


怎么将Python词频统计结果生成词云图展示
详细讲解如何将Python词频统计结果(字典或Counter对象)直接传入WordCloud生成词云图并展示。涵盖核心方法调用、中文字体配置、形状遮罩应用及常见乱码方块报错的完整排查。
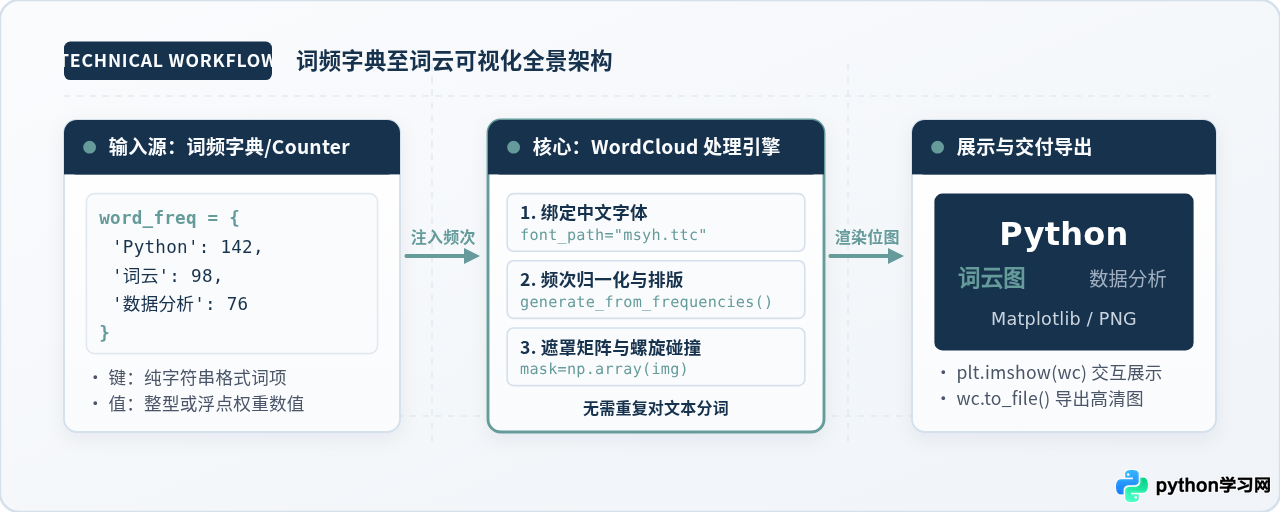
dict 字典或 collections.Counter 对象)时,不要再调用接收整段原始文本的 generate() 方法,而应直接调用 WordCloud 的专用方法 generate_from_frequencies(frequencies)。在该流程中,只需明确绑定系统中的真实中文字体路径(如 font_path='simhei.ttf')以避免中文方块乱码,设置画布尺寸与配色方案,再通过 matplotlib.pyplot 渲染展示或直接使用 to_file() 输出保存即可完成高质量交付。
一、准备工作与词频数据结构规范
生成词云图所需的核心依赖为 wordcloud(词云渲染引擎)与 matplotlib(图像展示与窗口交互)。如果需要通过自定义图形轮廓限制词云范围,通常还会用到 numpy 与 pillow(PIL)。
如果当前环境中尚未安装上述库,可以在终端或命令行中执行以下安装命令:
pip install wordcloud matplotlib pillow numpy1. 词频输入结构的要求
generate_from_frequencies() 接受的核心参数是一个形如 {"词语": 频次} 的 Python 字典。无论你的词频来源是通过 jieba 分词后结合 Counter 统计,还是从 Pandas 数据表的聚合结果导出,只要满足以下两个硬性条件即可无缝输入:
- 字典的键(Key):必须为代表词项的纯字符串(
str),不能包含None或未解包的对象。 - 字典的值(Value):必须为代表权重或次数的数值类型(
int或float)。该方法不仅支持整数出现频次,还完全支持 TF-IDF 权重或 TextRank 计算得出的浮点得分。
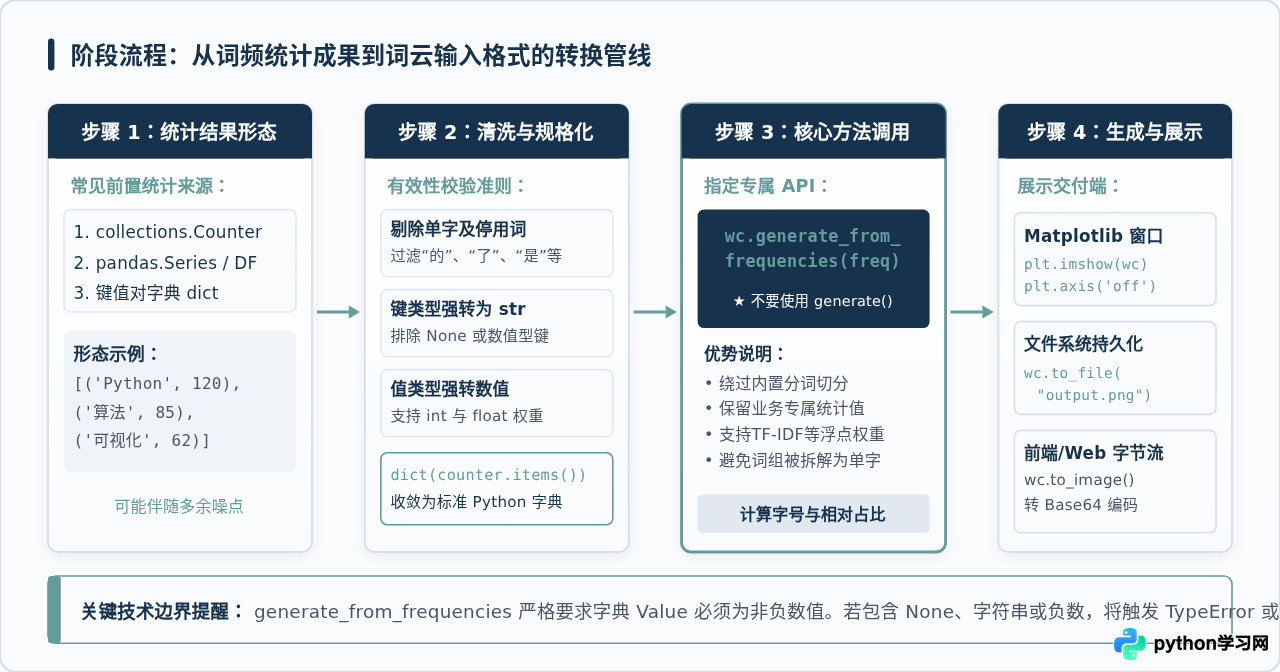
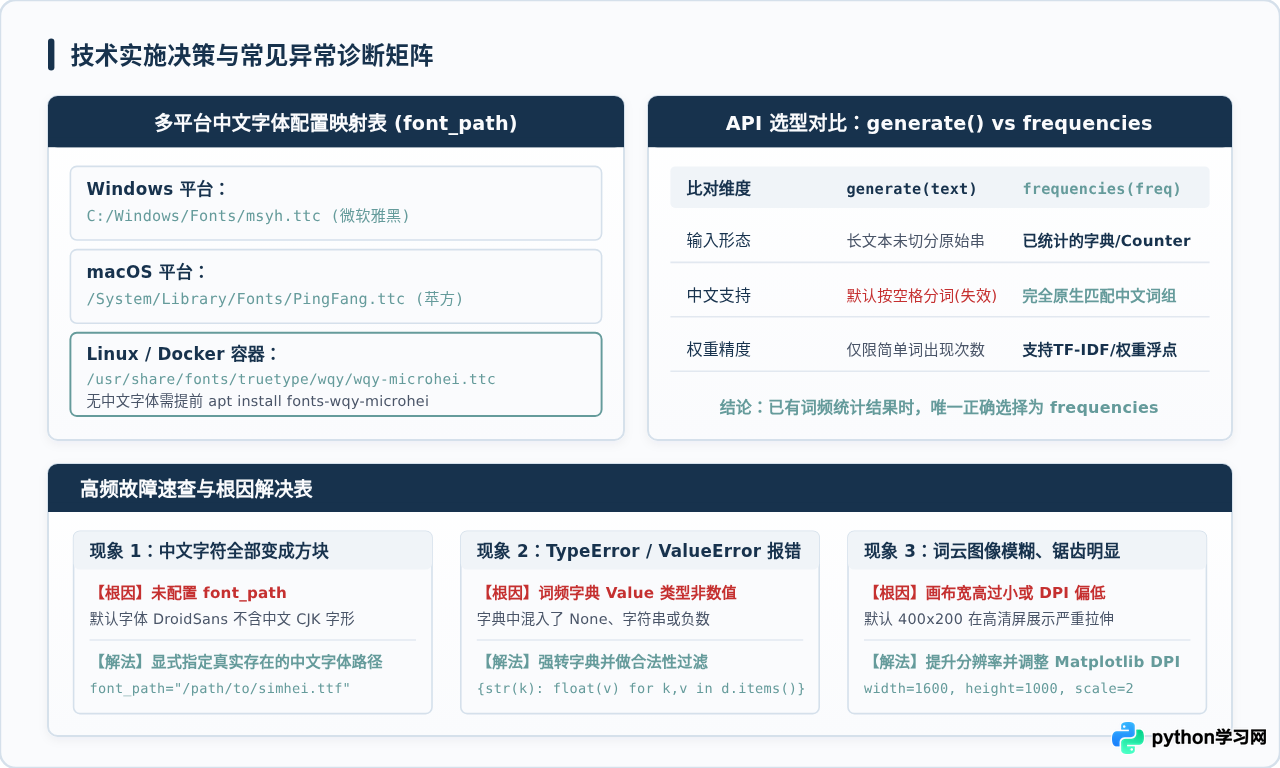
wordcloud 的默认 generate(text) 内部使用的是英文空格分词器。若直接传入中文段落,整句会被误判为一个不可分割的词。而通过前置分词得到精确词频字典后,直接调用 generate_from_frequencies 可以完全掌控分词粒度、精确剔除无效停用词,并保留统计权重的真实比例。
二、核心实现步骤:编写词云生成与展示脚本
以下为一个完整的最小可运行脚本。代码中构造了模拟词频字典,实例化 WordCloud 对象并完成画布参数绑定,最终通过 matplotlib 显示并保存为图像文件。
import matplotlib.pyplot as plt
from wordcloud import WordCloud

# 1. 准备已统计好的词频数据(以字典形式组织)
word_counts = {
    "Python": 185,
    "数据分析": 124,
    "词云图": 96,
    "机器学习": 82,
    "可视化": 78,
    "爬虫技术": 65,
    "自然语言处理": 58,
    "数据清洗": 52,
    "统计学": 45,
    "自动化脚本": 39,
    "算法模型": 33,
    "深度学习": 29
}

# 2. 实例化 WordCloud 并配置关键参数
# 注意:Windows 用户可使用 "msyh.ttc" 或 "C:/Windows/Fonts/simhei.ttf"
# macOS 用户可使用 "/System/Library/Fonts/PingFang.ttc"
wc = WordCloud(
    font_path="simhei.ttf",            # 必须显式声明中文字体,否则中文变成方块
    width=1200,                        # 输出位图宽度(像素)
    height=800,                        # 输出位图高度(像素)
    background_color="#FAFBFD",        # 画布底色
    max_words=100,                     # 渲染的最大词语数量
    max_font_size=160,                 # 最大字号限制
    min_font_size=14,                  # 最小字号限制
    colormap="ocean",                  # Matplotlib 色彩映射表
    random_state=42                    # 固定随机种子,确保排版结果可复现
)

# 3. 将词频字典注入词云生成器
wc.generate_from_frequencies(word_counts)

# 4. 使用 Matplotlib 进行界面展示
plt.figure(figsize=(12, 8), dpi=100)
plt.imshow(wc, interpolation="bilinear")  # 双线性插值抗锯齿
plt.axis("off")                           # 隐藏坐标轴刻度与外框
plt.tight_layout(pad=0)
plt.show()

# 5. 保存高清图片至本地文件
wc.to_file("wordcloud_output.png")
print("词云图已成功生成并保存为 wordcloud_output.png")
代码关键环节深度解析
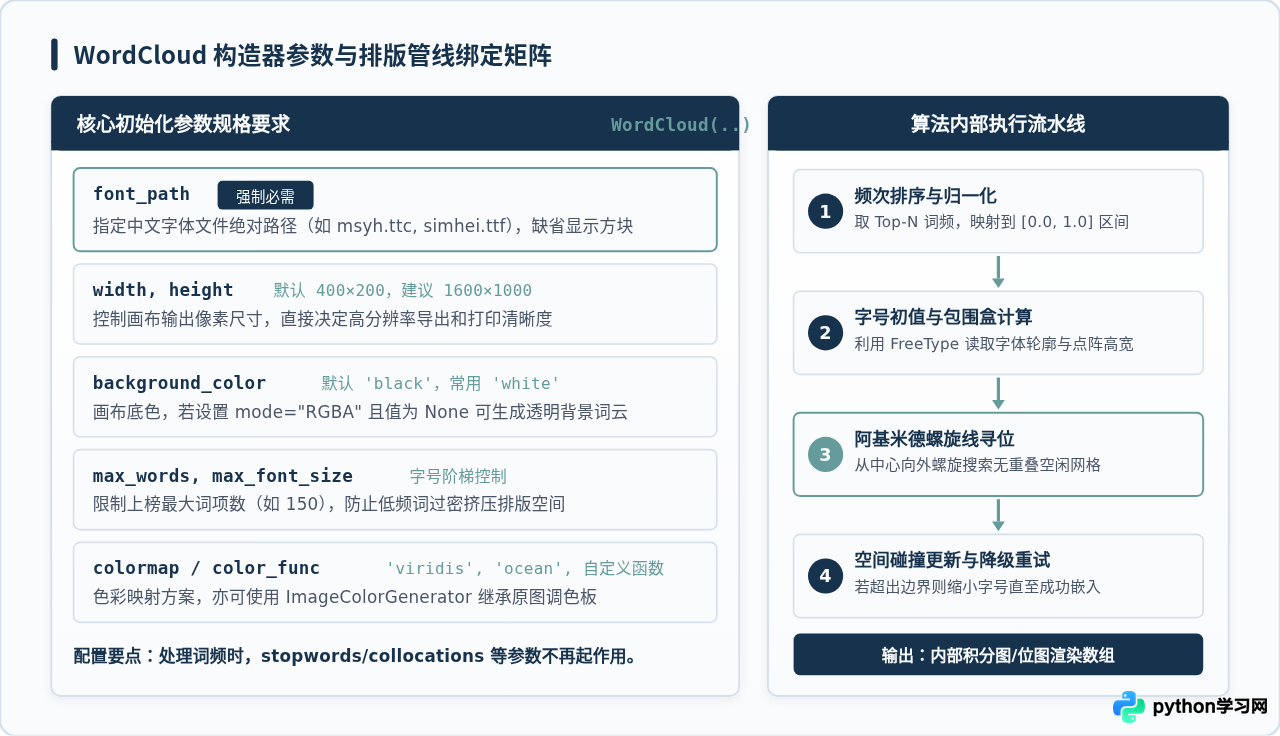
- font_path 的绝对必要性:
wordcloud内置默认字体为英文字体DroidSansMono.ttf,该字体不包含汉字编码。如果不在初始化中配置font_path,程序不会主动报错,而是静默将所有汉字渲染成空心方块(俗称“豆腐块”)。 - generate_from_frequencies 计算逻辑:该函数内部会自动对字典中的数值进行极差缩放或对数归一化,将权重最高词语映射到
max_font_size,最低词语映射到min_font_size。 - 展示与保存的先后顺序:可以直接调用
wc.to_file()生成无白边的精准位图。若先使用plt.savefig(),需额外指定bbox_inches='tight',否则保存出的图片四周会留下大面积空白画板。
三、进阶控制:按形状遮罩与原图色调渲染
在许多业务报告和展示场景中,长方形的词云图显得较为单调。通过给 WordCloud 传入一个 NumPy 矩阵作为 mask 参数,可以让词语紧密贴合特定图标(如公司 Logo、中国地图、几何圆环等)的轮廓生成。
1. 遮罩图像的技术硬性要求
制作遮罩素材图时必须注意:背景必须是纯白色(RGB 均为 255,即 #FFFFFF)。wordcloud 在判定像素点时,将所有像素值为 255 的区域视为“画布外/禁止放置区”,将非 255 的暗色区域视为“文字可排版安全区”。
import numpy as np
from PIL import Image
from wordcloud import WordCloud, ImageColorGenerator

# 读取遮罩图并转换为 NumPy 矩阵
mask_image = np.array(Image.open("heart_mask.png"))

# 实例化带遮罩的词云对象
wc_mask = WordCloud(
    font_path="simhei.ttf",
    background_color="#FFFFFF",
    mask=mask_image,                   # 注入形状遮罩矩阵
    contour_width=1.5,                 # 轮廓线宽度(像素)
    contour_color="#17324D",           # 轮廓线颜色
    max_words=200
)

wc_mask.generate_from_frequencies(word_counts)

# 可选:抽取遮罩图原本的色彩分布给词语着色
image_colors = ImageColorGenerator(mask_image)
wc_mask.recolor(color_func=image_colors)

wc_mask.to_file("custom_mask_wordcloud.png")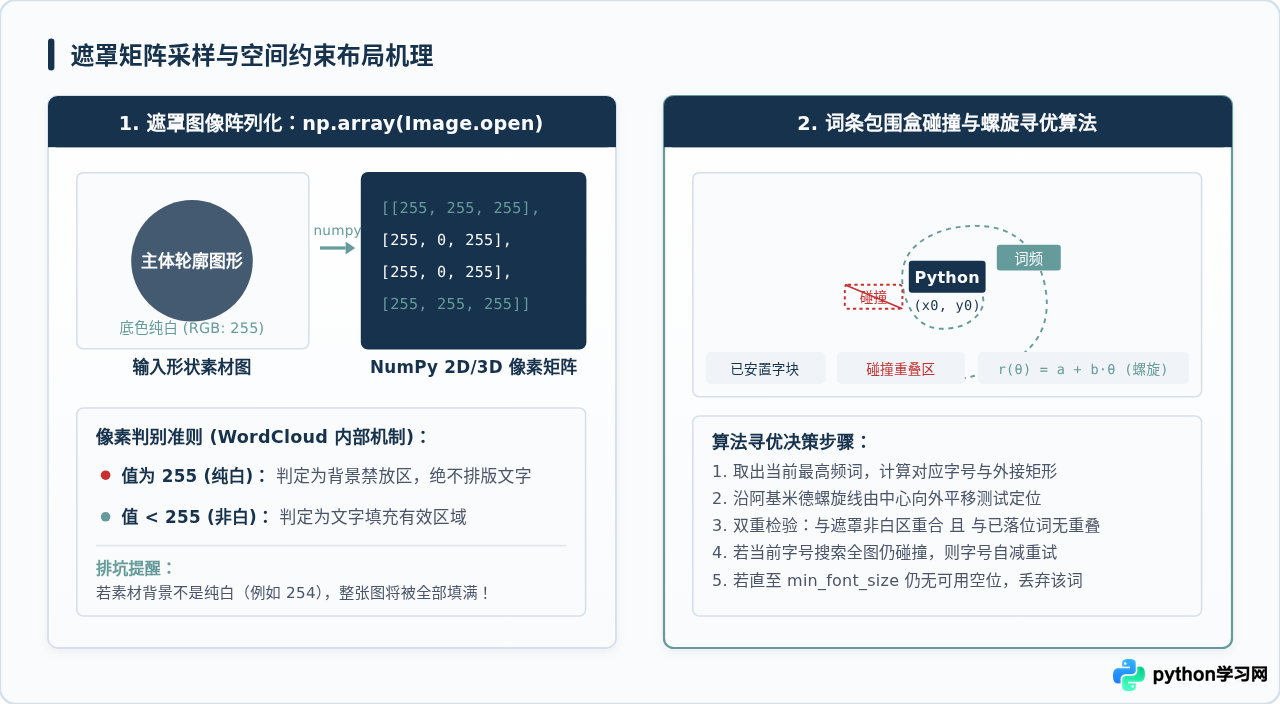
四、各系统字体路径速查与常见故障排查
在实际生产部署(尤其是由本地开发机迁移至 Linux 服务器或 Docker 容器)时,词频生成词云图最容易遇到环境差异引发的异常。以下整理常见系统的字体定位路径与排障方案。
| 操作系统平台 | 常用中文字体名称 | 推荐填写的系统绝对路径 |
|---|---|---|
| Windows 10 / 11 | 微软雅黑 (Microsoft YaHei) | C:/Windows/Fonts/msyh.ttc |
| Windows 10 / 11 | 黑体 (SimHei) | C:/Windows/Fonts/simhei.ttf |
| macOS (OS X) | 苹方简体 (PingFang SC) | /System/Library/Fonts/PingFang.ttc |
| macOS (OS X) | 冬青黑体 / 华文黑体 | /System/Library/Fonts/STHeiti Light.ttc |
| Linux (Ubuntu/Debian) | 文泉驿微米黑 (需提前 apt 安装) | /usr/share/fonts/truetype/wqy/wqy-microhei.ttc |
| 跨平台最佳实践 | 思源黑体 (开源免费商用) | 将 SourceHanSans.ttf 放在项目目录,填相对路径 ./SourceHanSans.ttf |
常见问题排查清单
- 问题 1:生成的图片中所有文字显示为方块(口口口)
根因:font_path填写的路径不存在,或者指向了不支持中文的英文字体。
验证方法:在代码前加入import os; print(os.path.exists("你的字体路径"))。确保输出为True。 - 问题 2:触发
TypeError: unhashable type: 'dict'或类似类型错误
根因:混淆了方法名,错误地调用了generate(word_counts)。
解决办法:切记字典数据只能传入generate_from_frequencies(word_counts)。 - 问题 3:遮罩图形无效,生成的词云依然是矩形
根因:遮罩图的空白背景并不是标准纯白(RGB 为 255,255,255),可能带有浅灰(如 250,250,250)或透明度通道 Alpha 干扰。
解决办法:使用图像处理工具确保底色彻底为 255,或者在 Python 中进行矩阵阈值处理:mask_image[mask_image > 240] = 255。
五、总结与实施规范
将 Python 词频统计结果转化为词云图是一条高度标准化的可视化管线。只要遵循以下规范即可确保稳定输出:
- 数据规整:前置清洗时剔除单字及停用词,收敛为
{词项: 数值}纯字典; - 接口选择:务必调用
WordCloud.generate_from_frequencies(),拒绝重复进行二次分词; - 字体绑定:首选随项目代码附带开源中文字体文件(如思源黑体),避免跨操作系统因系统字体缺失导致方块乱码;
- 高清渲染:合理配置
width、height(建议 1200 以上)及max_font_size,并通过wc.to_file()保证图片导出清晰度。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















