


Python机器学习核心第三方库介绍:TensorFlow与PyTorch
深入解析Python机器学习两大核心第三方库TensorFlow与PyTorch的设计范式、核心API工作流、生产部署生态及工程选型依据,助你快速掌握现代深度学习开发基础。
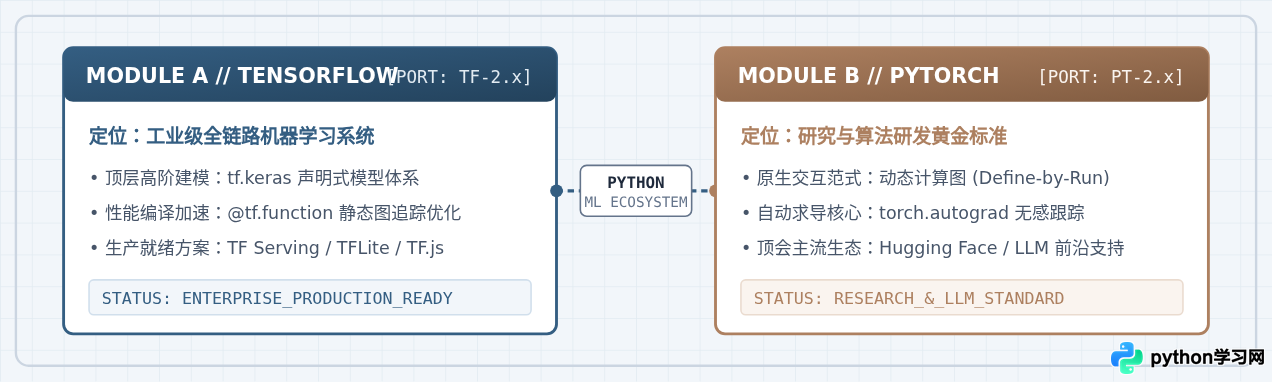
在 Python 机器学习与深度学习开发中,TensorFlow 与 PyTorch 是两个占据绝对主导地位的核心第三方库。TensorFlow 由 Google 主导维护,强调模型开发的高阶封装、静态图编译优化及工业级跨平台部署能力;PyTorch 由 Meta 研发,凭借原生 Python 风格的动态计算图、直观的调试体验与活跃的学术社区,成为前沿科研与大模型开发的首选框架。本文将直接从两者的计算架构、标准开发工作流、生态部署链路及实际选型决策四个维度展开深入讲解。
一、核心架构与计算图设计机制
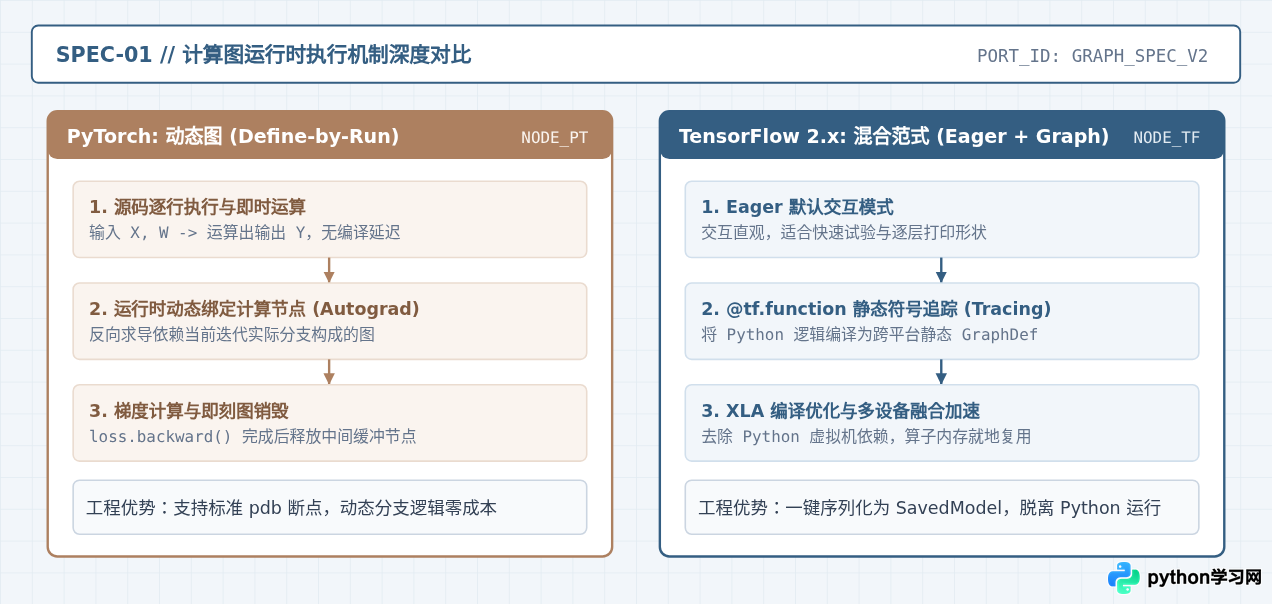
机器学习框架的本质是高效处理多维数组(张量,Tensor)并基于自动微分算法(Autograd / GradientTape)完成反向传播优化。TensorFlow 与 PyTorch 在设计哲学的根本分水岭在于计算图(Computational Graph)的构建与执行时机。
PyTorch 采用纯粹的动态图模式(Define-by-Run)。代码每执行一行,张量运算便即时完成计算,并在后台自动动态编织有向无环图(DAG)。由于图结构与 Python 原生控制流(如 if 分支、for 循环)完全绑定,开发者可以使用标准的 print() 或 pdb 直接单步调试模型张量。
TensorFlow 在 2.x 版本之后默认开启了 Eager Execution(即时执行),让开发体验贴近 Python 原生语法;同时保留了基于 @tf.function 的声明式编译机制。通过跟踪(Tracing)Python 函数,TensorFlow 会生成静态的 GraphDef,交由 XLA(Accelerated Linear Algebra)编译器进行算子融合与并行调度,从而在不需要 Python 解释器介入的场景下实现极高的脱机执行性能。
二、核心操作工作流:从数据管道到参数更新
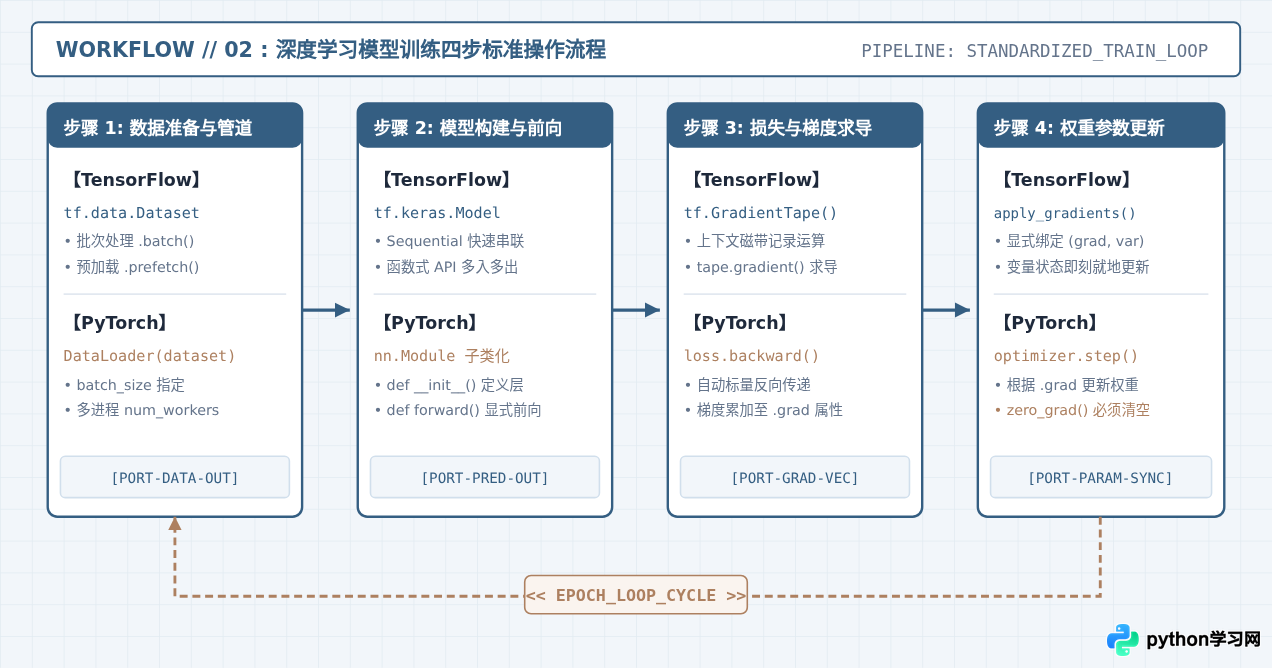
无论是进行经典卷积网络(CNN)图像分类还是循环模型训练,深度学习的实际操作均遵循固定的四步循环:数据输入流水线构建、前向模型定义、损失与反向求导计算、优化器参数步进更新。理解这两个库在各步骤的具体代码与对应关系,是掌握两者的核心捷径。
1. PyTorch 典型训练实现代码
在 PyTorch 中,开发者通常继承 torch.nn.Module 编写模型类,并在显式编写的 Python for 循环中手动控制求导与参数优化。
# 导入 PyTorch 核心模块
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset

# 1. 准备样本数据与 DataLoader
x_data = torch.randn(100, 10)
y_data = torch.randint(0, 2, (100,))
dataset = TensorDataset(x_data, y_data)
loader = DataLoader(dataset, batch_size=16, shuffle=True)

# 2. 定义两层神经网络
class SimpleClassifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(10, 32)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(32, 2)

    def forward(self, x):
        return self.fc2(self.relu(self.fc1(x)))

model = SimpleClassifier()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 3. 执行训练步骤循环
model.train()
for epoch in range(5):
    for batch_x, batch_y in loader:
        # 注意:每次反向传播前必须显式将梯度清零
        optimizer.zero_grad()
        outputs = model(batch_x)
        loss = criterion(outputs, batch_y)
        loss.backward()
        optimizer.step()
    print(f"Epoch {epoch + 1} 完成,当前批次 Loss: {loss.item():.4f}")
2. TensorFlow 2.x (Keras) 典型训练实现代码
TensorFlow 提供了两种风格:既可以使用高度自动化的 model.fit(),也可以使用与 PyTorch 类似的底层自定义训练循环(基于 tf.GradientTape)。
# 导入 TensorFlow 核心模块
import tensorflow as tf
from tensorflow.keras import layers, models

# 1. 准备数据管道
x_data = tf.random.normal([100, 10])
y_data = tf.random.uniform([100], maxval=2, dtype=tf.int32)
dataset = tf.data.Dataset.from_tensor_slices((x_data, y_data)).batch(16)

# 2. 构建模型结构
model = models.Sequential([
    layers.Dense(32, activation='relu', input_shape=(10,)),
    layers.Dense(2)
])
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)
optimizer = tf.keras.optimizers.Adam(learning_rate=0.001)

# 3. 自定义底层训练循环(使用 @tf.function 编译加速)
@tf.function
def train_step(x, y):
    with tf.GradientTape() as tape:
        predictions = model(x, training=True)
        loss = loss_fn(y, predictions)
    # 从磁带中提取可训练参数对应的梯度并更新
    gradients = tape.gradient(loss, model.trainable_variables)
    optimizer.apply_gradients(zip(gradients, model.trainable_variables))
    return loss

for epoch in range(5):
    epoch_loss = 0.0
    for batch_x, batch_y in dataset:
        loss = train_step(batch_x, batch_y)
        epoch_loss = loss
    print(f"Epoch {epoch + 1} 完成,当前批次 Loss: {float(epoch_loss):.4f}")
三、生态工具链与生产部署架构
在机器学习的工业实践中,“训练模型”往往仅占生命周期的一小部分,更繁重的工作在于模型序列化、跨平台推理引擎集成与高并发服务部署。
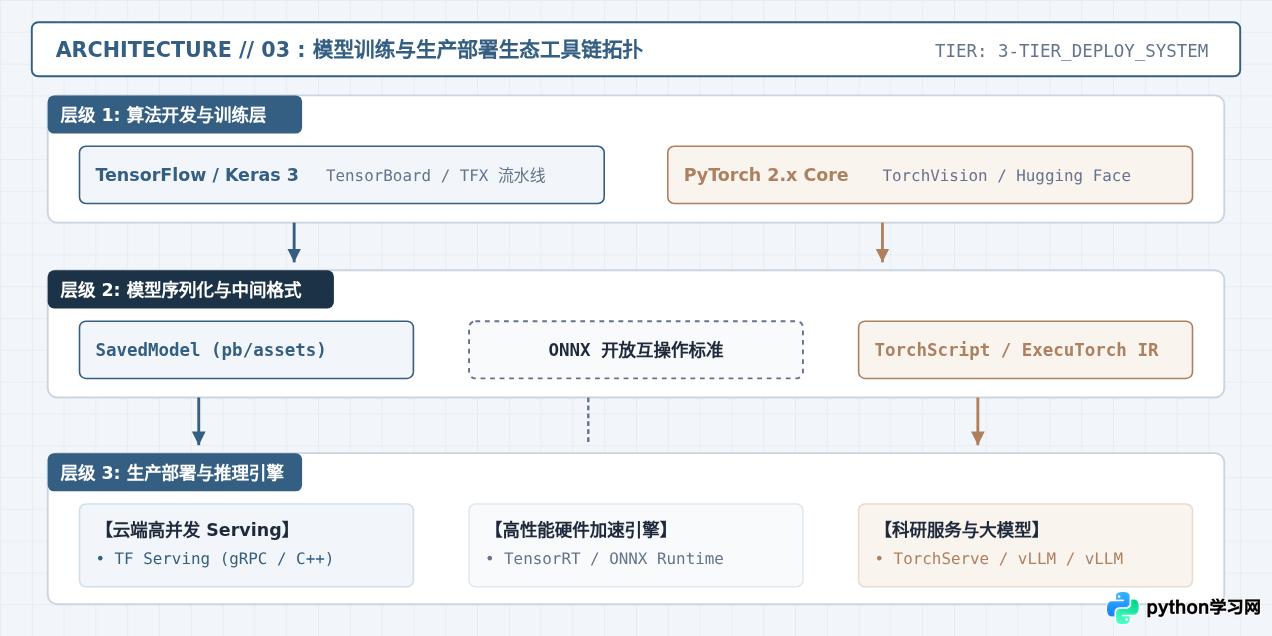
TensorFlow 诞生之初就定位于 Google 的大规模工业生产流水线,因此其周边配套极为完备。SavedModel 格式自包含完整的计算图定义和权重,能够无缝部署到基于 C++ 编写的 TF Serving,具备极高吞吐的 gRPC/RESTful 推理能力;对于手机端和 IoT 设备,TensorFlow Lite (TFLite) 提供了量化和硬件加速器代理支持。
PyTorch 早期因动态图特性在离线 C++ 部署上门槛较高,但后续通过引入 TorchScript(通过 torch.jit.trace 或 torch.jit.script 将模型转换为脱离 Python 的 TorchIR)和新一代移动边缘运行时 ExecuTorch 补全了短板。此外,PyTorch 与开源标准 ONNX(Open Neural Network Exchange)生态高度兼容,模型可以轻松导出并由 ONNX Runtime 或 NVIDIA TensorRT 驱动执行。
四、实际选型决策指南与核心维度对比
在启动实际工程项目或科研任务时,选择 TensorFlow 还是 PyTorch 不应受主观喜好左右,而应严格根据业务目标、交付形态与技术团队背景进行决策:
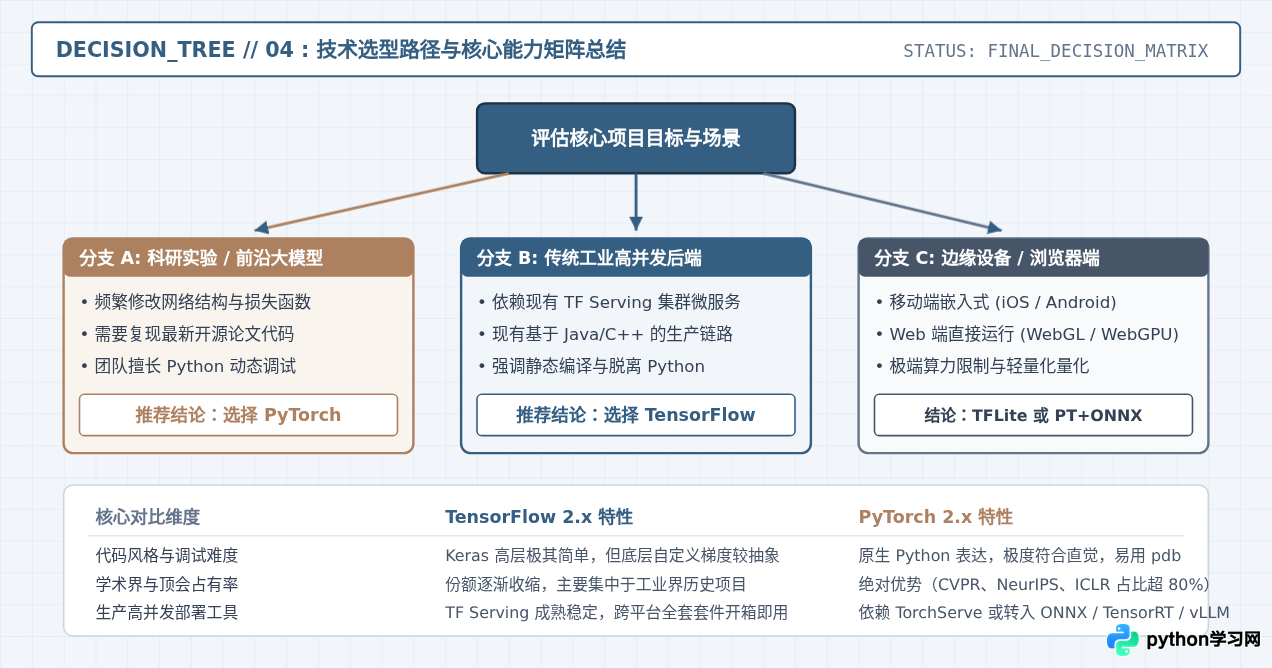
| 对比指标 | TensorFlow 2.x | PyTorch 2.x |
|---|---|---|
| 计算图机制 | Eager 即时执行 + @tf.function 符号图追踪 |
纯动态计算图(Define-by-Run,Autograd) |
| API 风格 | Keras 3 规范化封装为主,声明式倾向强 | 面向对象 Pythonic 风格,面向过程控制流 |
| 自动求导机制 | tf.GradientTape 上下文显式记录磁带 |
节点内置跟踪,loss.backward() 自动反向 |
| 学术社区支持 | 较少前沿预训练模型首发,但官方文档详实 | Hugging Face / GitHub 顶级开源论文首选实现 |
| 典型适用团队 | 注重部署标准化、既有 Java/C++ 服务体系的企业团队 | 高校算法研究员、大模型架构师、快速原型开发者 |
五、环境配置与实操避坑指南
初学者在配置 Python 机器学习环境时,经常遇到环境冲突、CUDA 版本不兼容等典型问题。建议通过虚拟环境(如 venv 或 conda)进行物理隔离:
1. 依赖安装标准命令
# 创建并激活专用虚拟环境
python -m venv ml_env
source ml_env/bin/activate  # Linux / macOS
# ml_env\Scripts\activate   # Windows

# 安装 CPU 基础版本进行快速学习验证
pip install tensorflow
pip install torch torchvision torchaudio

# 若具备 NVIDIA 独立显卡并已配置好驱动,推荐根据官方命令匹配 CUDA:
# PyTorch 官方推荐指定 index-url 安装对应 CUDA 构建版本
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121- PyTorch 梯度遗漏清理: PyTorch 默认会在张量上累积梯度(
grad不会自动归零)。如果忘记在每个批次前调用optimizer.zero_grad(),多个批次的梯度会直接相加,导致模型参数更新剧烈振荡甚至发生数值爆炸。 - 跨设备传输(Device Mismatch): PyTorch 要求所有参与运算的模型权重与输入张量必须位于同一物理设备。如果出现
RuntimeError: Expected all tensors to be on the same device,请检查是否统一调用了.to(device)。 - TensorFlow 2.x 图追踪副作用: 在被
@tf.function修饰的函数内部,尽量避免使用 Python 列表追加(list.append)或打印,而应使用原生张量算子,否则该代码只会在追踪时执行一次,后续调用均被跳过。
综上所述,TensorFlow 与 PyTorch 并非互斥的竞争关系,而是现代 AI 工程师工具箱中针对不同应用阶段的互补工具。初学者推荐以 PyTorch 作为切入点建立对张量流转与梯度反向传播的直观理解;当面临工业级高并发系统对接与端到端标准化部署时,TensorFlow 的完整生态工具链依然是一项坚实的技术选型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















