


怎么将Python硬编码配置重构迁移至Apollo配置中心
本文详细讲解如何将Python项目中的硬编码配置平滑重构迁移至Apollo配置中心,涵盖配置分类、Apollo空间规划、Python客户端适配层封装、断网容灾降级及动态监听最佳实践。
将 Python 工程中分散写在 settings.py、常量模块或业务代码中的数据库地址、业务阈值和第三方密钥等硬编码配置迁移至 Apollo 配置中心,核心路径分为三步:首先梳理现有配置并按静态结构与动态属性分类,在 Apollo 控制台规划 Namespace 并录入;其次在 Python 工程中封装一层支持“内存极速读取、本地快照容灾、自动类型转换与兜底缺省值”的高可用配置适配器(ConfigAdapter);最后通过向后兼容的接口逐步替换业务引用,并挂载变更回调(Watcher)实现无重启热更新与断网平滑降级。
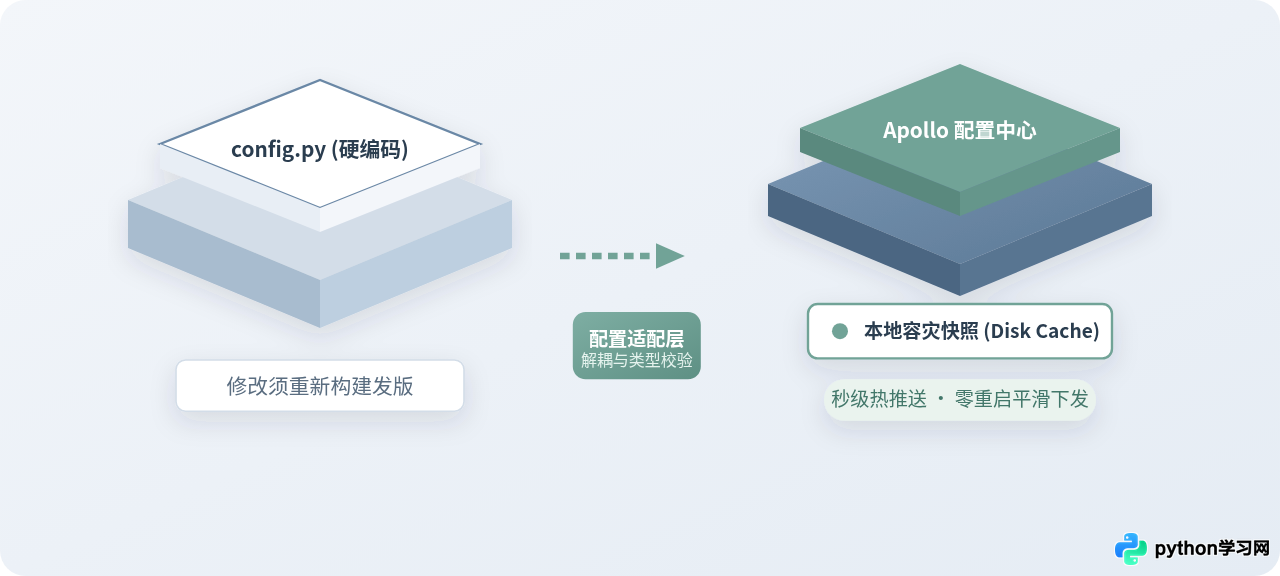
一、为什么要重构硬编码:明确迁移边界与核心收益
在 Python 后端与数据脚本开发初期,开发者习惯直接在模块顶部定义大写常量,或者集中写在 config.py 里。随着工程服务化和容器化部署,这类硬编码方式会产生明显的运维摩擦:每次修改一个超时时间或调整日志级别,都必须经历“提交代码、提交 PR、构建 Docker 镜像、重启 Pod”的漫长流水线;不同环境(开发、测试、预发、生产)切换时频繁依赖代码分支或启动参数,极易合错覆盖;此外,明文密码和 API 秘钥存放在代码仓库内,存在严峻的安全合规隐患。
但并非所有参数都适合丢进配置中心。在着手重构前,首先需要理清迁移的边界:
- 必须迁移的动态配置:各环境的网络端点(MySQL/Redis/ES 地址与端口)、业务熔断开关、接口超时时间、流量限流阈值、算法模型权重参数。这类配置要求能够根据线上运行状况在数秒内完成动态热调优。
- 必须迁移的环境敏感配置:第三方支付公钥、短信渠道秘钥、数据库连接密码等。迁移至 Apollo 可以借助平台的权限审核流、密文加密插件与发布操作审计脱敏。
- 保持硬编码的工程常量:系统底层协议魔数、内部固定的状态机枚举定义、与业务逻辑深度绑定的内置算法规则。这些属于代码内部逻辑的一部分,强行外部化只会增加网络依赖与理解成本。
二、Apollo 核心运行机制与 Python 适配原理
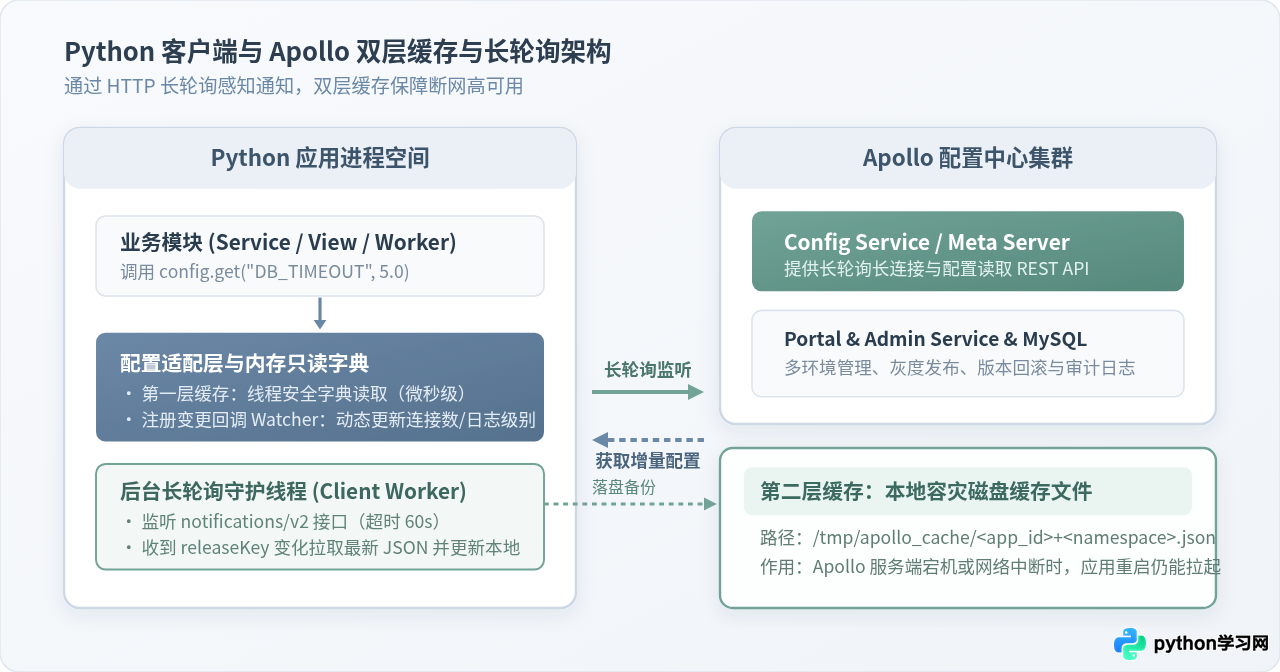
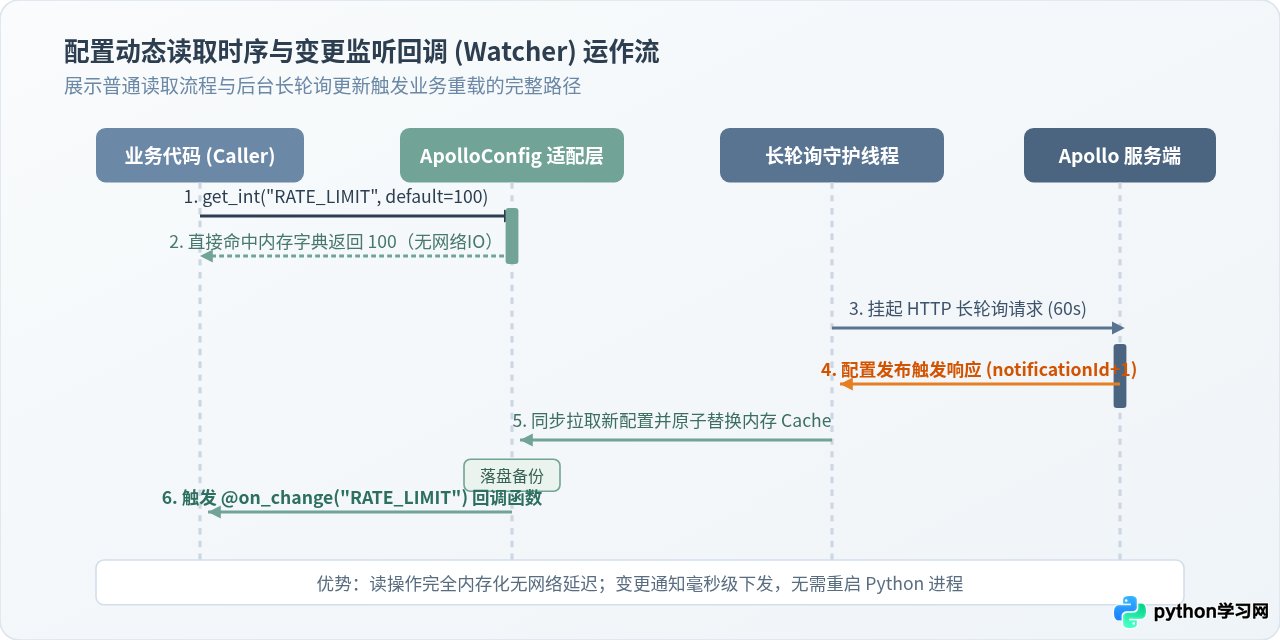
Apollo(携程开源的分布式配置中心)采用了基于 HTTP 长轮询(Long Polling)的高可用架构。许多刚接触 Apollo 的 Python 开发者容易产生误解,担心应用读取配置会频繁产生 HTTP 网络请求而拖慢接口性能,或者担心配置中心网络中断会导致整个系统崩溃。实际上,Apollo 客户端采用的是双层缓存架构:
- 第一层:内存字典缓存。客户端在初始化时拉取全量配置并保存在 Python 原生
dict中。业务代码读取配置时是纯内存操作,耗时通常在微秒级别,不存在网络 I/O 开销。 - 第二层:本地磁盘快照缓存(Disk Snapshot)。客户端每次成功拉取到新配置后,都会在本地磁盘(如
/tmp/apollo_cache/)生成一个包含app_id与namespace的 JSON 快照文件。若 Apollo 服务端发生集群宕机或网络分区,Python 应用在重启时会自动加载本地磁盘快照,保证系统照常启动。 - 长轮询变更感知线程:Python 客户端会启动一个后台守护线程(Daemon Thread),向 Apollo Config Service 的
notifications/v2接口发起长连接请求(默认超时 60 秒)。服务端若在此期间有新版本发布,会立即返回响应,客户端随即拉取最新配置、更新内存、覆盖磁盘文件并触发用户绑定的监听回调函数。
三、迁移重构五步实施法
为了避免在重构过程中出现配置漏填导致服务启动中断,建议采用由浅入深的五步标准化重构流程。
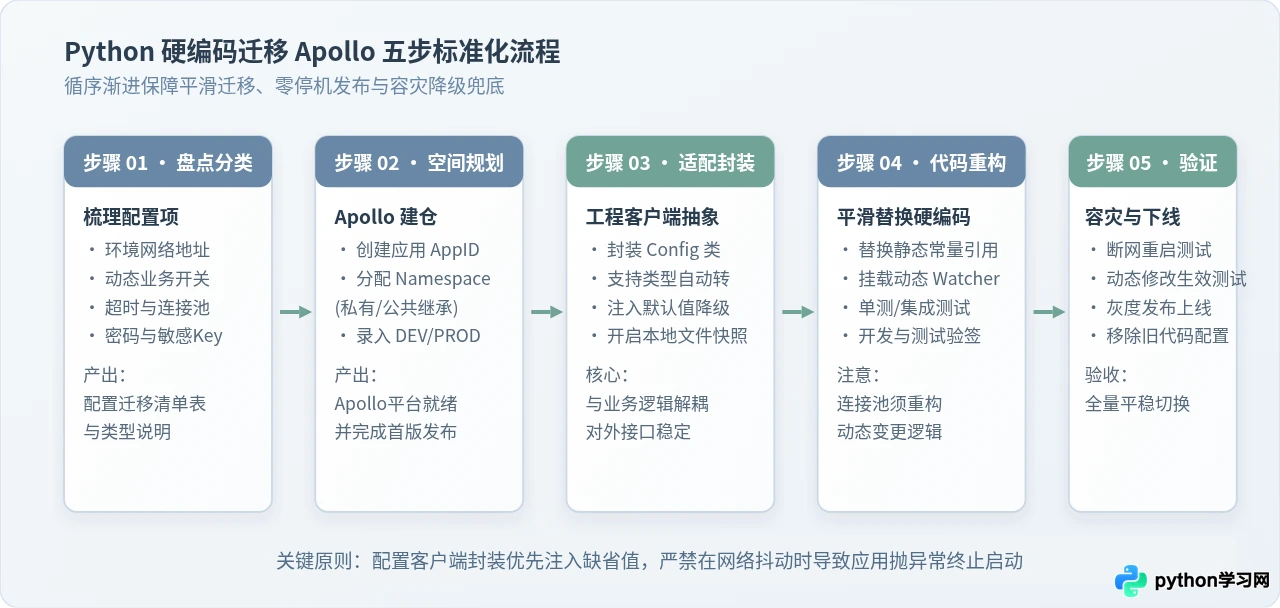
第 1 步:盘点现有配置并整理映射清单
全面扫描项目中的 settings.py、config.py 以及各业务模块顶部声明的全局变量。针对每一个提取出来的配置项,记录其键名、说明、期望数据类型(字符串、整数、浮点数或 JSON 结构)以及缺省默认值。
例如我们梳理出原有的硬编码配置模块:
# 旧版 config.py(待重构的硬编码常量)
DB_HOST = "192.168.10.25"
DB_PORT = 3306
DB_TIMEOUT = 5.0
ORDER_RATE_LIMIT = 200
FEATURE_NEW_CHECKOUT = True
WHITE_LIST_UIDS = [1001, 1002, 1088]
第 2 步:在 Apollo 管理控制台进行空间规划与录入
登录 Apollo Portal,按规范完成元数据与命名空间的创建:
- 创建 AppID:每个独立的 Python 微服务或应用项目分配一个全局唯一的
app_id(如order-service-py)。 - 选择或新建 Namespace:
application:私有命名空间,存放该项目独有的配置(如ORDER_RATE_LIMIT、业务开关)。common.infra:公共命名空间,供多个应用继承共用的基础设施配置(如统一的 Elasticsearch 集群地址、监控上报网关)。
- 按环境分别录入并发布:在 DEV、FAT、UAT、PROD 环境下分别录入对应的环境实际值。录入完成后点击“发布”(Release),生成初始的配置版本。
第 3 步:编写健壮的高可用 Python Apollo 适配器
不要直接在业务代码中散落调用第三方底层库的 API,必须封装一层工程级配置管理器(ConfigAdapter)。该管理器负责:
- 环境变量与本地文件快照的自动加载降级;
- 防御性类型转换(Apollo 后台存储的均为字符串,转为
int、float、bool、json必须有兜底机制); - 变更监听器(Watcher)的注册与分发。
以下是符合生产级可用性的完整封装示例:
import os
import json
import time
import logging
import threading
from typing import Any, Callable, Dict, Optional
import urllib.request
import urllib.parse
import urllib.error

logger = logging.getLogger("ApolloConfig")

class ApolloConfigAdapter:
    """
    Python Apollo 配置中心高可用适配器
    支持:内存微秒读取、磁盘快照容灾兜底、类型防御转换、动态监听回调
    """
    def __init__(
        self,
        app_id: str,
        config_server_url: str,
        cluster: str = "default",
        namespace: str = "application",
        cache_dir: str = "/tmp/apollo_cache"
    ):
        self.app_id = app_id
        self.config_server_url = config_server_url.rstrip("/")
        self.cluster = cluster
        self.namespace = namespace
        self.cache_dir = cache_dir
        self.cache_file = os.path.join(cache_dir, f"{app_id}+{cluster}+{namespace}.json")

        self._lock = threading.RLock()
        self._configurations: Dict[str, Any] = {}
        self._notification_id: int = -1
        self._listeners: Dict[str, list] = {}
        self._running = False
        self._thread: Optional[threading.Thread] = None

        os.makedirs(self.cache_dir, exist_ok=True)
        # 初始化:优先尝试拉取远程,失败则加载本地磁盘快照
        self._init_fetch()
        self.start_long_poll()

    def _init_fetch(self):
        try:
            self._fetch_remote_config()
            logger.info("Successfully fetched initial configs from Apollo server.")
        except Exception as e:
            logger.warning(f"Apollo server unreachable on init ({e}), falling back to disk cache.")
            self._load_disk_cache()

    def _fetch_remote_config(self):
        # 请求格式:/configs/{appId}/{clusterName}/{namespaceName}
        url = f"{self.config_server_url}/configs/{self.app_id}/{self.cluster}/{self.namespace}"
        req = urllib.request.Request(url, headers={"User-Agent": "PythonApolloClient/1.0"})
        with urllib.request.urlopen(req, timeout=5) as resp:
            data = json.loads(resp.read().decode("utf-8"))
            new_configs = data.get("configurations", {})
            with self._lock:
                old_configs = dict(self._configurations)
                self._configurations = new_configs
                self._save_disk_cache(new_configs)
            self._notify_changes(old_configs, new_configs)

    def _save_disk_cache(self, configs: dict):
        try:
            temp_file = self.cache_file + ".tmp"
            with open(temp_file, "w", encoding="utf-8") as f:
                json.dump(configs, f, ensure_ascii=False, indent=2)
            os.replace(temp_file, self.cache_file)
        except IOError as e:
            logger.error(f"Failed to save disk cache: {e}")

    def _load_disk_cache(self):
        if not os.path.exists(self.cache_file):
            logger.warning(f"No local disk cache found at {self.cache_file}")
            return
        try:
            with open(self.cache_file, "r", encoding="utf-8") as f:
                with self._lock:
                    self._configurations = json.load(f)
            logger.info(f"Loaded {len(self._configurations)} keys from local disk cache.")
        except Exception as e:
            logger.error(f"Failed to read disk cache: {e}")

    def get(self, key: str, default: Any = None) -> Any:
        with self._lock:
            return self._configurations.get(key, default)

    def get_int(self, key: str, default: int = 0) -> int:
        val = self.get(key, None)
        if val is None:
            return default
        try:
            return int(val)
        except (ValueError, TypeError):
            logger.error(f"Invalid integer for key '{key}': '{val}', returning default {default}")
            return default

    def get_float(self, key: str, default: float = 0.0) -> float:
        val = self.get(key, None)
        if val is None:
            return default
        try:
            return float(val)
        except (ValueError, TypeError):
            logger.error(f"Invalid float for key '{key}': '{val}', returning default {default}")
            return default

    def get_bool(self, key: str, default: bool = False) -> bool:
        val = self.get(key, None)
        if val is None:
            return default
        if isinstance(val, bool):
            return val
        return str(val).strip().lower() in ("true", "1", "yes", "on")

    def get_json(self, key: str, default: Any = None) -> Any:
        val = self.get(key, None)
        if val is None:
            return default
        if isinstance(val, (dict, list)):
            return val
        try:
            return json.loads(val)
        except Exception as e:
            logger.error(f"Failed to parse JSON for key '{key}': {e}, using default")
            return default

    def add_change_listener(self, key: str, callback: Callable[[Any, Any], None]):
        """注册键值变化监听器: callback(old_value, new_value)"""
        with self._lock:
            self._listeners.setdefault(key, []).append(callback)

    def _notify_changes(self, old_cfg: dict, new_cfg: dict):
        all_keys = set(old_cfg.keys()).union(set(new_cfg.keys()))
        for key in all_keys:
            old_val = old_cfg.get(key)
            new_val = new_cfg.get(key)
            if old_val != new_val:
                logger.info(f"Config changed: [{key}] '{old_val}' -> '{new_val}'")
                callbacks = self._listeners.get(key, [])
                for cb in callbacks:
                    try:
                        cb(old_val, new_val)
                    except Exception as err:
                        logger.exception(f"Error in change callback for {key}: {err}")

    def start_long_poll(self):
        if self._running:
            return
        self._running = True
        self._thread = threading.Thread(target=self._long_poll_worker, name="ApolloWatcherThread", daemon=True)
        self._thread.start()

    def _long_poll_worker(self):
        while self._running:
            try:
                notifications_payload = json.dumps([{
                    "namespaceName": self.namespace,
                    "notificationId": self._notification_id
                }])
                params = urllib.parse.urlencode({
                    "appId": self.app_id,
                    "cluster": self.cluster,
                    "notifications": notifications_payload
                })
                poll_url = f"{self.config_server_url}/notifications/v2?{params}"
                req = urllib.request.Request(poll_url, headers={"User-Agent": "PythonApolloClient/1.0"})

                with urllib.request.urlopen(req, timeout=75) as resp:
                    if resp.status == 200:
                        res_data = json.loads(resp.read().decode("utf-8"))
                        if res_data:
                            self._notification_id = res_data[0].get("notificationId", self._notification_id)
                            self._fetch_remote_config()
                    elif resp.status == 304:
                        pass
            except urllib.error.URLError:
                time.sleep(3)
            except Exception as ex:
                logger.error(f"Unexpected long poll error: {ex}")
                time.sleep(5)
第 4 步:设计向后兼容层并平滑重构业务调用
为了避免修改上百个业务文件的 import 语句,最佳做法是将原有的 config.py 改造为一个“委托模块”(Delegation Module),使用 Python 属性访问动态转发:
# 重构后的 config.py
import os
from apollo_adapter import ApolloConfigAdapter

# 优先读取系统环境变量中的 Apollo 地址与环境信息
APOLLO_META_SERVER = os.getenv("APOLLO_META_SERVER", "http://apollo-config.internal:8080")
APP_ENV = os.getenv("APP_ENV", "dev")

# 实例化全局单例
apollo = ApolloConfigAdapter(
    app_id="order-service-py",
    config_server_url=APOLLO_META_SERVER,
    cluster="default",
    namespace="application"
)

# 动态属性类,保持旧代码 `config.DB_PORT` 的平滑访问兼容
class ConfigProxy:
    @property
    def DB_HOST(self) -> str:
        return apollo.get("DB_HOST", default="127.0.0.1")

    @property
    def DB_PORT(self) -> int:
        return apollo.get_int("DB_PORT", default=3306)

    @property
    def DB_TIMEOUT(self) -> float:
        return apollo.get_float("DB_TIMEOUT", default=5.0)

    @property
    def ORDER_RATE_LIMIT(self) -> int:
        return apollo.get_int("ORDER_RATE_LIMIT", default=100)

    @property
    def FEATURE_NEW_CHECKOUT(self) -> bool:
        return apollo.get_bool("FEATURE_NEW_CHECKOUT", default=False)

    @property
    def WHITE_LIST_UIDS(self) -> list:
        return apollo.get_json("WHITE_LIST_UIDS", default=[])

# 对外暴露单例实例代理
settings = ConfigProxy()
通过上述代理包装,原业务代码中写的 from config import settings; timeout = settings.DB_TIMEOUT 无需做任何语法更改,底层就已经完全切换为了 Apollo 动态获取机制。
第 5 步:改造长生命周期对象的变更监听(Watcher)
对于普通的数值(如限流阈值、开关标志),每次在函数运行时通过 settings.ORDER_RATE_LIMIT 即可直接读取到最新值。但对于数据库连接池、日志记录器级别、长连接 Client 等单例对象,它们是在系统启动时被初始化的,仅更改变量值无法自动重建连接池。
此时需要借助 add_change_listener 注册回调函数,在收到 Apollo 推送时动态调整组件内部状态:
import logging
from config import apollo

# 示例 1:动态热修改日志级别(无需重启服务)
def on_log_level_change(old_val, new_val):
    if not new_val:
        return
    level = getattr(logging, new_val.upper(), None)
    if level is not None:
        logging.getLogger().setLevel(level)
        print(f"[Watcher] Log level dynamically adjusted to: {new_val.upper()}")

apollo.add_change_listener("LOG_LEVEL", on_log_level_change)

# 示例 2:动态更新业务黑白名单内存集合
ip_blacklist = set(apollo.get_json("IP_BLACKLIST", default=[]))

def on_blacklist_change(old_val, new_val):
    global ip_blacklist
    if new_val:
        parsed = apollo.get_json("IP_BLACKLIST", default=[])
        ip_blacklist = set(parsed)
        print(f"[Watcher] Blacklist updated, current count: {len(ip_blacklist)}")

apollo.add_change_listener("IP_BLACKLIST", on_blacklist_change)
四、生产环境容灾验证与避坑指南
1. 离线断网容灾演练
在将生产流量切换至 Apollo 之前,必须进行本地容灾演练:
- 演练步骤:先启动 Python 服务,让其成功拉取一次 Apollo 配置并确认
/tmp/apollo_cache/目录下已生成缓存文件;随后将本地机器网卡断开或在 hosts 中将 Apollo 域名指向无效 IP;最后重启 Python 进程。 - 预期表现:适配器捕获远程连接异常后,自动从本地磁盘快照恢复所有配置项,应用能够成功启动并对外提供正常业务服务,仅日志中打印出警告信息。
2. Apollo 字符串存储与强类型转换防御
Apollo 控制台在网页上录入的任何内容在底层均为纯字符串(String)。运维人员在控制台输入 100 (末尾带有空格)或者将布尔值录成 "True"、"1"、"yes" 时,如果代码中直接使用强类型转换(如 int(apollo.get("KEY"))),可能瞬间引发 ValueError 异常导致业务崩溃。
处理方案:严格通过适配器中提供的 get_int()、get_bool()、get_json() 等工具方法获取,在内部包裹 try...except 并在捕获格式错误时自动退回安全默认值,同时输出错误日志提示运维人员排查。
3. Gunicorn / uWSGI 多进程部署下的 Fork 陷阱
在采用 Gunicorn 或 uWSGI 部署多 Worker 进程时,如果客户端在主进程加载阶段就启动了 ApolloWatcherThread 线程,主进程 os.fork() 出 Worker 子进程时会导致子进程无法继承主进程的线程事件循环,造成 Worker 中的长轮询失效或文件锁竞争。
正确做法:在 Gunicorn 的 post_fork(server, worker) 钩子中,或者在各 Worker 进程真正被初始化时再调用 apollo.start_long_poll(),确保每个进程独立维护自己的监听上下文;或者对于多实例容器,仅由独立 Agent(如 sidecar 进程)负责同步到共享卷,各 Worker 只读本地文件。
五、重构对比与验收核对
完成迁移后,原有项目中散乱的硬编码文件彻底被规范的动态适配层替代。下表总结了重构前后各维度的质变表现,并提供了上线验收清单供交付前逐项核对。
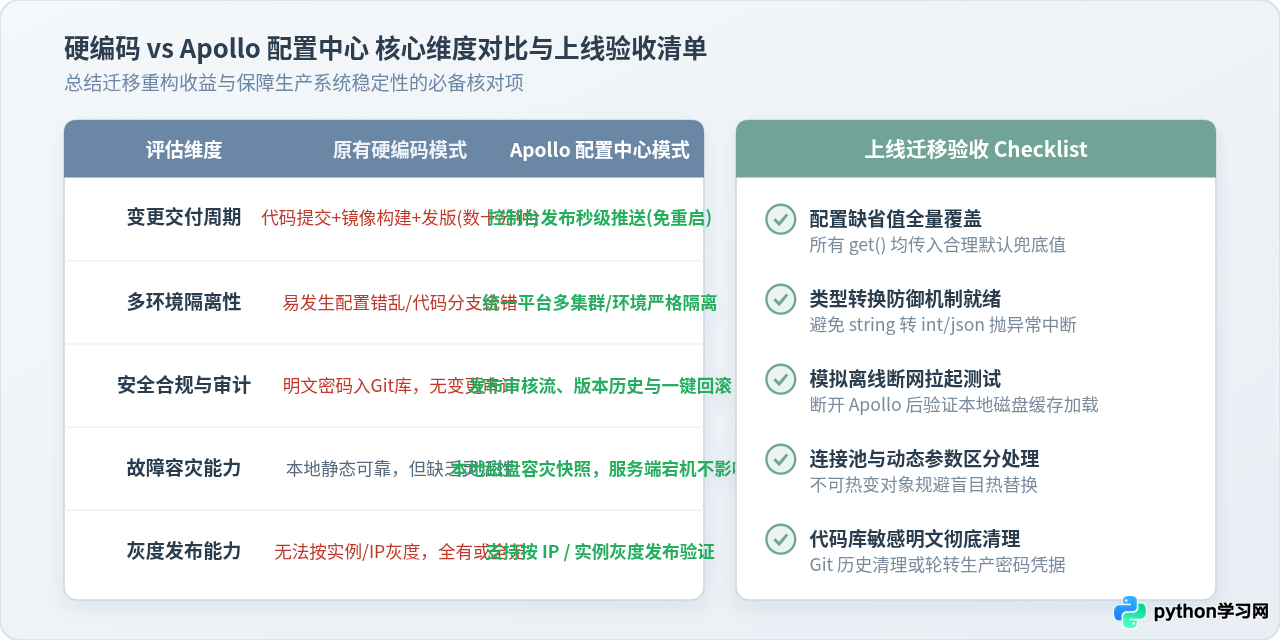
总结而言,将 Python 硬编码配置迁移至 Apollo 的核心价值在于将“代码交付流水线”与“业务参数调整流水线”彻底解耦。只要在 Python 侧遵循“双层缓存、缺省值兜底、防御性类型转换、安全管理监听线程”四大原则,就能在享受秒级配置热推送灵活性的同时,为生产系统筑牢坚实的断网容灾底座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















