


Python中通配符匹配与正则表达式re的区别及选择
深入解析Python中通配符匹配(fnmatch/glob)与正则表达式(re模块)的核心差异、底层运行机制、关键符号语义区别,并提供具体的场景选型依据与实操代码。
fnmatch、glob 与 pathlib 模块)与正则表达式(re 模块)是两套定位完全不同的字符串模式比对工具。通配符匹配专为文件路径与简单文件名过滤设计,语法极简直观;正则表达式则是通用、精密的文本解析引擎,支持结构提取、复杂量词与边界断言。本文将直接剖析两者的底层运行机理、核心符号语义差异,并给出清晰可执行的四步选型决策依据。
一、核心概念与本质差异
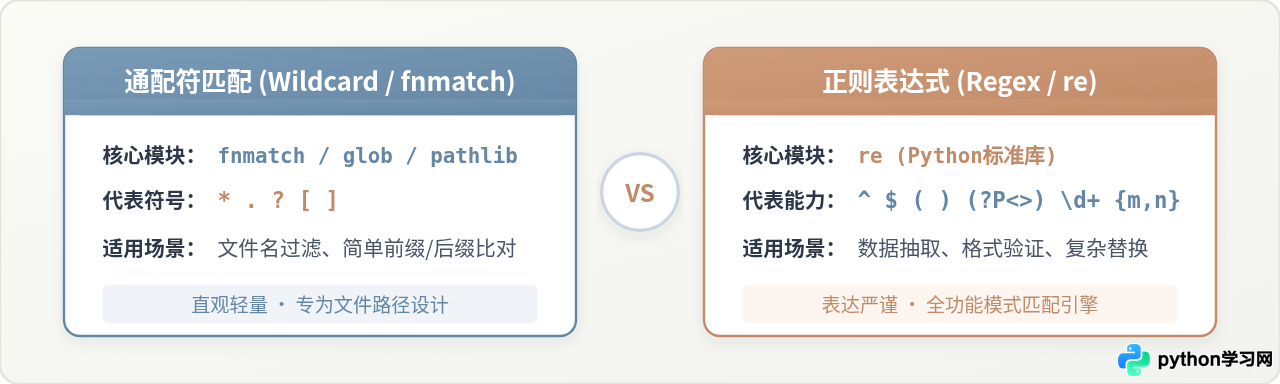
很多刚接触 Python 的开发者容易将通配符(Globbing)与正则表达式(Regular Expression)混为一谈,根本原因在于两者都可以使用形如 * 和 ? 的特殊字符进行模式过滤。然而,两者的设计目标与应用层级截然不同:
- 通配符匹配(Wildcard / Globbing):起源于 Unix Shell 环境的文件名通配机制。在 Python 中,标准库提供了
fnmatch模块处理单个字符串的通配判断,以及glob和pathlib.Path.glob()处理文件系统目录遍历。其语法集合极小,仅包含*、?、[...]和[!...],目标是用最符合人类直觉的方式快速定位一组文件。 - 正则表达式(Regular Expression,
re模块):基于形式语言与自动机理论构建的通用文本模式处理引擎。Python 的re模块支持位置锚定(^、$、\b)、贪婪与非贪婪量词、捕获分组与命名分组((?P<name>...))、前后查找断言等高级功能,专用于对复杂文本进行验证、精准抽取与模式替换。
二、核心符号语义与底层转换机理
开发者在实际编写代码时最常遇到的混淆,是同一个符号在两种语法体系下的不同语义。例如,在通配符中 *.txt 表示“任意字符接 .txt”,而在正则表达式中,字符 * 必须修饰前面的字符,若直接写 re.search("*.txt", s) 则会抛出 re.error: nothing to repeat 语法异常。
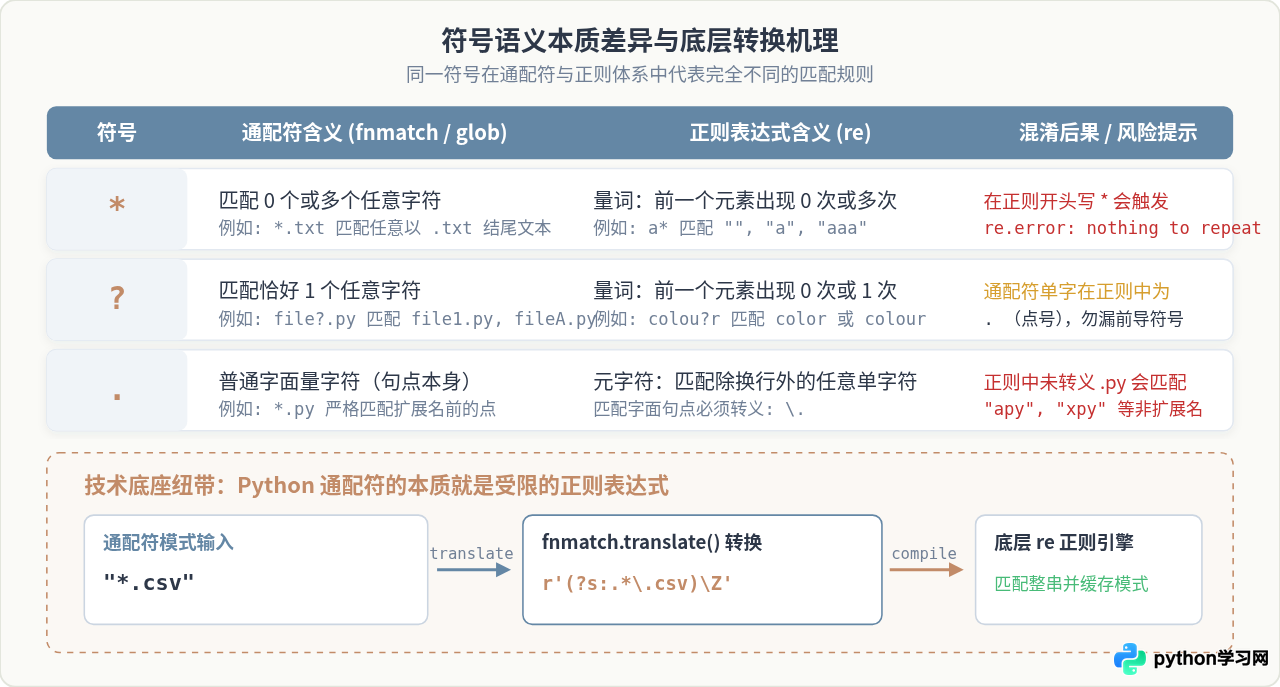
更有趣的是两者的技术纽带:在 Python 底层,通配符并不是独立编写的另一套字符串引擎,而是通过 fnmatch.translate() 将通配符模式翻译成了正则表达式,再交给 re 引擎编译执行。
import fnmatch

pattern = "*.csv"
regex_pattern = fnmatch.translate(pattern)
print("通配符转译结果:", regex_pattern)
# 输出示例: (?s:.*\.csv)\Z
从输出可以看出,fnmatch.translate() 会自动转义点号 \.,将 * 转换为包含跨行匹配模式的 .*,并加上字符串结尾锚点 \Z。这揭示了一个核心本质:通配符在能力上是正则表达式的一个极简子集,它牺牲了表达复杂度,换取了直观的易用性与极低的认知门槛。
三、执行流程与底层数据流对比
虽然通配符在底层复用了 re,但两者在 API 设计、数据流向以及返回结果上有着根本不同。
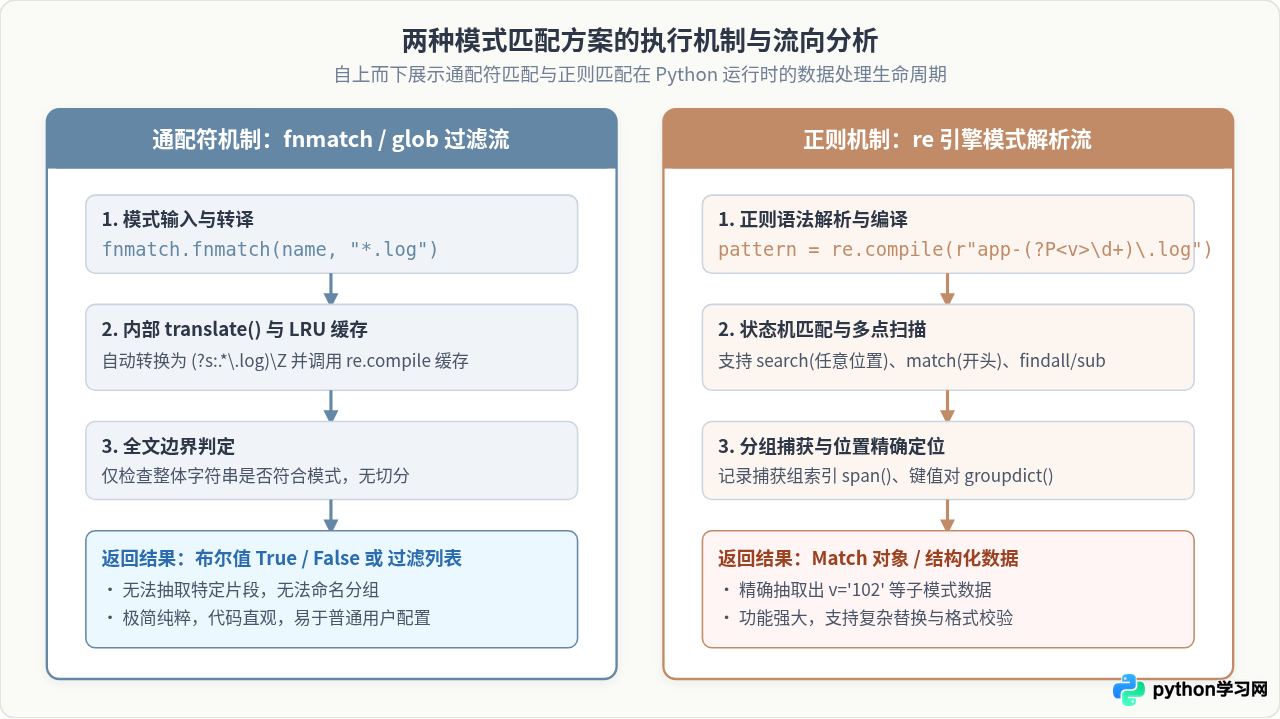
如上图所示,数据在两个模块中的流转呈现不同深度:
- 通配符执行流(全量布尔判断):
fnmatch.fnmatch(name, pat)仅关心“这串字符是否整体符合规则”,输出只有True或False;fnmatch.filter(names, pat)也仅是将匹配成功的元素原样过滤出来。它无法告诉你匹配到的某一段子字符串是什么,无法记录匹配位置,更无法直接实施捕获提取。 - 正则表达式执行流(结构化匹配对象):
re模块会先通过解析器构建确定有限状态自动机(DFA/NFA)。执行re.search()或re.match()后,返回的是一个完整的Match对象。该对象保留了匹配内容的起始/终止下标(span())、位置信息,以及各个分组的捕获值(groupdict()),并原生支持re.sub()替换。
四、典型场景代码与实践对比
通过具体场景来观察两者的代码写法,可以直观感受到适用边界的差异。
场景 1:文件遍历与后缀筛选(通配符的绝对主场)
假设需要找出项目目录下所有以 test_ 开头且以 .py 结尾的文件:
# 做法 A:使用 pathlib + 通配符(强烈推荐,代码清晰且高效)
from pathlib import Path

py_files = list(Path(".").glob("**/test_*.py"))
# 语法直观,直接递归匹配目录层级,跨平台兼容性良好

# 做法 B:使用 re 进行文件过滤(繁琐且容易出错)
import os
import re

pattern = re.compile(r"^test_.*\.py$")
py_files_re = []
for root, _, files in os.walk("."):
    for file in files:
        if pattern.match(file):
            py_files_re.append(os.path.join(root, file))
对比可知,对于目录结构和文件名过滤,通配符配合 pathlib.Path.glob 无论在代码量还是可读性上都显著优于正则表达式。
场景 2:数据提取与模式校验(正则表达式的无可替代领域)
假设需要从日志文本 "2026-10-31 11:20:05 [ERROR] worker-03 task 4082 timeout" 中提取出服务器节点名称和任务ID:
import re

log_line = "2026-10-31 11:20:05 [ERROR] worker-03 task 4082 timeout"

# 通配符无法完成局部捕获,必须使用正则表达式
log_pattern = re.compile(r"\[ERROR\]\s+(?P<node>[\w-]+)\s+task\s+(?P<task_id>\d+)")
match = log_pattern.search(log_line)

if match:
    data = match.groupdict()
    print("提取结果:", data)
    # 示例输出: 提取结果: {'node': 'worker-03', 'task_id': '4082'}
通配符完全不具备提取局部变量、按规则切割、统计出现次数的能力。一旦需求中出现“提取特定字段”、“格式校验(手机号/邮箱/IP)”、“动态替换”等字眼,正则表达式是唯一选择。
五、选型决策操作流程
在实际项目重构或新功能开发时,可以按照以下清晰的四步流程进行选型,避免“小题大做引入复杂正则”或“强行用通配符导致逻辑漏洞”。
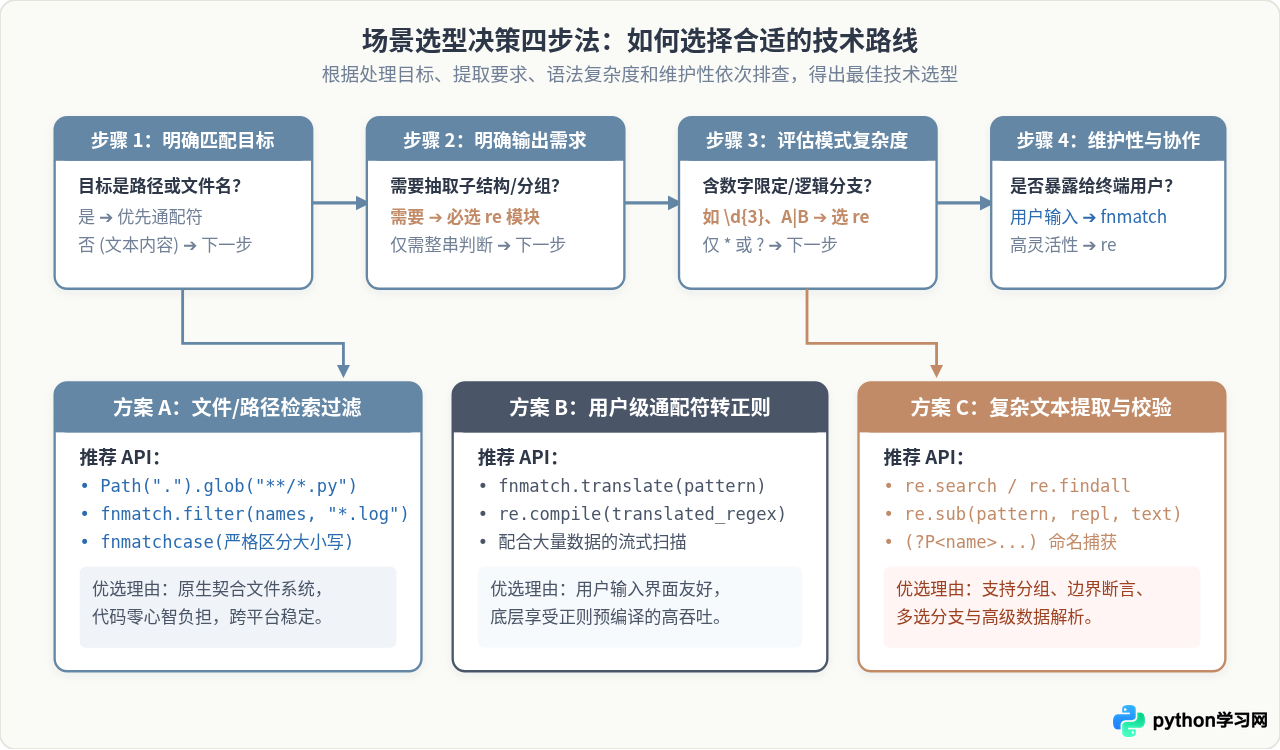
各步骤排查要点如下:
- 步骤 1:明确匹配对象。如果对象是本地文件系统的路径、文件名列表或资源 URI 路径,优先考虑
pathlib.Path.glob()或fnmatch;如果对象是长文本、日志行或网络请求体,直接进入正则链路。 - 步骤 2:明确输出需求。如果只需要返回布尔值(是否匹配)或从列表中挑选元素,通配符能够胜任;如果需要提取匹配子串、获取匹配坐标(索引范围)或对字符串执行模式替换,必须选用
re。 - 步骤 3:评估模式复杂度。如果匹配规则包含数字长度限定(如“恰好6位数字”)、逻辑“或”分支(如
jpeg|png|webp)或非贪婪匹配,通配符语法无法表达,必须使用re。 - 步骤 4:考虑维护成本与使用者属性。如果过滤规则是由终端用户通过配置文件、Web 界面输入的简易查询条件(如让用户输入
*.log),使用通配符或通过fnmatch.translate()转换能够大幅降低用户使用门槛,并规避不可信正则引发的 ReDoS 安全风险。
六、关键差异汇总与开发避坑指南
下表和全景图系统归纳了两者的关键维度差异:
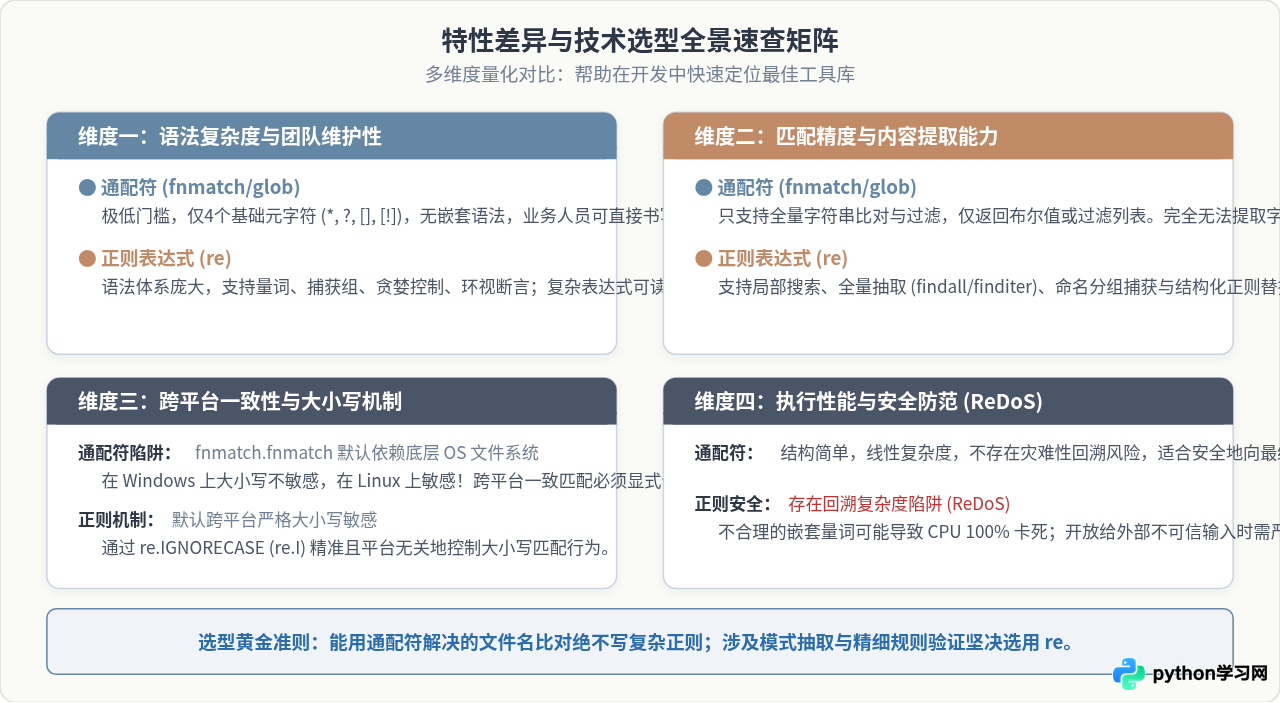
| 对比维度 | 通配符匹配 (fnmatch / glob) | 正则表达式 (re 模块) |
|---|---|---|
| 定位与重心 | 文件路径检索、简单后缀/前缀筛选 | 通用文本模式解析、复杂数据抽取与验证 |
| 语法复杂度 | 极低(仅 *, ?, [], [!] 四种) |
高(丰富元字符、量词、边界锚点、断言) |
| 内容抽取能力 | 无(仅返回布尔值或整串列表过滤) | 极强(支持索引范围、分组捕获与命名分组) |
| 大小写敏感性 | 平台依赖:Windows不敏感,Linux敏感(需用 fnmatchcase 保证一致) |
显式可控:默认严格敏感,通过 re.IGNORECASE 精准控制 |
| 性能与安全边界 | 线性扫描,零安全风险,开销极小 | 功能强大,但需警惕嵌套量词带来的 ReDoS 灾难性回溯 |
| 核心推荐 API | Path.glob(), fnmatch.filter(), fnmatchcase() |
re.compile(), re.search(), re.sub() |
- 注意 fnmatch 的跨平台大小写陷阱:
fnmatch.fnmatch("File.TXT", "*.txt")在 Windows 上会返回True,但在 Linux 服务器上部署时会返回False!如果需要跨平台保持严格一致的大小写比对,必须使用fnmatch.fnmatchcase()。 - 勿将通配符直接塞入正则函数:诸如
re.match("*.py", text)会因未提供前导字符直接报错;re.match(".*\.py", text)中点号未转义则会导致apy也会被错误匹配。 - 路径斜杠处理:在
glob和pathlib中,单个*不会跨越目录分隔符/,跨目录需显式使用**;而在fnmatch中,默认会将/视作普通字符处理。
总结而言,选择通配符还是正则表达式,本质上是权衡“直观简易”与“表达能力”。在绝大多数文件查找和简单格式筛选任务中,优先选用 pathlib.Path.glob() 或 fnmatch 能够让代码清晰易读、便于团队维护;而一旦涉及深度的文本结构抽取、数据清洗或严格的格式验证,则应当毫不犹豫地使用 re 模块。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















