


Python多线程与多进程的核心区别:GIL限制与适用场景
深入解析Python多线程与多进程的核心区别,剖析CPython全局解释器锁(GIL)底层机制、内存模型差异与性能特征,提供完整的I/O与CPU密集型基准测试代码与工程选型决策路径。
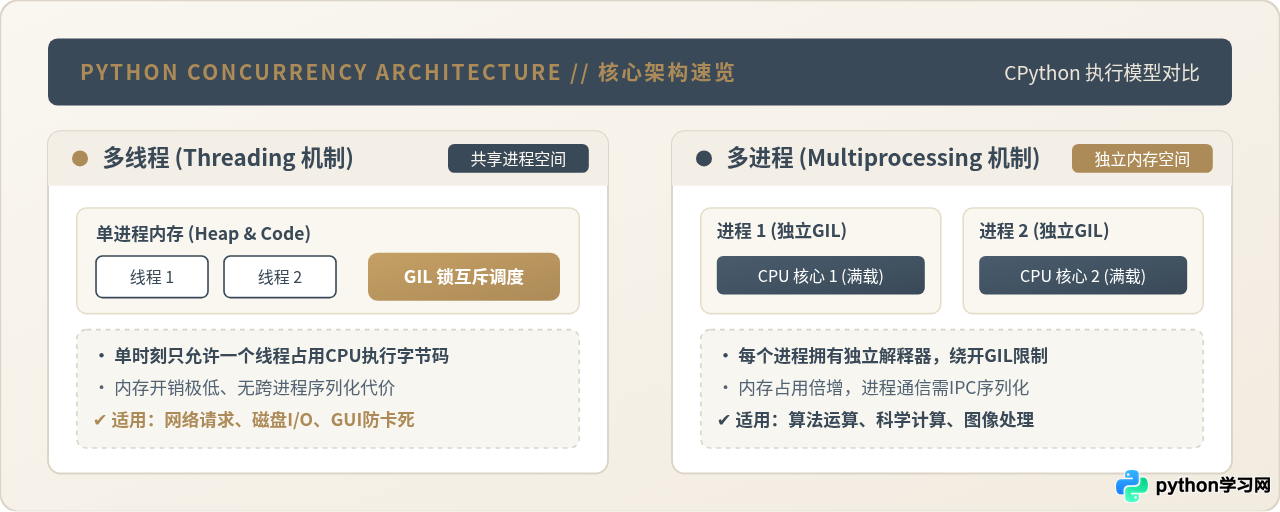
一、核心限制源头:什么是 GIL 以及它如何影响多线程
要透彻理解 Python 并发编程的选择,必须先从 GIL(Global Interpreter Lock,全局解释器锁) 说起。GIL 并非 Python 语言层面的语法规范,而是官方主导的 CPython 解释器特有的互斥锁机制。
在 CPython 早期设计中,对象的内存生命周期采用引用计数(Reference Counting)机制进行管理。每个 Python 对象内部都维护着一个 ob_refcnt 计数器。当一个对象在多个线程之间被引用或传递时,计数器的增减操作若缺少同步保护,极易引发竞态条件(Race Condition),进而造成内存泄漏或访问非法内存指针引发段错误(Segmentation Fault)。
为了简单、稳定且高效地解决引用计数与 C 扩展库的线程安全问题,CPython 引入了 GIL:在解释器进程级别设置一把全局互斥大锁,任何线程在执行任何 Python 字节码之前,必须首先争夺并持有这把锁。
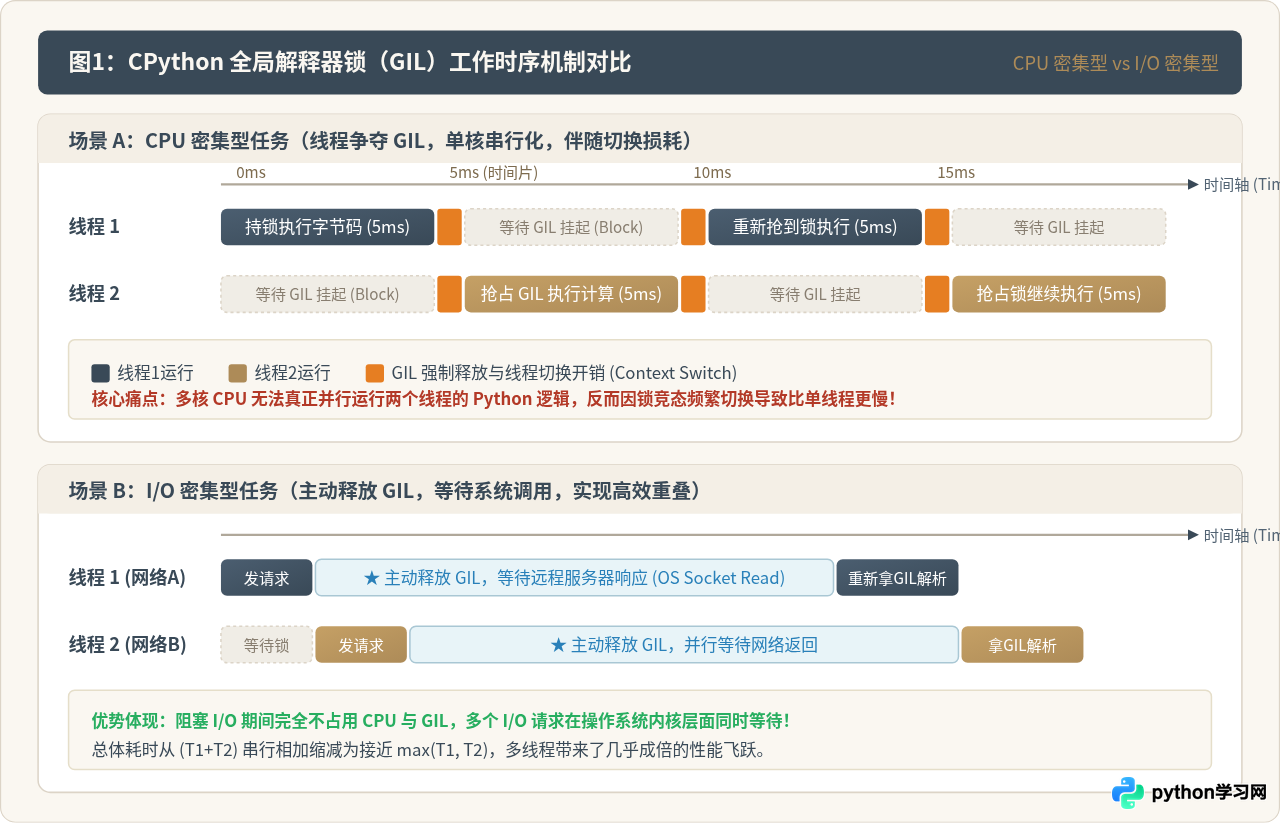
如图 1 所示,GIL 对不同工作负载的影响呈现完全相反的两极分化:
-
CPU 密集型任务(图 1 场景 A):各个线程都在持续执行纯算力逻辑(如数值运算、大字典排序)。根据 CPython 的调度规则,解释器默认每执行一定时间(通过
sys.getswitchinterval()查询,默认约 5 毫秒)或若干字节码后,当前线程会被强制释放 GIL。此时,多个线程会陷入剧烈的锁争夺和内核上下文切换(Context Switch)。由于计算无法真正并行,频繁的唤醒与挂起反而产生了额外的开销,导致多线程跑计算甚至比单线程还要慢。 -
I/O 密集型任务(图 1 场景 B):当线程执行到外部 I/O 操作时(例如调用
socket.recv()、执行 HTTP 请求、等待磁盘文件写入或执行time.sleep()),底层操作系统接口会在发起阻塞系统调用前主动释放 GIL。此时,操作系统内核负责监控网络数据包的收发,而其他就绪的 Python 线程可以立刻接管 GIL 继续执行业务代码。这样,多个耗时的 I/O 等待在操作系统层面完全重叠,实现了极高的并发吞吐效率。
二、多进程机制:突破 GIL 限制的物理多核并行
既然单一解释器受制于 GIL,Python 官方提供的 multiprocessing 模块便采取了另一种解决路径:既然锁是属于解释器的,那就为每个任务单独启动一个完整的解释器进程。
在多进程模式下,操作系统为每个进程分配独立且隔离的虚拟内存空间、独立的运行栈、独立的全局对象池,以及各自独立的 GIL 锁。
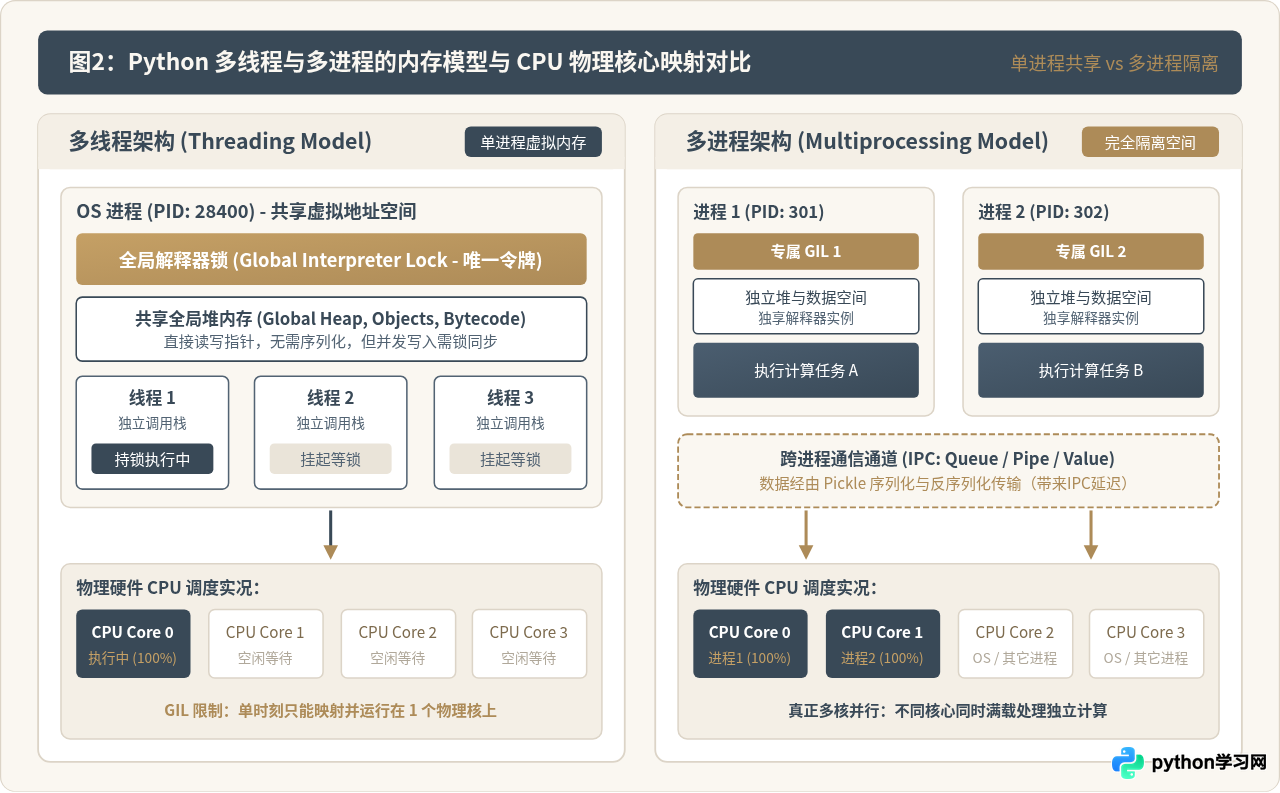
从图 2 可以清晰看出两种并发模型的系统层级差异:
-
多核计算真正释放:主进程通过
fork(Linux/macOS)或spawn(Windows/macOS)创建子进程后,操作系统调度器会直接将不同的子进程分配到不同的物理 CPU 核心上(如 Core 0 与 Core 1)。由于每个进程都在自己的独立解释器内运转,彼此之间没有任何 GIL 互斥,真正达成了硬件层面的多核 100% 满载并行计算。 - 隔离带来的内存代价:多线程的内存开销极小,创建新线程仅需分配少量私有栈空间(通常数十 KB 到几百 KB),共享父进程的全局变量和对象;而每个多进程实例都需要加载 Python 基础运行环境、模块代码和上下文数据,初始内存占用通常在 20MB 到 50MB 之间。如果盲目开启上百个子进程,容易造成系统物理内存耗尽(OOM)。
-
数据通信复杂度(IPC):多线程可以直接通过内存指针访问全局变量(只需注意使用
threading.Lock防止写冲突);而多进程之间内存物理隔离,若要在进程间传递数据,必须经过multiprocessing.Queue、Pipe或共享内存。在队列中传输 Python 对象时,后台必须经历 Pickle 序列化(将对象转为二进制字节流)与 反序列化 过程,传输大型复杂数据对象会产生显著的 CPU 与内存拷贝延迟。
三、基准测试代码:直观验证性能差异
为了让结论具备扎实的数据依据,我们可以通过标准 Python 3(无需安装第三方依赖)编写一组对比基准代码,分别在 CPU 密集型与 I/O 密集型两种典型场景下,测量单线程、多线程与多进程的实际耗时。
1. CPU 密集型基准测试(大范围质数计数计算)
# benchmark_cpu.py (运行环境:Python 3.8+,四核以上环境)
import time
import math
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def count_primes(limit):
    """CPU密集型任务:计算小于 limit 的质数数量"""
    count = 0
    for num in range(2, limit):
        is_prime = True
        for i in range(2, int(math.isqrt(num)) + 1):
            if num % i == 0:
                is_prime = False
                break
        if is_prime:
            count += 1
    return count

if __name__ == '__main__':
    tasks = [150000] * 4  # 4个计算量相同的子任务

    # 1. 串行单线程基准
    t0 = time.perf_counter()
    res_single = [count_primes(n) for n in tasks]
    t_single = time.perf_counter() - t0
    print(f"单线程串行执行耗时 : {t_single:.2f} 秒")

    # 2. 多线程执行 (4个工作线程)
    t0 = time.perf_counter()
    with ThreadPoolExecutor(max_workers=4) as executor:
        res_thread = list(executor.map(count_primes, tasks))
    t_thread = time.perf_counter() - t0
    print(f"多线程并发执行耗时 : {t_thread:.2f} 秒")

    # 3. 多进程执行 (4个工作进程)
    t0 = time.perf_counter()
    with ProcessPoolExecutor(max_workers=4) as executor:
        res_proc = list(executor.map(count_primes, tasks))
    t_proc = time.perf_counter() - t0
    print(f"多进程并行执行耗时 : {t_proc:.2f} 秒")
典型控制台示例输出(4核硬件环境):
多线程并发执行耗时 : 4.38 秒 (比单线程更慢!GIL频繁争抢与上下文切换惩罚)
多进程并行执行耗时 : 1.25 秒 (大幅提速约 3.3 倍!4 个核心真正同时满载运算)
2. I/O 密集型基准测试(模拟并发网络延迟)
# benchmark_io.py (运行环境:Python 3.8+)
import time
from concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor

def simulate_network_fetch(url_id):
    """I/O密集型任务:模拟发起 HTTP 请求并等待 1 秒返回"""
    time.sleep(1.0)  # 底层进入 C 语言系统休眠,主动释放 GIL
    return f"Task {url_id} Done"

if __name__ == '__main__':
    tasks = list(range(10))  # 10个并发网络请求任务

    # 1. 串行单线程
    t0 = time.perf_counter()
    [simulate_network_fetch(i) for i in tasks]
    t_single = time.perf_counter() - t0
    print(f"I/O 单线程串行耗时 : {t_single:.2f} 秒")

    # 2. 多线程池 (10个工作线程)
    t0 = time.perf_counter()
    with ThreadPoolExecutor(max_workers=10) as executor:
        list(executor.map(simulate_network_fetch, tasks))
    t_thread = time.perf_counter() - t0
    print(f"I/O 多线程并发耗时 : {t_thread:.2f} 秒")

    # 3. 多进程池 (10个工作进程)
    t0 = time.perf_counter()
    with ProcessPoolExecutor(max_workers=10) as executor:
        list(executor.map(simulate_network_fetch, tasks))
    t_proc = time.perf_counter() - t0
    print(f"I/O 多进程并发耗时 : {t_proc:.2f} 秒")
典型控制台示例输出:
I/O 多线程并发耗时 : 1.02 秒 (提速近 10 倍!GIL 自动让渡,轻量且高效)
I/O 多进程并发耗时 : 1.35 秒 (同样提速,但进程创建与IPC销毁额外耗费了 300ms)
四、工程实操选型:4 步决策路径与避坑指南
在实际项目开发中,技术选型不应停留在抽象的理论讨论中,而需要根据业务指标、数据流动与硬件条件,按标准化步骤进行推导排查。
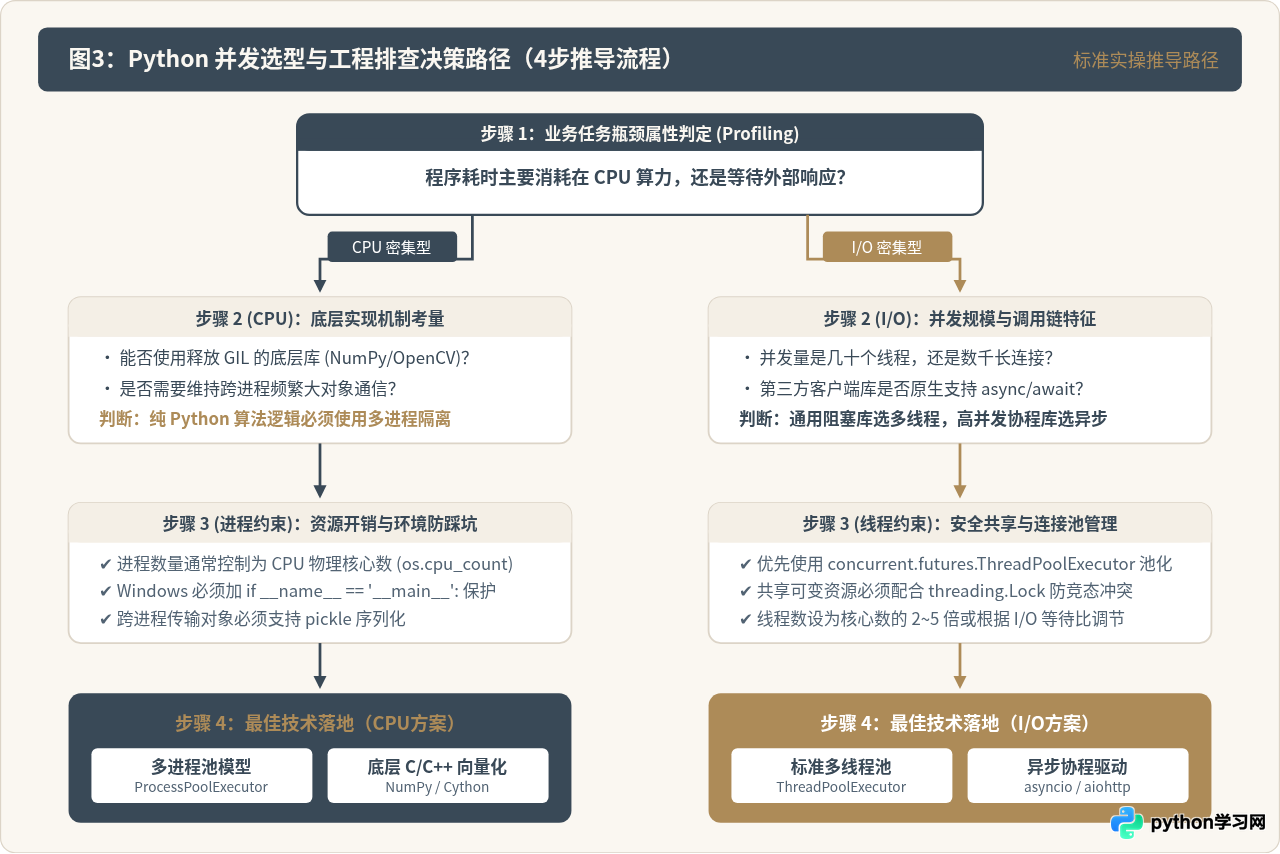
依据图 3 的决策流,工程落地应严格执行以下 4 个阶段:
第 1 步:分析任务瓶颈是算力还是等待
在启动并发改造前,先通过性能分析工具(如 cProfile 或简单的耗时打点)确认程序耗时卡在何处:
- 典型 I/O 密集型:网页网络爬虫、REST API 微服务调用、第三方 SDK 请求分发、数据库查询等待、批量磁盘日志扫描。该场景首选多线程(或异步协程)。
- 典型 CPU 密集型:高分辨率图片裁剪与缩放、大批量数据加解密、复杂正则匹配提取、科学计算与蒙特卡洛模拟。该场景必须使用多进程或 C 扩展。
第 2 步:评估状态共享与数据通信成本
如果任务是 CPU 密集型,需要进一步核对:子任务之间是否需要高频同步几个 GB 的大型内存字典?
-
如果是,多进程的 Pickle 传输开销可能吃掉多核带来的加速收益。此时应优先考虑通过
multiprocessing.shared_memory(Python 3.8+ 提供的原生共享内存)或改用带有并行支持的 C 扩展库(如 NumPy,其底层矩阵计算是在 C 语言层执行并主动释放 GIL 的)。 - 如果各任务属于独立的“分治计算”(例如给 100 张图片分别做锐化处理,输入文件路径,输出处理结果),各进程完全无共享依赖,这是多进程的最理想落地场景。
第 3 步:规避跨平台环境核心陷阱
- 入口守卫不可遗漏:在 Windows 和 macOS(Python 3.8+ 默认使用 spawn 启动模式)下,所有多进程创建代码必须包裹在
if __name__ == '__main__':之后,否则子进程在导入模块时会循环递归创建进程,导致系统崩溃。 - 进程池规模与 CPU 核心对齐:CPU 密集型任务的进程数量一般设置为物理核心数或逻辑核心数(即
os.cpu_count())。创建超过 CPU 物理核数的计算进程不会带来性能提升,只会加剧操作系统的进程上下文切换负担。 - Pickle 序列化兼容性:传递给子进程的函数和参数对象必须是“顶层可导入”的。内部嵌套函数(nested function)、lambda 匿名函数以及部分未导出的生成器对象无法被 pickle 序列化,会导致子进程抛出
AttributeError: Can't pickle local object异常。
第 4 步:技术方案落地与代码库选型
在现代 Python 开发中,强烈建议使用标准库 concurrent.futures 代替低阶的 threading.Thread 和 multiprocessing.Process 手动管理:
-
ThreadPoolExecutor与ProcessPoolExecutor实现了完全统一的高层面向对象接口(均提供submit()、map()与Future对象)。 - 当业务瓶颈发生迁移(例如原本做本地模拟改为调用外部微服务),开发者只需修改一行执行池实例化代码,而无需重构所有的任务分发逻辑,大幅提升了系统的可维护性。
五、多线程与多进程综合对比总结
为了方便日常开发查阅,下表与图 4 总结了两种并发方案在各个核心维度的对照关系:
| 对比维度 | 多线程 (threading) | 多进程 (multiprocessing) |
|---|---|---|
| GIL 的影响 | 受制于单一 GIL 锁,同一时间仅单核运行 Python 代码 | 每个进程拥有独立解释器与 GIL,多核完全并行运行 |
| 资源与内存占用 | 极低,共享同一进程内存,仅占轻量级线程私有栈 | 较高,子进程独立载入 Python 运行时环境(约数十 MB/进程) |
| 数据通信机制 | 天然共享内存变量指针,需通过 Lock 防止写冲突 |
内存物理隔离,依赖 Queue/Pipe/SharedMemory,涉及序列化 |
| 多核 CPU 利用率 | CPU 密集型下多核利用率为 0%(仅 1 核工作) | 可达到 100% 满负荷调动所有硬件物理核心 |
| 异常与崩溃隔离 | 隔离性差,一个线程触发段错误或致命异常可导致整个进程崩溃 | 隔离性极高,单个子进程崩溃不会破坏主进程及其余子任务 |
| 主流推荐工具 | concurrent.futures.ThreadPoolExecutor |
concurrent.futures.ProcessPoolExecutor |
| 最佳适用场景 | 网络请求、Web API 调用、磁盘文件读写、GUI 后台任务 | 科学计算、数据预处理、机器学习训练、媒体编解码与批量压缩 |
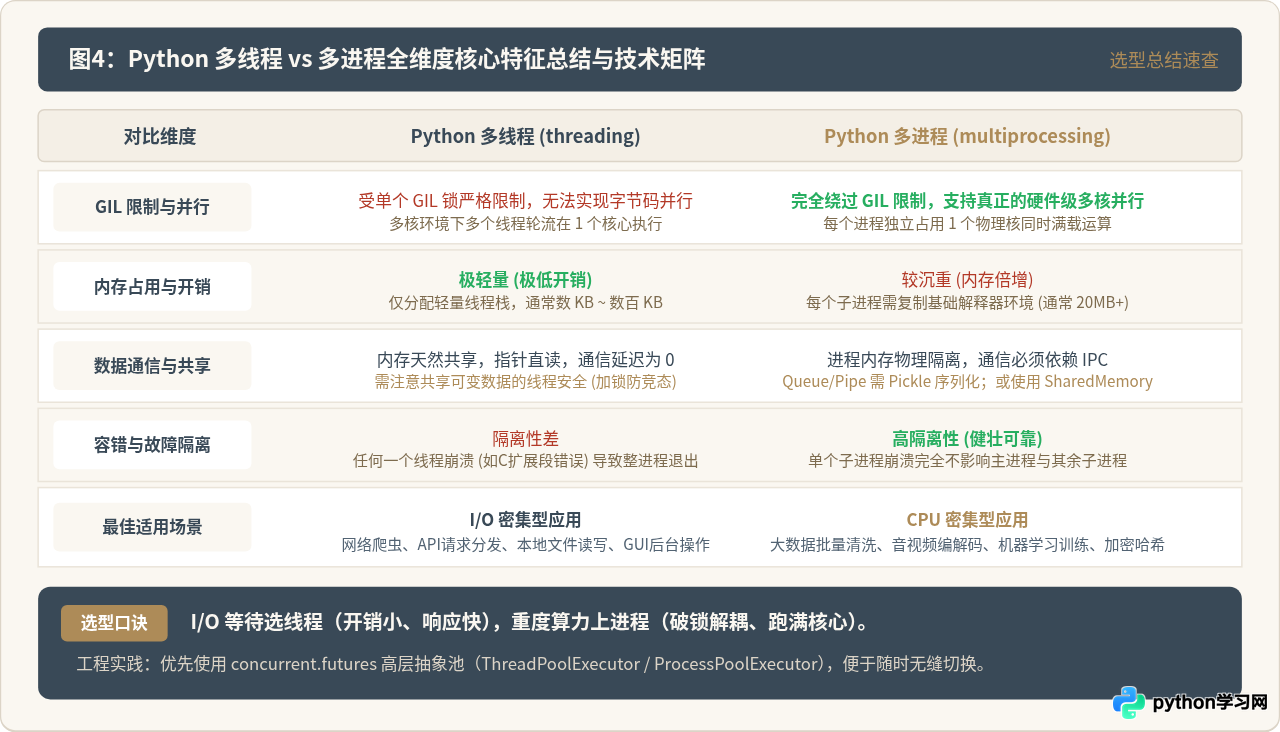
总结建议:面对并发需求,先测算耗时瓶颈。如果是网络交互与文件等待,使用 多线程池(ThreadPoolExecutor) 或 asyncio 协程 能以最轻量的内存消耗带来数倍吞吐提升;如果是重度数学计算、文本解析与数据转换,必须使用 多进程池(ProcessPoolExecutor) 冲破 GIL 枷锁,彻底调动服务器的多核算力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















