


Python面试高频编程题汇总:数据结构与算法实战解析
针对Python技术面试高频编程题进行深度实战解析,涵盖双指针、滑动窗口、链表操作、单调栈与动态规划,提供规范代码实现、复杂度推导、内存模型辨析及避坑指南。
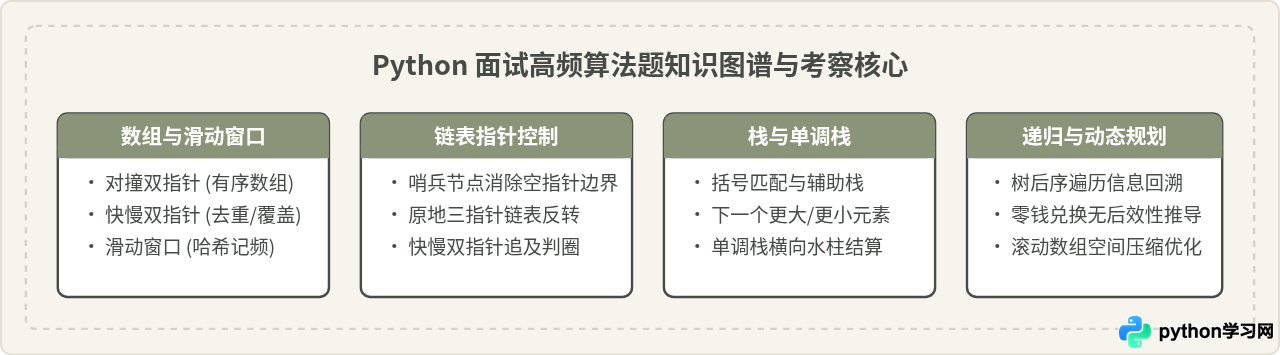
在 Python 技术面试中,编程题考察的核心不是记忆生僻冷门的算法技巧,而是对基础数据结构底层特性的理解、边界条件的严谨处理以及代码的时空复杂度优化能力。本文精选面试出现频率最高、极具代表性的四类核心题型(双指针与滑动窗口、链表操作与哨兵机制、单调栈原理以及动态规划状态转移),结合具体问题推导完整求解步骤,深入剖析 Python 语言内部机制对算法执行的影响,并对候选人常踩的代码陷阱与认知误区进行对比辨析。
一、双指针与滑动窗口:无重复字符的最长子串
滑动窗口是解决“连续子数组”或“连续子串”极值问题最直接且高效的方法。经典面试题目要求:给定一个字符串 s,请找出其中不含有重复字符的最长子串的长度。
1. 解题思路与推导步骤
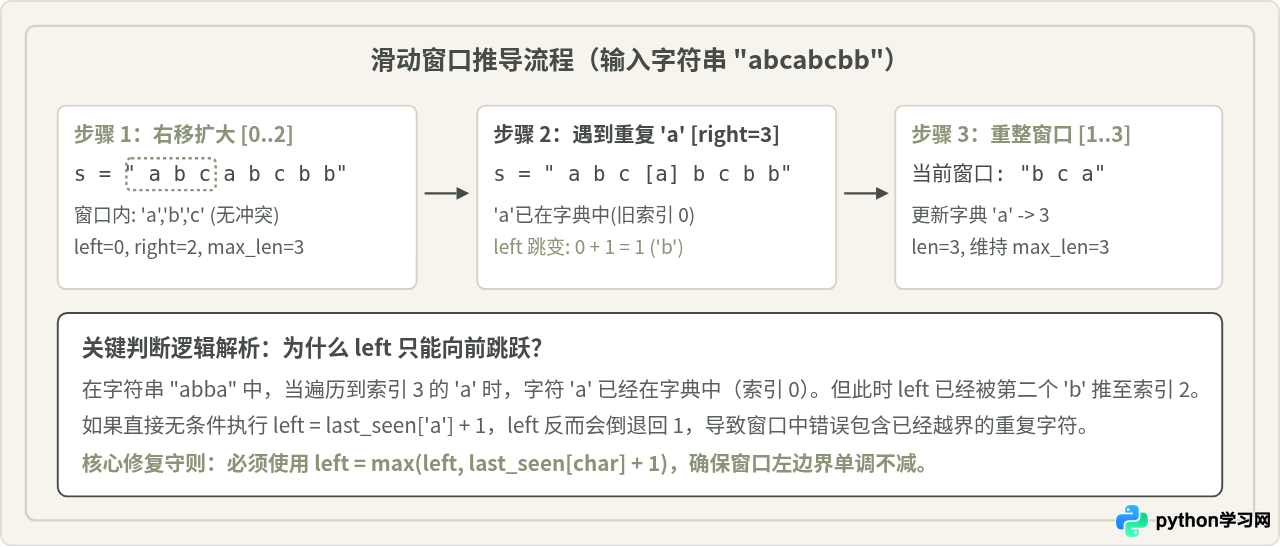
暴力求解通常需要双重循环枚举所有子串起点与终点,并使用集合判断是否包含重复项,其时间复杂度为 $O(n^2)$ 或 $O(n^3)$。而滑动窗口通过维护一个区间 [left, right],保证窗口内任意时刻都不存在重复字符:
- 初始化指针与哈希表:设置左指针
left = 0,使用字典last_seen记录每个字符最后一次出现的索引下标,维护全局最大长度max_len = 0。 - 右指针扩张:右指针
right从0遍历至len(s) - 1,设当前字符为char = s[right]。 - 收缩左边界:如果
char已经在last_seen中存在,且记录的上一次出现位置大于或等于当前的left,说明窗口内发生了重复。此时必须直接将left更新为last_seen[char] + 1。 - 更新状态:更新
last_seen[char] = right,并计算当前无重复窗口长度right - left + 1,更新max_len。
2. 规范代码实现与复杂度分析
执行环境为标准 Python 3.8+,算法直接使用原生类型,无需引入外部依赖:
def length_of_longest_substring(s: str) -> int:
    last_seen = {}
    left = 0
    max_len = 0

    for right, char in enumerate(s):
        # 若字符在窗口内已出现,收缩左边界
        if char in last_seen and last_seen[char] >= left:
            left = last_seen[char] + 1

        last_seen[char] = right
        current_len = right - left + 1
        if current_len > max_len:
            max_len = current_len

    return max_len

# 示例验证
sample_input = "pwwkew"
# 正确返回 3 (子串 "wke")
- 时间复杂度:$O(n)$。字符串长度为 $n$,右指针单向遍历每个字符一次,Python 字典查找和更新平均时间为 $O(1)$,整体验证只需要一次扫描。
- 空间复杂度:$O(\min(m, n))$。$m$ 为字符集的大小(ASCII 编码最多 128 个字符,扩展 Unicode 最多 $n$ 个键值对)。
3. 常见易错说法辨析
常见误区:“用 while s[right] in s[left:right]: left += 1 也能写出双指针滑动窗口,代码更简短易读。”
辨析说明:这种写法在功能上能够跑通测试用例,但在面试中往往会被直接扣分。Python 的字符串切片 s[left:right] 会在内存中创建新的字符串对象,具有 $O(k)$ 的内存分配与拷贝开销,而 in 关键字在线性字符串搜索中也是 $O(k)$。内层 while 循环结合切片会导致整体时间复杂度在恶劣情况下退化为 $O(n^2)$。正确的方式是借助哈希表记录位置,实现 $O(1)$ 的直接索引跳跃。
二、链表操作与指针控制:反转链表与环形检测
链表是考察指针变换和内存引用最基础、最严谨的数据结构。在 Python 中,对象之间全为引用传递,链表面试中出现频率最高的两个核心机制是哨兵节点(Dummy Node)与快慢双指针(Floyd 判圈法)。
1. 哨兵节点消除头节点特殊分支
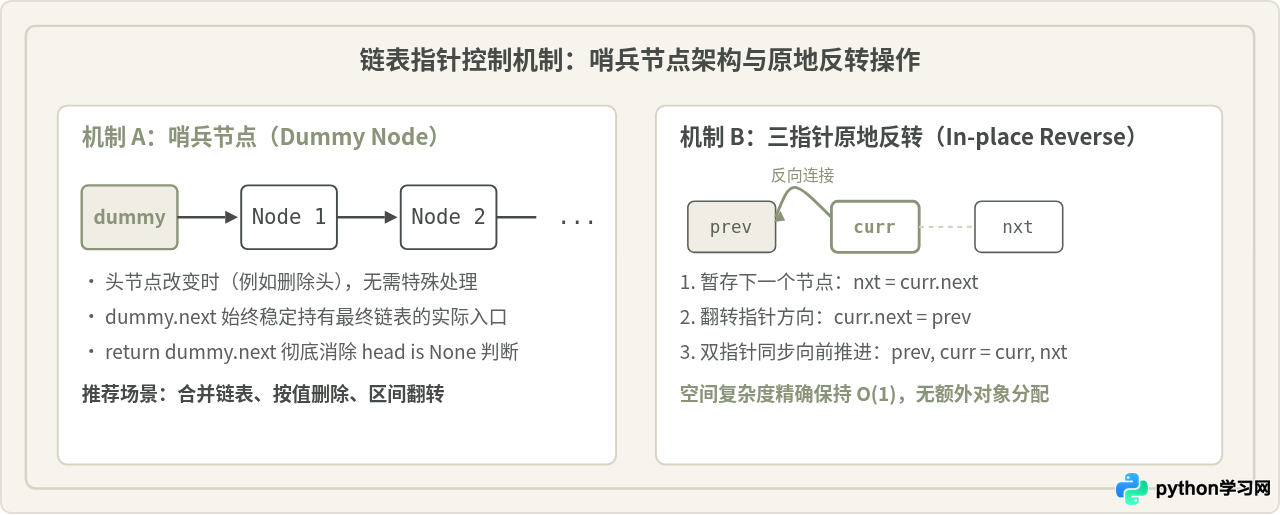
当题目涉及删除链表节点、两两交换节点或合并有序链表时,头节点本身可能被修改或替换。常规做法是在每一步都写 if head is None 或 if target == head,不仅代码分支臃肿,极易在面试紧张时漏写边缘分支。
标准做法:在 head 前创建一个虚拟的 dummy = ListNode(0),并将 dummy.next = head。如此一来,原始的头节点就被降级为一个具备前驱节点的普通节点,所有新增、删除或翻转逻辑完全统一,最后只需返回 dummy.next。
2. 经典实现:K 个一组翻转链表与环形链表
反转链表要求将单链表节点全部翻转。以下是规范的原地反转与快慢指针判环代码:
class ListNode:
    def __init__(self, val=0, next=None):
        self.val = val
        self.next = next

def reverse_list(head: ListNode) -> ListNode:
    prev = None
    curr = head
    while curr:
        nxt = curr.next
        curr.next = prev
        prev = curr
        curr = nxt
    return prev

def has_cycle(head: ListNode) -> bool:
    """Floyd 快慢指针判圈算法"""
    if not head or not head.next:
        return False
    slow = head
    fast = head
    while fast and fast.next:
        slow = slow.next
        fast = fast.next.next
        if slow is fast:
            return True
    return False
- 快慢指针原理:如果链表存在环,快指针
fast(每次走 2 步)与慢指针slow(每次走 1 步)一旦同时进入环内,快指针相对于慢指针每走一步距离缩减 1,必然会在某一时刻相遇;如果不存在环,快指针必然先到达None。 - 时空开销:时间复杂度均为 $O(n)$,空间复杂度严格为 $O(1)$。
三、单调栈原理:接雨水与下一更大元素
单调栈用于在 $O(n)$ 时间内寻找序列中每个元素左侧或右侧“第一个比它大”或“第一个比它小”的元素。其核心性质是:栈内存储元素下标,且对应的高度(或数值)保持严格单调递增或递减。
1. 接雨水(Trapping Rain Water)解法推导
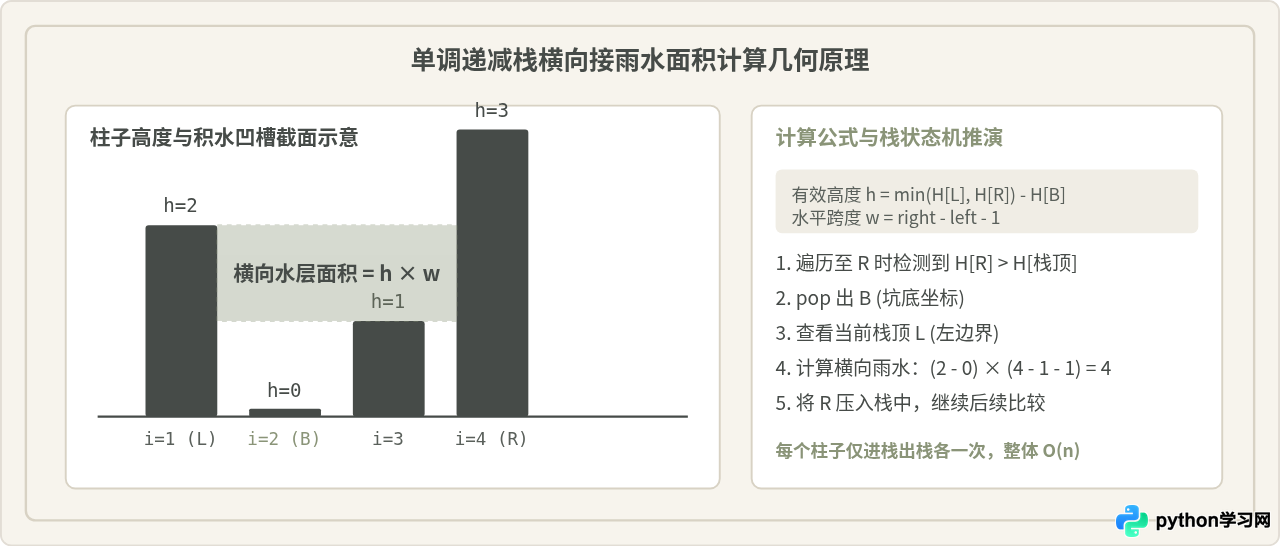
给定 $n$ 个非负整数表示每个宽度为 1 的柱子高度图,计算按此排列的柱子下雨后能接多少雨水。单调递减栈采用横向切片统计法:
- 遍历数组,维护一个单调递减的栈(存放柱子索引)。当当前柱子高度小于等于栈顶柱子高度时,直接入栈,因为这构成了一个潜在的水槽下降边缘。
- 当遇到一根比栈顶高的柱子时,说明找到了右侧边界。弹出栈顶元素,记作坑底
bottom = stack.pop()。 - 若此时栈为空,说明该坑底左侧没有更高的柱子能够挡水,无法蓄水,跳过。
- 若栈非空,此时的栈顶就是左边界
left = stack[-1]。 - 计算水坑的高度差:$h = \min( ext{height}[left], ext{height}[right]) - ext{height}[bottom]$。
- 计算水坑的宽度:$w = right - left - 1$。蓄水量增加 $h imes w$。
2. 规范代码实现
def trap(height: list[int]) -> int:
    stack = []
    water = 0

    for right, h in enumerate(height):
        # 只要当前柱子比栈顶柱子高,就形成了可蓄水的凹槽
        while stack and h > height[stack[-1]]:
            bottom = stack.pop()
            if not stack:
                break
            left = stack[-1]
            # 计算受限高度与横向距离
            bounded_height = min(height[left], h) - height[bottom]
            distance = right - left - 1
            water += bounded_height * distance

        stack.append(right)

    return water
- 复杂度:时间复杂度严格为 $O(n)$,因为每个索引最多被
append一次并被pop一次;空间复杂度为 $O(n)$,用于存放单调栈。
四、动态规划与记忆化搜索:零钱兑换与状态压缩
动态规划的核心在于将原问题分解为无后效性的重叠子问题,并建立明确的状态转移方程。以高频题“零钱兑换(Coin Change)”为例:给定不同面额的硬币 coins 和一个总金额 amount,计算凑成总金额所需的最少硬币个数;若无法凑出,返回 -1。
1. 贪心算法的反例与动态规划的必然性
很多初学者容易误以为“每次优先选最大面额的硬币”就能得到最优解。这是典型的贪心思维陷阱:
反例验证:设硬币面额为 [1, 3, 4],目标金额为 6。
- 贪心策略:优先选面额 4,剩余 2,接下来只能选 1 + 1,总共需要 3 枚硬币(4 + 1 + 1)。
- 最优策略:选择两枚面额 3,总共只需 2 枚硬币(3 + 3 = 6)。
结论:只有当硬币系统属于“规范货币系统(如特定倍数关系)”时贪心策略才成立;对于通用硬币面额,必须使用动态规划进行全局状态推导。
2. 状态转移与代码实现
定义状态 $dp[i]$ 为凑齐金额 $i$ 所需的最少硬币数:
- 基准状态:$dp[0] = 0$(凑齐金额 0 需要 0 枚硬币)。其余初始值赋为正无穷大
float('inf')或amount + 1。 - 转移方程:对每一个金额 $i$ 从 1 到 $amount$,枚举所有可用硬币 $c$: $$dp[i] = \min_{c \in coins, i \ge c} (dp[i - c] + 1)$$
def coin_change(coins: list[int], amount: int) -> int:
    # 填充 amount + 1 作为不可达上限标记
    dp = [amount + 1] * (amount + 1)
    dp[0] = 0

    for i in range(1, amount + 1):
        for c in coins:
            if i >= c:
                dp[i] = min(dp[i], dp[i - c] + 1)

    return dp[amount] if dp[amount] <= amount else -1
- 复杂度:时间复杂度为 $O( ext{amount} imes k)$($k$ 为硬币种类数);空间复杂度为 $O( ext{amount})$。
五、Python 算法面试高频陷阱与辨析
在 Python 算法面试中,许多候选人虽然算法逻辑正确,但由于忽略了 Python 运行时的底层细节,常常导致性能断崖式下降或遇到隐蔽的逻辑 Bug:
| 考察场景 | 易错写法与认知误区 | 底层风险与实际表现 | 推荐修正方案 |
|---|---|---|---|
| 队列模拟 (BFS) | 使用普通列表 list.pop(0) 作为出队操作 |
列表是连续动态数组,pop(0) 会引发后续所有元素内存平移,时间复杂度退化为 $O(n)$,导致整体 BFS 变为 $O(V + E \cdot n)$ 超时 |
改用 collections.deque,其两端出入队操作 popleft() 底层基于双向链表块,时间保证严格 $O(1)$ |
| 回溯算法路径记录 | 直接将当前路径加入结果集:res.append(path) |
path 是可变列表对象,传给 res 的只是对象引用;回溯弹出元素后,res 中的记录全被修改或变空 |
必须进行浅拷贝:res.append(path[:]) 或 res.append(list(path)) |
| 二维 DP 表初始化 | 使用乘法快捷复制:dp = [[0] * m] * n |
此语法创建的 $n$ 行实际上引用了同一个内层列表内存地址,修改 dp[0][1] 会导致所有行对应位置全部变动 |
采用列表推导式独立创建:dp = [[0] * m for _ in range(n)] |
| 递归深度限制 | 深层 DFS/树遍历未考虑栈溢出 | Python 默认递归深度上限为 1000(可通过 sys.getrecursionlimit() 查看),链化退化时直接触发 RecursionError |
面试中说明退化风险,主动将深度过大的递归改写为显式显式栈迭代,或利用 sys.setrecursionlimit 防御 |
六、面试全流程解题决策与复杂度评估总结
在面试中拿到一道算法题后,不要直接上手写代码。成熟的工程师通常遵循“特征分析 → 模式匹配 → 复杂度预估 → 边界测试”的规范解题路径。下图总结了面对常见题目时的标准判断模型:
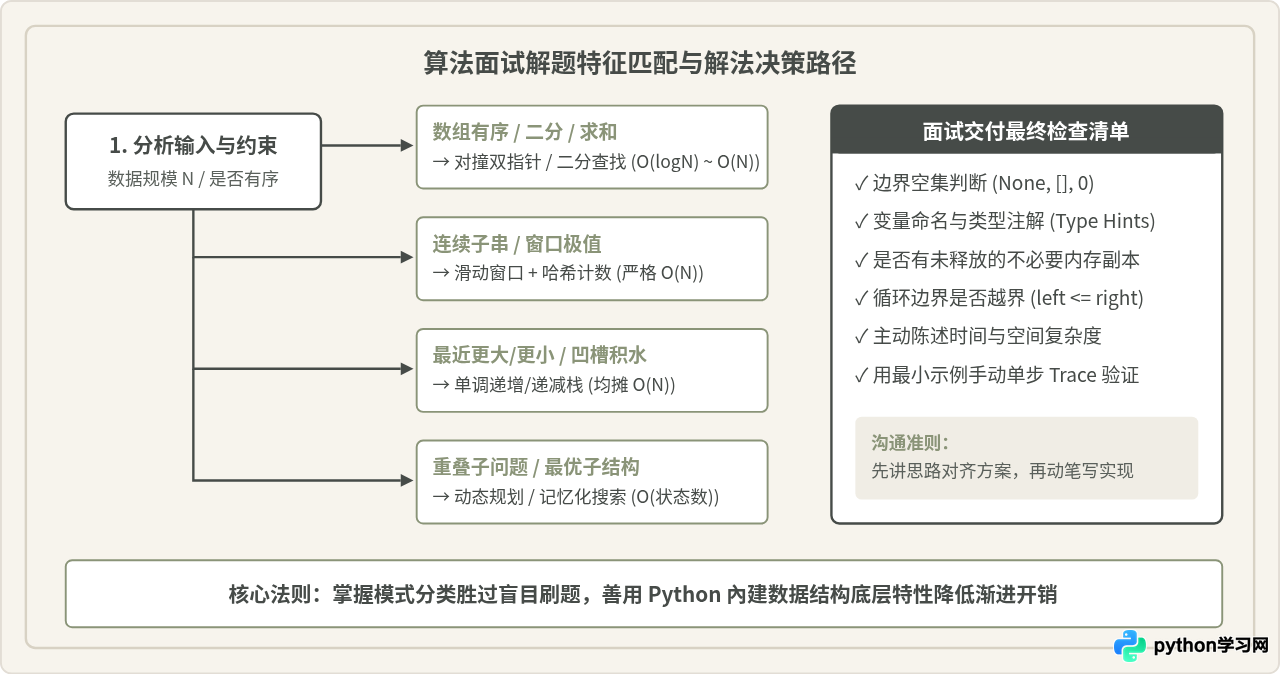
掌握以上高频算法范式与 Python 内部机制的深层联系,能够帮助候选人在面试中快速识别题目核心考点,写出不仅逻辑正确,而且在执行效率、内存占用与异常边界上都经得起检验的高质量工程代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















