


为什么现在面试要懂NumPy2.0破坏性变更?
解析数据科学、机器学习与Python后端面试常考NumPy 2.0破坏性变更的核心原因,涵盖ABI二进制兼容机制、NEP 50类型提升规则、移除API清单、copy参数行为变化及工程排障与迁移步骤。
Python后端、机器学习工程与数据分析岗位在技术面试中频繁考察NumPy 2.0的破坏性变更,直接原因是它是评估候选人“是否具备真实生产环境排障与依赖治理能力”的高效分水岭。NumPy 2.0同时打破了C-API二进制兼容性(ABI)、重写了标量与数组的类型提升规则(NEP 50)、清理了近百个历史别名,并更改了Windows默认整数位宽与副本创建语义。理解这些变更的触发条件、报错特征与迁移步骤,不仅能直接回答面试中的情景排障题,还能防止线上推理与特征工程管线出现静默精度偏移或容器构建崩溃。
一、面试官考察NumPy 2.0变更的三个工程切入点
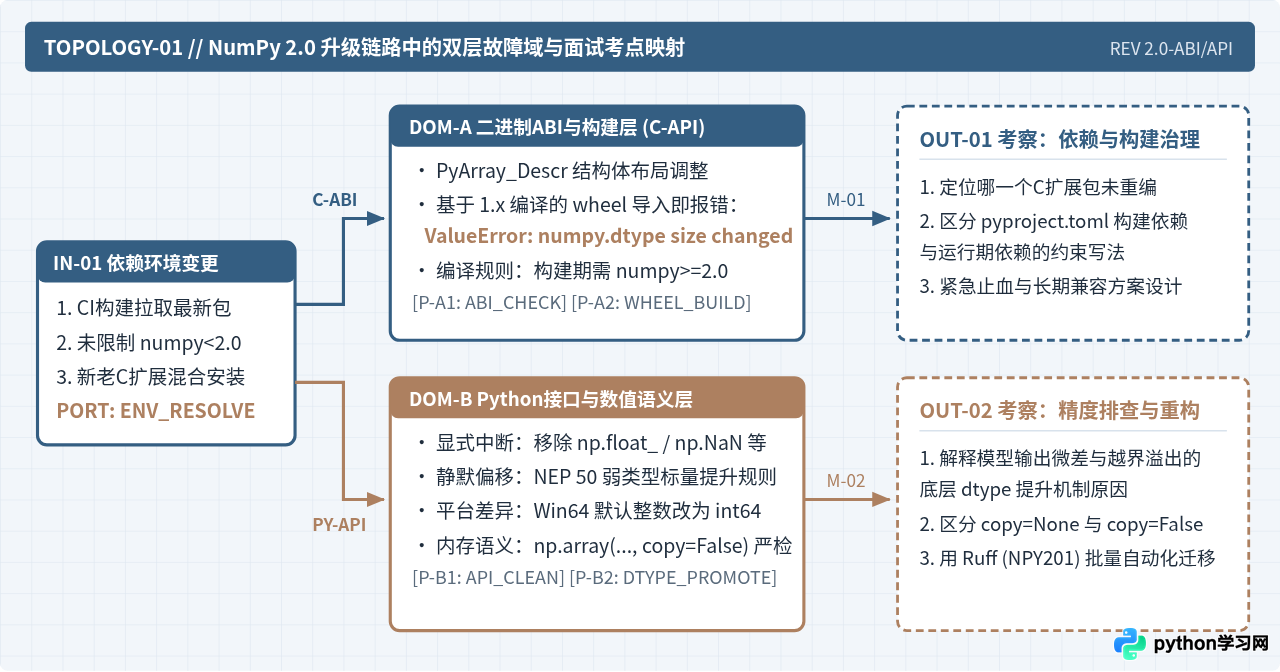
在面试中,面试官很少要求候选人背诵发行说明,而是通过具体的线上故障场景提问。考察重点集中在三个真实工程痛点:容器镜像构建突然报错、模型迁移后预测结果出现微小偏差、以及跨平台代码在Windows与Linux之间行为不一致。
第一个切入点是C扩展包的二进制兼容故障。当项目的requirements.txt存在未锁死上限的依赖,或者新装包触发pip将NumPy升级至2.x时,依赖旧版NumPy 1.x C-API编译的二进制包(如旧版本的scipy、pandas、pyarrow或自研Cython算子)会在导入阶段直接崩溃。面试官借此判断候选人是否理解Python打包中的运行期依赖与构建期依赖差异。
第二个切入点是静默数值变化。Python层面被移除的接口(如np.float_)会立即抛出AttributeError,修复成本很低;但NEP 50类型提升规则的改变不会报错,而是直接将float32数组与Python原生float运算的结果保持为float32(1.x中会提升为float64)。在深度学习特征预处理或金融风控计算中,这种位宽变化会导致线上线下特征不一致,属于典型的深水区面试题。
第三个切入点是第三方库协同升级策略。能够清晰说明如何利用NumPy 2.0向后兼容编译机制(在NumPy 2.0头文件下编译出兼容1.x与2.x的wheel包)的候选人,通常具备扎实的工程化落地经验。
二、核心必考变更1:NEP 50类型提升规则与静默精度变化
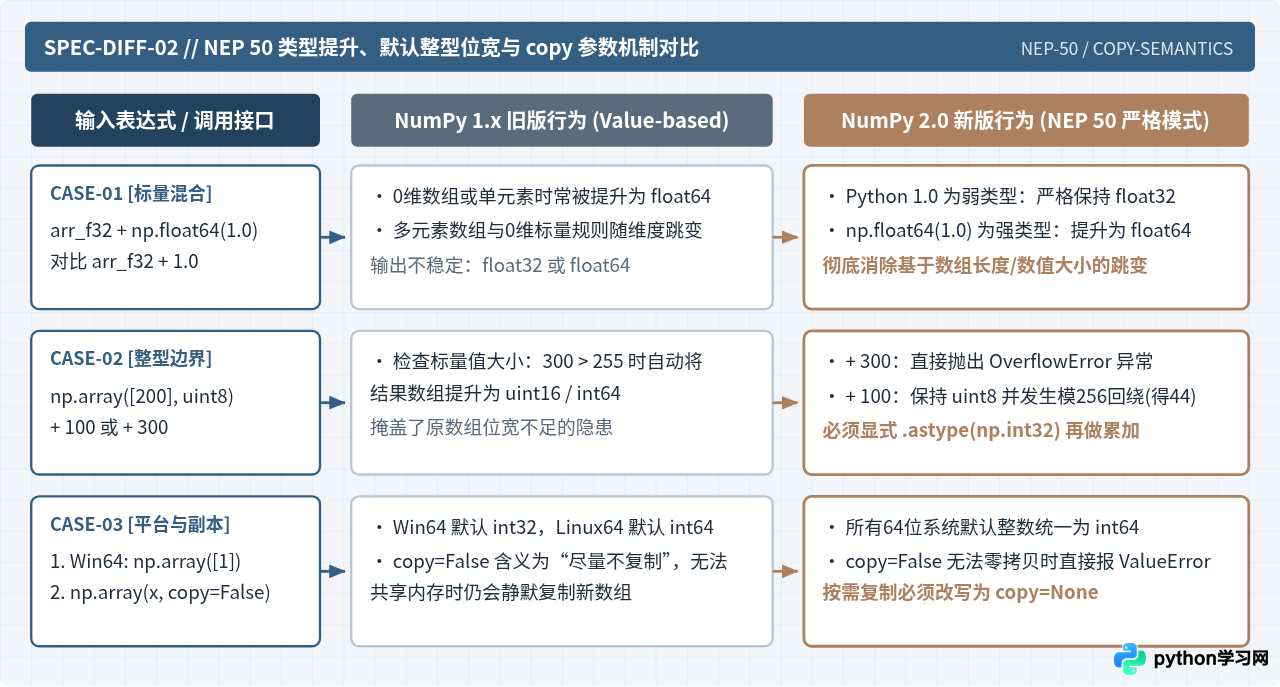
面试中最具区分度的问题是:“升级NumPy 2.0后代码没有任何报错,但推理结果或统计指标与原来不一致,甚至出现整数溢出,原因是什么?”核心答案在于NumPy 2.0正式启用了NEP 50(NumPy Enhancement Proposal 50)类型提升规则,彻底废弃了1.x版本“根据值大小(value-based)动态决定输出类型”的逻辑。
1. 标量不再支配数组精度(弱类型标量机制)
在NumPy 1.x中,当一个float32数组与Python原生浮点数(默认是64位双精度)或float64标量相加时,只要数组元素超过1个,或者处于特定值域,经常会发生向float64的提升;而在处理小整数标量时又会根据数值是否装得下动态判断。NumPy 2.0将Python原生int、float、complex视作“弱类型(weakly-typed)”标量:当数组与Python标量运算时,输出数组严格保留原数组的dtype精度,不再因为混入Python字面量而自动升级为64位。
import numpy as np

# 场景1:float32 数组与 Python float 字面量运算
features = np.array([1.2, 3.4], dtype=np.float32)
scaled = features * 0.5  # 0.5 是 Python float (64位)
print("scaled dtype:", scaled.dtype)

# 场景2:uint8 图像像素数组与超出范围的 Python int 运算
pixels = np.array([100, 200], dtype=np.uint8)
try:
    overflow_check = pixels + 300
    print("overflow_check:", overflow_check)
except OverflowError as exc:
    print("捕获到溢出异常:", type(exc).__name__, "-", exc)

# 场景3:同类型 uint8 内部运算溢出(触发越界回绕,需显式提升类型)
wrapped = pixels + np.uint8(100)
print("uint8 内部回绕结果:", wrapped, "dtype:", wrapped.dtype)# --- NumPy 2.0 示例输出 ---
scaled dtype: float32
捕获到溢出异常: OverflowError - Python integer 300 out of bounds for uint8
uint8 内部回绕结果: [200 44] dtype: uint8
# --- 对照:NumPy 1.26 下的同段代码输出 ---
# scaled dtype: float32 (单元素数组时为 float64,多元素时不一致)
# overflow_check: [400 500] (自动提升为 int16/int64,不报错)img_uint8 + 100并依赖NumPy 1.x在结果越界时自动提升位宽,或写np.uint8(200) + 100。在NumPy 2.0中,若Python整数本身超出目标无符号整型范围(如uint8配300)会直接抛出OverflowError;若在范围之内(如pixels + 100),运算会在uint8内直接截断回绕(200 + 100变成44)。需要高精度累加时,必须在运算前调用pixels.astype(np.int32)。
2. Windows 64位平台默认整数位宽统一为 int64
在NumPy 1.x中,默认整数类型跟随C语言的long类型:Linux和macOS(LP64模型)上np.array([1, 2]).dtype是int64,而在64位Windows(LLP64模型)上C语言的long只有32位,因此默认类型是int32。NumPy 2.0将所有64位操作系统的默认整数统一改为int64。
面试中若问及“升级后Windows服务器上的ONNX Runtime、TensorRT或自定义C++扩展接口突然报类型不匹配”,原因正是原先未显式指定dtype的整数数组从int32变成了int64。修复办法是在创建数组时显式声明dtype=np.int32或dtype=np.int64,不依赖平台默认行为。
三、核心必考变更2:Python API清理与 copy 参数语义重写
除了数值精度问题,面试代码审查(Code Review)环节常要求候选人直接指出旧代码在NumPy 2.0下会报错的位置,并写出兼容1.x与2.0的替代写法。
1. np.array() 中 copy 参数的三态拆分
在NumPy 1.x中,np.array(obj, copy=False)的实际行为是“如果能共享内存就不复制,如果由于类型转换或内存不连续必须复制,就静默创建副本”。这导致开发者误以为自己实现了零拷贝,实则在生产环境中产生了大量隐式内存分配。
NumPy 2.0将copy参数严格定义为三个取值:
copy=True(默认):始终分配新内存并创建数组副本。copy=None:尽可能复用现有内存视图;仅在类型转换或内存布局要求必须复制时才创建副本(等价于np.asarray())。copy=False:严格禁止复制。如果底层无法在不复制数据的前提下构造视图,立即抛出ValueError: Unable to avoid copy while creating an array as requested。
此外,关联的自定义对象协议__array__(self, dtype=None, copy=None)也新增了copy关键字参数。如果项目中有自定义的Dataset或Tensor封装类实现了__array__方法但未接收copy参数,在NumPy 2.0调用时会抛出TypeError。
2. 高频被移除的顶层别名与替代对照表
NumPy 2.0主命名空间移除了约100个长期处于弃用状态的别名。面试中最常出现的报错及标准替换方式如下表所示:
| 被移除的旧写法 (NumPy 1.x) | NumPy 2.0 报错类型 | 标准替代写法(同时兼容 1.26 与 2.0) | 适用场景说明 |
|---|---|---|---|
np.float_ / np.complex_ |
AttributeError |
np.float64 / np.complex128 |
声明64位浮点或128位复数类型 |
np.int_ / np.uint |
AttributeError |
np.int64(或np.intp) |
注意np.int_在2.0中虽保留为平台整型别名,但旧代码常与np.int0混用,np.int0已彻底移除 |
np.NaN / np.Inf / np.Infinity |
AttributeError |
np.nan / np.inf |
缺失值与无穷大常量统一仅保留全小写名称 |
np.product / np.cumproduct |
AttributeError |
np.prod / np.cumprod |
数组元素连乘与累乘计算 |
np.row_stack / np.in1d |
AttributeError |
np.vstack / np.isin |
按行堆叠数组与集合成员存在性判断 |
np.trapz |
AttributeError |
np.trapezoid(或scipy.integrate.trapezoid) |
复合梯形数值积分(注:np.trapezoid仅在2.0+提供) |
arr.ptp() |
AttributeError |
np.ptp(arr) |
移除了ndarray实例上的.ptp()方法,保留顶层函数 |
四、核心必考变更3:C-API ABI二进制不兼容与构建隔离机制
当面试官提问:“线上部署时出现ValueError: numpy.dtype size changed, may indicate binary incompatibility. Expected 96 from C header, got 88 from PyObject,这是什么原因?为什么有的包升级后能同时在NumPy 1.x和2.0下运行?”这个问题考察的是对Python C扩展ABI(应用二进制接口)的真实理解。
报错的直接原因是:环境中实际运行的NumPy是1.x版本(其PyArray_Descr结构体大小为88字节),但某个第三方C扩展包是在NumPy 2.0下编译且未开启兼容宏;或者反过来,环境中升级到了NumPy 2.0(结构体扩展至96字节),但某个旧版C扩展包是在NumPy 1.x下编译的,直接通过偏移量访问了已变更的C结构体字段。
NumPy 2.0设计了专门的“向上编译、双向运行”兼容机制:
- 使用NumPy 1.x头文件编译出的二进制
.whl包,只能在NumPy 1.x运行,无法在NumPy 2.0下导入。 - 使用NumPy 2.0+头文件编译出的二进制
.whl包,通过运行期动态查询结构体偏移量,可以同时在NumPy 2.0和NumPy 1.23+环境中正常运行。
因此在维护包含Cython、Pybind11或C扩展的工程时,pyproject.toml的标准配置方式是在构建阶段([build-system])指定numpy>=2.0.0,而在运行期依赖([project] dependencies)中声明numpy>=1.23,<3.0。
五、实战操作步骤:如何排查与迁移存量项目至NumPy 2.0
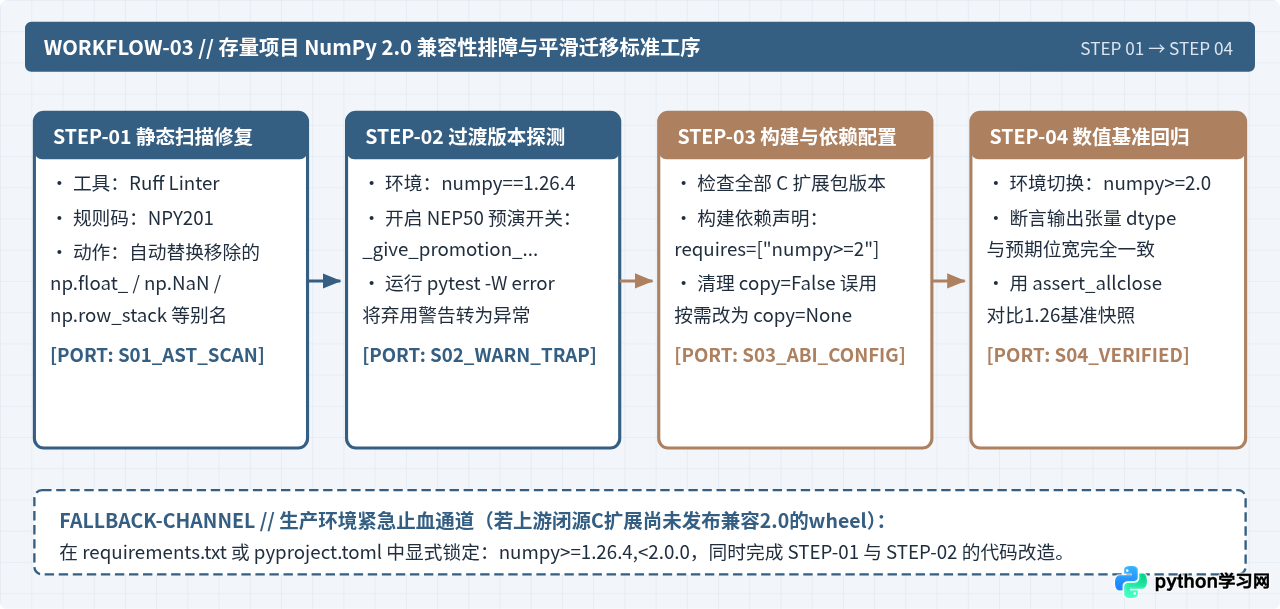
无论是在面试中口述迁移方案,还是在实际工作中升级代码库,都可以按照以下四个固定步骤执行,确保既不遗漏移除接口,也不放过静默数值变化。
步骤1:使用 Ruff 规则 NPY201 自动扫描并修复废弃接口
不需要手动在代码库中全局搜索几百个废弃函数名。现代Python静态检查工具Ruff内置了专门针对NumPy 2.0迁移的规则集NPY201,可以在秒级时间内定位所有已移除的别名并完成安全替换。
在项目根目录的终端中执行以下命令:
# 1. 仅扫描并列出所有不兼容 NumPy 2.0 的 API 调用位置
ruff check --select NPY201 src/ tests/

# 2. 预览并自动修复安全的别名替换(如 np.float_ -> np.float64, np.NaN -> np.nan)
ruff check --select NPY201 --fix src/ tests/src/preprocess/normalizer.py:42:18: NPY201 `np.float_` will be removed in NumPy 2.0. Use `np.float64` instead.
src/metrics/auc.py:19:12: NPY201 `np.trapz` will be removed in NumPy 2.0. Use `scipy.integrate.trapezoid` or `np.trapezoid` instead.
Found 2 errors (1 fixed, 1 remaining).步骤2:在 NumPy 1.26.4 过渡环境中把弃用警告转为报错
在直接安装NumPy 2.0之前,先将本地或CI测试环境固定在1.x系列的最后一个版本numpy==1.26.4,运行测试套件并将DeprecationWarning设置为抛出异常,定位动态运行期才会触发的接口问题。
pytest -W error::DeprecationWarning -W error::FutureWarning tests/步骤3:修正 pyproject.toml 中的依赖约束与 copy 语义
如果当前项目是业务应用,且部分第三方库尚未支持NumPy 2.0,需要先在依赖文件中锁定numpy>=1.26.4,<2.0.0防止CI构建突然中断;如果当前项目需要编译Cython或C++扩展并发布wheel包,则按如下格式配置pyproject.toml:
[build-system]
requires = [
    "setuptools>=68.0",
    "cython>=3.0.10",
    "numpy>=2.0.0"
]
build-backend = "setuptools.build_meta"

[project]
name = "feature-operator"
version = "0.4.0"
dependencies = [
    "numpy>=1.23.5,<3.0.0"
]同时检查代码中所有的np.array(data, copy=False)调用:如果业务意图是“尽量复用内存,必要时允许复制”,将其修改为np.asarray(data)或np.array(data, copy=None);只有确实要求零拷贝且需要强制校验内存共享时,才保留copy=False。
步骤4:编写兼容双版本的精度与 dtype 回归断言
升级到numpy>=2.0.0后,针对核心特征计算或数值算子编写回归测试,必须同时校验数值误差与输出数据类型(dtype),防止NEP 50或Windows默认整数变更引发静默漂移。
import numpy as np

def normalize_batch(batch_f32: np.ndarray, eps: float = 1e-5) -> np.ndarray:
    # 显式使用与输入相同 dtype 的标量或依赖 NEP 50 保持 float32
    mean = np.mean(batch_f32, axis=-1, keepdims=True)
    std = np.std(batch_f32, axis=-1, keepdims=True)
    return (batch_f32 - mean) / (std + np.float32(eps))

def test_normalize_dtype_and_precision():
    raw = np.array([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]], dtype=np.float32)
    result = normalize_batch(raw)

    # 1. 强校验输出位宽,防止在 1.x 与 2.0 之间发生 float32/float64 跳变
    assert result.dtype == np.float32, f"预期 float32,实际得到 {result.dtype}"

    # 2. 校验数值结果在容差范围内一致
    expected = np.array([[-1.2247356, 0.0, 1.2247356],
                         [-1.2247356, 0.0, 1.2247356]], dtype=np.float32)
    np.testing.assert_allclose(result, expected, rtol=1e-5, atol=1e-6)
    print("校验通过 -> dtype:", result.dtype, "首行输出:", np.round(result[0], 4))

if __name__ == "__main__":
test_normalize_dtype_and_precision()校验通过 -> dtype: float32 首行输出: [-1.2247 0. 1.2247]六、常见面试追问与回答要点总结
在面试收尾阶段,面试官常围绕“如何保障线上服务稳定过渡”展开追问。下面结合两类高频问题给出直接可用的判断依据与全局总结图。
1. 为什么只升级了某一个无关小包,整个环境的 pandas/scipy 就报二进制错误?
原因是该小包未设置numpy<2上限,pip install在解析依赖时顺带将环境中的NumPy从1.x升级到了2.x,而环境里已安装的旧版scipy或pandas是基于NumPy 1.x编译的。解决方式有两种:若暂不升级主栈,执行pip install "numpy<2.0"降级锁死;若决定升级至NumPy 2.0,则需要同步将scipy、pandas、scikit-learn、pyarrow等包含C扩展的科学计算包升级至各自支持NumPy 2.0 ABI的新版本。
2. 如何在同一份代码中同时兼容 NumPy 1.26 和 NumPy 2.0 的 copy 参数?
在NumPy 1.x中,np.array(x, copy=None)会报错(因为1.x只接受布尔值),而在NumPy 2.0中copy=False又变成了强制零拷贝报错。如果代码需要同时运行在1.26和2.0环境下,并且意图是“能不复制就不复制,必须复制时才复制”,不要直接传copy参数给np.array(),而是统一改用np.asarray(x, dtype=...)。np.asarray在NumPy 1.x和2.0中的行为完全一致,天然等价于2.0中的copy=None。
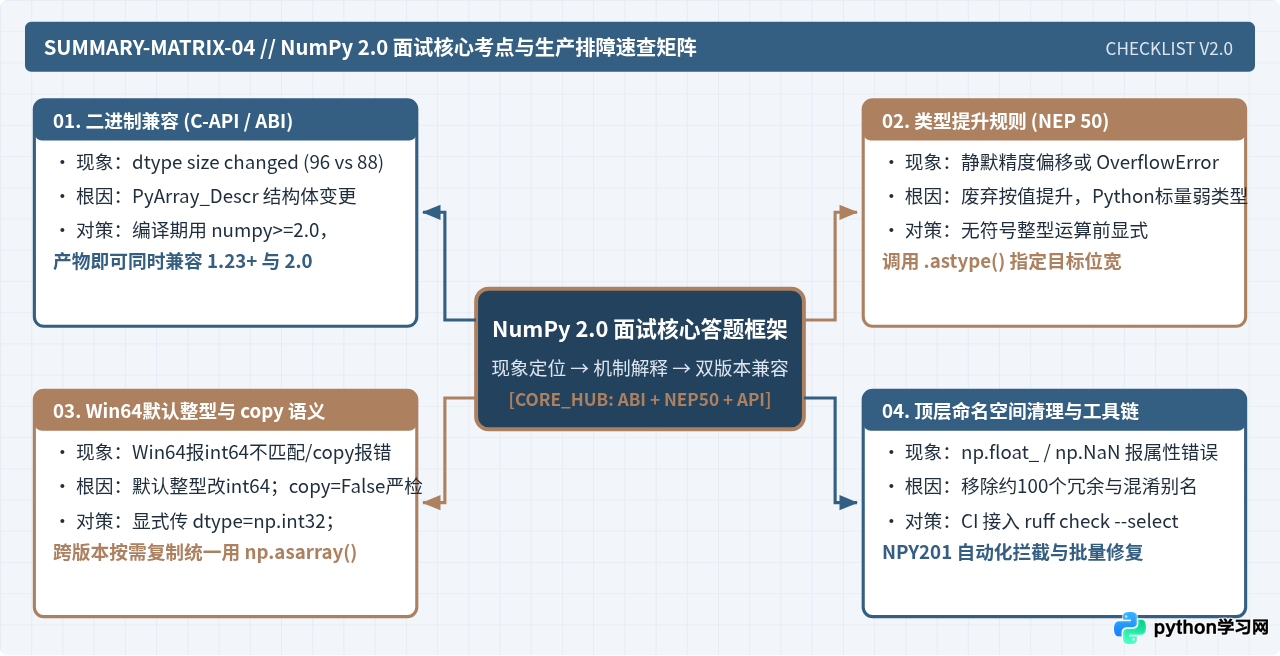
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















