


Python快速排序基础实现:递归逻辑与代码示例
深入解析Python快速排序的基础实现原理。本文详细拆解分治思想、递归基与分区机制,提供清晰的列表推导式与原地交换双指针代码示例,并分析时间复杂度与边界处理注意事项。
一、快速排序的核心原理与分治逻辑
快速排序由英国计算机科学家霍尔(Tony Hoare)提出。它能在多数实际场景下达到平均 O(n log n) 的极高运行效率,其核心驱动力在于“分而治之”(Divide and Conquer)。
如果直接对包含 1,000 个乱序数字的列表进行排序,全局比较与位移的开销会随着规模呈平方级(O(n²))暴增;但若能找到一个参照物,将 1,000 个数划分为“较小的 500 个”与“较大的 500 个”,两部分内部再各自独立排序,比较的范围就会以对数级别急剧收缩。
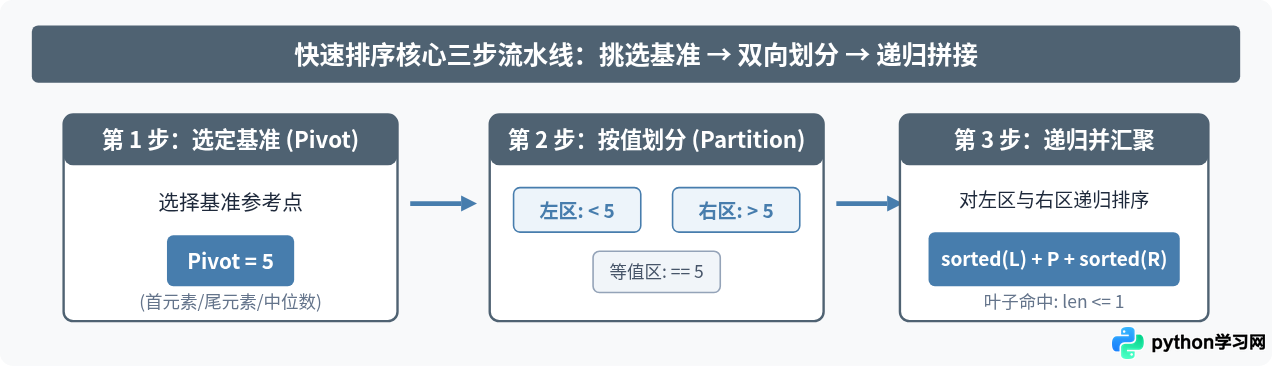
在每一次操作中,算法重点完成以下两件事:
- 确定基准值(Pivot):在当前处理的数据片段中挑出一个元素作为标尺,基准的选择既可以选头部、尾部,也可以随机或取中值。
- 元素归流分区(Partition):以基准值为分水岭,把整个列表拆分成小于基准、等于基准、大于基准三部分。分区完成的那一刻,基准元素本身在最终全局有序列表中的绝对位置就已经彻底锁定。
二、推导分解:单次分区的运作流程
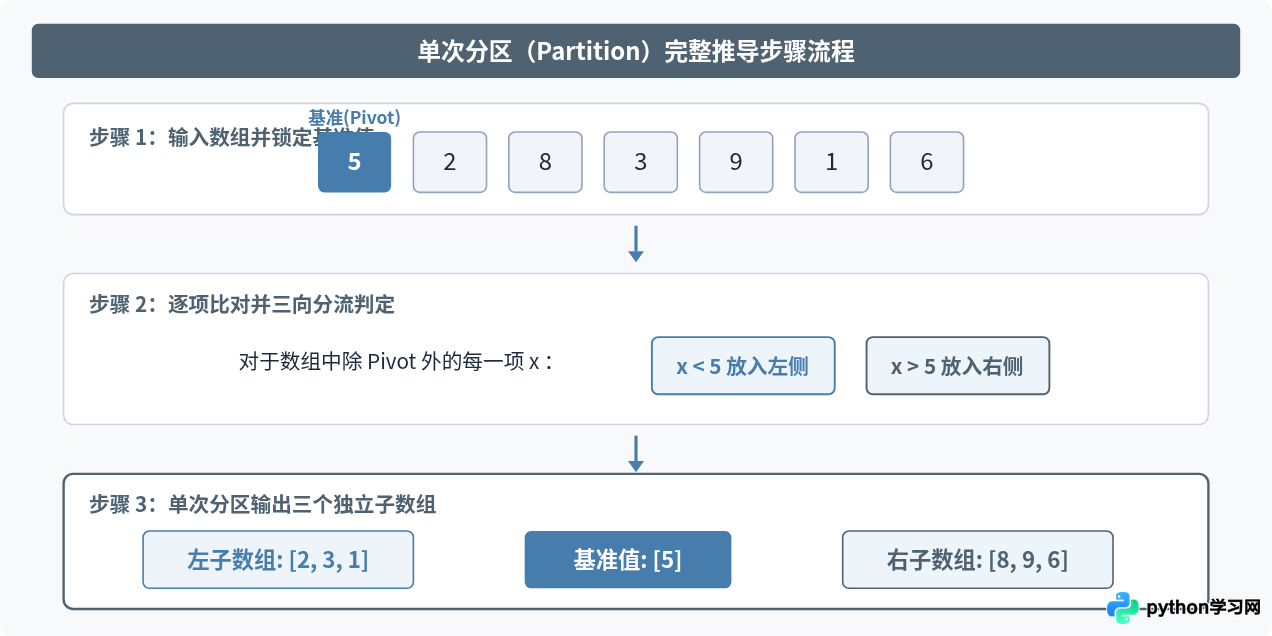
要写出正确的递归程序,必须先完全看透单次分区的执行步骤。假设我们有待排序序列 [5, 2, 8, 3, 9, 1, 6],选择首元素 5 作为基准值。
接下来,算法会遍历其余所有元素,将它们与基准值 5 逐一对比。小于 5 的元素被归入左子列表,大于等于 5 的元素被归入右子列表。推导过程如下图所示:
三、Python快速排序基础实现:列表推导式直观写法
在Python中,理解快速排序最简单直接的途径是运用列表推导式(List Comprehension)。这种写法严格贴合分治与递归的数学定义,具备极高的可读性。
1. 递归的两个基石
- 递归基(Base Case / 终止条件):当传入列表的长度为
0或1时(len(arr) <= 1),一个元素或空列表本身就是绝对有序的,无需再做任何比较,直接原样返回。缺少递归基会导致函数无限调用直至栈溢出。 - 递归步(Recursive Step):只要列表长度大于
1,就取一个基准值,划分出left(比基准小)、middle(与基准相等)、right(比基准大)三个列表,再分别对left和right执行自身函数,最后通过+操作符合并拼接。
2. 完整代码示例
def quick_sort_simple(arr):
    """
    使用列表推导式实现的直观快速排序
    :param arr: 待排序列表
    :return: 有序的新列表
    """
    # 1. 递归基:如果列表长度小于等于1,直接返回
    if len(arr) <= 1:
        return arr

    # 2. 选定基准值(此处选择列表中间位置的元素)
    pivot = arr[len(arr) // 2]

    # 3. 分区:利用列表推导式分别收集小于、等于、大于基准的元素
    left = [x for x in arr if x < pivot]
    middle = [x for x in arr if x == pivot]
    right = [x for x in arr if x > pivot]

    # 4. 递归调用并合并结果
    return quick_sort_simple(left) + middle + quick_sort_simple(right)


# --- 运行验证 ---
if __name__ == "__main__":
    raw_data = [38, 27, 43, 3, 9, 82, 10, 27]
    sorted_data = quick_sort_simple(raw_data)
    print("原始列表:", raw_data)
    print("排序结果:", sorted_data)
排序结果: [3, 9, 10, 27, 27, 38, 43, 82]
middle 数组。这样做能够自然处理列表中包含重复元素(例如示例中的两个 27)的情形,避免将等值元素反复压入递归,从而大幅提升含有大量重复值数据时的递归效率。
四、进阶基础:原地交换分区(Lomuto In-Place Partition)
列表推导式写法非常适合教学与快速理解,但它在每次递归时都会通过内存分配创建多个全新的子列表,空间复杂度为 O(n)。在生产级排序或内存敏感场景下,经典的快速排序通常采用原地分区(In-Place Partition)。
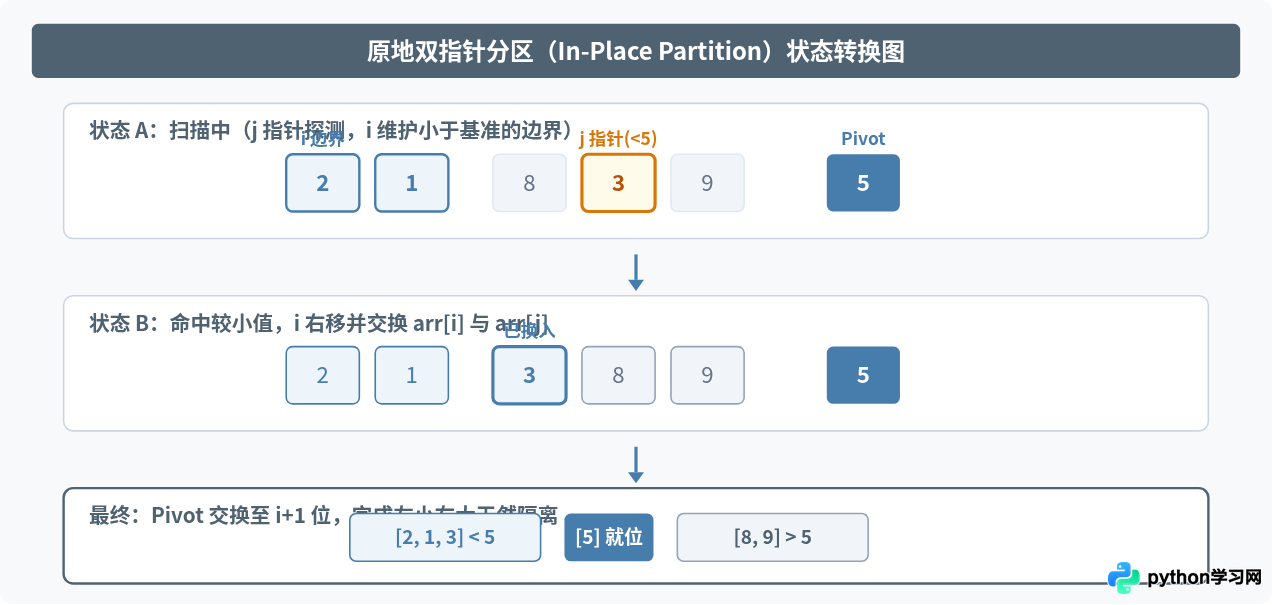
原地分区不需要额外新建数组,而是直接在原始列表上通过指针移动与元素交换(Swap)来重排元素。最著名的方案之一是 Lomuto 分区算法:
- 选择当前区间的最后一个元素作为基准值
pivot = arr[high]。 - 维护一个较小元素边界指针
i = low - 1,并用遍历指针j从low扫描到high - 1。 - 若
arr[j] < pivot,则将i前移一位,并交换arr[i]与arr[j],确保[low ... i]始终是小于基准的区域。 - 扫描结束后,将基准元素
arr[high]交换到i + 1位置,至此基准元素正式就位,并返回其索引。
原地快速排序代码示例
def partition(arr, low, high):
    """
    Lomuto 原地分区逻辑
    选择 arr[high] 为基准,并将小于基准的值移至左侧
    """
    pivot = arr[high]
    i = low - 1  # 较小元素的右边界指针

    for j in range(low, high):
        if arr[j] < pivot:
            i += 1
            arr[i], arr[j] = arr[j], arr[i]  # 交换元素

    # 将基准值放到边界右侧的最终位置 (i + 1)
    arr[i + 1], arr[high] = arr[high], arr[i + 1]
    return i + 1


def quick_sort_inplace(arr, low=0, high=None):
    """
    原地递归快速排序入口
    """
    if high is None:
        high = len(arr) - 1

    # 递归基:当 low >= high 时,区间内仅剩 0 或 1 个元素,停止递归
    if low < high:
        # 获得基准值归位后的绝对索引
        pi = partition(arr, low, high)

        # 递归排序基准左侧子数组
        quick_sort_inplace(arr, low, pi - 1)
        # 递归排序基准右侧子数组
        quick_sort_inplace(arr, pi + 1, high)
    return arr


# --- 运行验证 ---
if __name__ == "__main__":
    nums = [6, 2, 8, 1, 9, 3, 5]
    print("排序前:", nums)
    quick_sort_inplace(nums)
    print("排序后:", nums)
排序后: [1, 2, 3, 5, 6, 8, 9]
五、递归调用链与执行树全过程剖析
初学者在学习快速排序时,最容易产生困惑的是:“递归函数是如何一层层压栈并在合适时机返回合并的?”
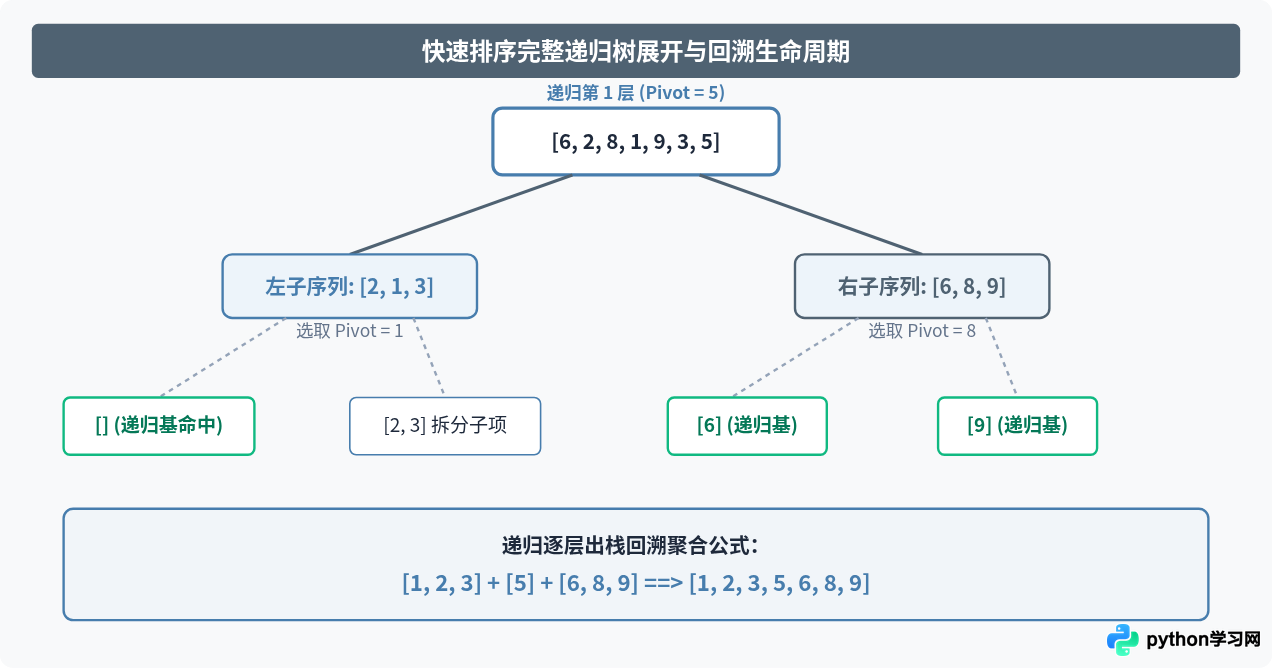
我们以序列 [6, 2, 8, 1, 9, 3, 5] 为例,完整拆解其调用树的展开与回溯流程:
- 根节点展开:选定
5为基准,划分得到左区间[2, 1, 3]与右区间[6, 8, 9]。 - 深入左子树:系统暂停根节点执行,对
[2, 1, 3]递归。以1为基准切分为空集、[1]和[2, 3],逐步抵达len <= 1的递归基。 - 回溯与右子树:左半部分完全有序并返回为
[1, 2, 3];系统接着执行右半区[6, 8, 9]的递归,最终返回[6, 8, 9]。 - 全局合拢:左右子任务均执行完毕,将
[1, 2, 3] + [5] + [6, 8, 9]组合,产出全局结果。
六、边界条件、性能特征与避坑指南
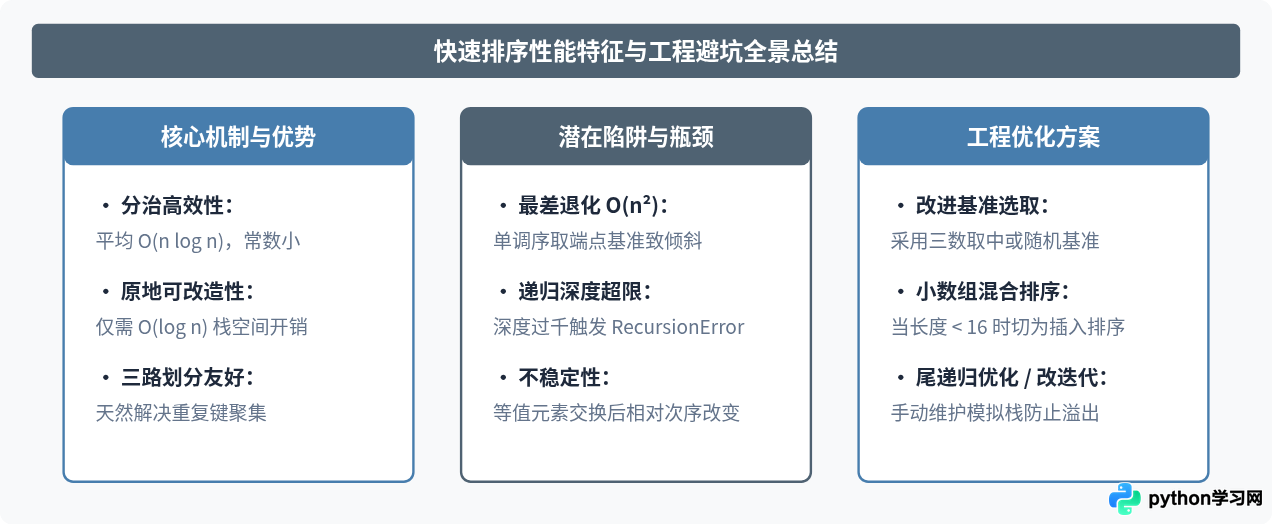
快速排序在大多数工业排序库中都是重要基石,但在实际工程运用中,开发者需要特别防范其潜在的性能退化陷阱与运行环境限制。
1. 时间与空间复杂度矩阵
| 指标维度 | 列表推导式写法 | 原地交换(Lomuto/Hoare) | 核心影响因素 |
|---|---|---|---|
| 最好时间复杂度 | O(n log n) | O(n log n) | 基准值恰好均匀对半二分 |
| 平均时间复杂度 | O(n log n) | O(n log n) | 绝大多数随机分布的输入 |
| 最差时间复杂度 | O(n²) | O(n²) | 输入本身已严格有序,且固定取首/尾作为基准 |
| 辅助空间复杂度 | O(n) | O(log n) | 列表推导式频繁新建数组;原地实现仅消耗栈帧 |
2. 核心陷阱与防御方案
-
最差情况 O(n²) 退化问题:
如果待排数组已经升序排列,而算法固定挑选首元素作为基准,那么每次分区后左侧为空,右侧只减少 1 个元素。树的深度从
log n骤增至n,算法退化为极其缓慢的冒泡/选择排序。
防御方法:采用“三数取中法”(取头部、中间和尾部的中位数作为基准)或在分区前使用random.choice随机选取基准。 -
Python 递归深度限制(RecursionError):
Python 解释器为了防止 C 语言调用栈溢出,设置了默认递归深度限制(通常为 1,000 层,可通过
sys.getrecursionlimit()查询)。在退化为O(n²)或面对超过数千个元素的极端输入时,极易抛出RecursionError: maximum recursion depth exceeded。 - 大量相同元素的处理: 若序列中存在成千上万个重复数值,双指针法若未做等值处理,容易把相同元素全分到同一侧,依然引起不平衡树。采用前文展示的三路划分(Less, Equal, Greater),可在一次分区中把所有相同值同时归位。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















