


Python基础语法精选练习题及详细答案解析
精选Python基础语法核心练习题,涵盖类型转换、分支判断、循环控制、列表切片、字典频次统计及函数可变默认参数,提供详尽的代码实现、逻辑推导及易错点解析。
掌握编程语法的有效途径在于具体题目的分析与编写练习。本文精选了涵盖数据类型转换、流程控制分支、循环嵌套、组合数据结构(列表、字典、集合)及函数参数作用域的核心练习题,针对每一道题目逐层拆解实现逻辑、给出规范示例代码,并指出易错陷阱,帮助读者建立扎实的Python编程基础。
一、Python解题思维与基础语法拆解路径
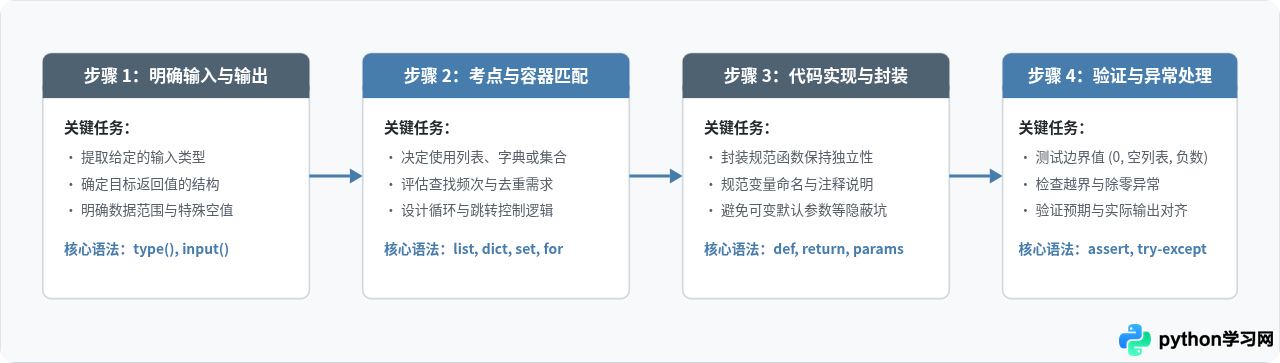
在面对具体的算法题目或语法应用需求时,许多初学者容易直接动手写代码,导致逻辑混乱或陷入局部细节。规范的解题过程应遵循从题目条件提炼、数据结构匹配、编码实现到边界测试的完整闭环。
二、精选练习题一:输入处理与类型转换格式化
1. 题目说明
编写一个程序,从用户输入中接收一个浮点数和一个整数(分别代表商品的单价与购买数量),计算总金额并按照指定格式输出:保留两位小数,同时输出格式化的账单摘要。
2. 核心考点与解题思路
Python中通过 input() 函数获取的数据默认均为字符串类型(str),直接进行数学相乘会导致字符串重复拼接错误。解决此题的关键在于:
- 使用
float()与int()对输入数据进行显式类型转换。 - 运用格式化字符串字面量(f-string),通过
:.2f格式化说明符精确控制浮点数输出位数。
3. 参考代码实现
def calculate_bill(price_str: str, quantity_str: str) -> str:
    # 显式类型转换
    price = float(price_str)
    quantity = int(quantity_str)

    # 业务计算
    total_amount = price * quantity

    # 使用 f-string 进行精确格式化
    result_text = f"商品单价: ¥{price:.2f} | 购买数量: {quantity} | 应付总计: ¥{total_amount:.2f}"
    return result_text

# 模拟调用与验证
sample_price = "19.85"
sample_qty = "4"
print(calculate_bill(sample_price, sample_qty))
示例输出:
商品单价: ¥19.85 | 购买数量: 4 | 应付总计: ¥79.40float() 会抛出 ValueError。在实际业务中,可先调用 strip() 或正则表达式清洗无效字符。
三、精选练习题二:循环与分支控制(素数判定与流程跳出)
1. 题目说明
编写一个函数 is_prime(n),输入一个正整数 n,判断该数字是否为素数(质数)。如果是素数返回 True,否则返回 False。并在主逻辑中打印 2 到 20 之间的所有素数。
2. 核心考点与算法推导
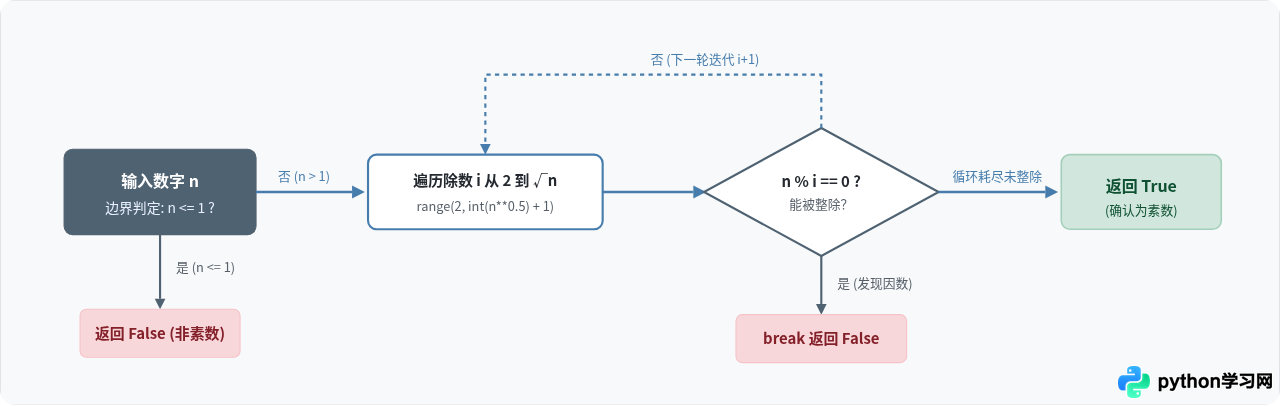
素数是指大于 1 且除了 1 和它本身之外不能被其他自然数整除的整数。基本逻辑包含:
- 边界条件检查:若
n <= 1,直接判定为非素数。 - 除数试除优化:试除因子只需要检查到
int(n ** 0.5) + 1。若在该范围内出现能被整除的数,立即触发break或返回False。 - 流程完整性:可利用 Python 特有的
for...else结构,当循环未被break中断时顺利执行else分支。
3. 参考代码实现
def is_prime(n: int) -> bool:
    if n <= 1:
        return False
    # 只需试除到根号n向下取整的位置
    limit = int(n ** 0.5) + 1
    for i in range(2, limit):
        if n % i == 0:
            return False
    return True

# 筛选 2 到 20 的素数
primes = [num for num in range(2, 21) if is_prime(num)]
print("2到20范围内的素数列表:", primes)
示例输出:
2到20范围内的素数列表: [2, 3, 5, 7, 11, 13, 17, 19]四、精选练习题三:列表切片与列表推导式重构
1. 题目说明
给定一个包含多个人名和成绩的列表 data = [("Alice", 85), ("Bob", 59), ("Charlie", 92), ("David", 60), ("Eve", 48)]。要求:
- 使用列表推导式提取所有成绩及格(>= 60)的学生姓名。
- 提取及格学生名单中前两名学生,并使用切片语法将其逆序排列。
2. 核心考点与解题思路
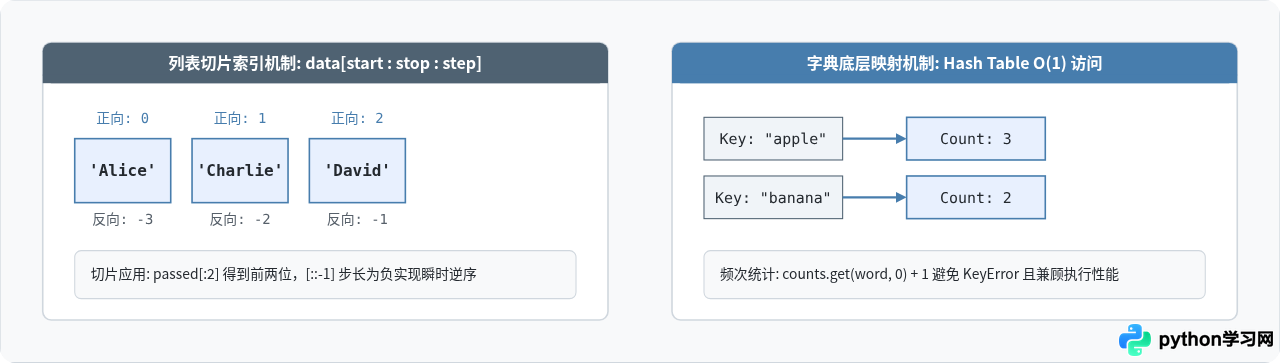
列表推导式(List Comprehension)提供了一种兼顾性能与简洁性的列表构造语法,形式为 [expr for item in iterable if condition]。切片操作 list[start:stop:step] 中,当 step 为负数(例如 [::-1])时,可以实现对列表的优雅翻转。
3. 参考代码实现
raw_records = [
    ("Alice", 85),
    ("Bob", 59),
    ("Charlie", 92),
    ("David", 60),
    ("Eve", 48)
]

# 1. 列表推导式筛选成绩 >= 60 的姓名
passed_students = [name for name, score in raw_records if score >= 60]
print("及格学生名单:", passed_students)

# 2. 切片获取前两个元素,并使用 [::-1] 步长进行逆序
top_two_reversed = passed_students[:2][::-1]
print("前两名学生(逆序排列):", top_two_reversed)
示例输出:
及格学生名单: ['Alice', 'Charlie', 'David']
前两名学生(逆序排列): ['Charlie', 'Alice']
五、精选练习题四:字典高频统计与键值反转
1. 题目说明
给定一段文本字符串 "python is powerful and python is elegant and easy",编写函数统计每个单词出现的频次,并将统计结果中频次相同的所有单词聚合归类(即以频次为键,单词列表为值)。
2. 核心考点与解题思路
该题目考查字符串切分、字典动态聚合以及 dict.get() 或 setdefault() 方法的高效运用:
- 使用
str.split()将字符串按空格切分为词元。 - 遍历词元构建初始词频字典,推荐使用
freq[word] = freq.get(word, 0) + 1。 - 反转映射关系时,遍历
freq.items(),将词频作为键,对应的值初始化为空列表并逐步append相应单词。
3. 参考代码实现
def word_frequency_analysis(text: str):
    words = text.split()

    # 步骤一:统计词频
    word_counts = {}
    for word in words:
        word_counts[word] = word_counts.get(word, 0) + 1

    # 步骤二:按频次聚合反转 (Count -> [Words])
    grouped_by_count = {}
    for word, count in word_counts.items():
        if count not in grouped_by_count:
            grouped_by_count[count] = []
        grouped_by_count[count].append(word)

    return word_counts, grouped_by_count

sample_sentence = "python is powerful and python is elegant and easy"
counts, grouped = word_frequency_analysis(sample_sentence)

print("单词频次统计结果:", counts)
print("频次聚合归类字典:", grouped)
示例输出:
单词频次统计结果: {'python': 2, 'is': 2, 'powerful': 1, 'and': 2, 'elegant': 1, 'easy': 1}
频次聚合归类字典: {2: ['python', 'is', 'and'], 1: ['powerful', 'elegant', 'easy']}
六、精选练习题五:函数可变默认参数与作用域陷阱
1. 题目说明
编写一个向任务队列添加事件项的函数 add_task(task_name, queue=[])。初学者常直接将默认参数设为空列表 [],请分析多次调用该函数产生的异常累积问题,并给出工业界标准修复方案。
2. 核心考点与原理分析
在 Python 中,函数的默认参数是在函数定义期(编译加载时)被求值并创建的,而不是在函数每次被调用时动态创建。因此,如果默认参数是可变对象(如 list、dict 或自定义类的实例),所有未传实参的调用都会共享同一个内存对象引用!
3. 问题重现与标准重构代码
# 【错误示范】:共享默认参数对象
def faulty_add_task(task_name, queue=[]):
    queue.append(task_name)
    return queue

# 【正确写法】:使用 None 作为哨兵值,在函数体内部动态初始化
def correct_add_task(task_name: str, queue: list = None) -> list:
    if queue is None:
        queue = []
    queue.append(task_name)
    return queue

# 验证对比
print("--- 错误实现连续调用 ---")
print(faulty_add_task("Task 1")) # 输出 ['Task 1']
print(faulty_add_task("Task 2")) # 意外输出 ['Task 1', 'Task 2']

print("\n--- 正确实现连续调用 ---")
print(correct_add_task("Task 1")) # 输出 ['Task 1']
print(correct_add_task("Task 2")) # 独立输出 ['Task 2']
七、Python基础语法核心考点与避坑总结
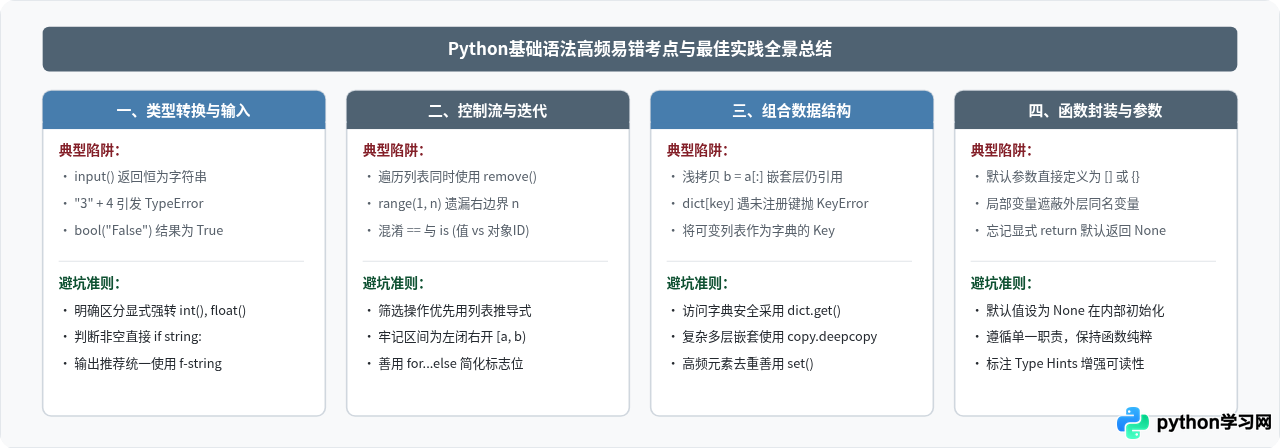
在基础语法学习与编写练习题时,高频出现的错误往往源自对 Python 内存模型、引用机制和作用域规则的模糊认知。下方的总结矩阵系统梳理了练习中最常见的四大考点与避坑准则:
八、练习方法与持续进阶建议
在练习 Python 基础语法的过程中,建议遵循以下三个学习步骤:
| 阶段 | 核心训练目标 | 推荐验证方式 |
|---|---|---|
| 阶段一:语法准绳 | 熟悉基本数据类型、操作符优先级、输入输出与格式化规则。 | 在终端交互模式或独立小脚本中进行单元表达式求值验证。 |
| 阶段二:逻辑重构 | 将传统的条件嵌套与多层循环改写为列表推导式、字典映射与生成器。 | 对比重构前后的代码行数、执行可读性与边界用例执行结果。 |
| 阶段三:健壮性提升 | 处理空值、边界值与非法输入,避免可变对象传参陷阱。 | 针对编写的函数设计极端输入(如空序列、负数、浮点除零),检查鲁棒性。 |
通过有意识地将语法规则运用到具体题目中,不仅能迅速摆脱“看书懂了却写不出代码”的瓶颈,更能为后续数据分析、自动化开发或进阶后端架构打下稳固的基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















