


Python map配合lambda表达式:简化批量数据处理的技巧
深入解析Python中map()函数配合lambda匿名表达式批量处理数据的核心语法、运作机制、多序列映射技巧、内存优势与实战避坑指南,并对比列表推导式的场景选型。
在日常数据清洗与轻量批量处理中,我们经常需要对列表或集合中的每个元素施加相同的数学转换、字段提取或字符串规范化操作。编写传统的 for 循环往往会引入累加容器、下标索引或多余的局部变量;单独通过 def 定义单行具名函数又会制造不必要的命名污染。将 Python 内置的高阶函数 map() 与匿名函数 lambda 搭配使用,能够以极简的代码结构直接完成一对一的数据映射,并借助惰性求值特性提升内存使用效率。本文将系统拆解这一组合的核心语法、数据流向机制、多序列协同技巧及性能边界,帮助你在实战中做出规范合理的选型。
一、核心语法剖析与快速上手
map() 是 Python 的内置高阶函数,其作用是将指定的函数依次作用到可迭代对象(如 list、tuple 等)的每一个元素上。而 lambda 表达式则允许我们在不需要定义具名函数的情况下,直接就地编写轻量的单行匿名表达式。
二者搭配的基础语法模板如下:
# 基础语法结构
map_object = map(lambda item: <处理表达式>, iterable)
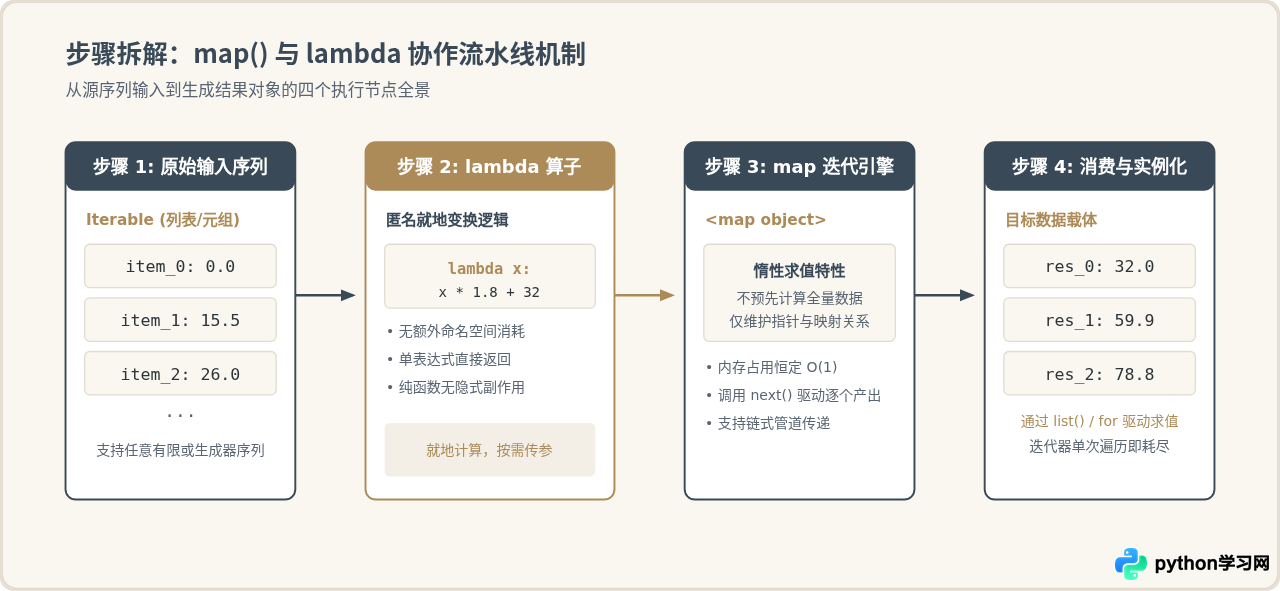
以最常见的温度数据批量转换场景为例,假设我们接收到一组气象站采集的摄氏度数据,需要全部转换为华氏度(换算公式为 \(F = C \times 1.8 + 32\))。我们来对比三种实现形式:
# 环境要求:Python 3.x
celsius_temps = [0.0, 15.5, 26.0, 37.5, -5.0]

# 方案 A:传统命令式 for 循环
fahr_a = []
for c in celsius_temps:
    fahr_a.append(c * 1.8 + 32)

# 方案 B:map 配合 lambda 表达式
fahr_b = list(map(lambda c: round(c * 1.8 + 32, 1), celsius_temps))

print("转换结果:", fahr_b)在方案 B 中,我们没有声明多余的临时列表 fahr_a,也没有编写繁复的 append 调用,而是直截了当地表达了“将每个温度元素经过公式运算映射为新值”的核心逻辑。
二、实战进阶:三类核心批量处理技巧
1. 杂乱文本数据的轻量清洗与标准化
在接收用户表单输入或爬虫抓取文本时,字符串列表往往夹杂前后空白、全半角符号或不规范的大小写。借助 lambda 能够在一个紧凑的链式调用中完成归一化:
# 场景:清洗杂乱的用户名列表
raw_usernames = ["  alice_99 ", "BOB_King", "   charLie-D ", "david "]

# 清除首尾空格并转换为全小写
clean_names = list(map(lambda name: name.strip().lower(), raw_usernames))

print("标准化结果:", clean_names)2. 多序列并行对其计算
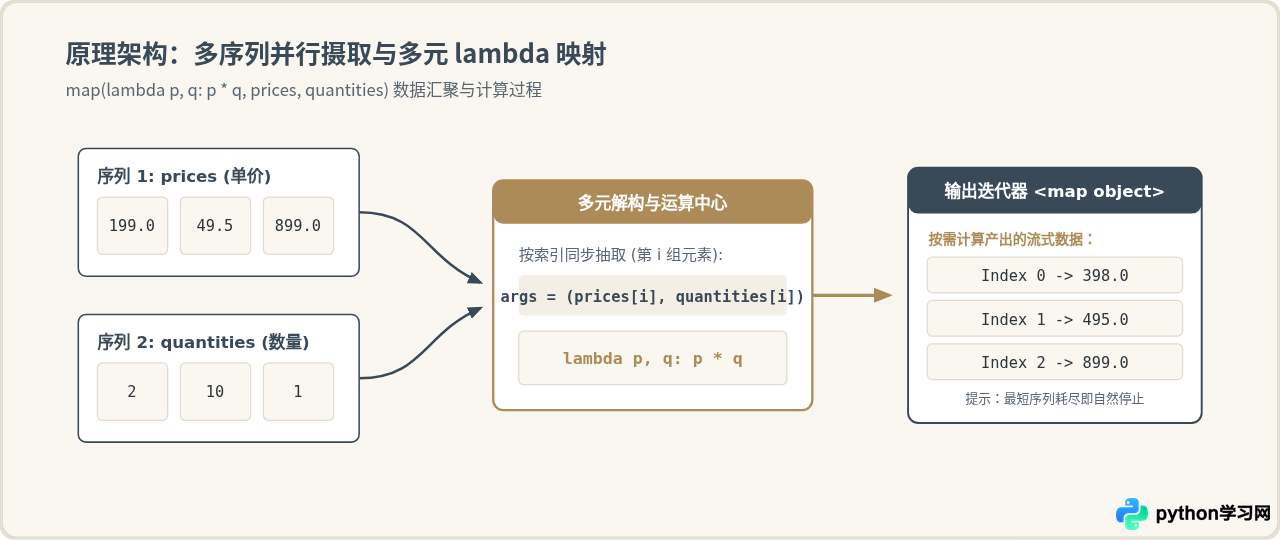
很多开发者误以为 map() 只能接收一个可迭代对象,实际上 map() 允许传入多个可迭代对象。此时,lambda 表达式需要同时接收与序列数量相等的参数,map() 会并行从各个序列中同步取出元素进行计算。
例如在电商结算场景中,将商品单价列表与采购数量列表对应计算出每一项的实际小计金额:
prices = [199.0, 49.5, 899.0, 15.0]     # 商品单价
quantities = [2, 10, 1, 8]              # 购买数量
discounts = [0.9, 1.0, 0.85, 0.95]      # 折扣比例

# 接收三个参数,进行多维度批量求值
subtotals = list(map(lambda p, q, d: round(p * q * d, 2), prices, quantities, discounts))

print("各商品实付小计:", subtotals)这种多序列对齐模式替代了传统基于 zip() 打包后再解包的繁杂步骤,代码表达极度洗练。
3. 字典列表(Record List)的轻量投影与重塑
在后端接口联调或从数据库读取记录时,我们常面对结构紧密的字典列表。利用 lambda 可以非常高效地抽取关键字段,或者重构成前端专用的数据形态:
# 场景:从用户数据表中抽取简要标签卡
users = [
    {"id": 101, "username": "zhangsan", "role": "admin", "score": 92},
    {"id": 102, "username": "lisi", "role": "editor", "score": 78},
    {"id": 103, "username": "wangwu", "role": "visitor", "score": 64}
]

# 批量提取并重塑为简化元组 (用户ID, 评级)
user_summary = list(map(
    lambda u: (u["id"], "优秀" if u["score"] >= 90 else "合格"),
    users
))

print("用户评级摘要:", user_summary)三、核心特性:惰性求值与内存优势
在 Python 2 中,map() 会直接在内存中分配一个完整的 list。但在 Python 3 中,map() 进行了关键架构改造:它返回的是一个迭代器对象(Iterator)。
这意味着:当你调用 map(lambda ...) 的瞬间,任何具体的转换运算都还没有发生。Python 仅仅记录了函数引用与迭代器指针。只有当你显式通过 for 循环迭代、调用 next()、或使用 list()、tuple() 强制求值时,数据才会逐个被运算并吐出。
💡 为什么尽量避免无脑调用 list(map(...))?
如果原始数据量高达数千万行,直接调用 list(map(...)) 会瞬间将所有计算结果压入内存,可能直接触发系统的 OOM(内存溢出)异常。直接将 map 产生的结果传递给下一个流式消费环节(例如直接写入文件或传入数据库 batch 生成器),内存占用自始至终只有一条记录的大小(\(O(1)\) 空间复杂度)。
四、对比与权衡:map+lambda vs 列表推导式
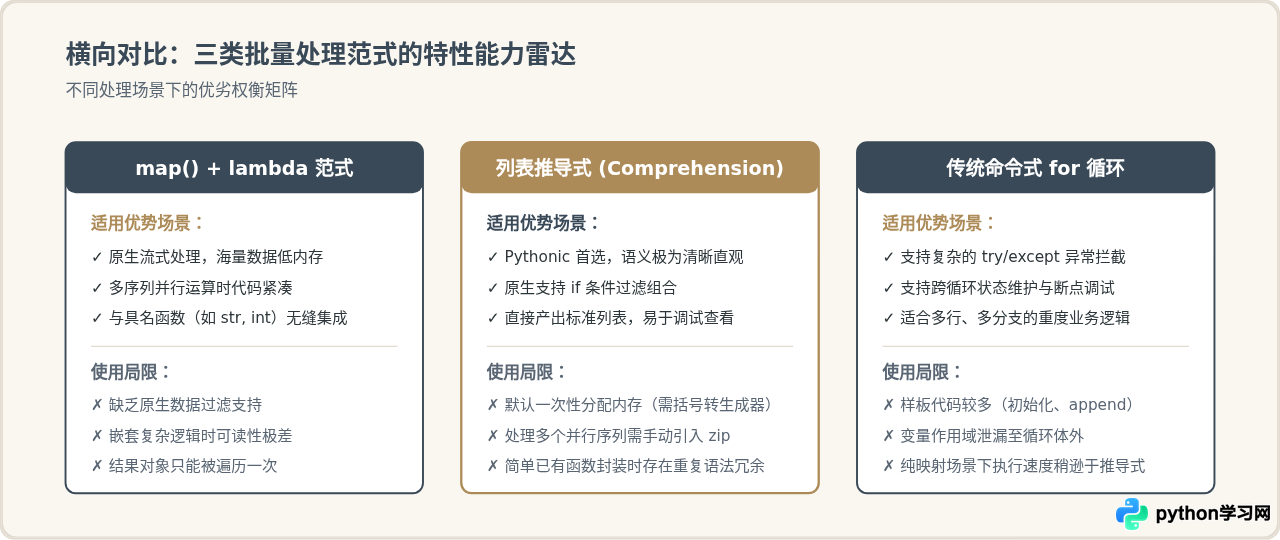
在 Python 社区中,列表推导式(List Comprehension) 同样是处理批量数据的利器。许多初学者常对“什么时候用 map + lambda,什么时候用列表推导式”感到困惑。下表从语法、性能与可读性方面进行了客观横向对比:
| 维度 | map + lambda 表达式 | 列表推导式 [x for x in ...] | 传统 for 循环 |
|---|---|---|---|
| 语法特征 | 函数式风格,就地传参,无多余循环关键字 | Pythonic 首选,符合自然语言习惯 | 命令式风格,语法结构较冗长 |
| 求值机制 | 惰性求值(返回 Iterator),零额外内存消耗 | 立即求值(生成器推导式除外) | 逐行命令式执行,需预先初始化集合 |
| 过滤支持 (Filtering) | 自身不支持,需套用 filter() 嵌套,可读性骤降 |
原生支持 [f(x) for x in seq if cond] |
原生支持在循环体内嵌入 if 分支 |
| 多序列并行 | 原生支持 map(func, seq1, seq2) |
需配合 zip(seq1, seq2) 显式解构 |
需配合 zip() 或通过下标索引访问 |
| 复用已有具名函数 | 极佳:直接 map(int, str_list),无需 lambda |
稍显多余:[int(x) for x in str_list] |
较为啰嗦 |
五、常见陷阱与避坑准则
在实际工程中,map + lambda 的使用虽然便捷,但如果忽视了底层特性,很容易引发隐蔽的 Bug。以下是必须重点防范的三大常见陷阱:
陷阱 1:迭代器“一次性消费”问题
map() 返回的是迭代器,它维护一个不断前移的内部游标。一旦遍历完毕,迭代器即处于耗尽状态。如果后续代码尝试再次读取它,将直接返回空结果:
# 错误示例:重复消费同一个 map 迭代器
squared_iter = map(lambda x: x ** 2, [1, 2, 3])

# 第一次消费:成功输出
print("第一轮求和:", sum(squared_iter))   # 输出 14

# 第二次消费:迭代器已空!
print("第二轮求和:", sum(squared_iter)) # 输出 0(而非 14!)防坑策略:如果计算结果需要被多处复用,应在生成阶段直接显式固化为列表 list(map(...)),或者使用生成器函数按需重建。
陷阱 2:在 lambda 内部滥用复杂逻辑
lambda 设计初衷仅用于表达单行简单的纯计算。如果在 lambda 内嵌套多层三元运算符(a if c1 else b if c2 else d),会导致代码晦涩难懂,丧失可维护性。
# 糟糕的反模式:晦涩难懂的复杂嵌套 lambda
bad_code = map(lambda x: "High" if x > 80 else ("Mid" if x > 60 else "Low"), scores)

# 推荐规范:超过单行三元判断时,果断拆解为标准 def 具名函数
def categorize_score(score):
    if score >= 80:
        return "High"
    if score >= 60:
        return "Mid"
    return "Low"

good_code = map(categorize_score, scores)
陷阱 3:序列长度不匹配引发的“隐式截断”
当向 map() 传入多个不同长度的可迭代对象时,map() 会在最短的序列耗尽时自动终止,超出部分将被无声丢弃,且不会抛出任何告警:
nums_a = [10, 20, 30, 40, 50]  # 5 个元素
nums_b = [1, 2]                 # 仅 2 个元素

result = list(map(lambda x, y: x + y, nums_a, nums_b))
print("合并结果:", result) # 仅输出 [11, 22],后续 30, 40, 50 被静默截断防坑策略:如果业务逻辑严格要求所有序列长度必须一致,建议在调用前增加 assert len(a) == len(b) 校验,或使用 itertools.zip_longest 进行补全填充。
六、选型决策指南与总结
掌握工具的价值在于知道“何时用”以及“何时不用”。下图提供了一套直观的选型路径:
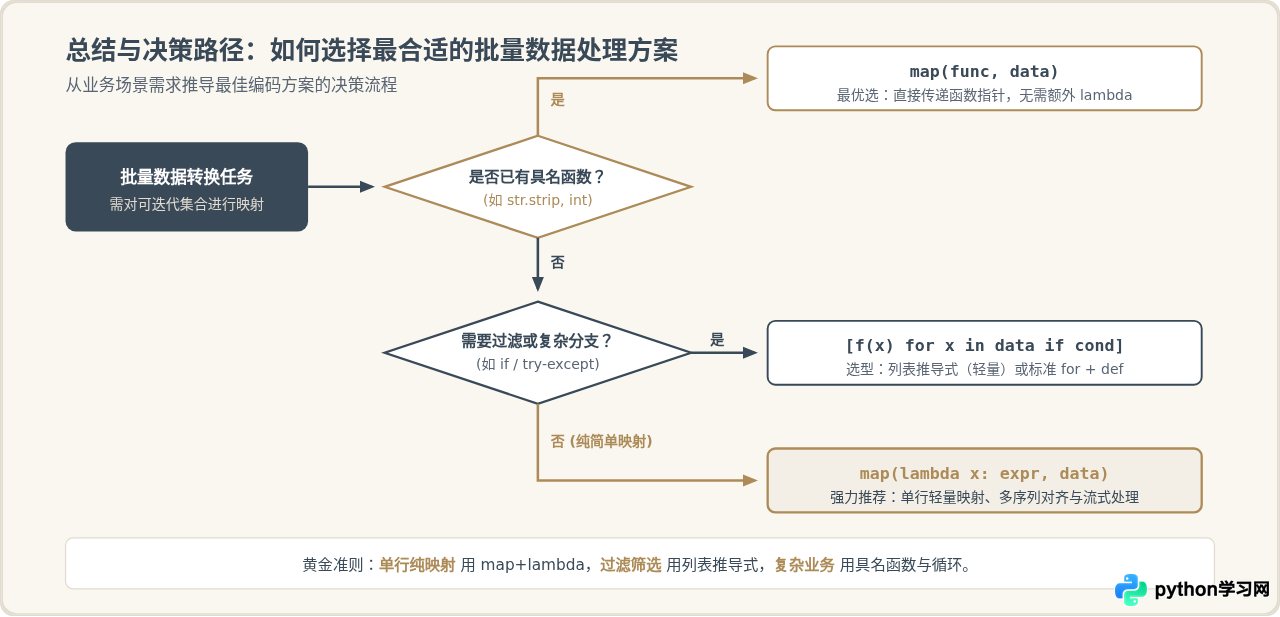
综上所述,map() 与 lambda 表达式并非用于取代所有的循环与推导式,而是在简单一对一变换、多序列并行处理以及需要按需流式计算的场景中,提供了一种高表达力、低内存开销的利器。只要遵循单行纯函数原则、警惕迭代器的一次性消耗特征,这一技巧就能显著提升你的 Python 代码质感与数据处理效能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















