


数据分析面试该不该建议把pandas换成Polars?
在数据分析面试中,是否应该建议团队把pandas替换成Polars?本文从面试官考察意图、底层架构与性能边界、代码实测对比以及结构化答题策略展开深度剖析,提供兼顾技术深度与工程落地价值的完整解答方案。
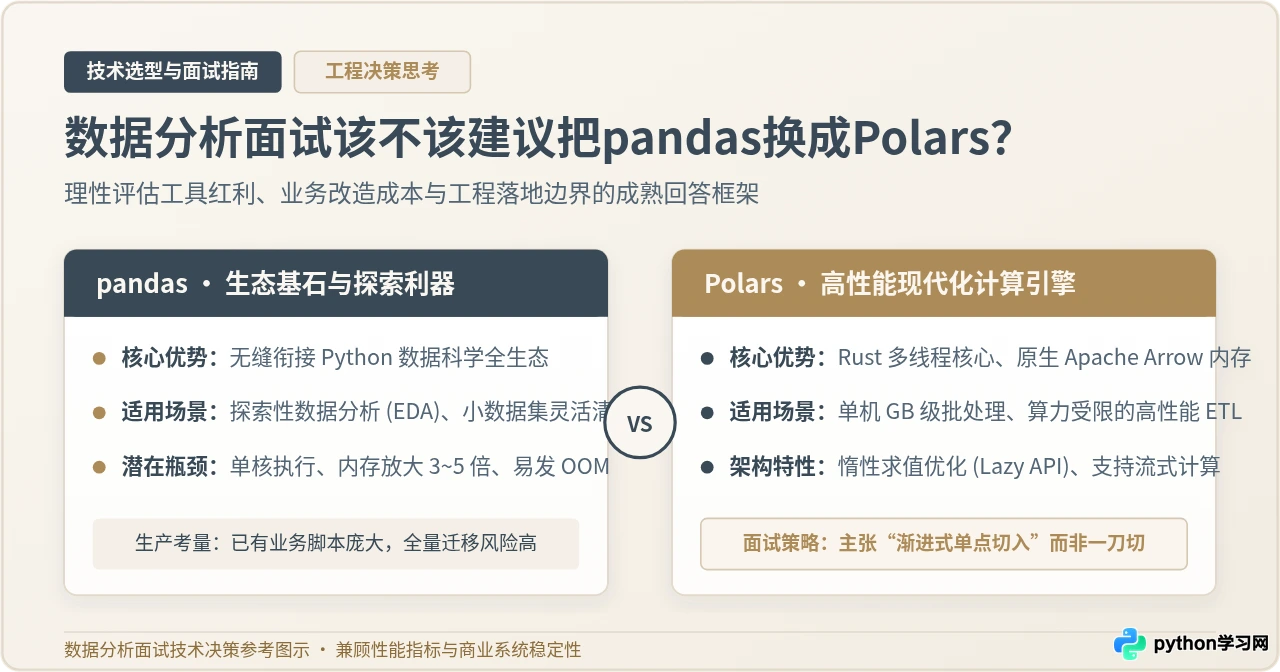
核心答案很明确:在数据分析面试中,绝不应盲目、一刀切地建议团队将 pandas 全部替换为 Polars,而应将其定位于“在单机高负载、内存吃紧或存在明确性能瓶颈的特定计算节点上的渐进式替代方案”。面试官抛出此题或听到你主动提及此话题时,考查的核心并非你追逐新兴开源库的热情,而是评估你是否具备区分探索性分析与生产工程落地、核算迁移改造成本与团队协同代价的成熟技术决策思维。
一、面试官的核心考察意图:技术敏锐度与工程成熟度
当面试中出现“你觉得我们团队现在用 pandas,该不该换成 Polars?”或者你自己在回答数据处理瓶颈时主动引出 Polars 时,对话的性质已经从单纯的“语法考核”跃升到了“技术选型与工程权衡”。很多候选人容易在这个问题上掉入陷阱,误以为只要热情洋溢地列举 Polars 的 Benchmark(基准测试跑分)比 pandas 快数倍到数十倍,就能证明自己的技术前瞻性。
在资深技术面试官或团队负责人眼中,脱离业务约束空谈性能往往被归类为“学生思维”或“唯新技术论”。面试官通常在考察以下三个维度的工程素质:
- 技术广度与原理理解:你是否真正了解现代数据处理框架的代际差异?你清楚 Polars 变快的底层机理(如 Apache Arrow、查询优化器、无锁并行),还是仅仅停留在背诵社区跑分?
- 商业与工程成本意识:你是否能预估将既有生产系统迁移到一个新库所需的隐形成本?这包括下游生态兼容性、历史脚本重写、CI/CD 构建环境调整以及全团队的学习曲线。
- 防御性与渐进式落地思维:在面对性能痛点时,你是否懂得“按需改造、局部验证、双轨测试”的工程安全准则,而不是轻率地倡导颠覆式重构。
二、底层机制与性能边界:不仅要知道“快”,更要讲清“为什么快”
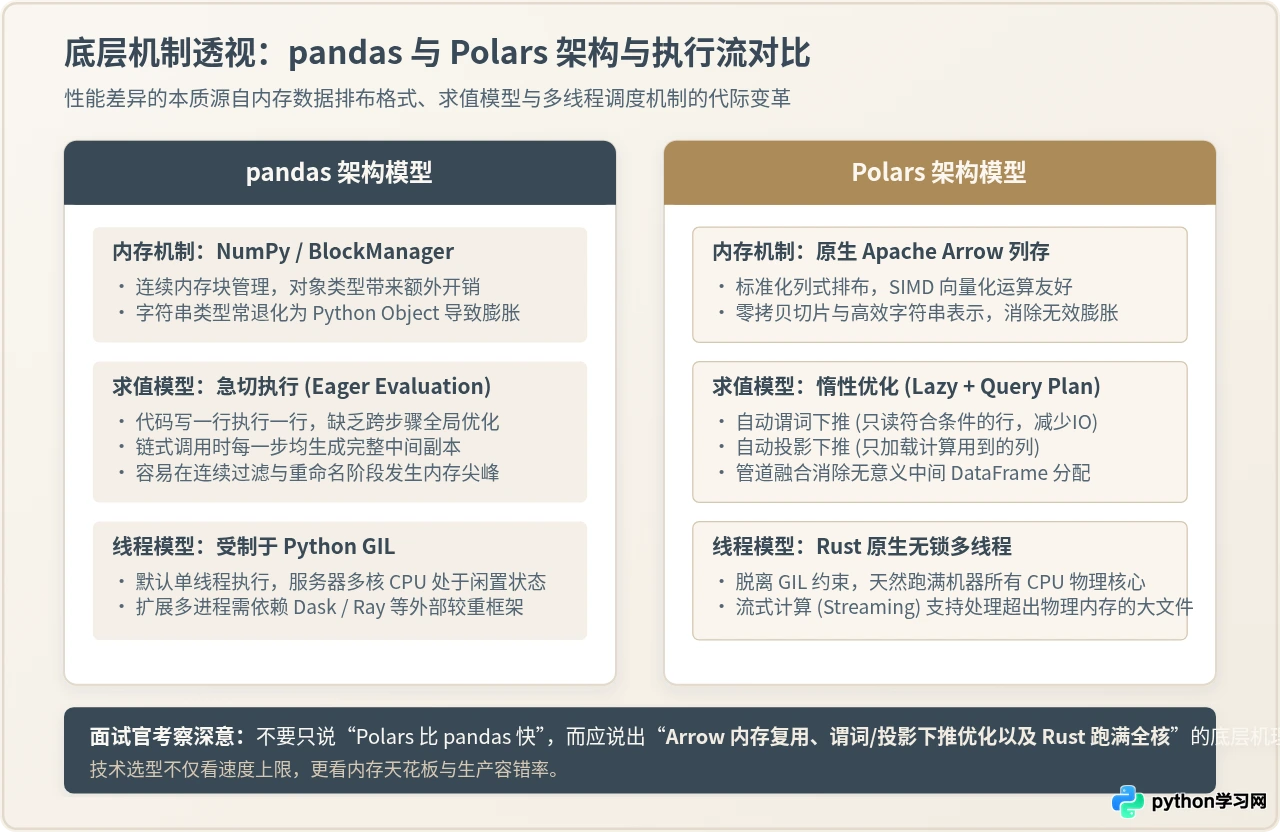
如果要在面试中给出高质量的建议,你必须能够在黑板或白板上讲清楚两者底层机制的根本差异。Polars 之所以能在绝大多数基准测试中大幅超越 pandas,并非简单的代码微调,而是由底层内存格式、求值模型和执行引擎三者共同决定的代际升级。
| 对比维度 | pandas (默认模型) | Polars (核心架构) |
|---|---|---|
| 底层内存格式 | 基于 NumPy 连续数组(BlockManager 管理),字符串常以 Python Object 形式存在,额外指针开销大。 | 原生基于 Apache Arrow 列存格式,内存紧凑,天然支持零拷贝(Zero-Copy)切片与 SIMD 向量化指令。 |
| 求值计算模型 | 急切求值(Eager Evaluation):每一步方法链执行立即分配新内存,多步骤连续计算产生大量瞬时对象。 | 惰性求值(Lazy API)为主:先构建计算图,查询优化器执行谓词下推(Predicate Pushdown)和投影下推(Projection Pushdown)。 |
| 多线程并发能力 | 受限于 Python 全局解释器锁(GIL),计算基本运行在单核 CPU 上,多核利用率低。 | 底层由 Rust 编写,拥有原生的无锁多线程并行能力,开箱即用跑满机器的所有物理 CPU 核心。 |
| 超内存数据集支持 | 无原生磁盘流式机制,当数据体积接近物理内存时,极易因内存放大(3~5倍)导致 OOM 崩溃。 | 提供 Streaming(流式)处理模式,支持将超出物理 RAM 的大文件分批流经计算管道。 |
| 生态与下游兼容 | 数据科学绝对标准,原生兼容 Scikit-learn、Statsmodels、SQLAlchemy、Matplotlib 等所有主流库。 | 下游对接机器学习时往往需要通过 Arrow 或转为 pandas/NumPy,频繁转换会抵消一部分性能优势。 |
在面试中表达这部分内容时,重点要突出两点细节:
第一,谓词下推(Predicate Pushdown)的实际价值:在 pandas 中执行 df = pd.read_csv("data.csv") 紧接着 df = df[df["status"] == "PAID"] 时,整个文件必须完整载入内存后再执行布尔过滤;而 Polars 的 scan_csv() 会直接把过滤条件推送到文件读取阶段,只将符合条件的行和指定的列反序列化进内存,从根本上降低了磁盘 I/O 和内存占用。
第二,内存放大效应(Memory Amplification):pandas 在做多列聚合与字符串处理时,内存消耗往往是原始文件体积的 3 到 5 倍。如果数据分析任务运行在 16GB 内存的云服务器上,处理 4GB 的 CSV 就随时有被 Linux OOM Killer 杀死的风险。而 Polars 的列式结构与按需流式机制能有效抑制峰值内存。
三、代码范式与思维转换:从链式变换到表达式(Expression)
在面试的代码考核或技术追问环节,面试官可能会让你简述两者在书写范式上的差异。Polars 并非 pandas 的简单语法克隆版,其核心设计理念是表达式(Expressions)驱动,这种设计不仅语法更一致,而且能帮助优化器自动实现跨表达式的并行计算。
import pandas as pd

# 1. 读入完整数据文件到内存
df = pd.read_csv("sales_records.csv", parse_dates=["sale_date"])

# 2. 连续中间过滤与派生列创建(每一步均产生中间对象)
valid_orders = df[df["order_status"] == "COMPLETED"].copy()
valid_orders["sale_month"] = valid_orders["sale_date"].dt.to_period("M")

# 3. 分组聚合统计
monthly_summary = (
    valid_orders.groupby(["department_id", "sale_month"])
    .agg(
        gross_revenue=("amount", "sum"),
        order_count=("order_id", "count"),
        avg_ticket=("amount", "mean"),
    )
    .reset_index()
)

# 4. 组内窗口计算:获取上一期销售额并计算环比增长
monthly_summary["prev_revenue"] = monthly_summary.groupby("department_id")[
    "gross_revenue"
].shift(1)
monthly_summary["mom_growth"] = (
    monthly_summary["gross_revenue"] - monthly_summary["prev_revenue"]
) / monthly_summary["prev_revenue"]
import polars as pl

# 1. 声明惰性查询计划(scan_csv 仅读取文件元数据 Schema,不实际载入数据)
lazy_plan = (
    pl.scan_csv("sales_records.csv")
    # 谓词下推:优化器自动在读取 CSV 阶段直接过滤,大幅减少无用行读入
    .filter(pl.col("order_status") == "COMPLETED")
    .with_columns(
        pl.col("sale_date").str.to_datetime().dt.truncate("1mo").alias("sale_month")
    )
    # 分组聚合:表达式在 Rust 内部全核并发计算
    .group_by(["department_id", "sale_month"])
    .agg([
        pl.col("amount").sum().alias("gross_revenue"),
        pl.col("order_id").count().alias("order_count"),
        pl.col("amount").mean().alias("avg_ticket"),
    ])
    .sort(["department_id", "sale_month"])
    # 窗口表达式:直接通过 over() 语法声明窗口,无需重复 groupby
    .with_columns(
        pl.col("gross_revenue").shift(1).over("department_id").alias("prev_revenue")
    )
    .with_columns(
        ((pl.col("gross_revenue") - pl.col("prev_revenue")) / pl.col("prev_revenue")).alias("mom_growth")
    )
)

# 2. 显式触发执行,由查询优化器编译执行图并跑满所有 CPU 核心
final_result = lazy_plan.collect()
在面试中提及上述代码差异时,可以强调两点:其一,Polars 没有复杂的 MultiIndex(多级层级索引),所有操作均基于扁平的关系型列语义,这规避了 pandas 中令初学者头疼的 reset_index() 陷阱;其二,Polars 表达式的 over() 语法与 SQL 窗口函数(Window Function)高度一致,对于具备 SQL 基础的数据分析师来说,心智负担其实比 pandas 的逐层 groupby-shift 更低。
四、典型业务场景下的选型边界
没有任何一个框架能全场景通吃。面试官最希望听到的不是非此即彼的站队,而是根据具体场景制定的选型决策矩阵。在实际业务研发中,数据分析工作可以清晰划分为以下四大场景:
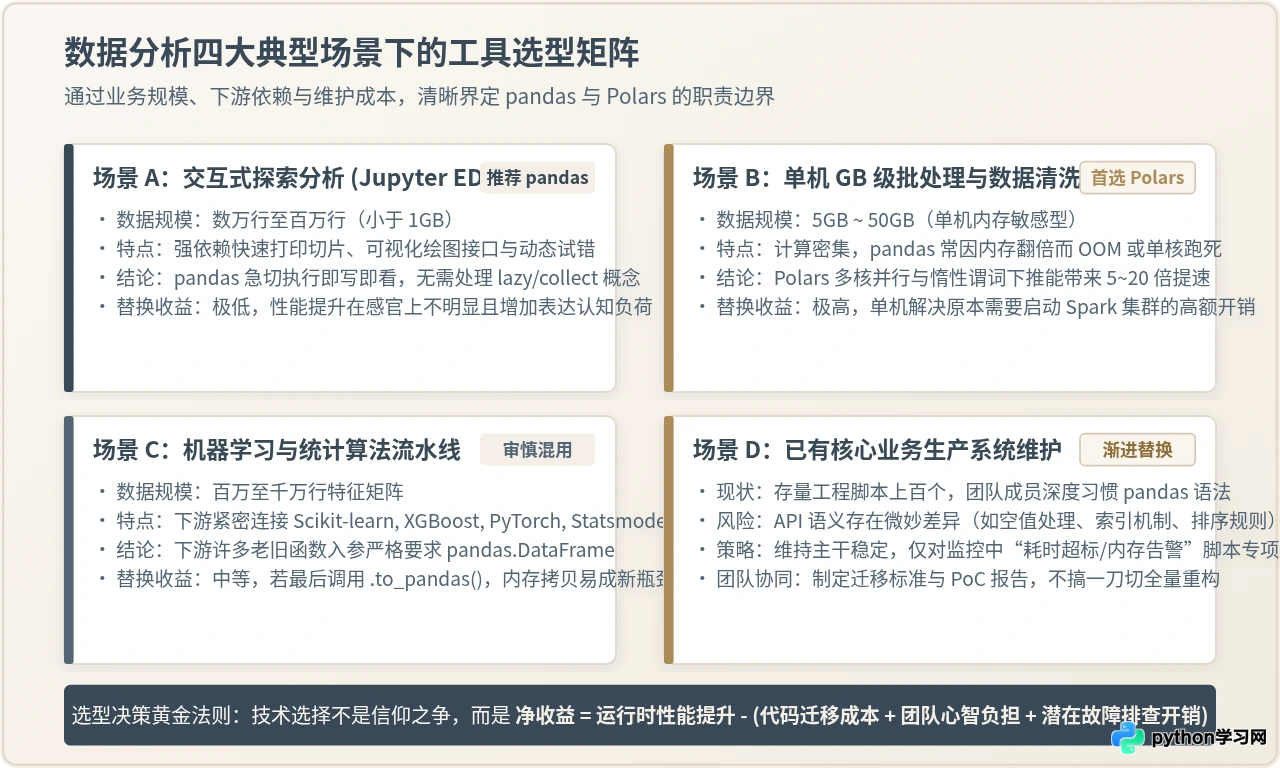
1. 交互式探索分析(Jupyter Notebook / 1GB 以下小数据集)
建议选择:继续保留 pandas。
在这个场景下,数据分析师追求的是极高频的即时反馈(REPL 模式),输入代码后需要立刻查看前五行、查看描述性统计或直接调用 Seaborn/Matplotlib 出图。此时数据量较小,pandas 的单核计算耗时通常在毫秒到秒级,性能完全不是瓶颈。强行使用 Polars 反而需要频繁编写 .collect(),且如果与某些专为 pandas 编写的绘图或统计库交互,还会增加转换成本,收益微乎其微。
2. 单机 GB 级离线批处理与 ETL 任务
建议选择:坚定推荐引入 Polars。
当单次处理的数据文件达到 5GB~30GB 时,pandas 的局限性会被无限放大:执行耗时长达数十分钟,多核服务器 CPU 利用率仅有 10%~20%,内存经常发生翻倍震荡甚至引发集群节点驱逐。如果为了这几十 GB 的数据去启动 Spark 分布式集群,不仅会引入高昂的云资源开销与复杂的部署依赖,还会因网络传输和序列化带来额外延迟。在此场景下,使用 Polars 单机多线程在几分钟内跑完,是投资回报率(ROI)最高的解法。
3. 下游衔接传统机器学习流水线
建议选择:审慎混用或保持 pandas。
如果当前数据处理的最终目标是给 Scikit-learn、LightGBM 或特定领域计量经济学库喂入特征矩阵,需要注意下游算法底层的输入期望。虽然 LightGBM 等现代库已经逐步支持 Arrow/Polars,但许多算法仍假定入参为 NumPy 数组或带特定索引的 pandas.DataFrame。如果在 Polars 中完成预处理后,最终必须调用 .to_pandas() 或 .to_numpy(),可能在转换边界引发一次完整的内存复制,吞噬掉先前的提速收益。
4. 存量业务系统与团队协同维护
建议选择:渐进式双轨推进,切忌全面翻新。
如果企业已有数十个生产脚本稳定运行了数年,代码库深度依赖 pandas。建议向面试官说明:绝对不应为了“技术时髦”去重写所有代码。即便测试用例覆盖充足,由于两个库在空值计算规则(Null vs NaN)、浮点数舍入精度以及边界排序上的微妙差异,全量重构极易引入不易察觉的线上业务逻辑 Bug。
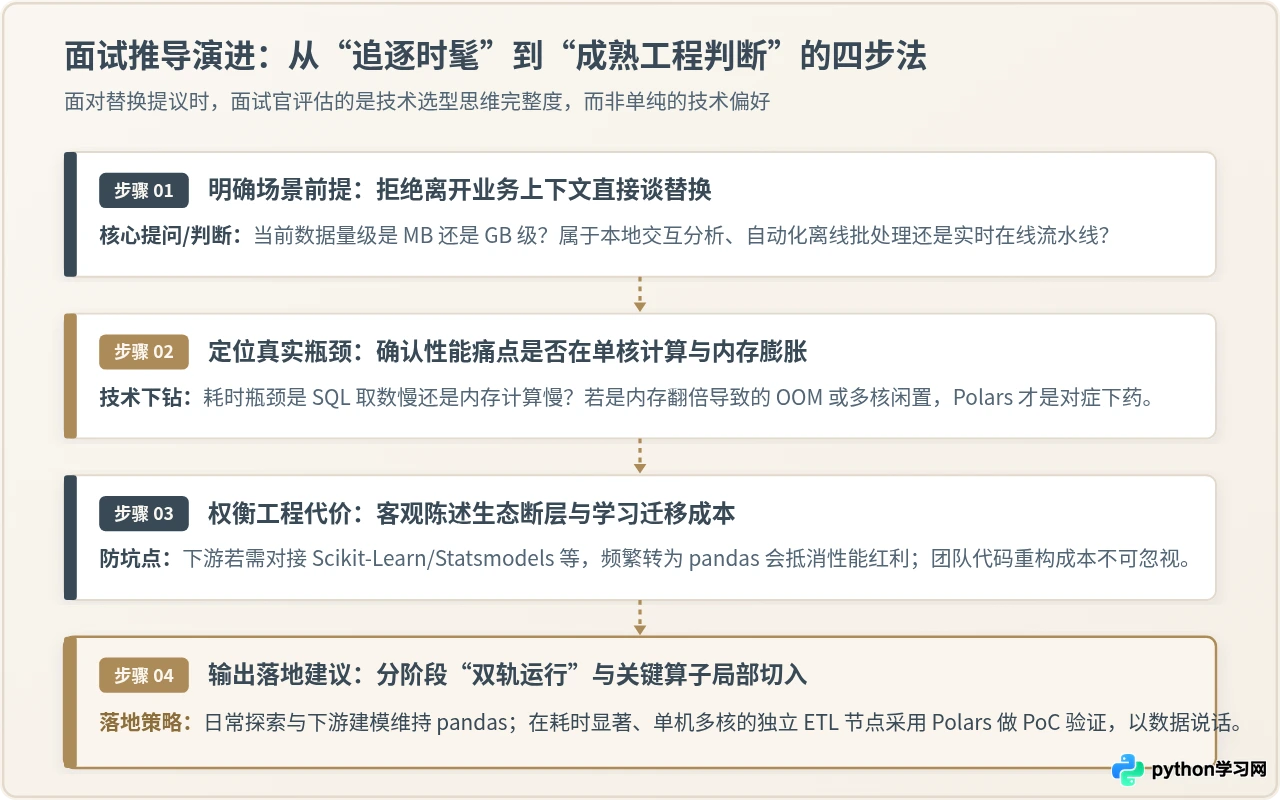
五、数据分析面试中的结构化答题四步法
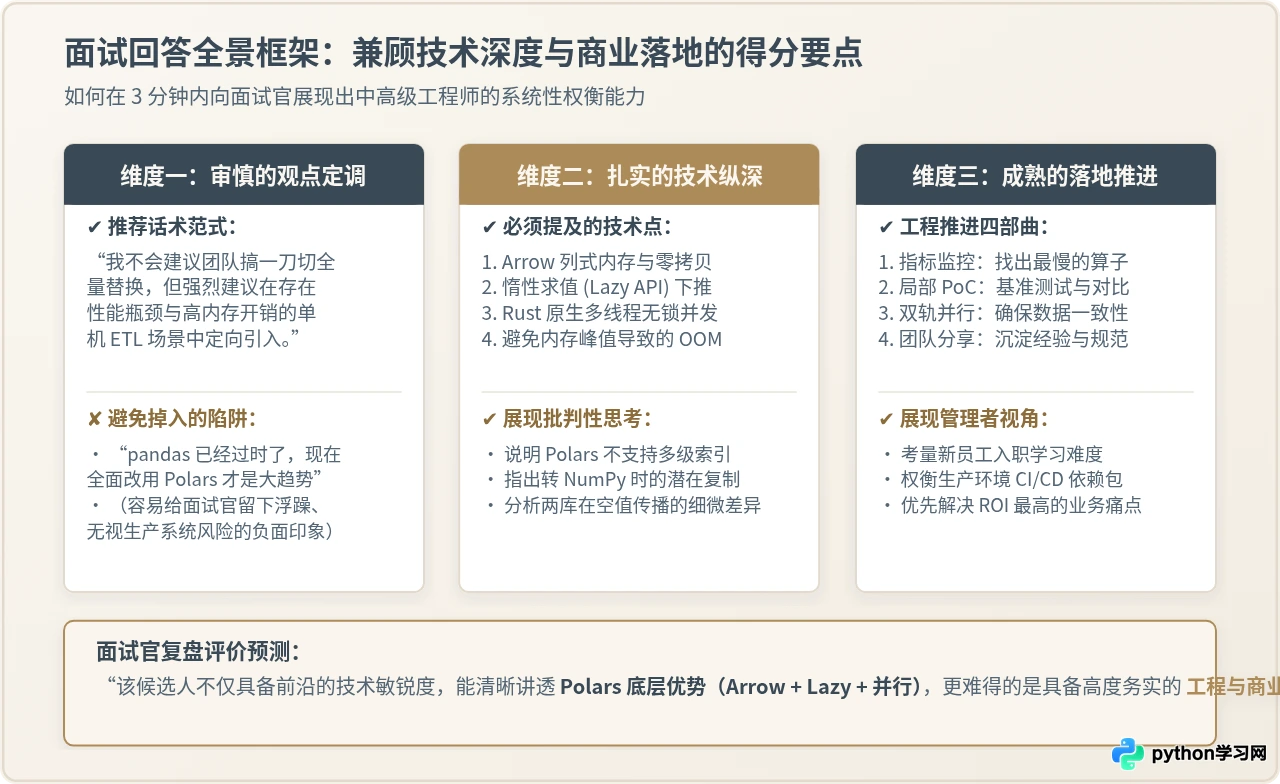
在面试中被问及“是否应该把 pandas 换成 Polars”时,可以按照以下经过实战检验的四步表达框架展开,展示系统化思维:
-
第一步:表明客观态度,界定前置条件(30秒)
“我认为不应该一刀切地建议团队全量把 pandas 替换为 Polars。技术选型必须服务于业务痛点。如果团队目前的数据量普遍在百兆级别,下游对接大量定制化的报表和机器学习生态,现有的 pandas 已经足够稳定且高效,全量迁移的风险和成本远大于收益。” -
第二步:明确指出痛点触发场景与 Polars 的不可替代性(60秒)
“但是,如果团队在单机 GB 级定时批处理、内存吃紧容易 OOM、或者多核服务器算力被闲置的具体场景下遇到了明显瓶颈,我强烈建议将这部分独立 ETL 算子逐步重构为 Polars。因为 Polars 基于 Rust 原生并发和 Apache Arrow 列式格式,配合其 Lazy API 的谓词下推与投影下推,可以在不引入 Spark 复杂集群的前提下,把原本数十甚至上百分钟的单机处理任务压缩到几分钟,显著节约机器成本。” -
第三步:深入阐明潜在风险与边界约束(45秒)
“同时在落地时我也必须提醒团队注意几个风险点:第一是生态断层,Polars 虽有成熟的 Arrow 生态,但与某些老旧 Python 科学计算库交互时仍需转换开销;第二是团队学习与维护成本,Polars 的表达式语法和无索引机制需要团队成员转换思维;第三是细微的算子语义差异,例如两者对缺失值(None/Null vs NaN)的传播机制不同,需要完备的单元测试保障。” -
第四步:给出稳妥可执行的工程推进方案(45秒)
“因此在实际推行中,我会建议采用‘局部试点、PoC 验证、双轨对比、沉淀规范’的渐进策略:先挑出一个性能瓶颈最严重、上下游依赖最清晰的离线数据清洗任务作为试点,对比两者的运行耗时、内存峰值与结果一致性;验证收益显著后,沉淀团队内部的最佳实践文档,再视情况推广到类似的大数据量任务中。”
六、高频追问防坑指南
在给出上述完整回答后,经验丰富的面试官往往会继续深入追问以探明你的技术边界。提前准备好以下三个典型追问的应对口径,能让你在面试中更加从容:
追问 1:“既然 Polars 这么快,为什么 pandas 2.0 引入 PyArrow 后不能解决所有问题?”
参考思路:pandas 2.0 虽然引入了 PyArrow 作为可选的底层后端(可以避免字符串退化为 Python Object 以及解决部分缺失值混乱),但它并没有改变 pandas 的核心求值骨架——它依然是急切执行(Eager Execution)为主,并且受制于 Python GIL 的约束,无法像 Rust 编写的 Polars 那样在底层原生进行无锁细粒度的工作窃取(Work-Stealing)多线程调度,因此在跨步骤查询优化与全核并发上仍然存在代际差距。
追问 2:“如果数据量大到 Polars 也处理不了,你是建议加机器内存,还是改用 Spark,还是考虑 DuckDB?”
参考思路:首先看是否超出了单机外存极限。如果在 100GB 以内且以结构化分析为主,DuckDB 是一个非常优秀的嵌入式 SQL 替代品,它能与 Arrow/Polars 共享零拷贝内存,直接执行 SQL 复杂查询;若数据量真正达到 TB 级且需要分布式存储与容错机制,才建议转向 Spark 或 Trino。选择 Spark 的前提一定是‘业务规模真正超越了单机垂直扩展(Scale-up)的物理天花板’,而不是盲目追求分布式架构。
追问 3:“在现存代码库中,如果一定要在某个模块引入 Polars,如何保证结果与原有 pandas 脚本 100% 一致?”
参考思路:建立影子双轨运行(Shadow Pipeline)机制。在测试环境中,让同一份生产输入数据分别流经原有 pandas 脚本与重构后的 Polars 脚本,随后将两者产出的最终数据集转换为标准 Arrow 表或 Parquet 文件,通过严格的 Schema 校验、数值绝对容差(assert_series_equal(..., atol=1e-5))以及空值统计进行逐行逐列断言对比,确保业务口径零偏差后再行上线。
在数据分析面试中,面试官问“该不该换”,永远不是在等一个简单的“该”或“不该”。展现出对技术机理的深挖能力、对业务价值的尊重、对工程风险的敬畏以及稳步推进的执行力,才是从众多候选人中脱颖而出的致胜密码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















