


数据科学新手该先学Anaconda3还是PyCharm?
针对数据科学初学者的工具选择难题,详细对比Anaconda3与PyCharm的本质定位、适用场景、学习路线与协作工作流,提供清晰明确的学习优先级与实操指南。
一、本质区别:运行环境底座 vs 专业代码工作台
许多初学者之所以产生“二选一”的困惑,主要源于对两款软件定位的混淆。在软件工程范畴中,它们承担的职责处于完全不同的层级:
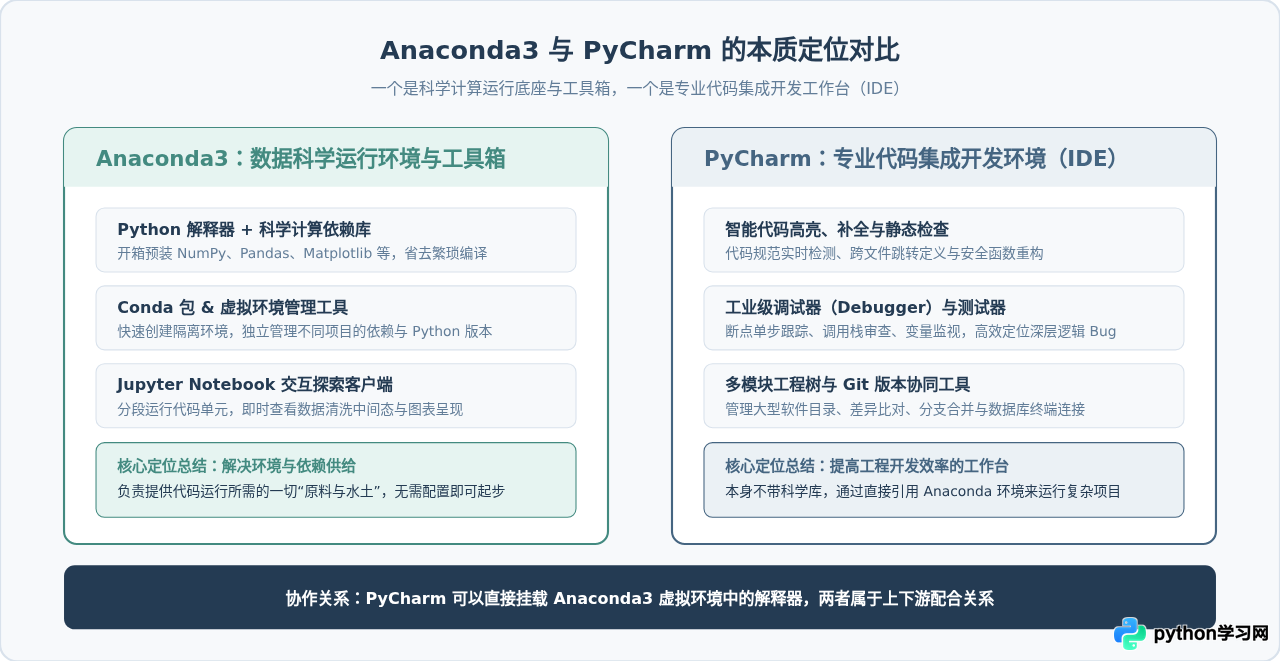
- Anaconda3 是一个科学计算发行版与运行环境管理系统:它不仅包含标准 Python 解释器,还集成了 Conda 包管理器,并预装了数据分析与机器学习所需的核心工具栈(如 NumPy、Pandas、Matplotlib、SciPy、Jupyter Notebook 等)。它的核心价值是“提供开箱即用、依赖完备的 Python 运行土壤”。
- PyCharm 是一个专业的集成开发环境(IDE):它由 JetBrains 开发,专精于代码编辑、语法智能提示、多文件跳转、重构、可视化调试以及 Git 团队协同。PyCharm 本身不自带数据分析第三方库,必须依靠外部的 Python 解释器或 Conda 环境来执行代码。
二、为什么数据科学新手应该先从 Anaconda3 切入?
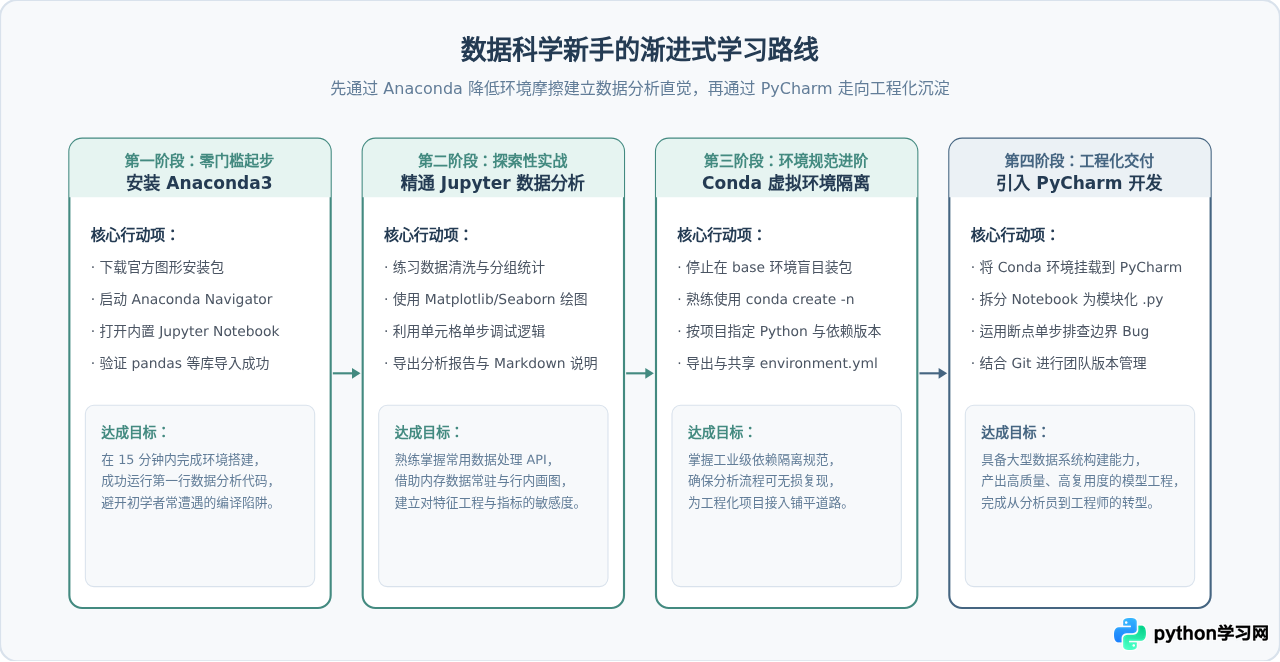
数据科学的学习曲线与传统 Web 后端开发不同。新手入门时面临的最大阻力往往不是 Python 语法本身,而是环境依赖报错与无法即时观察数据变化。优先选择 Anaconda3 能够带来以下三项决定性收益:
1. 彻底规避科学计算库的编译与依赖泥潭
数据科学库(如 NumPy、SciPy、Pandas、scikit-learn)包含大量用 C、C++ 或 Fortran 编写的底层加速代码。若仅安装官方原生 Python 后通过 pip 逐个安装,往往会因本地缺少对应版本的 Visual C++ Build Tools 或系统底层动态链接库而遭遇安装失败。Anaconda 官方仓库中的二进制包经过了官方预编译与兼容性测试,一键安装即可拥有完整可用的科学计算环境。
2. Jupyter Notebook 提供的即时交互反馈
探索性数据分析(EDA)需要频繁检查中间结果:比如读取了一张包含 100 万行数据的 CSV 表格,需要查看前 5 行、检查空值分布、或者调整绘图配色。
在传统 IDE(如 PyCharm)中执行常规 .py 脚本时,代码每次运行都必须从第一行重新执行,重新加载数秒甚至数分钟的数据文件。而 Anaconda3 附带的 Jupyter Notebook 允许将代码切分为多个独立的单元格(Cell),数据常驻内存,修改画图代码只需重新运行单个单元格,一秒内即可查看图表渲染结果。这种“探索—即时反馈”的节奏是培养数据直觉的最佳途径。
3. Conda 提供的沙盒式环境隔离能力
当后续开始涉足深度学习(如 PyTorch、TensorFlow)时,不同框架对 CUDA 驱动和 Python 小版本的要求各不相同。借助 Anaconda 的 Conda 工具,新手仅需一条命令即可搭建纯净的沙盒环境,完全不用担心把主系统的 Python 环境搞乱。
三、什么时候需要引入 PyCharm?
随着分析任务的推进,Jupyter Notebook 会逐渐暴露其自身局限:单个 .ipynb 文件如果膨胀到几千行代码,单元格上下翻找困难;隐式的全局变量状态容易导致“在这一格能跑,换台电脑重新执行却报错”;多人协作时 JSON 格式的 .ipynb 极难在 Git 中解决代码冲突。
当遇到以下三类典型场景时,就应当开始引入 PyCharm:
-
多文件架构与面向对象封装:需要将常用的数据预处理函数抽取为
data_utils.py,将模型结构封装为model.py,并编写train.py与evaluate.py。PyCharm 能够清晰展现目录树,并在文件间提供精准的代码跳转。 -
复杂逻辑的断点调试:当管道(Pipeline)处理复杂嵌套 JSON 数据发生 KeyError,或者模型输出维度不匹配时,PyCharm 的 Debugger 允许随时暂停在某一行,实时展开内存变量字典查看每个字段,比在代码中到处添加
print()语句高效数十倍。 - 生产部署与接口服务:需要使用 FastAPI 或 Flask 将算法封装为 HTTP API,或者需要编写自动化定时抓取与清洗服务时,PyCharm 完备的项目结构与测试套件支持不可或缺。
四、标准协同工作流:在 PyCharm 中接入 Anaconda3 解释器
许多新人在初次使用 PyCharm 时容易犯错:他们在系统里既装了 Anaconda3 又在 PyCharm 里新建原生 venv,导致在外部装好的库在 PyCharm 报错找不到模块。
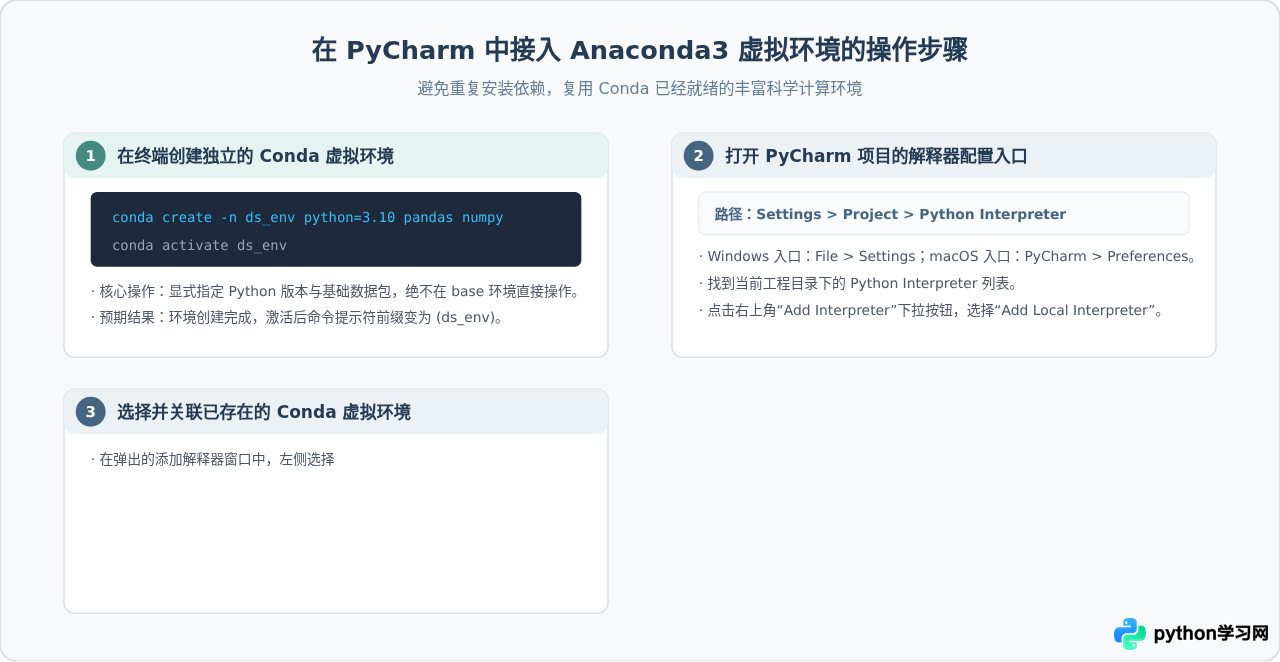
正确的协同姿势是:让 PyCharm 直接使用 Anaconda3 已经创建好的 Conda 虚拟环境。具体操作遵循以下四个步骤:
五、选型决策指南与核心维度对比
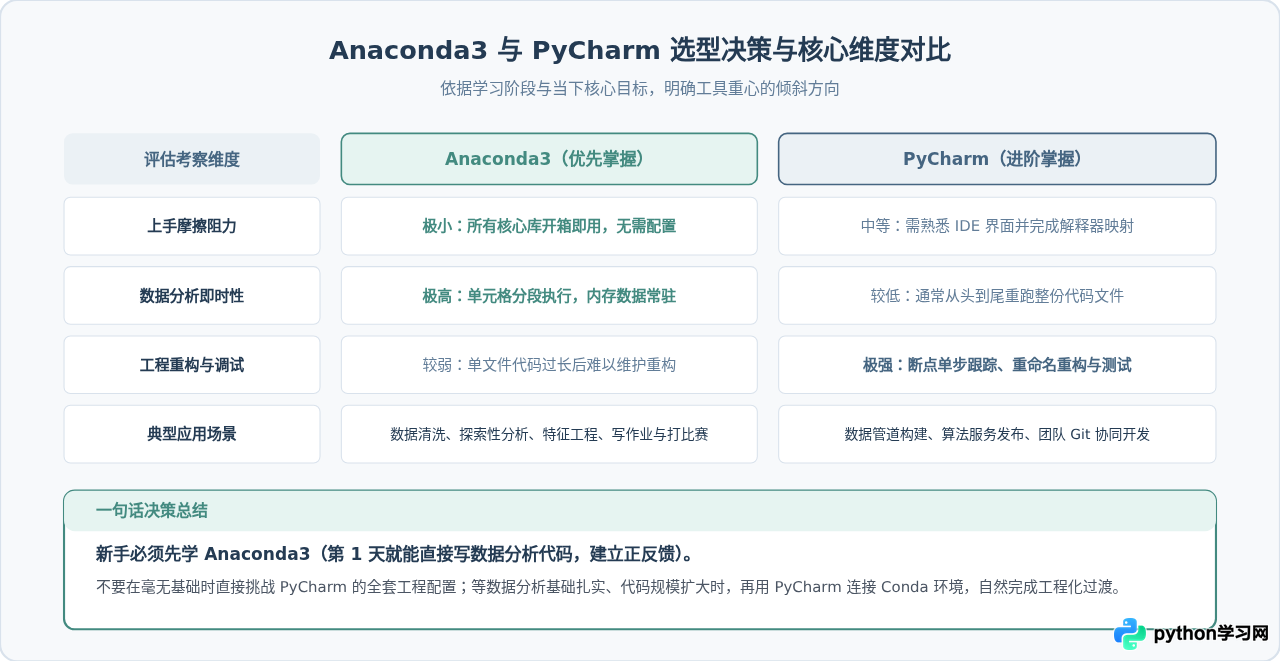
为了帮助初学者建立直观的心理模型,下表将两款工具在数据科学全流程中的关键表现进行了系统化汇总:
| 对比维度 | Anaconda3(附带 Jupyter) | PyCharm(社区版 / 专业版) |
|---|---|---|
| 核心定位 | 科学计算 Python 发行版、Conda 依赖与环境管理器 | 专业 Python 代码集成开发环境(IDE) |
| 新手配置门槛 | 极低,图形化安装包一键就绪,零依赖缺失报错 | 中等,需理解项目目录概念并手动绑定 Python 解释器 |
| 交互式数据探索 | 卓越,Notebook 分块执行、变量内存常驻、表格可视化展示 | 一般,纯脚本必须整体执行,中间数据需手动输出查看 |
| 复杂代码重构与调试 | 较弱,仅提供基础异常报错,多文件搜索与跳转能力有限 | 极强,工业级断点调试器、跨文件安全重命名、调用栈排查 |
| Git 协同与工程化支持 | 较差,.ipynb 文件包含运行输出,Git 差异对比极其繁琐 | 极强,原生图形化 Git 分支管理、代码审查与单元测试框架 |
| 建议学习阶段 | 第一阶段(必修基础):第 1 天起立即使用 | 第二阶段(工程进阶):开始写多模块项目时引入 |
六、新手常见误区与避坑建议
Anaconda 自带一个名为
base 的默认全局环境,专门负责维持 Anaconda Navigator 和 Conda 本身的运行。如果在这里使用 pip install 随意安装更新各种库,极易引起底层依赖冲突导致整个 Conda 损坏。正确的做法是:每开启一个新项目或新课程,都用 conda create -n my_project 创建独立环境。
在 Conda 虚拟环境中,优先使用
conda install [package] 安装核心库(能够保证 C 语言底层依赖的二进制匹配)。如果某个小众库仅在 PyPI 上提供,再在该环境激活状态下执行 pip install [package]。尽量不要反复交替混用,以防依赖树紊乱。
业内成熟的数据科学家与算法工程师的日常节奏大多是:在 Jupyter 中做前期探索与方案验证,在 PyCharm 中进行代码封装、重构与部署。先从 Anaconda3 切入,不仅能以最低成本跨过最初的入门门槛,还能为后续使用 PyCharm 打下完备坚实的环境基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















