


Python基础语法核心:变量、列表、字典与控制流详解
深入解析Python语言四大基础核心:变量引用模型、列表序列操作、字典哈希映射与分支循环控制流,帮助开发者建立扎实的代码编写与排错基础。
一、变量与数据引用机制
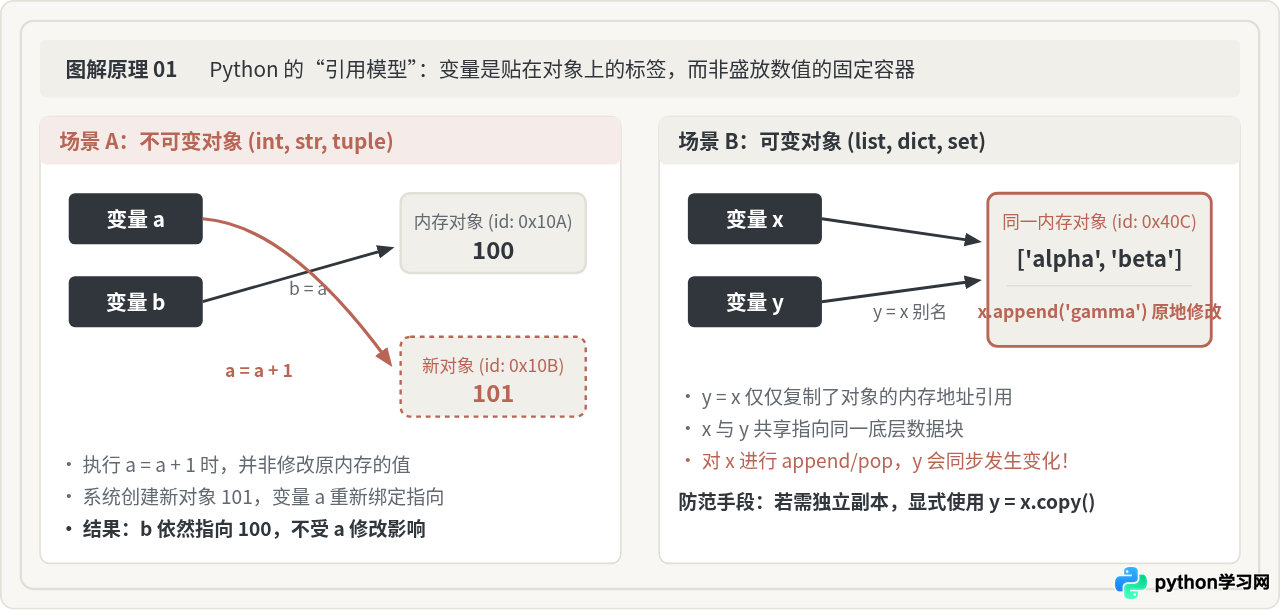
在许多静态编译语言中,变量常被视作开辟在栈空间内、类型固定且用来“存放具体数值”的内存盒子。然而在 Python 的运行时世界中,变量只是贴在内存对象上的标签(指针引用)。
当我们在 Python 中执行赋值语句 x = 100 时,解释器首先在堆内存中创建整数对象 100,随后创建变量名称 x 并将其指针指向该整数对象的物理地址。理解这一机制是防范数据意外修改与排查别名 Bug 的第一道关卡。
1. 不可变对象 vs 可变对象的本质分界
Python 将内置类型严格划分为不可变对象(Immutable)与可变对象(Mutable):
- 不可变类型(int, float, str, tuple, frozenset):一旦创建,其在内存中的内容便无法更改。任何看起来是在“修改”变量的操作(例如数字累加、字符串拼接),本质上都是解释器创建了一个全新的对象,并使变量指针重新指向新对象。
- 可变类型(list, dict, set):对象在内存中的槽位允许进行原地(In-place)修改,例如添加、删除或更新元素,而该对象的内存地址(由
id()函数返回)自始至终保持不变。
# 1. 不可变对象示例(整数与字符串)
val_a = 42
val_b = val_a
val_a += 1

print(f"val_a 值为: {val_a}, id 为: {id(val_a)}")
print(f"val_b 值为: {val_b}, id 为: {id(val_b)}")

# 2. 可变对象示例(列表共享引用)
origin_list = [10, 20]
alias_list = origin_list  # 仅仅复制了内存引用地址,未产生新列表
origin_list.append(30)

print(f"origin_list: {origin_list}")
print(f"alias_list: {alias_list}")
print(f"两者是否指向同一对象: {origin_list is alias_list}")
val_a 值为: 43, id 为: 4378901248
val_b 值为: 42, id 为: 4378901216
origin_list: [10, 20, 30]
alias_list: [10, 20, 30]
两者是否指向同一对象: True
== 用于比较两个对象持有的数值或内容是否相等;而 is 则是判断两个变量是否引用堆内存中的同一物理对象(即 id(a) == id(b))。判断变量是否为 None 时务必使用 val is None,而比对常规数据内容时应使用 ==。
二、列表(List)的核心操作与内存特性
列表是 Python 中最常用的有序容器。在底层 CPython 实现中,列表被设计为一个由对象指针构成的动态连续数组。这一特性赋予了列表通过索引进行 O(1) 随机访问的极致速度,但同时也决定了在不同位置增删元素的时间成本差异。
1. 双向索引与切片边界规则
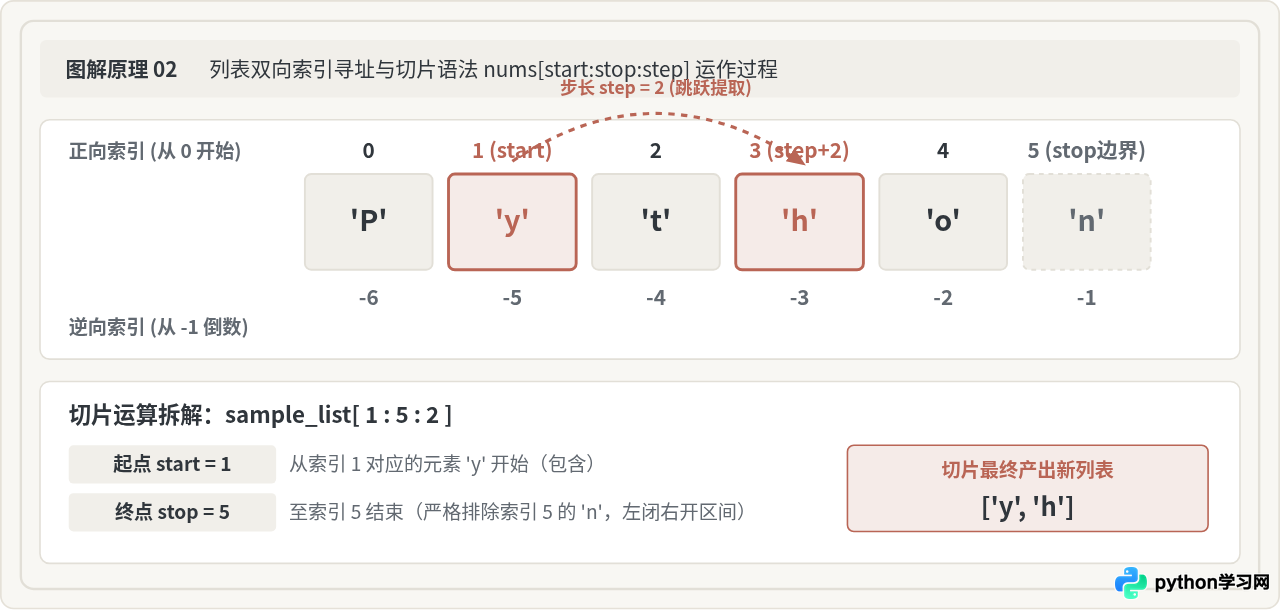
Python 列表支持正向与逆向双向寻址:
- 正向索引从
0开始依次递增,首个元素为list[0],末尾为list[len-1]。 - 逆向索引从
-1开始向前倒数,list[-1]始终代表尾部最后一个元素,极大简化了尾部访问操作。
切片语法采用统一的标准格式 sequence[start:stop:step],核心判定原则为左闭右开区间(包含 start,但不包含 stop)。当 step 为负数时,切片方向反转,常用于逆序提取,如 nums[::-1]。
chars = ['P', 'y', 't', 'h', 'o', 'n']

# 切片操作:包含起始位置 1,截至位置 5(排除索引 5),步长 2
sliced = chars[1:5:2]
print(f"切片 chars[1:5:2] 结果: {sliced}")

# 负步长切片:整列逆序输出
reversed_chars = chars[::-1]
print(f"逆序 chars[::-1] 结果: {reversed_chars}")

# 列表推导式(List Comprehension):过滤偶数并计算平方
numbers = [1, 2, 3, 4, 5, 6]
even_squares = [n ** 2 for n in numbers if n % 2 == 0]
print(f"推导式计算偶数平方: {even_squares}")
切片 chars[1:5:2] 结果: ['y', 'h']
逆序 chars[::-1] 结果: ['n', 'o', 'h', 't', 'y', 'P']
推导式计算偶数平方: [4, 16, 36]
2. 常见操作的时间复杂度权衡
| 操作方法 | 典型语法 | 时间复杂度 | 执行行为与内部原因 |
|---|---|---|---|
| 尾部追加 | lst.append(x) |
O(1) 均摊 | 预留过分配空间,直接在末尾指针处赋值,无须挪动现有元素。 |
| 尾部弹出 | lst.pop() |
O(1) | 直接将数组逻辑长度减 1,释放末尾引用。 |
| 头部插入 | lst.insert(0, x) |
O(n) | 数组连续性要求从索引 0 开始的所有后续元素统一向后移动一位。 |
| 按值删除 | lst.remove(x) |
O(n) | 首先线性遍历定位元素,找到后将后续全部元素向前位移填补空缺。 |
三、字典(Dictionary)的键值映射与哈希机制
字典是 Python 中处理结构化映射的核心数据结构。与列表的顺序遍历不同,字典在处理大规模数据集时能够做到近乎瞬间的查找、插入与更新。这一优异特性的根基在于其底层的哈希表(Hash Table)架构。
1. 为什么字典访问是 O(1)?
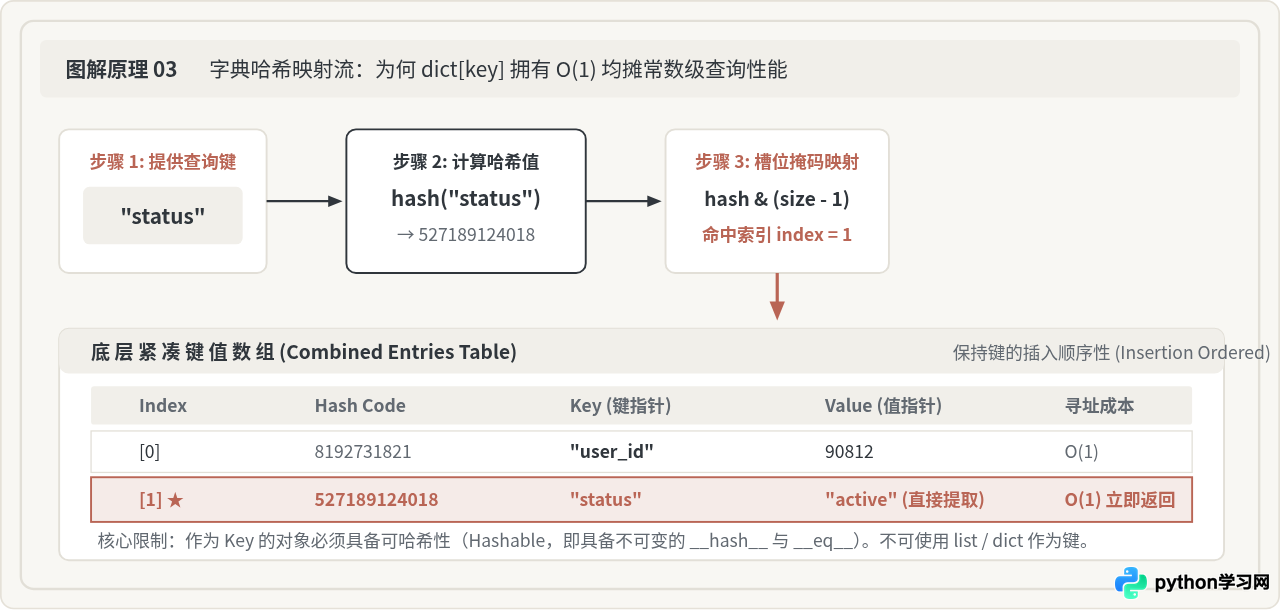
当调用 dict[key] 时,解释器并非从第一个键开始逐个比对,而是历经以下三个严格确定的步骤:
- 哈希化:调用内置函数
hash(key)计算该键的整数哈希值。 - 槽位掩码运算:利用哈希值与当前哈希表容量进行位运算(
hash & mask),直接换算出该键对应的数组索引位置。 - 精准寻址:直接跳至指定槽位,比对目标键与存储键的等价性。若无碰撞则单次取回对应的值指针,耗时与字典规模完全无关。
正因如此,作为字典 Key 的对象必须是可哈希的(Hashable)。字符串、整数、浮点数和元组(若元组内部元素均不可变)是合法的键;而列表、字典或集合等可变容器由于内容可变、哈希值不固定,不能充当键,否则将直接抛出 TypeError: unhashable type: 'list'。
2. 核心防御性操作方法
user_profile = {
    "username": "dev_alex",
    "role": "engineer",
    "logins": 12
}

# 1. 安全访问:使用 get() 避免 KeyError 导致程序中断
dept = user_profile.get("department", "未分配部门")
print(f"部门信息: {dept}")

# 2. setdefault():键不存在时赋默认值,存在时返回已有值
tags = user_profile.setdefault("skills", [])
tags.append("Python")

# 3. 批量更新:update() 合并字典
user_profile.update({"status": "active", "logins": 13})

# 4. 字典项遍历
for k, v in user_profile.items():
    print(f"  - 属性 {k}: {v}")
部门信息: 未分配部门
- 属性 username: dev_alex
- 属性 role: engineer
- 属性 logins: 13
- 属性 skills: ['Python']
- 属性 status: active
四、控制流(Control Flow)与逻辑分支
如果说变量、列表与字典是数据的载体与骨架,那么控制流就是让数据按业务意图运转的神经中枢。Python 的控制流包含条件判断分支与循环遍历调度,其设计强调语法的直观性与严格的缩进规范。
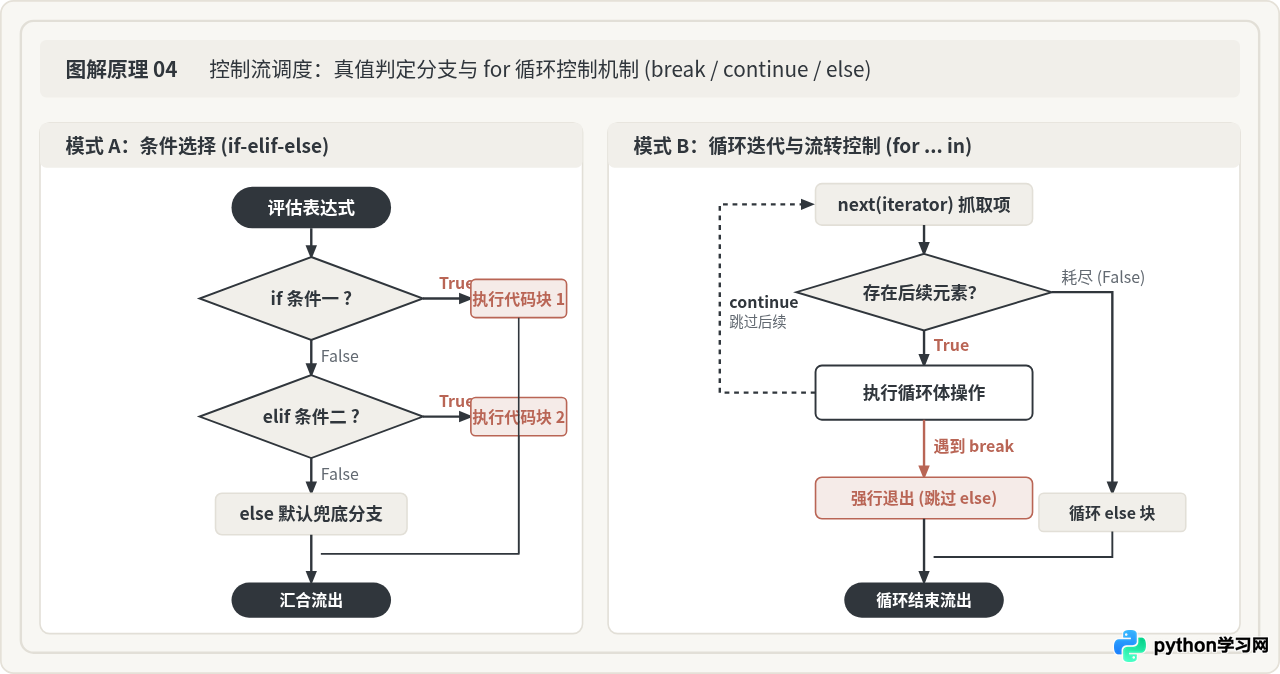
1. 条件判断与真值测试(Truth Value Testing)
在 if 条件表达式中,Python 并不局限于判定布尔型变量 True 或 False。所有标准对象都有内建的“真值(Truthy)”或“假值(Falsy)”属性:
- 固有假值对象(Falsy):包括
None、数字零(0,0.0)、空序列与空集合("",[],(),{},set())。 - 其余对象皆为真值(Truthy):任何非空容器或非零数值均自动判定为成立。因此推荐写
if items:判断列表是否非空,而非冗余的if len(items) > 0:。
2. 循环遍历工具:range, enumerate 与 zip
Python 倡导利用迭代器协议直接遍历容器元素本身,而不是通过下标计数器繁琐递增。内置函数让循环更加优雅清晰:
users = ["Alice", "Bob", "Charlie"]
scores = [95, 82, 88]

# 1. enumerate:同时获取遍历索引与元素
for idx, name in enumerate(users, start=1):
    print(f"排名第 {idx} 位学员: {name}")

# 2. zip:并行解包组合多个可迭代对象
for name, score in zip(users, scores):
    print(f"学员 {name} 的最终评分为: {score}")

# 3. 循环中 else 块的特殊用途:仅当循环正常耗尽(未被 break 中断)时触发
target_name = "David"
for name in users:
    if name == target_name:
        print("目标学员已找到!")
        break
else:
    print(f"遍历全员后未找到目标学员: {target_name}")
排名第 1 位学员: Alice
排名第 2 位学员: Bob
排名第 3 位学员: Charlie
学员 Alice 的最终评分为: 95
学员 Bob 的最终评分为: 82
学员 Charlie 的最终评分为: 88
遍历全员后未找到目标学员: David
for item in my_list: 期间调用 my_list.remove(item) 会导致迭代器内部下标向前位移,引发相邻元素被无视跳过的隐蔽逻辑 Bug;对于字典,在遍历过程中增删键更会直接抛出 RuntimeError: dictionary changed size during iteration。正确方案是遍历其浅拷贝:for item in my_list.copy(): 或使用列表推导式直接生成过滤后的新列表。
五、四大核心语法协同实战:数据清洗与分组统计
在真实的工程实践中,变量、列表、字典与控制流从来都不是孤立运作的。下面通过一个具体的数据处理任务,展示这四项核心能力如何在代码中协同构建稳健、高效的处理链路。
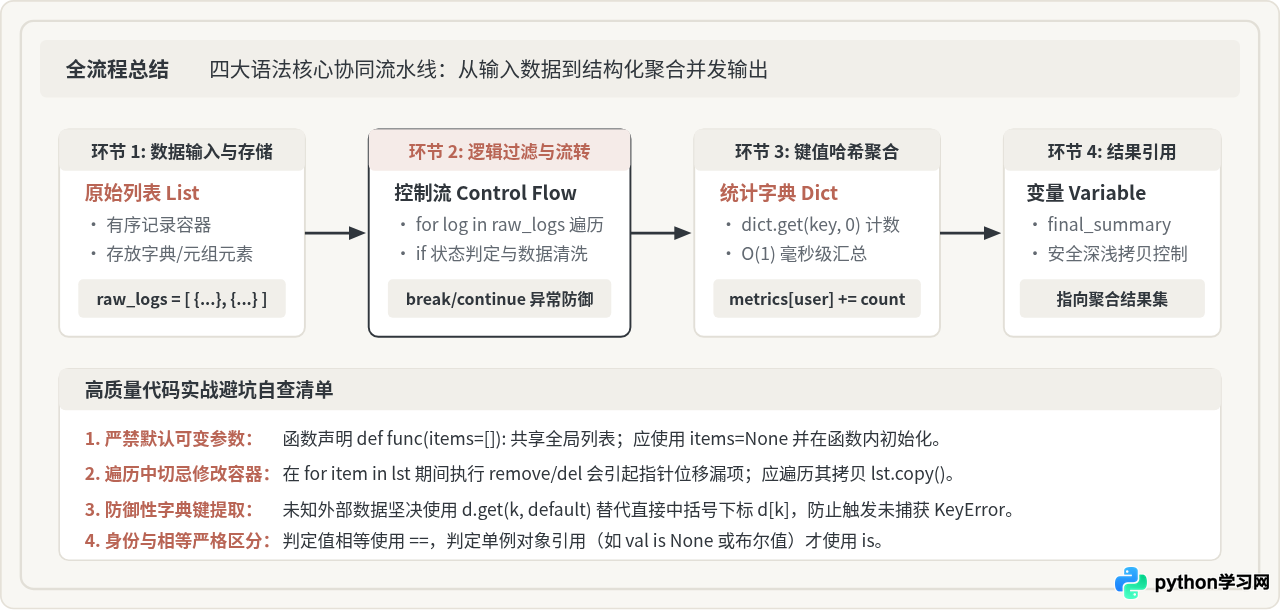
# 1. 变量声明与原始数据集定义(列表内嵌字典)
raw_transactions = [
    {"id": 101, "user": "Alice", "amount": 320.0, "status": "completed"},
    {"id": 102, "user": "Bob",   "amount": -50.0,  "status": "invalid"},
    {"id": 103, "user": "Alice", "amount": 150.5, "status": "completed"},
    {"id": 104, "user": "Charlie", "amount": 80.0, "status": "completed"},
    {"id": 105, "user": "Bob",   "amount": 210.0, "status": "completed"},
]

# 2. 结构化字典容器:用于用户维度的金额累计与订单计数
user_stats = {}

# 3. 控制流遍历清洗与哈希聚合
for item in raw_transactions:
    # 过滤条件一:状态校验;过滤条件二:异常负向金额剔除
    if item.get("status") != "completed" or item.get("amount", 0) <= 0:
        continue  # 跳过非法记录

    user = item["user"]
    amount = item["amount"]

    # 利用 setdefault 初始化嵌套字典结构
    current_data = user_stats.setdefault(user, {"total_spent": 0.0, "order_count": 0})
    current_data["total_spent"] += amount
    current_data["order_count"] += 1

# 4. 列表推导式重构输出:提取优质大客户名单(消费金额超过 200)
vip_users = [
    u for u, data in user_stats.items()
    if data["total_spent"] > 200.0
]

print("===== 用户汇总统计数据 =====")
for username, summary in user_stats.items():
    print(f"用户 [{username}] : 累计消费 ¥{summary['total_spent']:.2f}, 有效订单 {summary['order_count']} 笔")

print(f"\n重点 VIP 客户列表: {vip_users}")
===== 用户汇总统计数据 =====
用户 [Alice] : 累计消费 ¥470.50, 有效订单 2 笔
用户 [Charlie] : 累计消费 ¥80.00, 有效订单 1 笔
用户 [Bob] : 累计消费 ¥210.00, 有效订单 1 笔
重点 VIP 客户列表: ['Alice', 'Bob']
六、总结与工程编写规范
熟练运用 Python 基础语法并不仅仅在于记住关键字的拼写,而在于深刻领会这四大核心在内存与运行时中的底层行为逻辑:
- 变量是引用的载体:时刻区分对象的“值复制”与“地址引用”,面对可变对象作为函数参数传递或变量赋值时,养成明确审查是否需要执行
copy()或copy.deepcopy()的习惯。 - 列表注重顺序与连续性:针对频繁随机索引与末尾追加读取的场景,列表是最佳选择;但面对频繁在头部或中间插入删除的大数据序列,应及时选用双端队列
collections.deque。 - 字典主导关联与速查:充分利用字典哈希表的
O(1)性能进行快速排重与数据聚合,善用dict.get()进行防御性编码,杜绝未捕获异常。 - 控制流遵循简洁与安全规范:利用可迭代对象本身展开循环,不在循环体执行过程中破坏迭代容器,让程序的分支与退出路径清晰可测。
构建软件系统就像搭建坚固的大厦,变量、列表、字典与控制流就是最坚实的地基石材。将这些核心概念在脑海中内化为清晰的指针与数据流模型,是迈向高效 Python 进阶开发的必经之路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















