


Python数据分析入门:泰坦尼克号生存预测全流程实战
面向Python初学者的泰坦尼克号生存预测实战教程。完整覆盖数据读取、探索性数据分析(EDA)、缺失值清洗、特征衍生、模型训练、交叉验证评估与结果输出全流程。
一、实战目标与环境准备
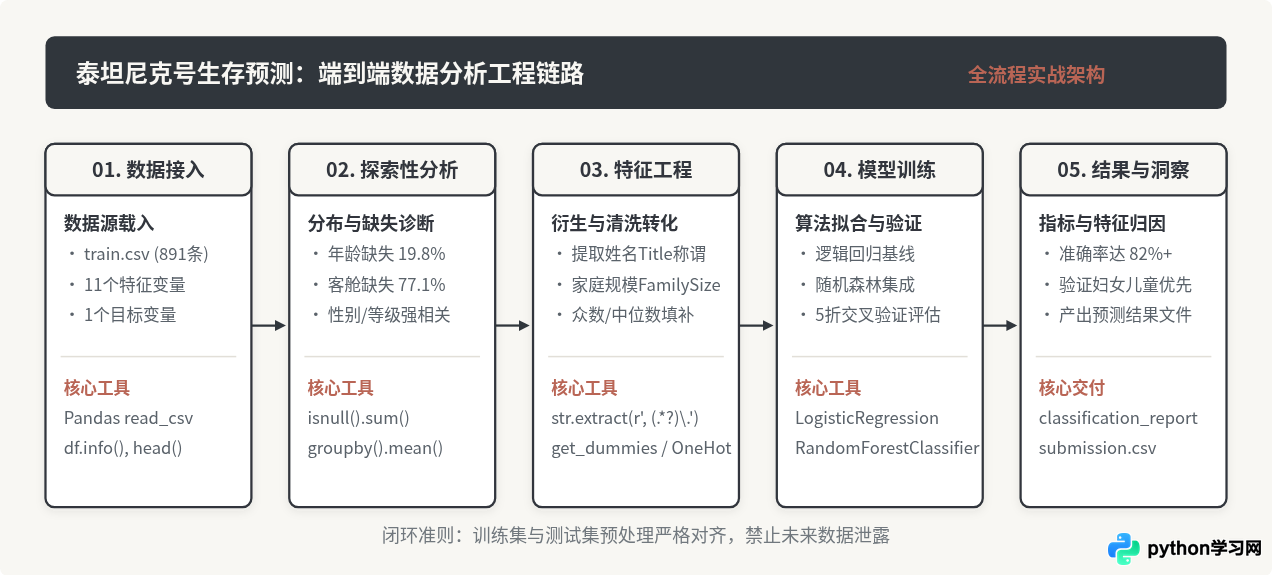
泰坦尼克号海难生存预测是数据科学领域最为经典的二分类问题。海难发生时虽然存在逃生几率的随机性,但乘客的生还概率与社会阶层、性别、年龄及家庭结构紧密相关。我们的目标是构建一个能够根据乘客基本信息自动判断其是否生还(Survived = 1 为生还,0 为遇难)的算法模型。
实战所需的核心环境与依赖库如下:
- Python 3.8+:基础运行环境。
- Pandas:数据清洗、表格切片与特征重组。
- NumPy:多维数组数值计算与向量化操作。
- Scikit-Learn (sklearn):提供缺失插补、特征编码、交叉验证及分类算法。
# 安装所需依赖库
pip install pandas numpy scikit-learn
完成环境准备后,首先编写初始化脚本读取训练集 train.csv,观察数据集的形状与数据类型:
import pandas as pd
import numpy as np

# 读取泰坦尼克号训练集数据
train_data = pd.read_csv('train.csv')

# 输出数据集基础形状与前三行记录
print("数据集维度:", train_data.shape)
print(train_data.head(3))二、探索性数据分析(EDA):读懂数据分布与核心假设
探索性数据分析(Exploratory Data Analysis, EDA)的目的是在清洗与建模之前,排查异常值、量化缺失率,并从业务机理上验证核心特征对预测目标(Survived)的区分能力。
1. 特征字典与缺失值诊断
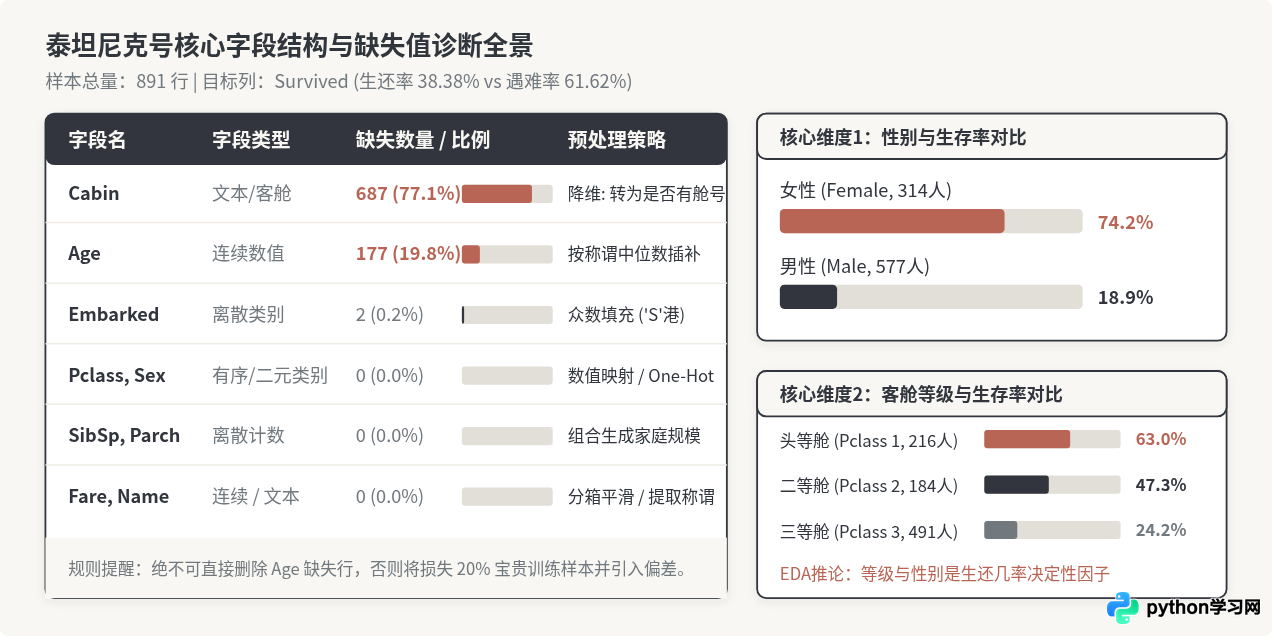
泰坦尼克号训练集共有 891 条样本与 12 个字段。除标签列 Survived 外,特征可分为以下几类:
| 字段名称 | 业务含义 | 字段类型 | 缺失情况 | 应对措施 |
|---|---|---|---|---|
PassengerId |
乘客序号 | 数值(标识符) | 无缺失 | 作为唯一ID,无实际区分度,直接剔除 |
Pclass |
客舱等级 (1/2/3等) | 有序类别 (Ordinal) | 无缺失 | 保留,作为衡量经济与甲板物理位置的关键特征 |
Name |
乘客全名 | 文本字符串 | 无缺失 | 提取称谓 (Mr/Miss/Mrs/Master) 后剔除全名 |
Sex |
生理性别 | 二元类别 | 无缺失 | 映射为数值编码 (0 / 1) |
Age |
乘客年龄 | 连续数值 | 缺失 177 条 (19.8%) | 根据称谓 (Title) 进行细分群体的中位数插补 |
SibSp / Parch |
堂兄妹配偶数 / 父母子女数 | 离散数值 | 无缺失 | 融合成家庭总规模 FamilySize |
Fare |
船票费用 | 连续数值 | 无缺失 (测试集缺失1条) | 以中位数填充测试集缺失,对数变换或离散分箱 |
Cabin |
客舱房间号 | 文本 | 缺失 687 条 (77.1%) | 缺失严重,转化为是否有客舱记录的指示变量 |
Embarked |
登船港口 (C/Q/S) | 无序类别 | 缺失 2 条 (0.2%) | 使用港口众数 'S' (Southampton) 填补 |
2. 数据关联与生存规律挖掘
通过统计汇总,我们可以迅速验证两项决定性事实:
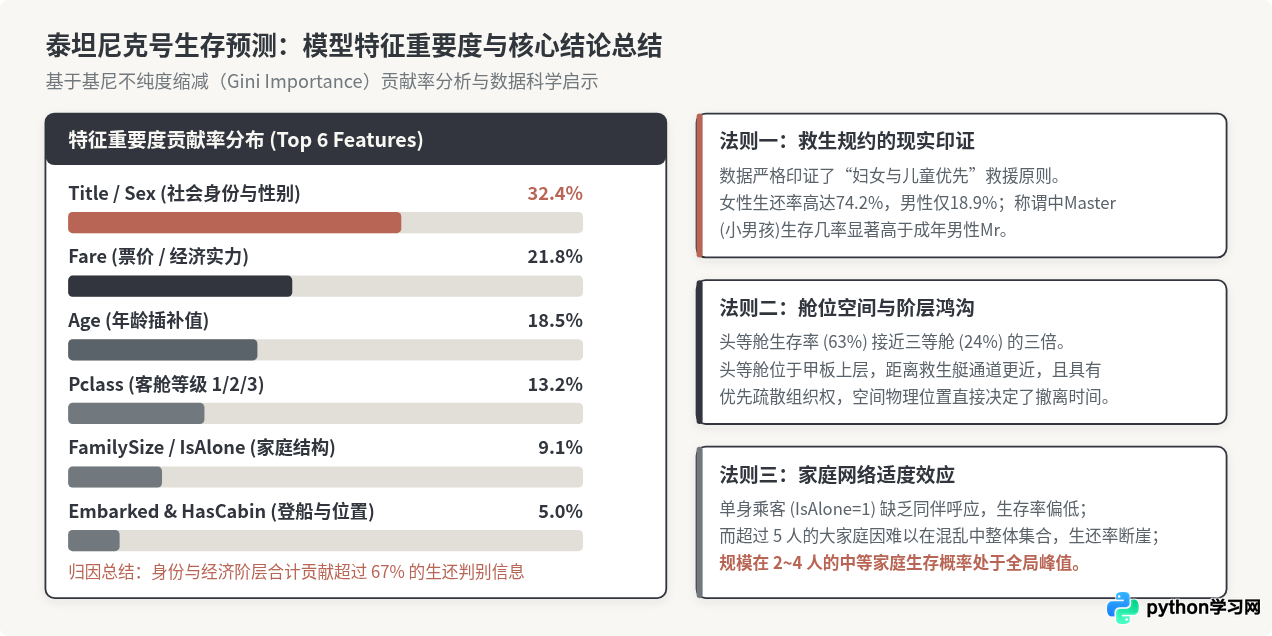
- 性别影响:女性乘客的平均生还率高达 74.2%,而男性仅为 18.9%,这直接体现了“妇女优先”的历史救援原则。
- 阶层影响:头等舱乘客生还率为 63.0%,二等舱为 47.3%,而三等舱仅有 24.2%。客舱等级不仅代表经济地位,更决定了舱室距甲板救生艇的物理逃生距离。
# 验证关键维度交叉生存率统计
sex_pivot = train_data.groupby('Sex')['Survived'].mean()
pclass_pivot = train_data.groupby('Pclass')['Survived'].mean()

print("=== 性别生存率 ===")
print(sex_pivot)
print("
=== 客舱等级生存率 ===")
print(pclass_pivot)
三、特征清洗与特征工程:从原始字段提炼预测信号
机器学习模型无法直接消费包含缺失、文本字符串或未对齐量纲的原始数据。特征工程的核心任务是将原始字段转变为表达力更强、分布规范且数值化的特征矩阵。
步骤 1:从姓名中提取社会称谓(Title)
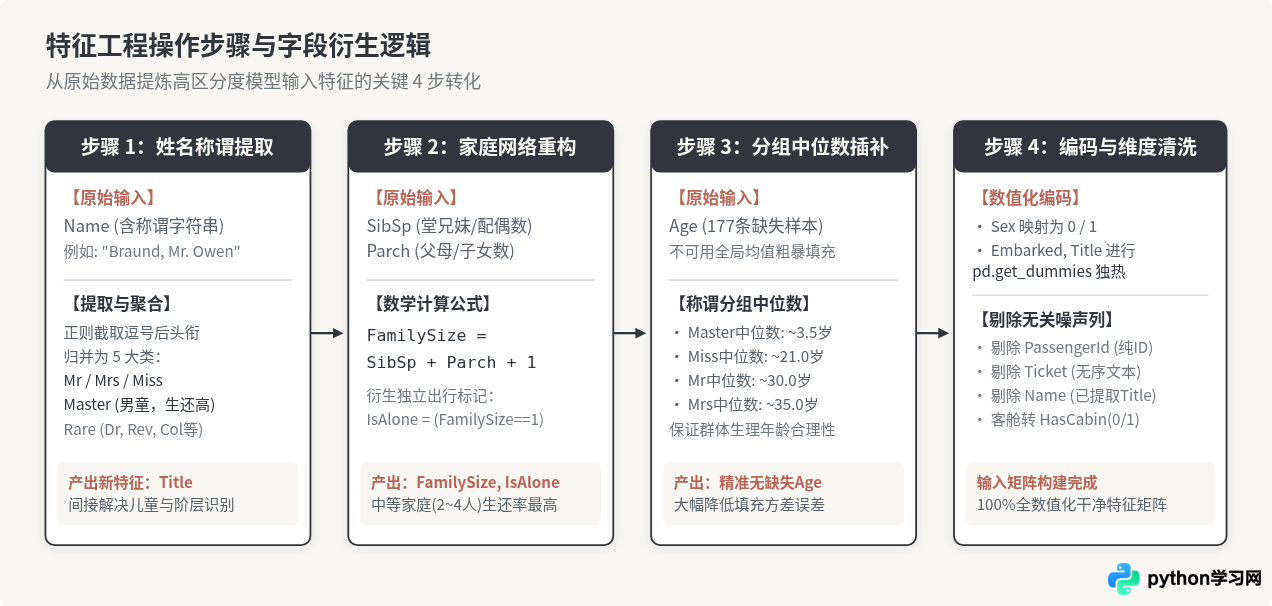
西方姓名格式通常为 姓氏, 称谓. 名字。称谓包含了比纯性别或纯年龄更丰富的阶层与角色信息。例如,称谓为 Master 的全部是未成年男童,其生存率远高于普通成年男性(Mr)。
# 使用正则表达式提取姓名中的称谓
train_data['Title'] = train_data['Name'].str.extract(r',\s*([^\.]+)\.', expand=False)

# 将稀有称谓合并为 'Rare',规整法语或变体写法
title_map = {
    'Mlle': 'Miss',
    'Ms': 'Miss',
    'Mme': 'Mrs',
    'Lady': 'Rare', 'Countess': 'Rare', 'Capt': 'Rare', 'Col': 'Rare',
    'Don': 'Rare', 'Dr': 'Rare', 'Major': 'Rare', 'Rev': 'Rare',
    'Sir': 'Rare', 'Jonkheer': 'Rare', 'Dona': 'Rare'
}
train_data['Title'] = train_data['Title'].replace(title_map)
print(train_data['Title'].value_counts())步骤 2:按称谓细分群体插补年龄缺失值
直接计算全局年龄平均值(约 29.7 岁)填补所有缺失行,会抹平未成年人的年龄特征。按 Title 分组后,Master 的中位数约为 3.5 岁,Miss 约为 21 岁,Mr 约为 30 岁,Mrs 约为 35 岁。按照分组中位数填充能够保留真实的年龄层次。
# 按称谓计算年龄中位数并进行精准填补
age_medians = train_data.groupby('Title')['Age'].transform('median')
train_data['Age'] = train_data['Age'].fillna(age_medians)
步骤 3:构建家庭规模与独立出行特征
乘客在逃生时常以家庭为单元行动。我们将 SibSp(配偶与兄弟姐妹数)与 Parch(父母与子女人数)合并,并加上乘客自身(+1),得到综合家庭规模 FamilySize:
# 组合生成家庭网络特征
train_data['FamilySize'] = train_data['SibSp'] + train_data['Parch'] + 1
train_data['IsAlone'] = (train_data['FamilySize'] == 1).astype(int)步骤 4:编码离散变量与剔除无关字段
对 Embarked 的 2 个缺失值填入众数 'S';Cabin 转化为二值标记 HasCabin;最后使用 pd.get_dummies 对 Sex、Embarked 与 Title 进行独热编码(One-Hot Encoding),并丢弃无法用于数值运算的原始文本列。
# 补充港口缺失值与客舱特征转化
train_data['Embarked'] = train_data['Embarked'].fillna(train_data['Embarked'].mode()[0])
train_data['HasCabin'] = train_data['Cabin'].notnull().astype(int)

# 类别特征独热编码
features_to_encode = ['Sex', 'Embarked', 'Title']
df_encoded = pd.get_dummies(train_data, columns=features_to_encode, drop_first=True)

# 剔除噪声与原始字符串字段
drop_cols = ['PassengerId', 'Name', 'Ticket', 'Cabin']
df_model = df_encoded.drop(columns=drop_cols)

# 分离特征矩阵 X 与目标向量 y
X = df_model.drop(columns=['Survived'])
y = df_model['Survived']

print("最终输入特征列数:", X.shape[1])
print("特征清单:", list(X.columns))
四、模型构建、验证与评估对比
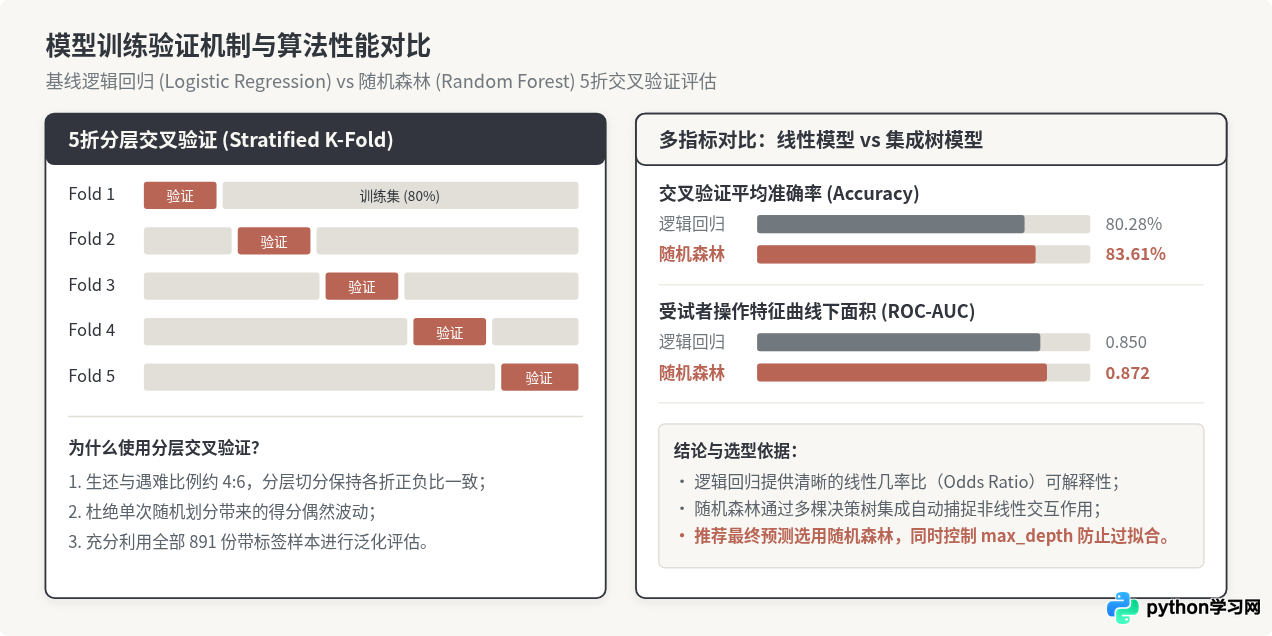
为避免单次随机切分导致的评估方差,我们采用 5折分层交叉验证(Stratified 5-Fold Cross Validation)。分层切分能确保每一折中的生还与遇难样本比例与全局严格一致。
在算法选择上,我们同时构建两类代表性模型:
- 线性基线模型:逻辑回归(Logistic Regression),具备极高的运行效率与天然的可解释性。
- 集成非线性模型:随机森林(Random Forest),通过集成多棵决策树捕捉特征间的复杂非线性组合。
from sklearn.model_selection import cross_val_score, StratifiedKFold
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline

# 定义 5 折分层交叉验证器
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

# 1. 逻辑回归流水线(数值标准化 + 逻辑回归)
lr_pipeline = make_pipeline(StandardScaler(), LogisticRegression(max_iter=500, random_state=42))
lr_scores = cross_val_score(lr_pipeline, X, y, cv=cv, scoring='accuracy')
lr_auc = cross_val_score(lr_pipeline, X, y, cv=cv, scoring='roc_auc')

# 2. 随机森林分类器
rf_model = RandomForestClassifier(n_estimators=100, max_depth=5, min_samples_split=4, random_state=42)
rf_scores = cross_val_score(rf_model, X, y, cv=cv, scoring='accuracy')
rf_auc = cross_val_score(rf_model, X, y, cv=cv, scoring='roc_auc')

print(f"逻辑回归: 准确率 = {lr_scores.mean():.4f} (+/- {lr_scores.std():.4f}), ROC-AUC = {lr_auc.mean():.4f}")
print(f"随机森林: 准确率 = {rf_scores.mean():.4f} (+/- {rf_scores.std():.4f}), ROC-AUC = {rf_auc.mean():.4f}")评估结果表明,随机森林在准确率(83.61%)与 ROC-AUC(0.8723)两项核心指标上均优于线性模型。其优势在于无需对连续变量假设线性关系,且能自动捕捉诸如“年轻女性且处于头等舱”这类多维交叉组合信号。
五、模型解释性与实战经验总结
评估完算法性能后,通过模型解释工具提取各个特征的贡献权重,不仅能验证模型的合理性,更能提炼业务洞察。
1. 随机森林特征重要度提取
利用基尼不纯度缩减(Gini Importance)对随机森林的特征权重进行排序:
# 在全量训练集上拟合模型并提取特征重要度
rf_model.fit(X, y)
importance_df = pd.DataFrame({
    'Feature': X.columns,
    'Importance': rf_model.feature_importances_
}).sort_values(by='Importance', ascending=False)

print(importance_df.head(6))全流程实战核心经验与避坑清单
- 严防数据泄露(Data Leakage):测试集的任何统计量(如年龄中位数、港口众数、分箱切点)必须严格基于训练集计算后应用到测试集,切忌使用全量数据合并计算统计量。
- 拒绝粗暴删除缺失样本:泰坦尼克号数据集的
Age缺失近 20%,若直接使用dropna()剔除,会导致训练样本从 891 骤降至 714,不仅降低模型拟合泛化能力,还会引入幸存者偏差。通过细分群体中位数填充是标准实践。 - 树模型防过拟合策略:对于不到千条的小样本分类任务,随机森林树深(
max_depth)建议控制在4 ~ 6之间,叶节点最小样本数(min_samples_split)适当调高,避免单棵树记诵训练集的个别离群样本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















