


Python编程语言主要用来做什么
全面解析Python编程语言的核心应用场景,涵盖自动化运维与办公、数据分析与计算、人工智能研发及Web后端开发,辅以完整代码示例、架构图解与选型边界分析。
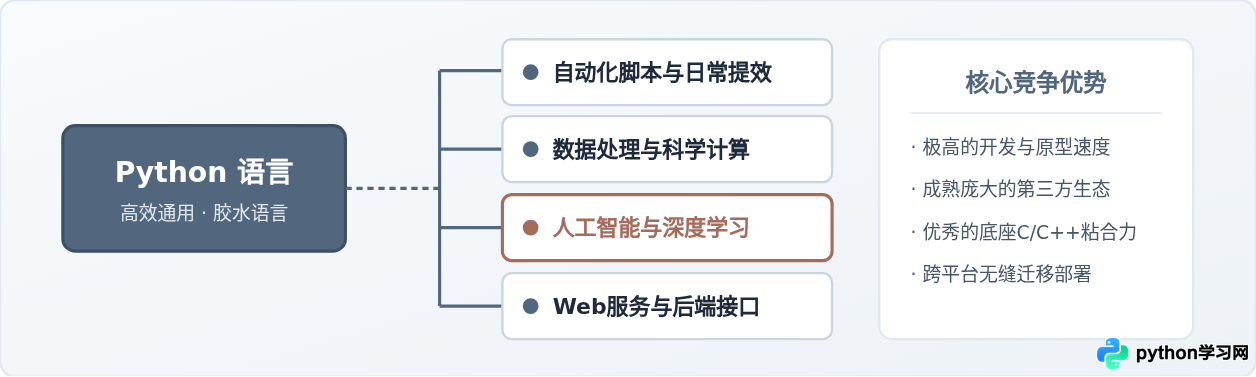
一、自动化脚本与日常提效:最接地气的“数字瑞士军刀”
许多初学者或非计算机专业人员接触 Python,往往始于解决繁琐的机械性劳动。Python 的语法接近自然英语伪代码,标准库本身就内置了文件操作、网络请求、格式转换和时间处理工具,这让它成为了自动化领域的首选工具。
在日常工作中,Python 主要用于以下具体场景:
- 本地文件与目录自动化:跨文件夹批量重命名、正则匹配解压日志、按规则将成千上万个离散文件按时间或类别归档。
- 跨格式文档数据提取与合并:借助
openpyxl、python-docx和pypdf等模块,自动读取散落在数百张 Excel 或 PDF 中的特定字段,汇总生成统一标准报表。 - 网络数据采集(爬虫):通过
requests结合BeautifulSoup或playwright,定期抓取行业公开价格、监控网站状态并自动落盘为 CSV 或写入数据库。 - 运维监控与接口巡检:定时调用第三方 REST API,巡检服务健康状态,在触发特定异常指标时自动通过企业微信或邮件机器人发送报警通知。
为了直观理解这种提效方式,下面是一个用于日常批量处理日志或文件的完整示例:扫描指定目录下所有文本文件,提取其中包含特定错误关键词的记录,并汇总输出为标准化统计结果。
# 自动化处理脚本示例:扫描并汇总目录日志
import os
import re
from datetime import datetime

def summarize_error_logs(log_dir, output_summary_path):
    # 匹配时间戳与ERROR级别日志的正则模式
    pattern = re.compile(r"^(\d{4}-\d{2}-\d{2}\s\d{2}:\d{2}:\d{2})\s+\[ERROR\]\s+(.*)$")
    total_scanned = 0
    extracted_errors = []

    if not os.path.exists(log_dir):
        print(f"指定的目录不存在: {log_dir}")
        return

    # 遍历目标目录
    for root, _, files in os.walk(log_dir):
        for file in files:
            if file.endswith(".log"):
                total_scanned += 1
                full_path = os.path.join(root, file)
                with open(full_path, "r", encoding="utf-8", errors="ignore") as f:
                    for line_no, line in enumerate(f, start=1):
                        match = pattern.match(line.strip())
                        if match:
                            extracted_errors.append(f"{file}:{line_no} | {match.group(1)} | {match.group(2)}")

    # 将提取结果写入汇总文件
    with open(output_summary_path, "w", encoding="utf-8") as out:
        out.write(f"# 日志汇总报告(生成时间: {datetime.now()})\n")
        out.write(f"# 扫描日志文件数: {total_scanned},捕获错误条目数: {len(extracted_errors)}\n\n")
        out.write("\n".join(extracted_errors))

    print(f"处理完成:扫描 {total_scanned} 个日志,捕获 {len(extracted_errors)} 个错误,输出至 {output_summary_path}")

# 执行自动化汇总(示例调用)
if __name__ == "__main__":
    summarize_error_logs(log_dir="./system_logs", output_summary_path="./error_summary.txt")
二、数据分析与科学计算:现代数据栈的通用中枢
如果说自动化是工具属性,那么数据分析则是 Python 奠定现代技术地位的核心领域之一。在 Python 流行之前,数据处理主要依赖专有的统计商业软件(如 SAS、SPSS)或特定语言(如 R、MATLAB)。Python 凭借开源生态打破了这一壁垒,形成了以 NumPy、Pandas、SciPy 为基础的庞大技术栈。
在数据方向,Python 的典型工作并不是单纯写复杂的算法底层,而是构建端到端的数据加工链:
- 数据清洗与特征工程(Pandas):加载混乱的原始业务数据,过滤空值、填补缺失值、进行时间序列聚合、透视与多表关联(Join)。
- 高性能数值与矩阵运算(NumPy):利用底层的 C/Fortran 向量化加速,高效处理数千万规模的多维数组计算,避免纯 Python 循环的性能损耗。
- 数据可视化与探索性分析(Matplotlib / Seaborn):绘制多维分布图、箱线图、热力图,为商业决策提供直观的证据链支撑。
三、人工智能与深度学习:现代算法工程的事实标准
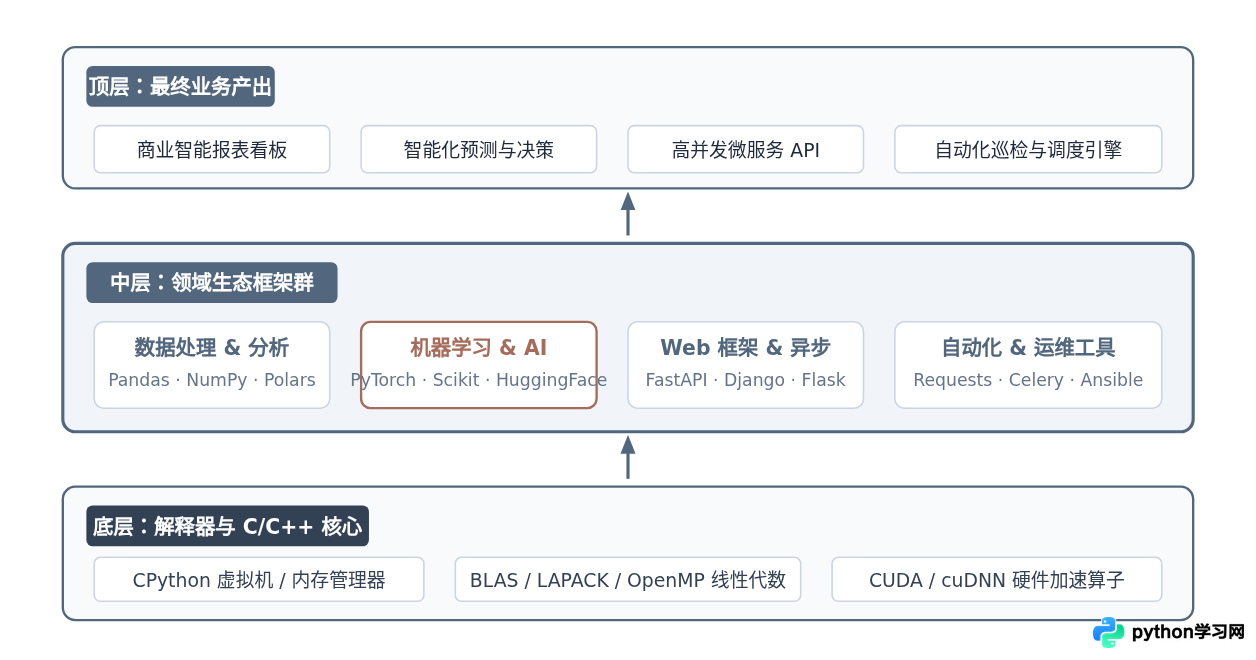
在人工智能领域,Python 目前处于不可替代的事实垄断地位。从学术论文的前沿模型开源,到工业界的模型微调与部署管线,绝大多数 AI 框架均将 Python 作为第一优先级的交互语言。
读者可能会好奇:既然 Python 运行效率远逊于 C++,为什么计算密集的人工智能会以 Python 为核心?
核心原因在于“关注点分离”:深度学习的瓶颈在于海量矩阵的浮点运算,这些耗时操作完全通过 C++、CUDA 或 Triton 预编译为高性能算子下发给 GPU/TPU 执行;而研究员与工程师需要的是能够快速试错、表达拓扑网络、调整超参数并做数据流转的高级语言。Python 极低的学习成本与动态解释特性,完美契合了这一阶段的研发节奏。
在 AI 领域,Python 承担的具体工作包括:
- 模型构建与训练调试:使用
PyTorch或TensorFlow构建神经网络结构,编写自定义损失函数与训练循环。 - 大语言模型(LLM)生态构建:基于
Hugging Face Transformers加载预训练权重,利用LangChain或LlamaIndex搭建检索增强生成(RAG)管道与 Agent 智能体。 - 模型轻量化与推理前置处理:对文本 Token 化(Tokenization)、图像裁剪与像素归一化,并在导出为 ONNX 或 TensorRT 引擎前完成逻辑验证。
四、Web 后端与服务接口开发:敏捷交付的核心支柱
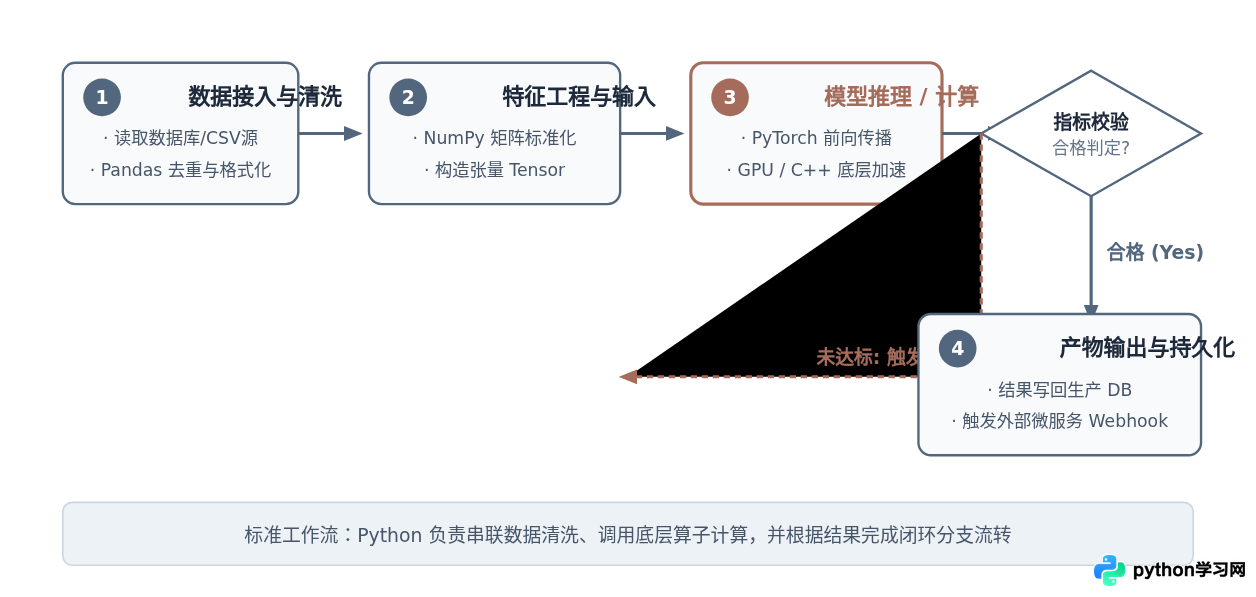
在互联网服务开发中,Python 并不主打高并发微秒级网关,但在中大型企业的中台系统、初创产品的最小可行性验证(MVP)以及现代 RESTful/GraphQL API 服务中占据重要位置。
常见的 Web 框架形成了明确的分工:
- FastAPI:近年来增长最快的新一代框架。基于 Python 3.6+ 的类型提示(Type Hints)与
asyncio异步机制,自带自动化 Swagger 文档生成,性能优异,常用于微服务接口和 AI 模型服务暴露。 - Django:典型的“开箱即用”全功能框架。内置强大的 ORM、身份认证、表单验证与管理后台,适合在短时间内搭建结构规范的企业级信息管理系统。
- Flask:轻量级微框架。核心精简,插件生态自由度极高,适合轻量级工具或不需要重型体系的单体小应用。
以下展示一个使用 FastAPI 快速提供结构化数据查询接口的代码示例。注意其中的类型提示与异步语法:
# Web API 开发示例:基于 FastAPI 的数据查询微服务
from fastapi import FastAPI, HTTPException, Query
from pydantic import BaseModel
from typing import Optional, List

app = FastAPI(title="数据指标服务", version="1.0.0")

# 定义返回的数据模型(自动校验与生成文档)
class MetricItem(BaseModel):
    id: int
    dimension: str
    score: float
    is_active: bool

# 模拟数据库源
DATABASE = [
    {"id": 1, "dimension": "性能指标", "score": 98.5, "is_active": True},
    {"id": 2, "dimension": "安全合规", "score": 92.0, "is_active": True},
    {"id": 3, "dimension": "资源消耗", "score": 75.3, "is_active": False},
]

@app.get("/api/v1/metrics", response_model=List[MetricItem])
async def list_metrics(
    min_score: float = Query(default=0.0, ge=0.0, le=100.0, description="最低评分筛选"),
    active_only: bool = Query(default=True, description="是否仅返回激活指标")
):
    """
    根据给定的阈值与状态筛选业务指标
    """
    results = [
        item for item in DATABASE
        if item["score"] >= min_score and (not active_only or item["is_active"])
    ]
    return results

@app.get("/api/v1/metrics/{metric_id}", response_model=MetricItem)
async def get_metric_detail(metric_id: int):
    for item in DATABASE:
        if item["id"] == metric_id:
            return item
    raise HTTPException(status_code=404, detail=f"ID 为 {metric_id} 的指标未找到")

# 启动命令:uvicorn main:app --host 0.0.0.0 --port 8000 --reload
五、Python 并非万能:明确它的能力边界与不适用场景
评价一门编程语言,不仅要看它能做什么,更要清晰界定它不适合做什么。如果忽视限制条件盲目使用 Python,往往会导致工程项目在后期遭遇性能瓶颈或维护灾难。
具体而言,以下场景通常不建议将 Python 作为主力语言:
- 高频交易与微秒级低延迟系统:金融撮合系统、核心网络交换机等场景对延迟抖动(Jitter)和垃圾回收(GC)暂停极其敏感,属于 C++、Rust 的绝对领域。
- 移动端 App 原生开发:在 iOS(Swift/Objective-C)与 Android(Kotlin/Java)系统上,虽然有 Kivy、BeeWare 等尝试,但无论在包体积、渲染帧率还是系统原生 API 贴合度上,均无法与原生或 Flutter/React Native 抗衡。
- 浏览器端直接运行:尽管 WebAssembly 带来 Pyodide 等方案,但下载数百兆解释器运行时的成本远高于原生 JavaScript/TypeScript,难以作为通用前端技术方案。
- 单机超高吞吐网络代理与网关:类似 Nginx、Envoy、Traefik 这一类底层代理服务,通常依赖 Go 或 C++ 的内存与协程调度机制,Python 在此类极低开销纯网络包转发中并不占优。
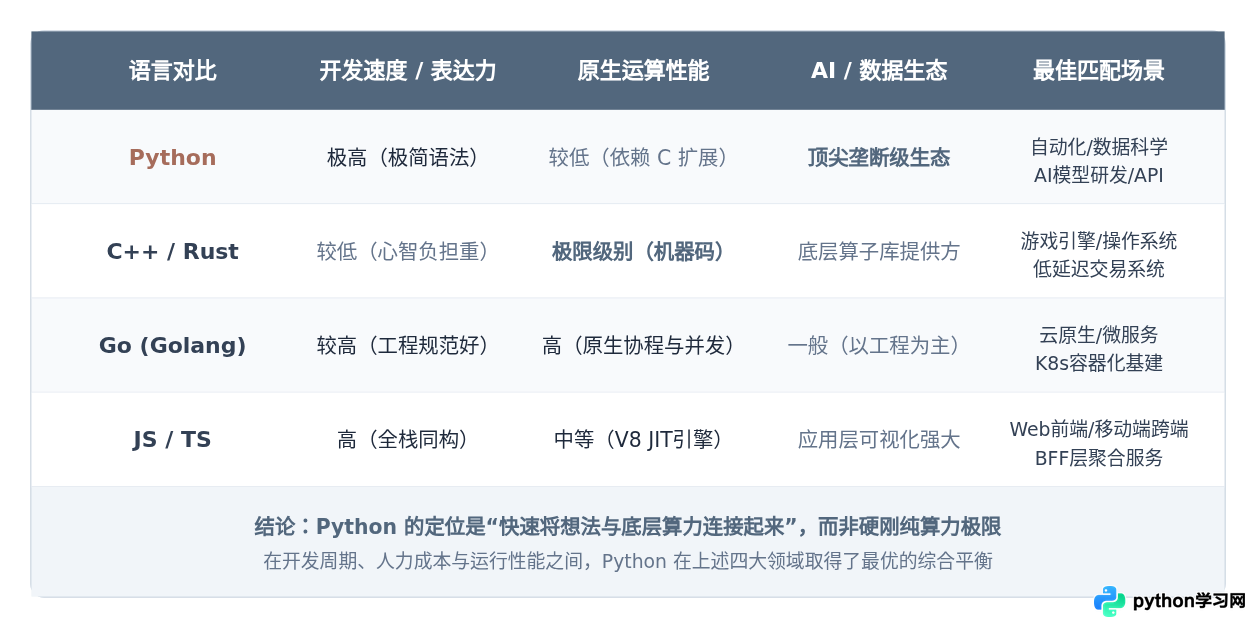
六、如何判断是否应该选择 Python:技术选型决策路径
在面对一个实际工程或业务需求时,判断是否采用 Python 可以遵循一条清晰的推导链路:从任务性质、性能阈值与团队资源三个维度进行综合权衡。
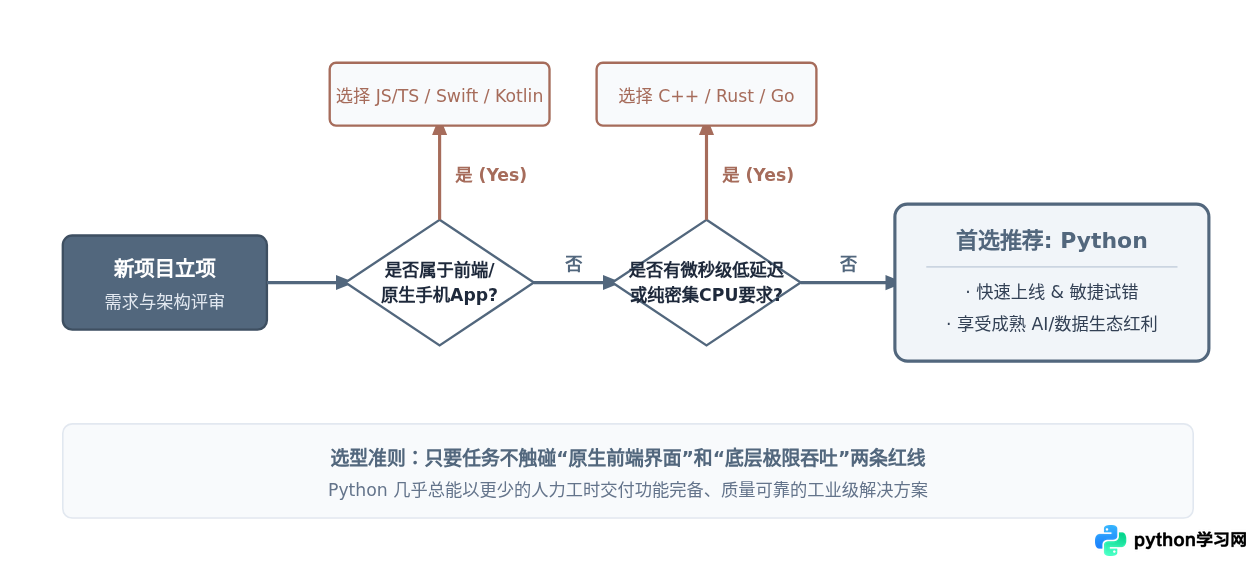
综上所述,回答“Python编程语言主要用来做什么”,核心并不在于列举成百上千个库的名字,而在于理解它在现代软件工程体系中扮演的“高阶调度与敏捷整合中心”角色。从写几十行脚本解放双手,到处理数以亿计的业务报表,再到调度千亿参数的人工智能模型,Python 始终以最低的代码阻力,帮助开发者用最直接的方式将需求转化为生产力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















