


自学Python还是报班?分析不同学习方式对掌握难度的影响
深入对比自学与报班在环境配置、报错排查、知识体系构建与独立项目开发各阶段的掌握难度差异,提供科学的Python学习方式决策与自测指南。
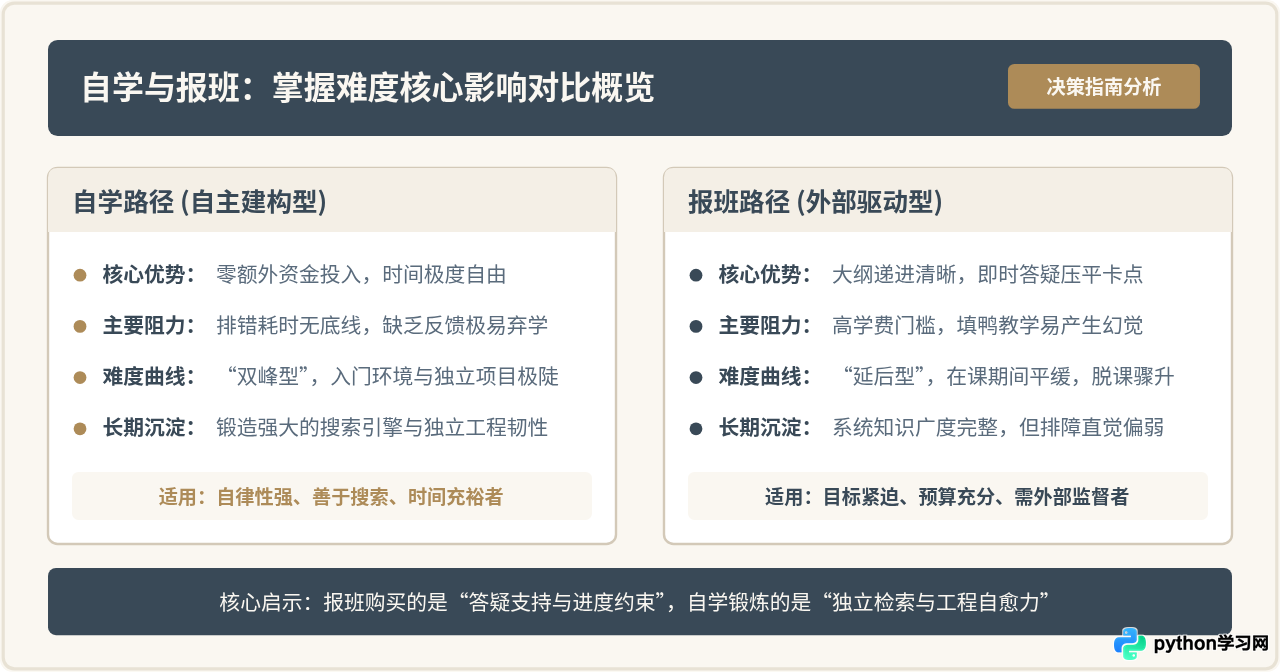
学习Python的掌握难度并不取决于语言本身的语法复杂度,而取决于在“环境配置、报错排查、知识结构化与工程实践”这四个关键节点上,学习者能否及时获得有效反馈。自学的难度呈“前高后高”的双峰分布,容易在起步报错和独立写项目阶段陷入停滞;报班的难度则被外部进度和答疑机制压平,但如果缺乏主动构建能力,可能在课程结束脱离指导时出现断崖式落差。本文将深入拆解自学与报班在不同认知阶段的具体阻力来源,并提供一套基于个人时间、预算与学习目标的量化评估路径。
一、掌握难度的本质:Python学习中的四道阻力屏障
许多初学者认为,Python由于语法贴近自然语言、没有指针和严格内存管理,学习门槛应当很低。然而在实际学习过程中,无论自学还是报班,学员都会遭遇显著的“掌握难度断层”。这种难度往往不来自语法规则本身,而是来自以下四道关键阻力屏障:
- 环境与工具链屏障:Python解释器版本冲突、pip源超时、虚拟环境隔离(venv / conda)、环境变量PATH配置错误。这类问题与编程逻辑无关,但足以让新手卡在第一步数天。
- 逻辑思维转译屏障:从看懂 `for` 循环和 `if` 分支,到面对一个实际问题时能够自主拆解为数据结构与控制流。这是初学者产生“代码看得懂但自己写不出来”的核心原因。
- 异常诊断与Debug屏障:代码运行报错时,面对长达几十行的回溯信息(Traceback),是否能准确定位触发根因,还是盲目在代码各处胡乱修改。
- 工程化与独立构建屏障:脱离教程既定的单文件脚本,去构建包含模块调用、异常捕获、第三方库集成和日志记录的完整小工具。
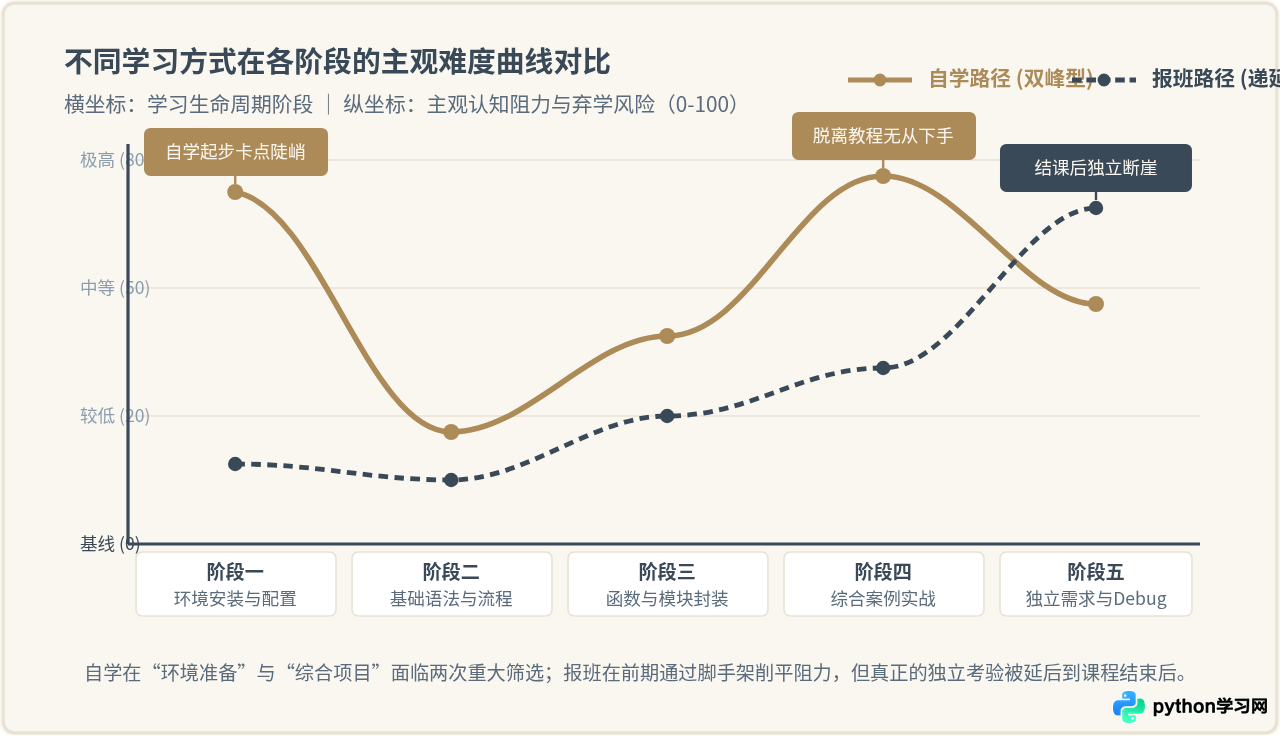
从上图的难度曲线可以看出,自学与报班的区别并非单纯的“简单”与“困难”,而是阻力出现的时间点和性质截然不同。自学将阻力前置,在每一次遭遇报错时强迫学习者建立检索反射;报班则将阻力后置,用现成的集成环境和答疑人员缓冲初期的挫败感,但延后了独立解决问题的基本功锻炼。
二、自学路径分析:高自由度背后的隐性认知负荷
自学Python最大的优势是边际成本极低且时间支配完全自由。现代互联网拥有丰富的官方文档(如 docs.python.org)、高质量开源教程以及活跃的社区问答。然而,正是这种“资源过剩”带来了自学者特有的掌握难度:
1. 缺乏全局地图导致的信息过载
初学者在自学时通常难以判断某项技术在当前阶段的必要性。例如,刚学完基本数据类型,就可能在网络文章中看到装饰器、元类、多进程协程等高级概念,或者在爬虫教程中陷入反爬机制的复杂攻防中。这种“不知道自己不知道什么”的状态,会消耗大量认知带宽,造成盲目探索和进度滞后。
2. 报错调试阶段的时间黑洞
在缺乏指导的情况下,一个微小的拼写错误或依赖版本冲突,常常需要自学者花费几个小时甚至数天排查。以常见的模块导入与环境问题为例:
Traceback (most recent call last):
File "/workspace/script.py", line 2, in <module>
import pandas as pd
ModuleNotFoundError: No module named 'pandas'
经验丰富的开发者一眼能看出这是多版本环境路径没有对齐的问题,只需执行 `python -m pip install pandas` 或激活对应的虚拟环境即可解决。但对自学新手而言,这可能演变成反复卸载重装系统环境的恶性循环。
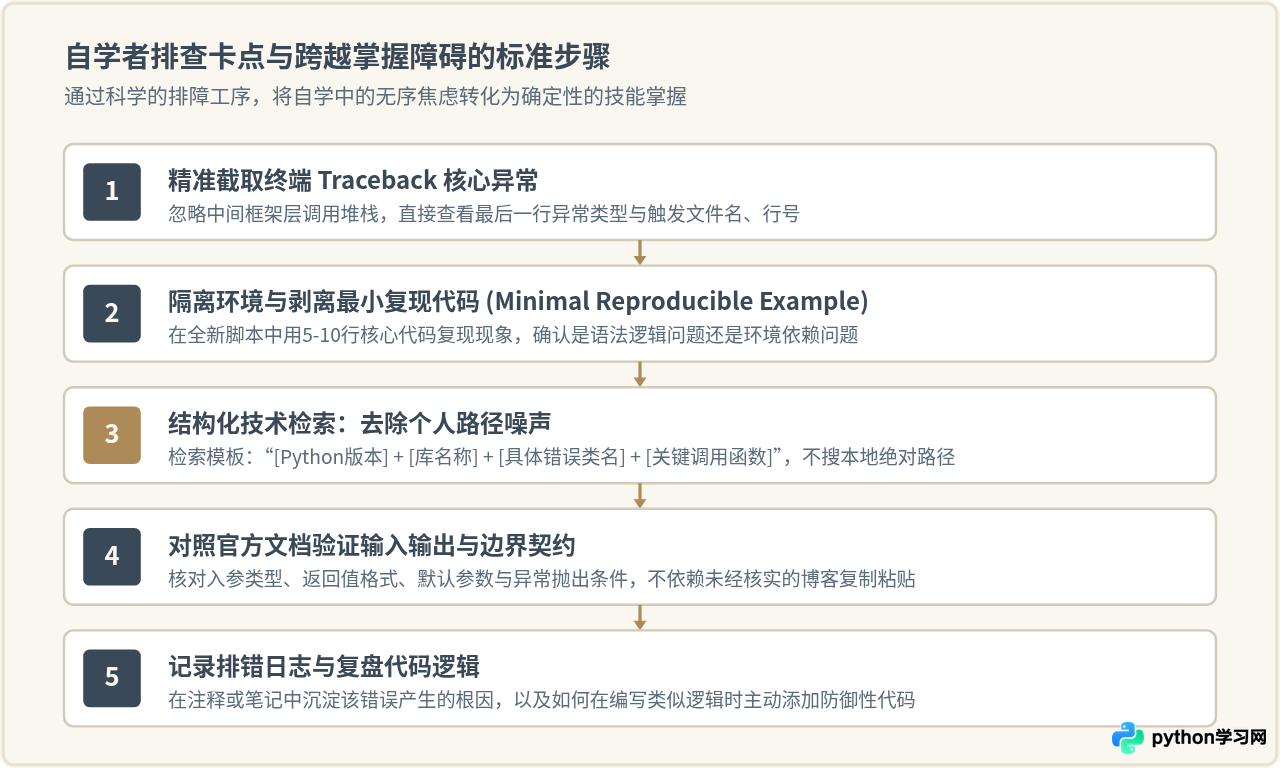
自学能否成功的关键,在于能否在 2 到 3 周内建立标准化的排错方法论。一旦自学者掌握了上述五步法,不再将报错视为“自己的愚钝”而是视为“程序的确定性反馈”,自学的难度指数就会迅速由峰值下降为平稳的上升通道。
三、报班路径分析:付费购买的究竟是知识还是支持系统
很多人报班时的初衷是“老师能讲得更生动、更容易听懂”。但现代编程教育的现实是:任何机构的授课内容,几乎都能在网络上找到同等甚至更高质量的公开资料。学员支付学费购买的真正核心价值,实质上是外部约束系统与即时答疑缓冲带:
- 削平初期报错峰值:机构通常提供经过反复验证的安装包、远程协助或在线容器环境,直接跳过环境配置的深坑;遇到报错时,助教在数分钟内给出修改建议,避免学员在细枝末节上卡壳。
- 提供确定性的递进路径:课程大纲由浅入深,每个阶段配套习题和作业,学员只需按部就班推进,省去了自行搜集与筛选资料的筛选成本。
- 时间节奏与同侪约束:打卡机制、作业截止日期(DDL)以及班级群的学习氛围,显著降低了拖延症带来的中途放弃率。
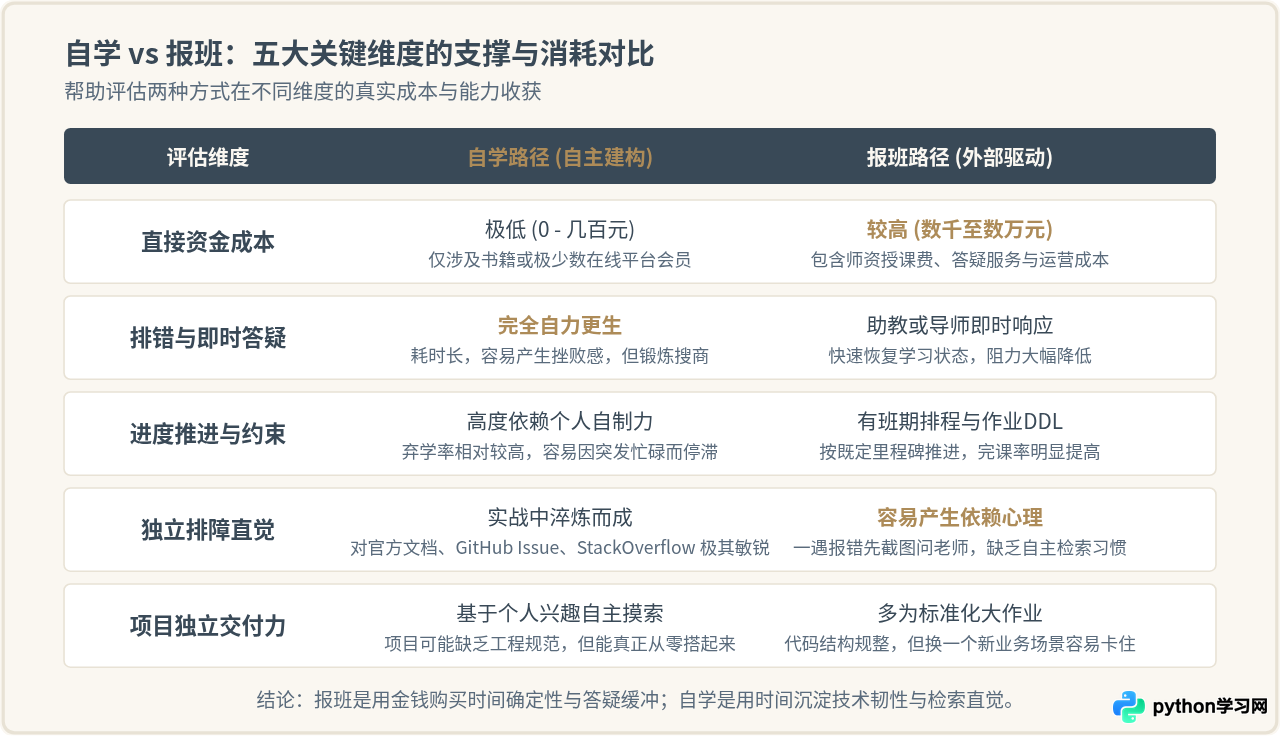
报班容易陷入的“虚假掌握”陷阱
报班虽然降低了初期的心理压力,但它隐藏着一个重大隐患——认知幻觉(Illusion of Competence)。很多学员在课堂上看着讲师行云流水地编写代码,自己也能按模板填空完成作业,便误以为自己已经掌握了Python。然而一旦课程结束,脱离了讲师的代码半成品和助教的即时指导,面对空无一物的编辑器时,往往发现自己连项目目录结构该怎么规划、第三方包该怎么按规范导入都无法独立完成。
四、学习方式决策模型:如何根据自身条件做选择
选择自学还是报班,不应依赖他人的主观推荐,而应基于学习者自身的三个客观维度进行系统匹配:学习目标、时间窗口与信息检索习惯。
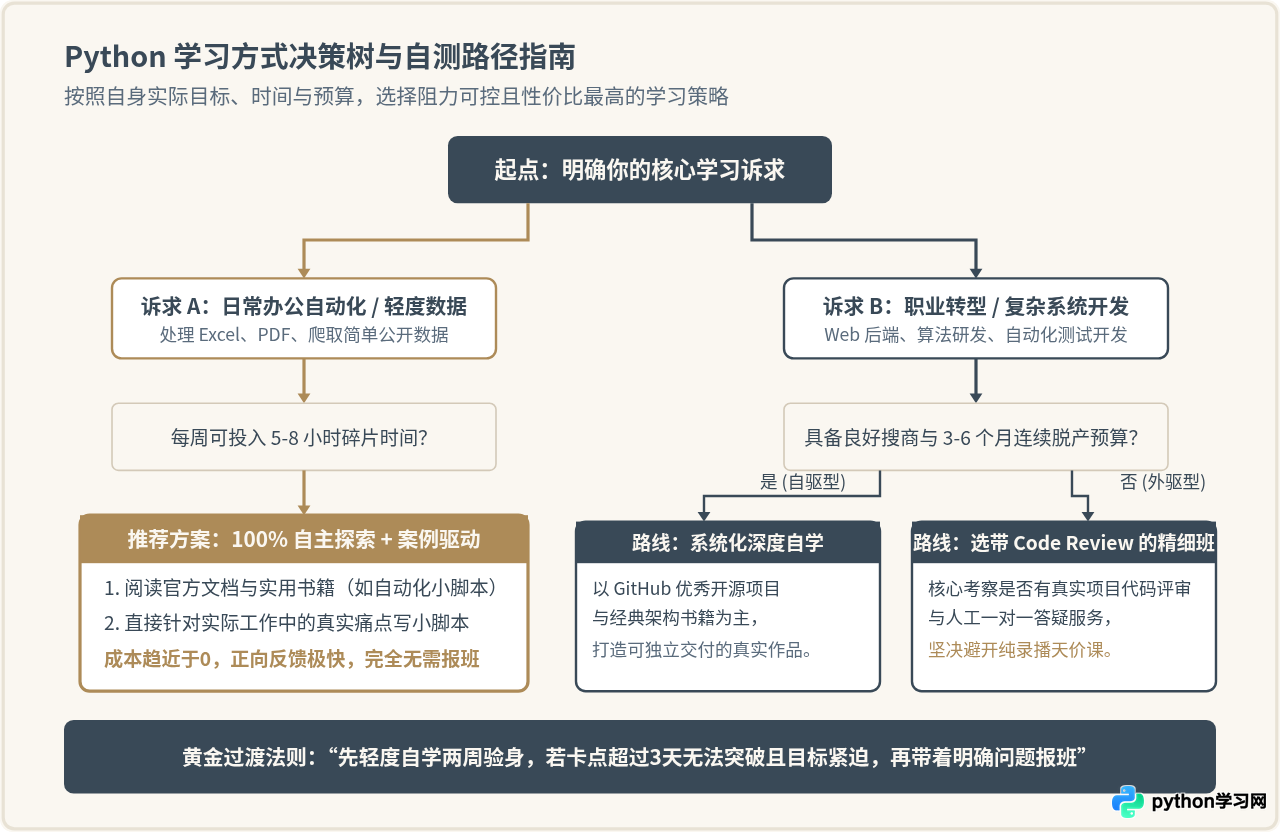
三种典型学习者的决策建议
- 职场增效型(非计算机从业者):目标是自动化处理日报、处理十万行 Excel 数据或简单网络抓取。这类需求逻辑链条短、第三方库极其成熟(如 openpyxl、pandas、requests)。坚决推荐自学。按照实际痛点直接检索写脚本,一两周即可见到成效,报班的理论深度反而会增加冗余负荷。
- 职业转型且自律性强者:有明确的软件工程师就业目标,逻辑清晰,有英语检索能力。建议自学为主,兼听高分公开课。通过完成真实的开源贡献或端到端全栈项目来构建作品集,其排错韧性在技术面试中会形成巨大优势。
- 零基础且目标时间极紧凑者:转行窗口期短(如 3-4 个月内必须拿出成果),面对终端报错极易焦虑且缺乏自我时间管理机制。可选择带有高质量即时答疑与严格作业批改(Code Review)的小班,用资金换取时间,但必须在课后强迫自己独立重构项目,防止陷入“课上会、课下废”的窘境。
五、常见避坑问题与关键检验标准
1. 如何判断培训机构的质量是否能真正降低掌握难度?
判断的核心依据绝不是销售承诺的“保就业”或“名师履历”,而是以下两项硬性服务指标:
- 是否包含逐行人工代码评审(Code Review):好的掌握需要纠正坏习惯。如果机构只看代码跑通与否,不点评变量命名、代码结构和异常处理规范,其教学效果与看免费视频无异。
- 答疑响应机制是直接给答案还是授人以渔:如果助教总是直接发送修改后的代码,学员就失去了经历“看报错-猜根因-验证修改”的心智模型训练机会。
2. 自学者如何检验自己是否“真正掌握”了Python?
检验Python掌握程度的唯一标准不是“背诵了多少语法”或“看了几百个小时的视频”,而是脱离教学素材的独立构建能力。以下三道测试可作为阶段性验收标准:
| 检验阶段 | 独立测试任务要求 | 合格判定标准 |
|---|---|---|
| 基础阶段 | 脱离教程,编写一个能自动遍历指定文件夹、筛选出特定扩展名文件并按修改时间重命名的脚本。 | 不查阅现成脚本模板,仅凭标准库文档在 30 分钟内独立写完并调试通过。 |
| 进阶阶段 | 调用一个带有鉴权机制的公开 REST API,获取数据并持久化到 SQLite 或 CSV 中,处理断网和异常超时。 | 包含完整的 `try...except` 异常捕获与重试机制,代码无硬编码敏感凭据。 |
| 工程阶段 | 从零新建虚拟环境,组织一个包含配置文件、主入口、工具模块与 requirements.txt 的模块化工程。 | 在另一台全新电脑上能够一键拉取依赖并顺利运行,无隐藏路径报错。 |
无论是选择自学还是报班,最终在真实职场中编写代码的始终是学习者自己。把学习方式看作一种根据自身阶段动态调整的“资源配置”,在需要解决具体问题时保持敏锐,在遇到报错卡壳时保持冷静,才是持续掌握任何编程技能的底层保障。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















