


Python定义固定类型数组:array模块使用教程
本教程系统讲解 Python 标准库内置 array 模块的使用方法。从底层连续内存模型对比、常用类型码(Type Code)对照表、数据增删查改与类型安全拦截,到高速二进制文件读写与技术选型决策,全面掌握轻量级同构数组的使用技巧。
假设你需要编写一个数据采集程序,持续从工业传感器、网络套接字或硬件总线中接收上千万条 32 位整型读数。如果习惯性地直接在 Python 中使用标准列表 list 存储,程序占用的常驻内存很快就会飙升至数百兆。这背后的物理原因是:Python 的标准列表本质上是指针数组,其中存储的每个数字都是一个拥有完整对象头的独立 PyObject,由此带来了昂贵的指针解引用与内存开销。
面对这类元素类型严格统一、数据量庞大且对物理内存敏感的场景,Python 标准库内置的 array 模块是最直接、最轻量的原生方案。array 模块通过固定类型码(Type Code)锁定存储类型,直接在底层开辟连续紧凑的 C 语言原生缓冲区,既大幅消除了对象头开销,又原生支持二进制与磁盘文件的快速存取。本文将全面介绍 array 模块的底层机制、类型码定义、基础操作及高效持久化方法。
一、底层原理:为什么 array 比普通 list 更轻量?
在 Python 中,通用列表 list 允许混入任意类型的元素(如整数、浮点数、字符串甚至字典)。为了实现这一灵活性,列表自身只维护一个连续的“指针数组”,每个槽位存放的是指向堆内存中独立 Python 对象的 64 位内存地址。
在典型的 64 位 CPython 解释器中,一个最基础的 int 整数在底层实际上是一个 PyLongObject 结构体。它不仅包含数值本身,还必须附带 8 字节的引用计数(ob_refcnt)、8 字节的类型指针(ob_type)以及 8 字节的长度信息。这意味着,一个原本仅需 4 字节表示的 32 位整数,作为 Python 对象独立存在时至少占用 28 字节;再加上列表指针数组本身为每个元素分配的 8 字节指针,存储一个整数的综合内存开销高达 36 字节以上。
与此相对,array.array 彻底放弃了异构特性,要求所有元素必须是同一 C 语言基本类型。在底层实现上,它仅在对象头部记录一次元数据,底层数据区则是一块单一且纯粹的连续 C 语言原生内存缓冲区(Contiguous Buffer)。当指定类型码为 32 位有符号整数时,数组内部每个元素就严格占用 4 字节,没有任何额外的对象头或引用计数包袱。
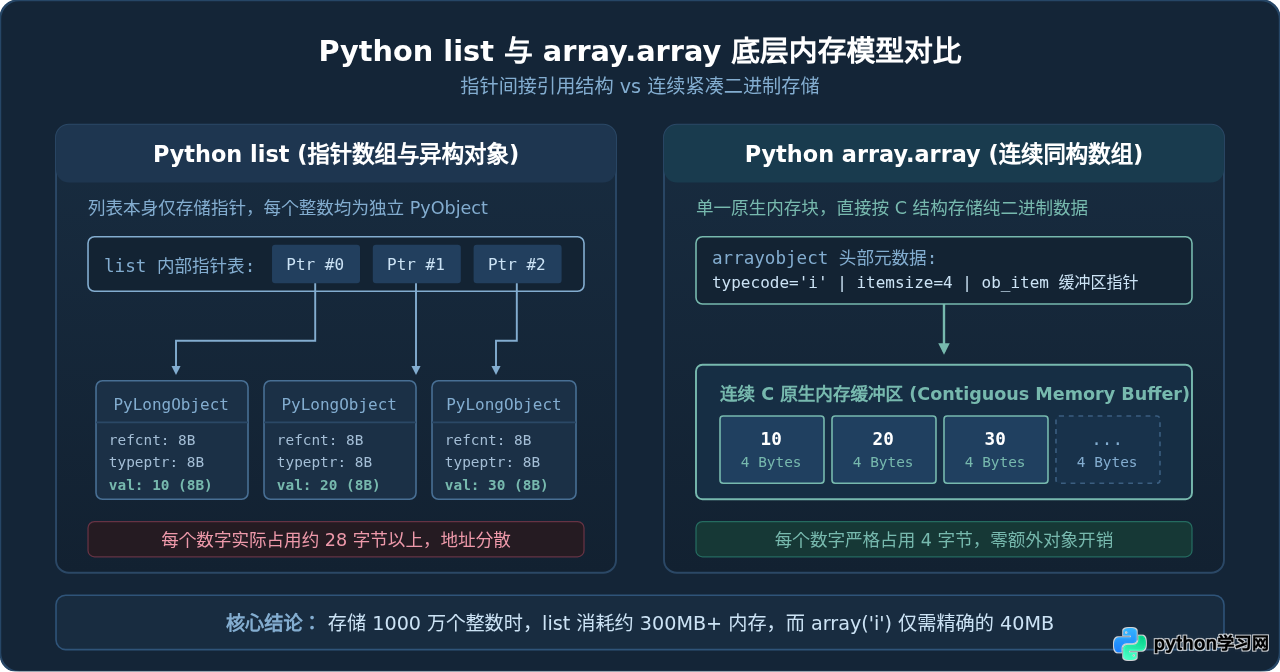
正如上图所示,当存储 1000 万个 32 位整数时:
- 使用标准
list:需要分配约 80MB 的指针表,以及分散在堆上的独立整型对象,总体内存消耗通常在 300MB ~ 360MB 之间,且频繁的指针寻址对 CPU 缓存极为不友好。 - 使用
array('i'):数据严格按10,000,000 × 4 字节顺序排布,占用内存精准稳定在 40MB(加上微小的对象头),节省了近 88% 的内存空间。
二、类型码(Type Code)系统与底层规格定义
在使用 array 模块之前,必须先明确要存放的数据在底层究竟对应哪一种 C 语言原始数据类型。这是通过单个字符表示的类型码(Type Code)来指定的。
创建数组的通用构造语法非常简单:
import array

# 语法形式:array.array(typecode, [initializer])
# 示例:创建包含 32 位有符号整数的固定类型数组
numbers = array.array('i', [10, 20, 30, 40])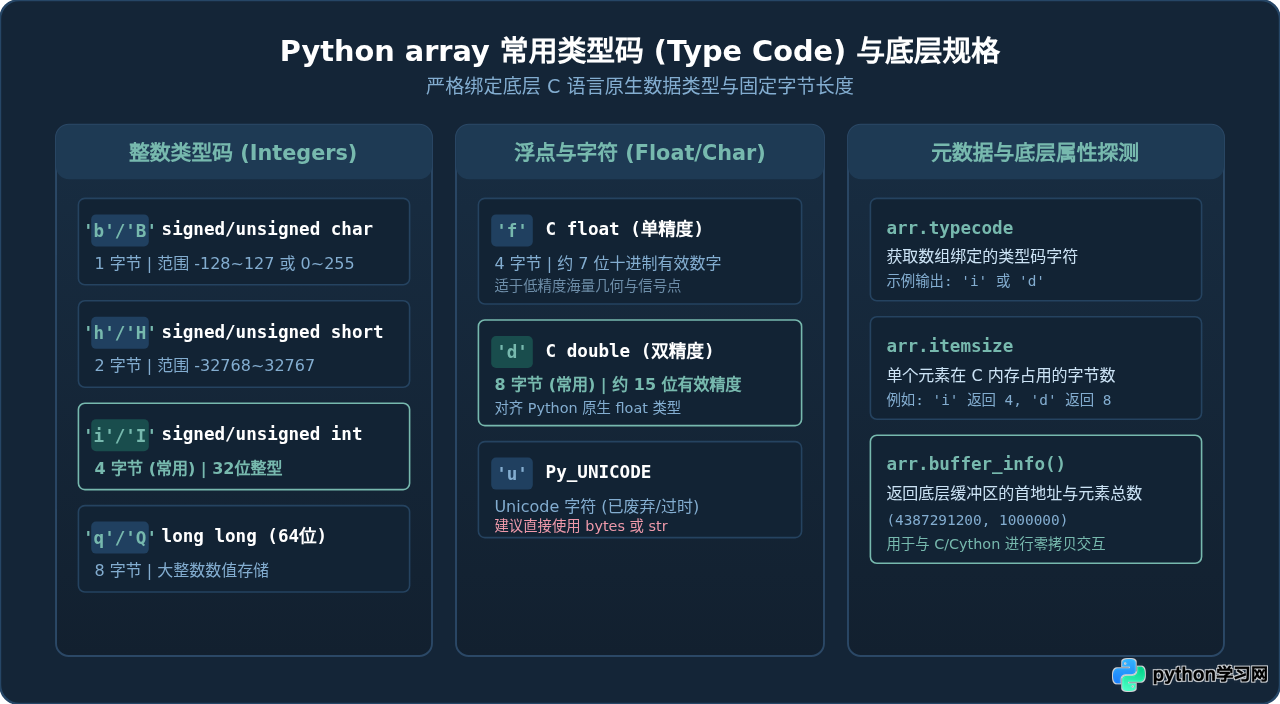
标准库支持的常用类型码及其对应的物理字节与取值范围如下表所示:
| 类型码 | 对应 C 原生类型 | Python 类型 | 最小字节数 | 取值范围与说明 |
|---|---|---|---|---|
'b' |
signed char | int | 1 | -128 至 127,紧凑单字节有符号数 |
'B' |
unsigned char | int | 1 | 0 至 255,常用于处理单字节原始字节流 |
'h' |
signed short | int | 2 | -32,768 至 32,767,16 位短整型 |
'H' |
unsigned short | int | 2 | 0 至 65,535,16 位无符号整型 |
'i' |
signed int | int | 4(主流平台) | -2,147,483,648 至 2,147,483,647,最常用的 32 位整型 |
'I' |
unsigned int | int | 4(主流平台) | 0 至 4,294,967,295,32 位无符号整型 |
'q' |
signed long long | int | 8 | -9,223,372,036,854,775,808 至 9,223,372,036,854,775,807,64 位整型 |
'Q' |
unsigned long long | int | 8 | 0 至 18,446,744,073,709,551,615,64 位无符号数 |
'f' |
float | float | 4 | C 单精度浮点数(约 7 位有效十进制位) |
'd' |
double | float | 8 | C 双精度浮点数(约 15 位有效十进制位,对齐 Python float) |
元数据探针:检查数组底层物理属性
创建 array 实例后,可以通过几个内置属性和方法直接观察其底层的存储细节:
arr.typecode:返回当前数组绑定的类型码字符,如'i'或'd'。arr.itemsize:返回单个元素占用的底层字节数。例如'i'对应4,'d'对应8。arr.buffer_info():返回一个二元组(内存基地址, 元素个数)。该地址可直接供底层的 C/C++ 动态链接库或 Cython 代码进行指针级别的零拷贝访问。
import array

arr = array.array('i', [100, 200, 300])
print("类型码:", arr.typecode)        # 输出: 类型码: i
print("单元素字节:", arr.itemsize)    # 输出: 单元素字节: 4
print("底层缓冲信息:", arr.buffer_info()) # 示例输出: (4382914560, 3)
三、基础操作与严格类型安全拦截
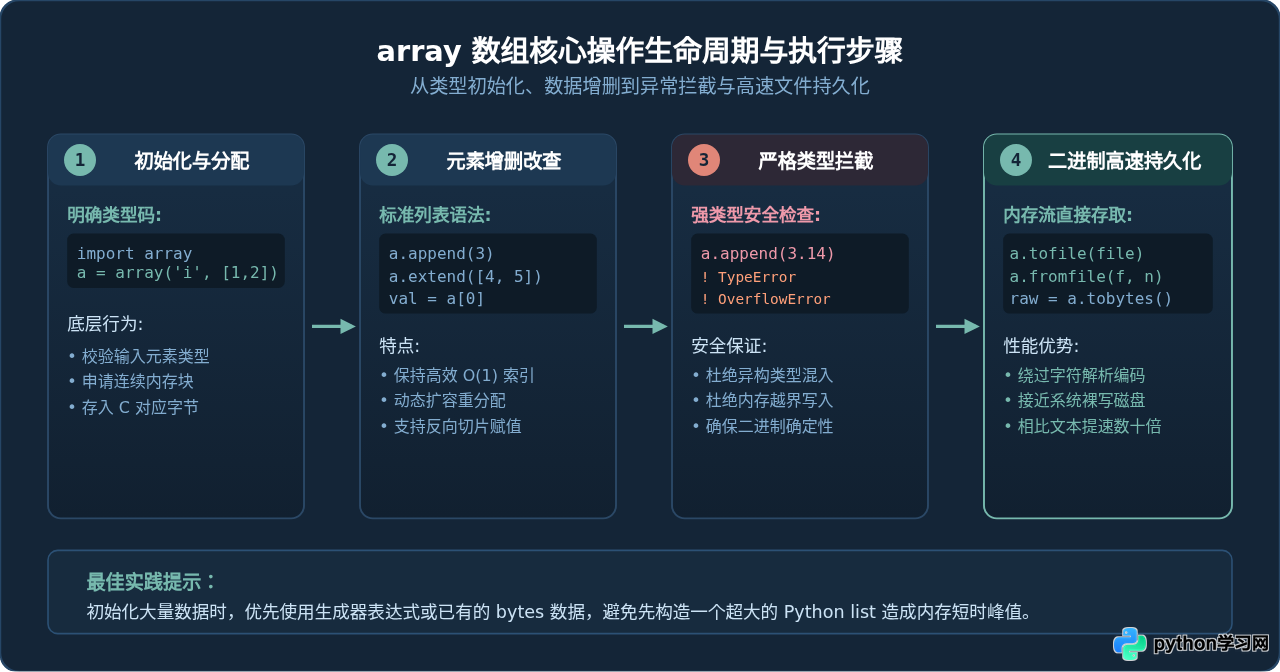
在日常操作接口上,array 表现得与普通 list 非常相似,全面支持下标索引、切片、遍历、append()、extend() 以及 pop() 等方法。但核心差异在于:它在运行时实施严格的类型和边界检查。
1. 常用修改与访问方法
下面的代码演示了数组的日常操作:
from array import array

# 1. 初始化数组(支持传入列表、元组或生成器)
data = array('h', [10, 20, 30])

# 2. 追加单个元素与批量扩展
data.append(40)
data.extend([50, 60])

# 3. 按索引访问与切片
print(data[0])      # 10
print(data[1:4])    # array('h', [20, 30, 40])

# 4. 修改元素与切片替换(替换的数据必须是相同类型的 array)
data[0] = 99
data[1:3] = array('h', [200, 300])

# 5. 查找与移除
data.remove(99)
last_val = data.pop()
print("当前元素总数:", len(data))
2. 运行时类型拦截:TypeError 与 OverflowError
在普通的 Python 列表中,往一个装满整数的列表中追加一个字符串或浮点数是完全合法的。但在 array 中,尝试存入不合规的元素会立即触发异常:
from array import array

arr_int = array('i', [1, 2, 3])

# 场景 A:类型不匹配 -> 抛出 TypeError
try:
    arr_int.append("hello")
except TypeError as e:
    print("类型错误拦截:", e)
    # 输出: 类型错误拦截: 'str' object cannot be interpreted as an integer

# 场景 B:数值溢出 -> 抛出 OverflowError
# 'h' 为 16 位有符号数,最大值为 32767
arr_short = array('h', [100, 200])
try:
    arr_short.append(70000)
except OverflowError as e:
    print("数值越界拦截:", e)
# 输出: 数值越界拦截: signed short integer is greater than maximum四、极速二进制持久化与磁盘读写
array 模块最具生产力优势的特性之一,是它能够直接在连续内存和二进制字节流之间进行无损互转,完全绕过了文本编码/解码或 JSON 解析等耗时的高层抽象。
1. 内存字节转换:tobytes() 与 frombytes()
调用 tobytes() 时,Python 直接将底层 C 连续内存块以原始字节流拷贝输出,速度极快:
from array import array

original = array('i', [10, 20, 30, 40])

# 导出为 bytes 对象(小端序系统上每个数字占 4 个十六进制字节)
raw_bytes = original.tobytes()
print("字节流长度:", len(raw_bytes))  # 输出: 16 (4 元素 * 4 字节)

# 快速从 bytes 重构数组
restored = array('i')
restored.frombytes(raw_bytes)
print("恢复后的数组:", restored)      # array('i', [10, 20, 30, 40])
2. 文件流直接倾倒:tofile() 与 fromfile()
在海量数据存盘时,如果将数字格式化为逗号分隔的文本文件(如 CSV),不仅会产生庞大的字符串转换 CPU 开销,文本文件本身的体积也会膨胀数倍。通过 tofile() 方法,可以直接将内存连续块灌入二进制文件句柄中:
from array import array

# 构造包含 100 万个双精度浮点数的测试数组
# 使用生成器表达式初始化,避免在内存中产生巨大的临时 list
data = array('d', (x * 0.01 for x in range(1000000)))

# 1. 快速写入磁盘二进制文件
with open("sensor_data.bin", "wb") as f:
    data.tofile(f)  # 直接将内存块写入文件,耗时仅数毫秒

# 2. 毫秒级直接从文件读入
loaded = array('d')
with open("sensor_data.bin", "rb") as f:
    # 明确指定需要读取的元素总数
    loaded.fromfile(f, 1000000)

print("读取完成,前 3 个数值:", loaded[:3])tofile() 与 tobytes() 采用的是运行环境本机的机器字节序(Endianness,现代主流 x86/ARM 通常为小端序)。如果生成的二进制文件需要跨异构硬件网络传输,建议配合标准库 struct 模块或统一调用 arr.byteswap() 翻转字节序。
五、场景技术选型:list、array 与 NumPy 如何选择?
Python 生态中提供了多种集合与数值容器,面对不同工程需求,合理选型能够避免过度设计或性能瓶颈。
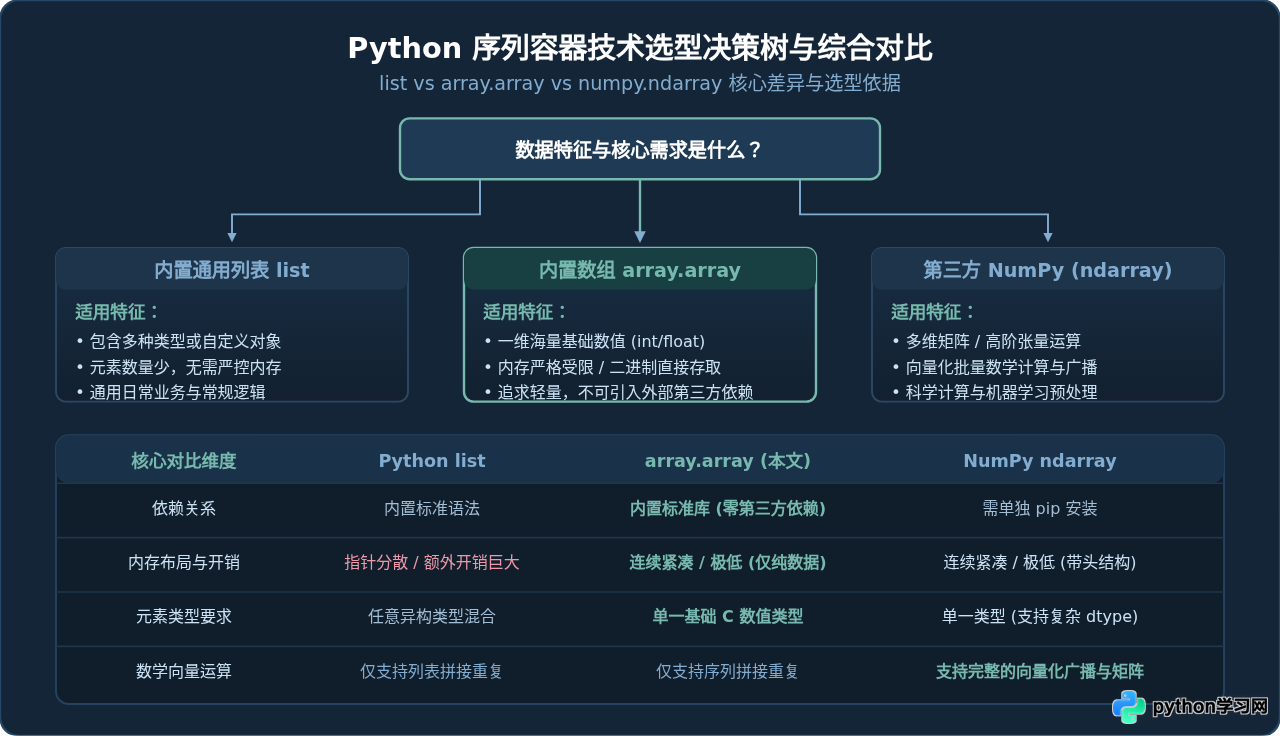
选型决策建议:
- 选择标准
list:- 容器内需要容纳不同类型的数据(如字符串、数字与对象混合)。
- 数据量处于中小规模(几千至数万级),内存压力不是核心矛盾。
- 需要使用丰富的 Python 高层容器特性,且更注重代码编写的便捷性。
- 选择
array.array(本文主角):- 需要处理海量基础数值(数十万至数千万的一维整数或浮点数),内存预算受到严格限制。
- 运行环境受限,无法或不允许安装第三方依赖包(例如轻量级 Docker 镜像、嵌入式系统或企业受控服务器)。
- 需要与 C/C++ 动态库、网络底层套接字直接进行裸二进制内存交互或快速文件转储。
- 选择第三方
NumPy (ndarray):- 需要处理二维表格、多维矩阵或高阶张量。
- 需要进行向量化批量数学运算(如矩阵乘法、傅里叶变换、统计分析、广播机制)。
- 从事科学计算、图像处理、机器学习或高密度数据分析任务。
六、关键限制与避坑指南
- 仅支持一维扁平结构:
array无法原生构建二维或多维数组。虽然可以通过嵌套array(如array('i')的列表)来模拟,但这会破坏底层的物理连续性,失去连续内存的性能优势。多维需求应坚决选用 NumPy。 - 不支持向量数学运算重载:在
array上执行arr * 2并不是将每个元素数值乘以 2,而是将整个数组复制重复一次(与标准列表行为一致);执行arr1 + arr2也只是将两个数组首尾拼接。如果需要元素逐位数学运算,必须通过列表推导式遍历或使用第三方数学库。 - 动态扩容的临时内存峰值:在频繁调用
append()时,当预分配的缓冲区耗尽,解释器会开辟更大的内存块并将数据整体搬迁。如果预先已知数据规模,建议尽可能一次性分配,或从已知大小的迭代器直接构造。
七、全文总结
Python 标准库的 array 模块巧妙地填补了“灵活但臃肿的通用列表”与“强大但沉重的第三方科学计算库”之间的生态空白。通过显式的类型码声明,它把 C 语言高效紧凑的连续内存布局带入了 Python 原生环境:
- 在内存效率上,它以精准的原生字节存储基础数值,将存储开销降低数倍;
- 在安全保障上,它在数据摄入时提供严格的类型检查和数值溢出拦截;
- 在 I/O 吞吐上,它的
tobytes()和tofile()提供了接近硬件裸写速度的二进制持久化能力。
在不引入外部依赖的前提下处理大规模基础数值时,熟练运用 array 模块是编写高资源利用率 Python 程序的有效手段。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















