


零基础学Python要掌握哪些核心语法?变量、循环与函数详解
面向零基础读者的Python核心语法详解教程。全面拆解变量命名与内存引用机制、for与while循环执行差异,以及函数的定义、传参与return返回值逻辑,帮助初学者构建清晰的编程思维模型。
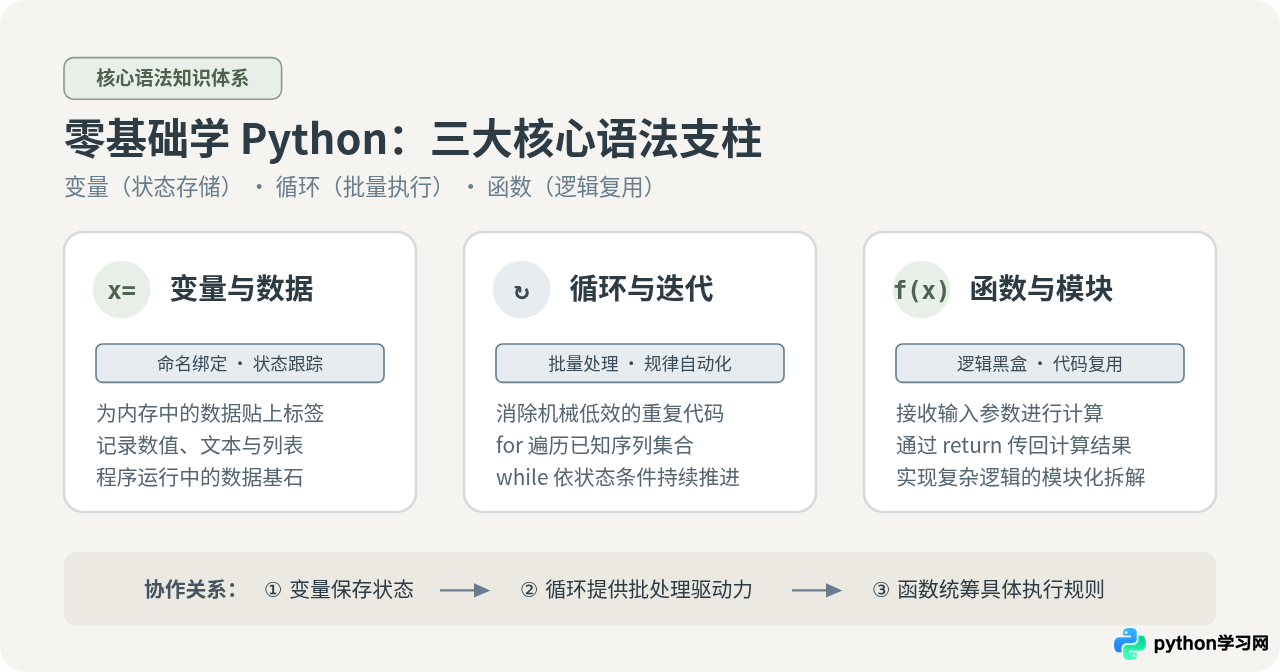
一、变量:数据的标签与状态跟踪
在程序执行过程中,计算机需要不断记录和更新各种数据,例如用户的名称、计算的累计金额或任务的完成状态。变量正是我们用来引用这些数据的符号。
1. Python 变量的本质:是“标签”而非“盒子”
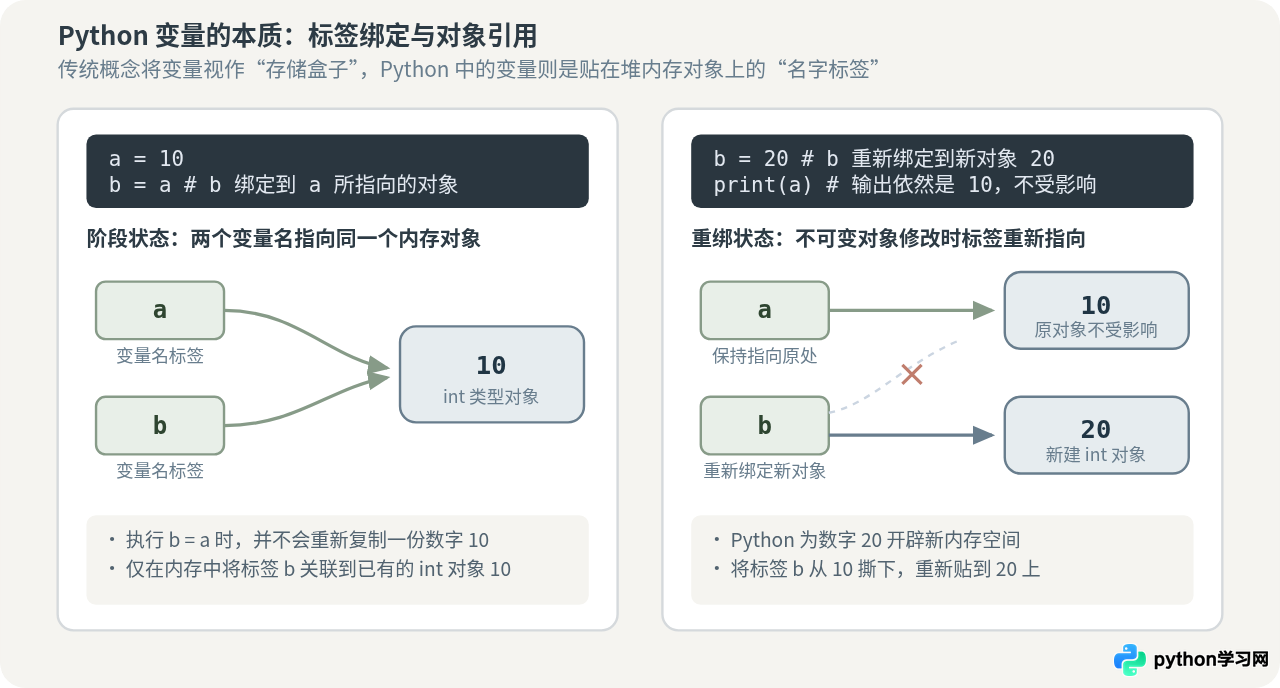
许多初学者常把变量误解为一个装东西的“实体盒子”,认为变量赋值是把数值放进了盒子里。在 Python 的底层机制中,变量本质上是贴在内存对象上的“名字标签”。
当你书写 a = 10 时,Python 会在堆内存中创建一个整数对象 10,然后将名字标签 a 贴在该对象上。如果紧接着写 b = a,并不会在内存中复制一份新的数字 10,而是将标签 b 同样贴到现有的对象 10 上。
2. 常见基础数据类型与赋值示例
Python 是一门动态强类型语言,你在创建变量时无需显式声明类型,解释器会根据赋给它的对象自动确定类型。零基础阶段必须掌握的四种基本类型如下:
# 1. 整数 (int)
user_age = 25

# 2. 浮点数 (float)
item_price = 49.9

# 3. 字符串 (str)
user_name = "张三"

# 4. 布尔值 (bool)
is_active = True

# 5. 列表容器 (list):按顺序存放多个元素
scores = [88, 92, 79, 95]

print(f"用户: {user_name}, 年龄: {user_age}, 状态激活: {is_active}")用户: 张三, 年龄: 25, 状态激活: True
- 强制规则:变量名只能包含字母、数字和下划线(_),严禁以数字开头(如
2items是语法错误),且不能使用 Python 内置关键字(如for、def、class)。 - 官方推荐风格(PEP 8):普通变量采用小写字母加下划线命名法(snake_case),例如
max_retry_count,杜绝使用无意义的单字母或拼音缩写。
二、循环:规律性任务的自动化执行
如果需要对 100 个客户逐一发送账单,或者计算 1 到 1000 的累加和,机械地书写 100 次相同的代码不仅耗时耗力,而且极易出错。循环语句赋予了程序自动重复执行特定代码段的能力。Python 提供了两种基础循环结构:for 循环与 while 循环。
1. for 循环:按序遍历已知容器
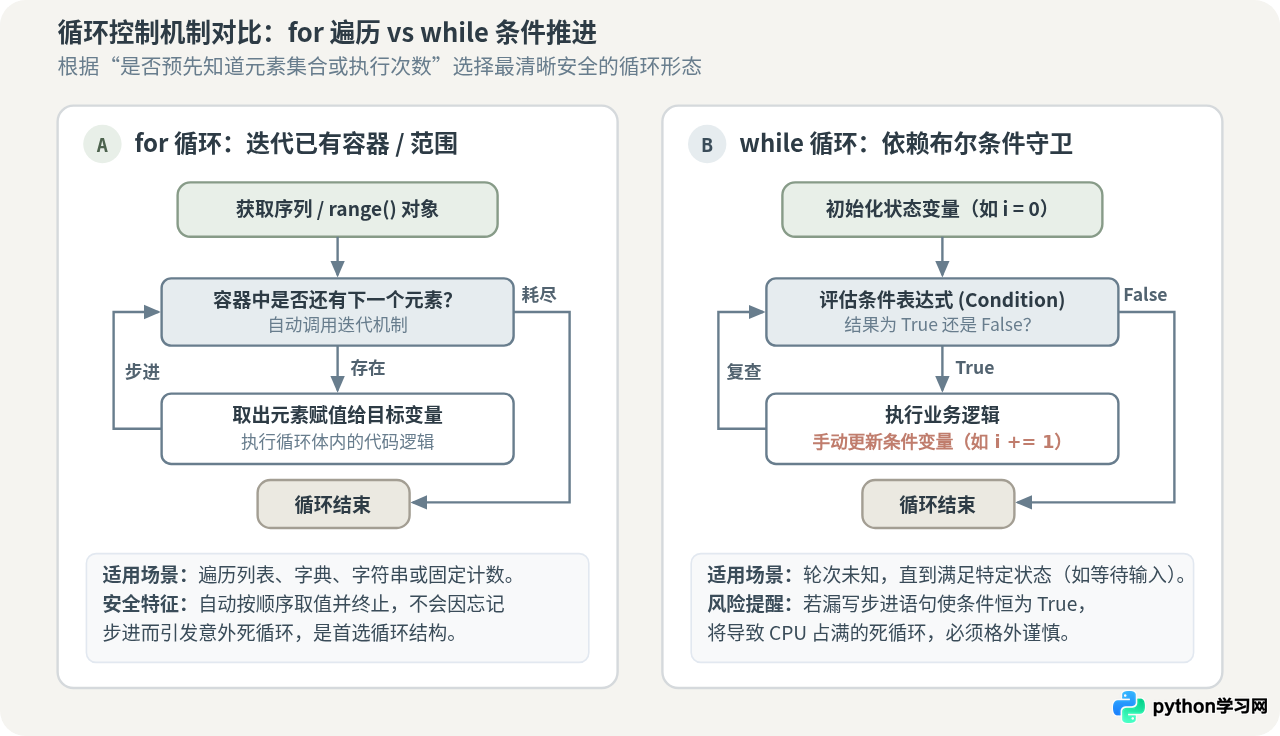
Python 中的 for 循环主要用于“迭代”。只要目标对象是一个序列或集合(如列表、字符串、元组或由 range() 生成的数字序列),for 循环就会按部就班地从头到尾取出每一个元素并执行循环体。
# 场景:批量处理商品价格列表并计算总价
prices = [12.5, 45.0, 30.0, 8.5]
total_amount = 0.0

for price in prices:
    total_amount += price
    print(f"累加当前商品价格: {price} 元")

print(f"结算总计: {total_amount} 元")累加当前商品价格: 12.5 元
累加当前商品价格: 45.0 元
累加当前商品价格: 30.0 元
累加当前商品价格: 8.5 元
结算总计: 96.0 元
2. while 循环:基于状态条件的持续运转
与 for 循环不同,while 循环不关心是否有现成的列表容器,它完全依赖一个布尔条件表达式。只要该表达式的计算结果为 True,循环体就会反复运行;一旦条件变为 False,循环立即终止。
# 场景:模拟重试连接,直到成功或达到最大重试上限
retry_count = 0
max_retries = 3

while retry_count < max_retries:
    retry_count += 1  # 关键步进:更新条件变量
    print(f"正在进行第 {retry_count} 次请求尝试...")

print("已达到重试上限,流程结束")正在进行第 1 次请求尝试...
正在进行第 2 次请求尝试...
正在进行第 3 次请求尝试...
已达到重试上限,流程结束
3. 核心差异对照:何时选 for,何时选 while?
| 比较维度 | for 循环 | while 循环 |
|---|---|---|
| 核心驱动源 | 可迭代序列(列表、字符串、range 等) | 布尔条件表达式(True / False) |
| 执行轮次确定性 | 明确。通常在开始前就由序列长度决定 | 未知或不固定。由运行时的实时状态变化决定 |
| 计数步进方式 | 解释器自动按序抓取下一个元素并推进 | 必须在循环体内手动书写修改条件变量的代码 |
| 死循环风险 | 极低。序列耗尽即自然结束 | 较高。若漏写步进语句导致条件恒为 True,将引发死循环 |
| 典型使用场景 | 批量读取列表、处理表格行、固定次数计数 | 等待网络响应、用户交互确认、传感器数值轮询 |
当处于循环中时,可能遇到需要提前干预的情况:
break:彻底终止整个循环。例如在批量扫描数据时,一旦找到了目标数据,立即通过break退出,避免无谓的后续计算。continue:立即跳过当前这轮循环的剩余代码,直接转入下一轮迭代。例如遇到无效的空数据时跳过,继续处理下一个对象。
三、函数:封装业务逻辑与代码复用
随着程序规模的增长,重复编写类似的计算流程会导致代码冗长且难以维护。函数(Function)是组织代码的核心构件,它将一段具有特定功能的代码块打包并赋予名字。在需要使用时,只需通过函数名调用即可,实现“一次编写,到处复用”。
1. 函数的定义与标准结构
Python 使用关键字 def(define 的简写)来声明函数。一个完整的函数通常包含:函数名称、圆括号内的参数列表、缩进的代码块以及返回结果的 return 语句。
# 定义一个计算折后价格的函数
def calculate_discount(original_price, discount_rate=0.9):
    """
    接收原价与折扣率,返回折后最终价格
    discount_rate 带有默认值 0.9(即打九折)
    """
    final_price = original_price * discount_rate
    return round(final_price, 2)

# 调用函数并接收返回值
pay_amount = calculate_discount(200.0, 0.8)
print(f"八折应付金额: {pay_amount} 元")

# 使用默认折扣调用
normal_amount = calculate_discount(200.0)
print(f"默认九折应付金额: {normal_amount} 元")八折应付金额: 160.0 元
默认九折应付金额: 180.0 元
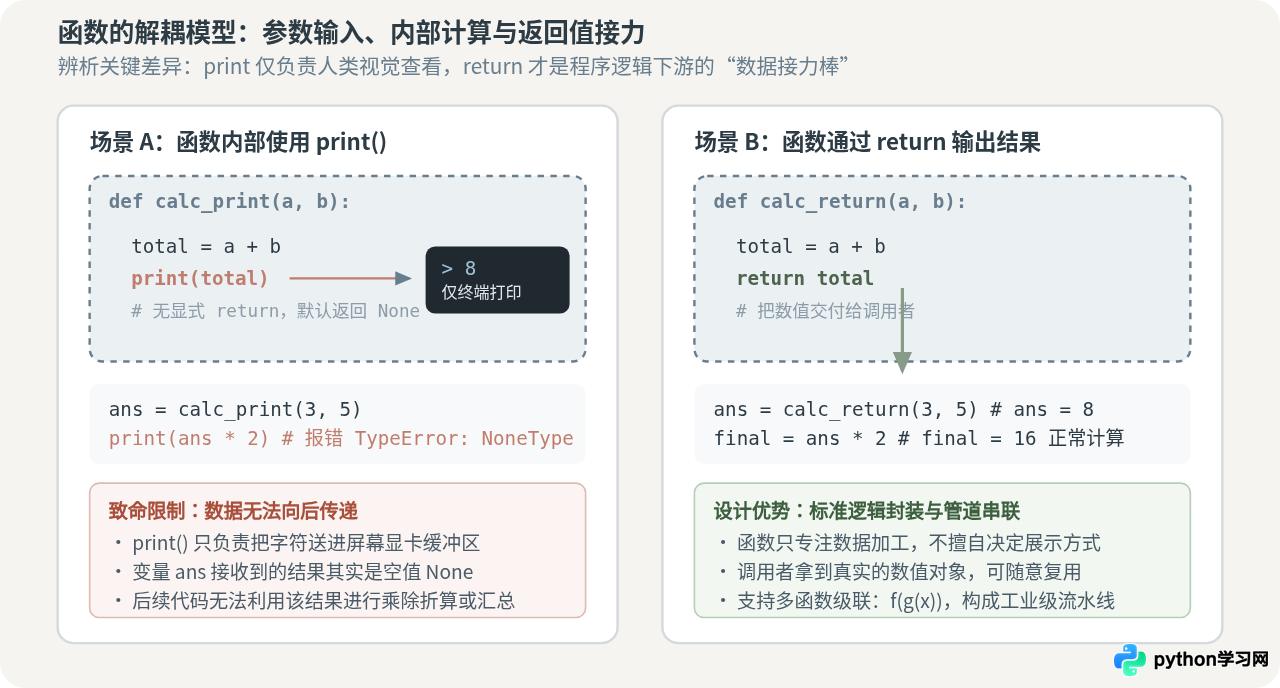
2. 关键辨析:return 与 print() 的本质差异
初学者最容易混淆的概念之一,是在函数内部使用 print() 还是 return。两者在视觉效果上似乎都把结果“吐”了出来,但背后的程序意义截然相反:
- print() 是“屏幕输出动作”:它唯一的作用是将文字转换成光电信号打在显示屏上让人类阅读。它不会给代码中的其他部分留下任何计算结果。调用一个只有
print的函数,其得到的返回值本质上是空对象None。 - return 是“数据传递通道”:它将计算完成的数据实体交回给函数的调用者,后续代码可以用变量将这个数值接住,用于下一步的乘除运算、写入数据库或作为另一个函数的输入参数。此外,执行到
return会立即退出当前函数。
def bad_add(x, y):
    print(x + y)  # 仅打印,未 return

def good_add(x, y):
    return x + y  # 正规返回数据

# 错误示例:尝试继续使用 bad_add 的结果
result_a = bad_add(5, 5)  # 屏幕输出 10,但 result_a 实际为 None
# 试图继续计算: total = result_a * 2
# 运行时直接崩溃: TypeError: unsupported operand type(s) for *: 'NoneType' and 'int'

# 正确示例:接收 good_add 的真实结果继续工作
result_b = good_add(5, 5)  # result_b 接收到整数 10
total = result_b * 2       # 正常进行下游计算
print(f"下游计算得到的正确总数: {total}")10
下游计算得到的正确总数: 20
四、三者协同实战:从零编写一个统计评级系统
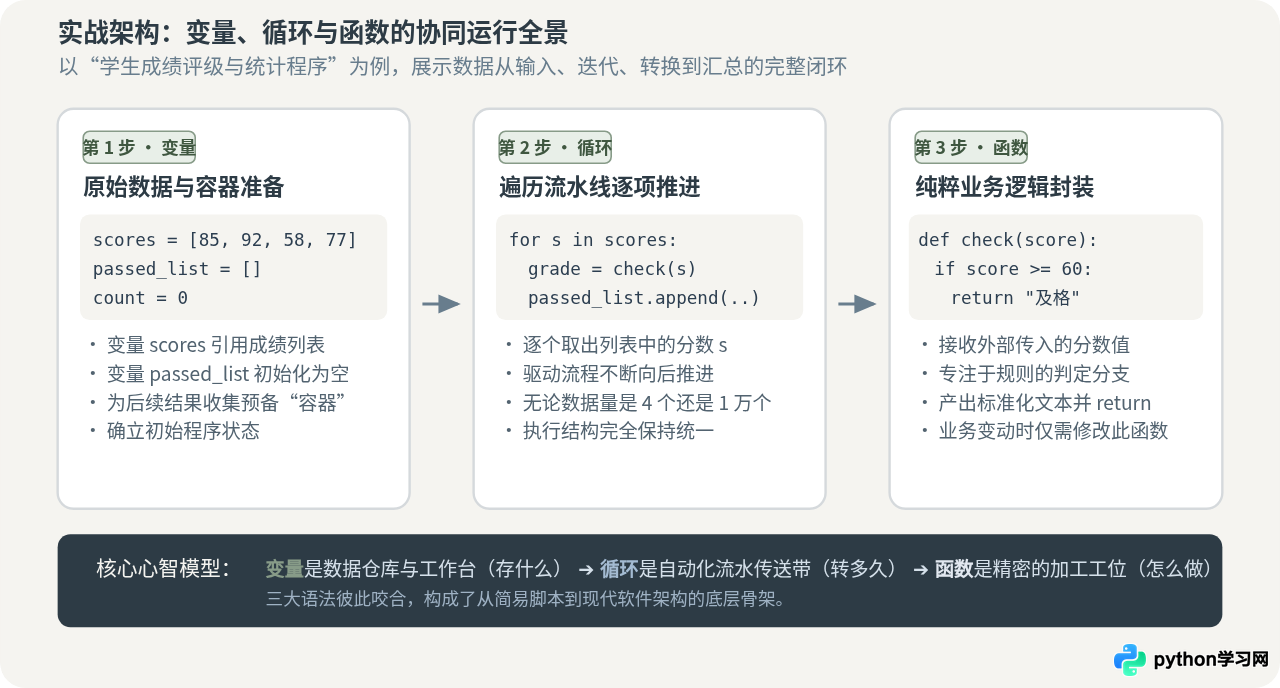
孤立地看,变量是静态名词,循环是动力动词,函数则是精确的规则谓词。只有把它们组合起来,才能形成一条流水线。下面我们通过一个“批量学员成绩评估与统计”完整案例,直观展示三者的协同协作方式。
# 1. 【函数层】:封装单条分数的评定规则
def evaluate_grade(score):
    if score >= 90:
        return "优秀"
    elif score >= 60:
        return "及格"
    else:
        return "需补考"

# 2. 【变量层】:定义初始原始数据容器与结果汇总计数器
raw_scores = [95, 58, 84, 72, 53, 91]
summary_report = []
passed_count = 0

# 3. 【循环层】:建立流水线,逐个推进处理
for score in raw_scores:
    # 协同动作 A:调用函数获取判定等级
    grade_label = evaluate_grade(score)

    # 协同动作 B:根据判定结果更新状态变量
    if grade_label in ["优秀", "及格"]:
        passed_count += 1

    # 协同动作 C:结构化组装结果
    summary_report.append(f"分数: {score} -> 等级: {grade_label}")

# 4. 输出最终分析报表
print("=== 成绩批量评估结果 ===")
for line in summary_report:
    print(line)

print("-" * 25)
total_students = len(raw_scores)
pass_rate = (passed_count / total_students) * 100
print(f"总计评估: {total_students} 人,及格人数: {passed_count} 人,及格率: {pass_rate:.1f}%")=== 成绩批量评估结果 ===
分数: 95 -> 等级: 优秀
分数: 58 -> 等级: 需补考
分数: 84 -> 等级: 及格
分数: 72 -> 等级: 及格
分数: 53 -> 等级: 需补考
分数: 91 -> 等级: 优秀
-------------------------
总计评估: 6 人,及格人数: 4 人,及格率: 66.7%
五、新手高频报错与精准排查指南
编写 Python 代码时遇到错误是极其正常的现象。初学者在掌握上述三项语法的初期,最常碰到的四大典型报错如下:
-
1. NameError: name 'xxx' is not defined
原因:尝试访问一个尚未赋值的变量,或者变量名存在大小写拼写笔误。在 Python 中,大小写极其敏感(Score与score是两个完全无关的变量名)。此外,如果在函数内部定义了局部变量,在函数外部直接调用它也会触发此报错。 -
2. IndentationError: unexpected indent / expected an indented block
原因:缩进错误。Python 依赖严格的缩进(推荐统一为 4 个英文空格)来标明代码归属层级。for、while或def行的下一行代码必须缩进;切勿在同一个文件中混用 Tab 制表符与空格。 -
3. while 循环无休止卡死(死循环)
原因:while的条件表达式始终无法满足跳出条件。排查重点是检查循环体内部是否缺少了关键的累加语句(如i += 1),或者外部变更的标志变量是否未能正确在循环内传递。 -
4. 函数返回值出现 None 并引发后续 TypeError
原因:函数内部的所有代码分支中,至少有一个分支没有显式书写return。当代码执行到末尾依然没有遇到 return 时,Python 会默认返回None。排查时应仔细核对if-elif-else结构,确保每一条执行路径都有确定的返回值。
总结
Python 编程的核心逻辑虽然千变万化,但其基础架构始终统一:变量承载着数据与系统的状态,循环提供了自动遍历与批量执行的动力,而函数则将具体的业务算法和转换规则固化为可复用的构件。
建议初学者在练习时,先从写出清晰规范的变量命名做起;随后运用 for 循环体验处理列表数据的便捷性;再将重复出现的逻辑提炼进函数中,通过确定的参数和返回值完成模块解耦。循序渐进地建立起这套心智模型,便能从容应对更复杂的编程挑战。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















