


Python配置Chrome无头模式实现后台静默浏览网页
本文详细介绍在Python中使用Selenium配置Chrome无头模式(Headless Chrome)的方法,解析新版与旧版无头参数差异、常用静默运行选项、视口尺寸调整、反识别配置及常见报错排查。
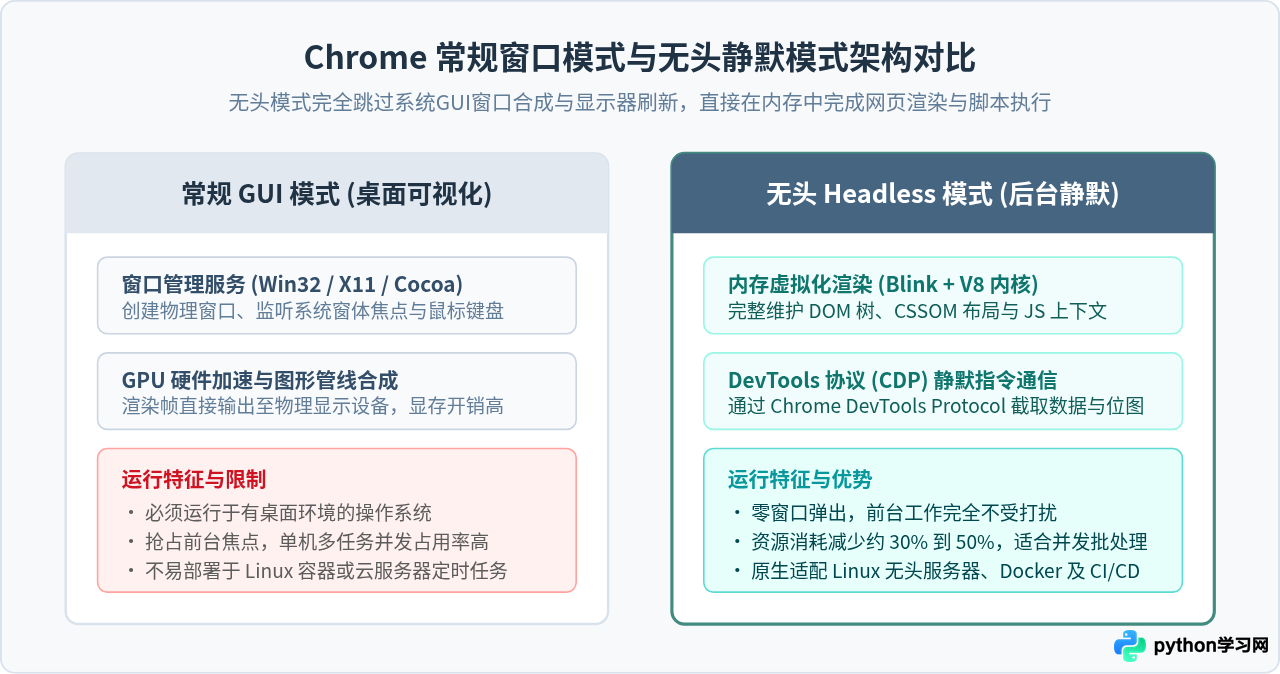
在进行自动化测试、周期性数据抓取或定时页面巡检时,频繁弹出浏览器窗口不仅会干扰桌面正常操作,还会消耗大量显卡与窗口合成资源。通过在Python中为Selenium配置Chrome无头模式(Headless Chrome),可以在不唤起任何可视化窗口的前提下,让浏览器内核在操作系统后台静默执行页面导航、DOM解析、数据提取与截图导出等完整交互流程。
一、准备运行环境
在编写自动化脚本前,需要保证当前系统已安装 Google Chrome 浏览器以及 Python 的 selenium 依赖库。在现代 Selenium(4.6.0 及以上版本)中,官方内置了 Selenium Manager 工具,它会自动识别本机安装的 Chrome 版本并按需下载匹配的 chromedriver,无需开发者手动下载解压并配置环境变量 PATH。
# 安装或更新最新版 Selenium 库
pip install --upgrade selenium--headless=new 参数。旧参数 --headless 是一个单独维护的精简渲染器分支,存在许多与常规浏览器行为不一致的隐性Bug;而新参数 --headless=new 则是直接在完整的 Chrome 浏览器内核上屏蔽界面合成,排版、样式和功能表现与桌面真实窗口完全一致。二、配置无头模式的关键参数
通过 Selenium 启动静默浏览器时,核心操作是实例化 webdriver.ChromeOptions 类,并通过 add_argument() 方法注入 Chrome 命令行参数。启动静默模式所需的典型配置如下:
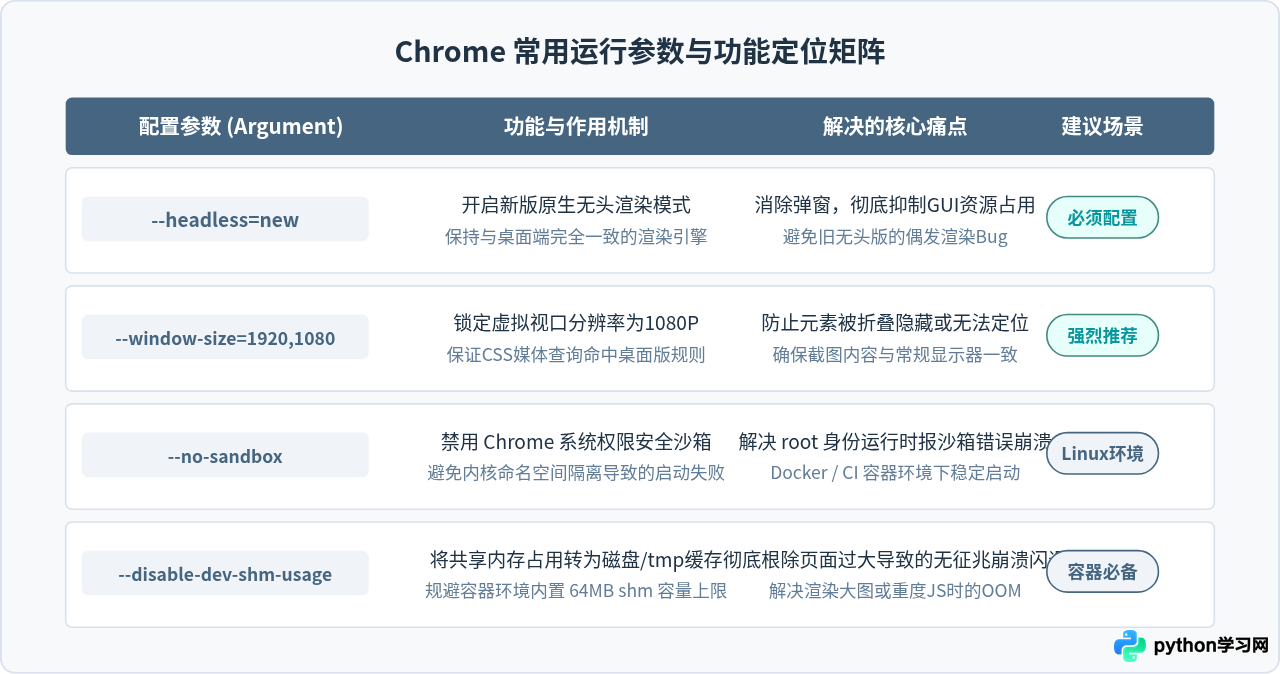
--headless=new:开启 Chrome 现代原生无头模式。在后台进程中完成完整的页面生命周期调度,不展示任何操作系统窗体。--window-size=1920,1080:显式定义虚拟视口尺寸。无头模式在默认情况下可能会以极小的窗口(例如 800x600)运行,导致响应式网页折叠导航菜单、延迟加载下方内容或将关键交互按钮隐藏在汉堡菜单中。--disable-gpu:禁用 GPU 硬件加速。主要用于防止部分特定操作系统或虚拟机在没有显卡物理驱动时输出图形上下文报错。--no-sandbox:停用沙箱机制。在 Linux 无桌面服务器、以 root 身份运行脚本或在 Docker 容器中部署时,这是避免进程因权限被系统内核阻断而崩溃的必要参数。--disable-dev-shm-usage:禁止使用/dev/shm共享内存。在容器或部分默认共享内存仅有 64MB 的 Linux 环境中,重度渲染容易导致内存溢出崩溃,加入该参数可以让 Chrome 使用/tmp磁盘缓存代替共享内存。
三、完整可运行代码示例
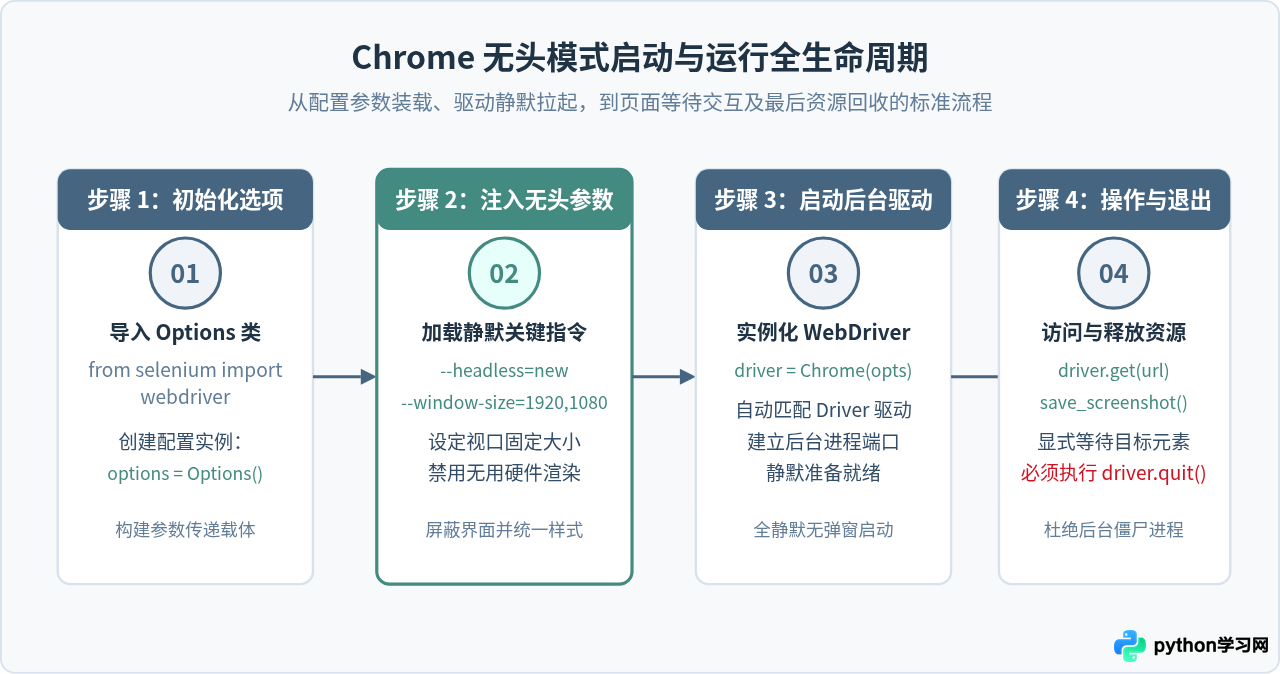
下面是一段可直接运行的 Python 脚本。该脚本配置了无头选项,访问目标网页获取网页标题、输出渲染后的 HTML 片段,并将静默渲染的内容保存为本地截图文件,最后确保安全退出并回收进程。
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

def run_headless_browser():
    # 1. 实例化 ChromeOptions 配置对象
    options = Options()

    # 2. 启用新版无头模式(Chrome 109+ 推荐使用 --headless=new)
    options.add_argument("--headless=new")

    # 3. 设置虚拟窗口尺寸,避免因移动端适配导致排版塌陷或元素不可视
    options.add_argument("--window-size=1920,1080")

    # 4. 禁用 GPU 加速及沙箱,提升多环境(尤其是 Linux/Docker)兼容性
    options.add_argument("--disable-gpu")
    options.add_argument("--no-sandbox")
    options.add_argument("--disable-dev-shm-usage")

    # 5. 可选:设置伪装 User-Agent,规避针对无头模式的默认标识拦截
    user_agent = ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/120.0.0.0 Safari/537.36")
    options.add_argument(f"--user-agent={user_agent}")

    # 6. 初始化驱动(Selenium 4 自动接管驱动下载与路径匹配)
    driver = webdriver.Chrome(options=options)

    try:
        # 打开目标页面(以 Python 官网为例)
        target_url = "https://www.python.org"
        print(f"正在后台静默访问: {target_url}")
        driver.get(target_url)

        # 7. 显式等待:由于无头模式没有视觉反馈,必须使用 WebDriverWait 确保目标元素加载
        wait = WebDriverWait(driver, 10)
        nav_element = wait.until(
            EC.presence_of_element_located((By.ID, "mainnav"))
        )

        # 获取并打印页面基础信息
        page_title = driver.title
        print(f"网页加载成功,标题为: {page_title}")

        # 截取静默渲染生成的网页图片,用于验证执行效果
        screenshot_path = "headless_preview.png"
        driver.save_screenshot(screenshot_path)
        print(f"后台渲染完成,截图已保存至: {screenshot_path}")

    except Exception as e:
        print(f"运行过程中出现异常: {e}")

    finally:
        # 8. 无论成功或失败,都必须调用 quit() 终止后台浏览器进程
        driver.quit()
        print("Chrome 后台进程已安全关闭。")

if __name__ == "__main__":
    run_headless_browser()
四、无头模式关键配置项详细对照
为了让不同应用场景下的配置更具针对性,下表整理了无头配置中的常见参数、具体职能及推荐开启的场景:
五、反检测与高级优化技巧
很多现代网站为了防范自动化爬虫,会检测访问者的无头特征。如果使用默认无头参数访问,部分站点可能会拒绝响应或弹出人机验证。以下是两项实用且低风险的优化方案:
1. 移除 navigator.webdriver 属性
Chrome 处于自动化受控模式时,JavaScript 的 window.navigator.webdriver 属性会被默认赋值为 true。可以通过 CDP(Chrome DevTools Protocol)在每一个新文档构建前注入一段脚本,将该属性伪装为 undefined:
# 配合 ChromeOptions 屏蔽自动化受控提示
options.add_experimental_option("excludeSwitches", ["enable-automation"])
options.add_experimental_option('useAutomationExtension', False)

driver = webdriver.Chrome(options=options)

# 利用 CDP 脚本,在每个页面加载前静默抹除 webdriver 标志
driver.execute_cdp_cmd("Page.addScriptToEvaluateOnNewDocument", {
    "source": """
        Object.defineProperty(navigator, 'webdriver', {
            get: () => undefined
        })
    """
})
2. 禁用图片加载以进一步加速
如果你仅需获取网页中的纯文本数据或接口响应,而不需要进行页面截图,可以在配置中禁止下载图片资源,从而节省带宽并大幅提高访问速度:
# 禁止加载图片提升静默爬取吞吐量
options.add_argument("--blink-settings=imagesEnabled=false")
六、常见问题与排查清单
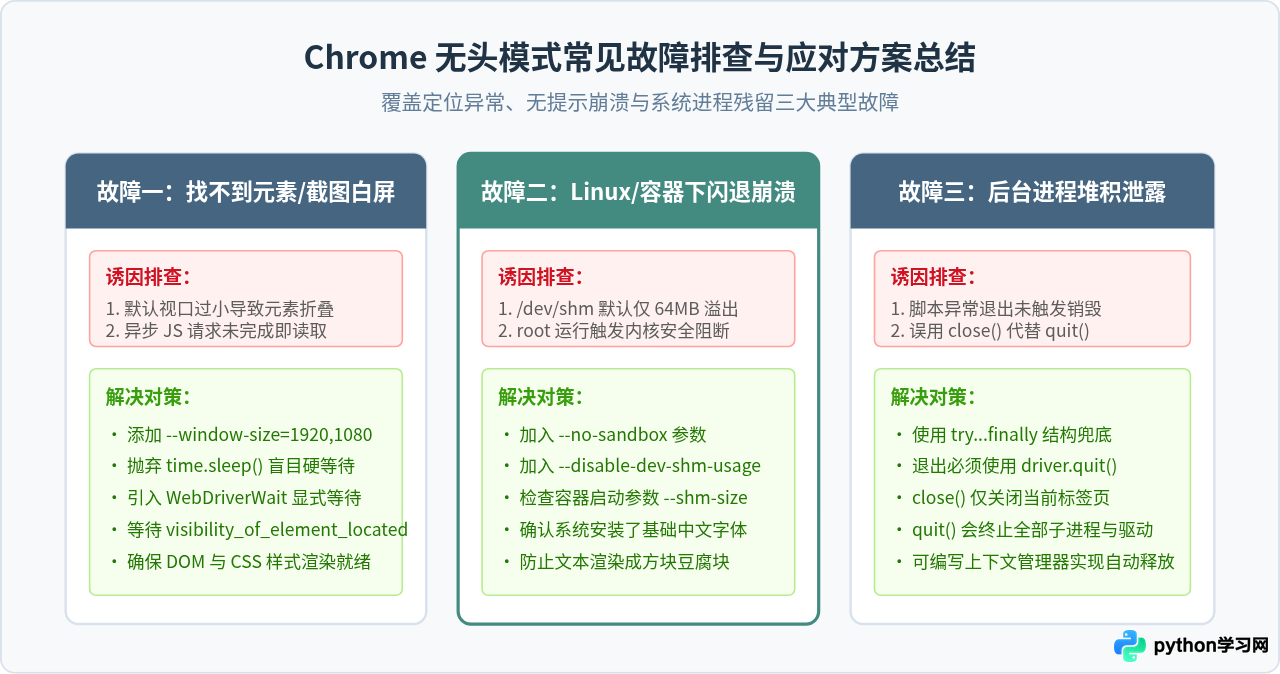
在实际工程部署与运行无头模式脚本时,开发者常遇到以下典型异常情况,可按对应方案快速排查:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















