


Python字符串切片常用示例:截取前N位、后N位及中间部分
详细讲解Python字符串切片的核心语法与高频应用场景,涵盖截取前N位、截取后N位、截取中间指定区间、步长控制及反转字符串的完整代码示例与原理解析。
在 Python 开发中,截取字符串指定位置的内容是一项基础且使用频率极高的操作。Python 原生提供了简洁优雅的切片机制(Slice),无需调用专门的截取函数,即可通过下标索引灵活获取目标子串。无论是截取前 N 位、后 N 位,还是提取中间特定区间的内容,切片语法的核心都在于理解“索引范围”与“左闭右开”规则。本文将通过具体代码示例、图文示意和易错点解析,帮助读者全面掌握字符串切片的常用操作与边界处理策略。
一、核心原理:双向索引与切片基本语法
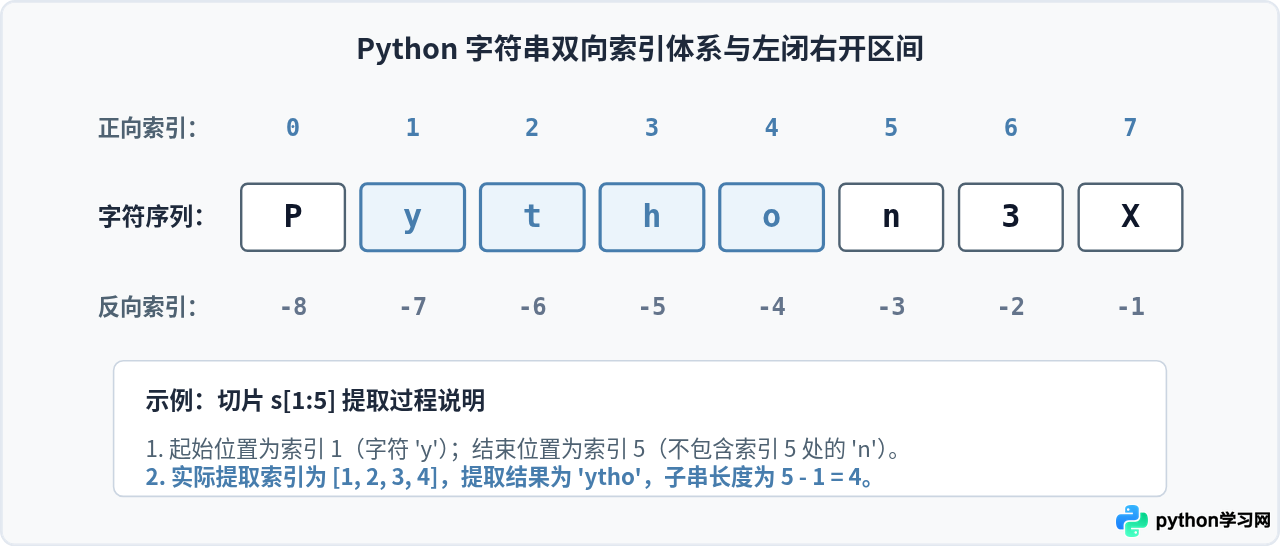
Python 字符串属于不可变有序序列,序列中的每一个字符都有两个固定的位置标识:正向索引与反向索引。正向索引从字符串最左侧的 0 开始递增;反向索引则从字符串最右侧的 -1 开始向左递减。
切片的基本语法结构为 string[start:stop:step],其中包含三个关键参数:
- start(起始索引):切片开始提取的位置。若省略,正向步长下默认为
0。 - stop(结束索引):切片停止的位置。切片规则采用标准的左闭右开区间,即包含
start位置的字符,但不包含stop位置的字符。若省略,正向步长下默认切取至字符串末尾。 - step(步长):每次提取字符的步进间隔。若省略,默认为
1。
二、截取前 N 位字符:省略起点的标准用法
当需要从字符串头部开始截取指定数量的字符时,最地道、最常用的写法是省略起始索引 start,直接书写 string[:N]。
1. 标准语法与代码示例
根据切片规则,省略 start 默认代表从索引 0 开始,切到索引 N 停止(不含 N),因此实际正好截取了下标为 0, 1, ..., N-1 的前 N 个字符。
# 基础示例:截取前 N 位
text = "PythonProgramming"

# 截取前 6 位字符
prefix_6 = text[:6]
print("前6位字符:", prefix_6)  # 示例输出: Python

# 截取前 1 位(首字符)
first_char = text[:1]
print("首位字符:", first_char)  # 示例输出: P
2. 边界行为:当 N 超出字符串长度时
在直接使用单字符下标索引(如 text[100])时,如果索引超出有效范围,Python 会抛出 IndexError: string index out of range 异常。但切片操作具有自动容错特性:
- 如果
N >= len(string),切片不会报错,而是直接截取到字符串末尾,返回原字符串的完整浅拷贝。 - 如果
N <= 0,切片结果为一个空字符串""。
# 切片越界安全性示例
short_text = "Hi"
print(short_text[:10])  # 示例输出: Hi (不抛出 IndexError,安全截断)
print(short_text[:0])   # 示例输出: "" (空字符串)
三、截取后 N 位字符:负索引与终点省略规则
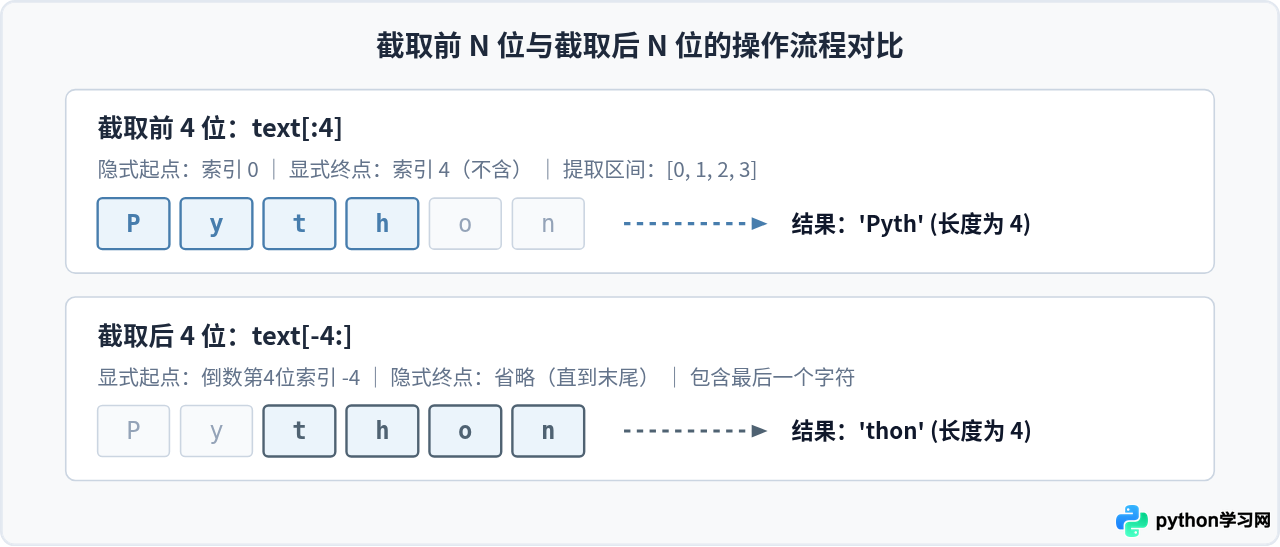
截取后 N 位字符是负索引最典型的使用场景。常用写法为 string[-N:]。
1. 标准写法与运作机制
在 string[-N:] 中:
-N表示从字符串末尾向前数第 N 个位置作为起始点。- 省略 stop 参数:这一点至关重要。因为切片是左闭右开的,如果要保留字符串的最后一个字符(其索引为
-1),就绝对不能写string[-N:-1],否则最后一个字符会被排除在外。省略stop会通知 Python 引擎一直提取至字符串物理终点,完整包含最后一个字符。
# 基础示例:截取后 N 位
filename = "report_2026_final.pdf"

# 截取后 3 位扩展名字符
ext_3 = filename[-3:]
print("后3位字符:", ext_3)  # 示例输出: pdf

# 截取后 4 位(包含点号)
ext_4 = filename[-4:]
print("后4位字符:", ext_4)  # 示例输出: .pdf
避坑提醒:切勿误写为 string[-N:-1]。例如 "Python"[-4:-1] 的输出是 "tho" 而非 "thon",因为右开区间会把 -1 处的字符 'n' 排除。
四、截取中间部分:精确定位与灵活搭配
对于既不包含开头也不延伸至结尾的中间区域,可以通过组合具体的起止下标进行提取。
1. 指定已知起止索引:string[start:stop]
如果已经预先知道目标内容的固定下标区间,直接传入具体的整数即可。例如提取一段定长格式日志中的日期或代码编号:
# 截取中间指定位置
log_record = "2026-10-15 [INFO] Server started successfully"

# 截取索引 11 到 17 之间的级别标识内容(含 '[' 与 ']')
level_tag = log_record[11:17]
print("提取中间标识:", level_tag)  # 示例输出: [INFO]
2. 去除首尾字符:正负索引混合搭配
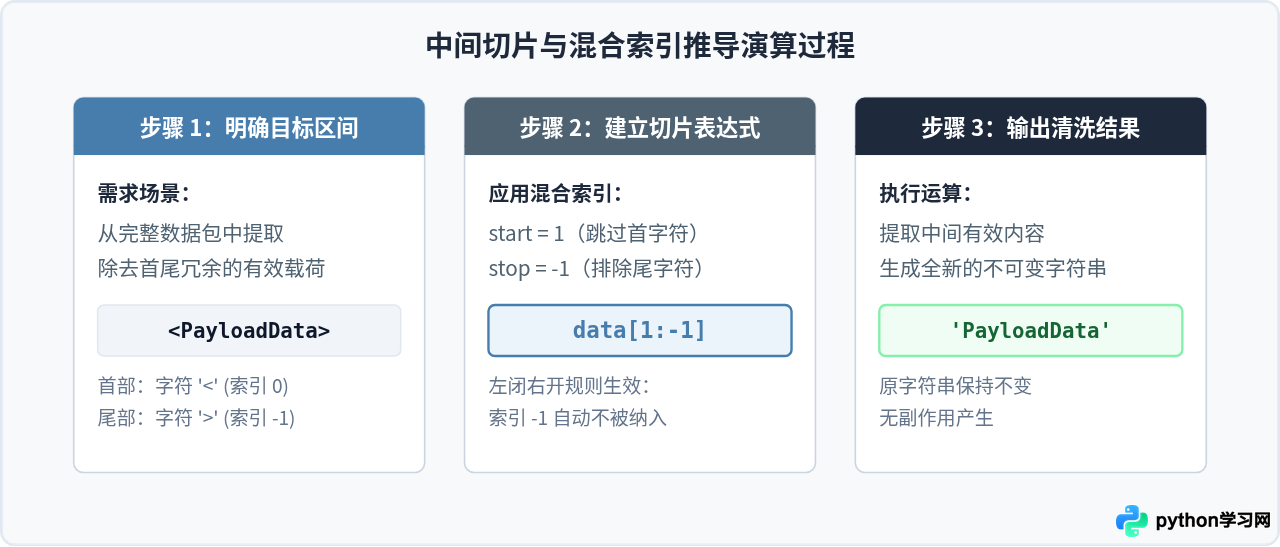
在日常数据清洗时,经常需要剥离字符串两端的外包字符(如括号、单双引号、特定前缀后缀)。此时可以结合正索引与负索引:string[1:-1]。
# 去除两端字符示例
raw_str = "\"CleanData\""
trimmed = raw_str[1:-1]
print("剥离双引号后:", trimmed)  # 示例输出: CleanData

bracket_str = "[12345]"
inner_val = bracket_str[1:-1]
print("去除方括号后:", inner_val)  # 示例输出: 12345
3. 动态中间截取:结合 find() 与 index()
在实际业务中,目标子串的起始位置往往不是固定写死的。通常需要先借助 find() 定位特征符号,再将计算出的索引传入切片:
# 动态查找并提取两符号中间的内容
email = "user.support@service.example.com"

start_pos = email.find("@") + 1
stop_pos = email.find(".", start_pos)

domain = email[start_pos:stop_pos]
print("主域名服务商:", domain)  # 示例输出: service
五、步长控制与字符串反转技巧
切片的第三个参数 step 用于控制遍历步长与方向。理解 step 可以扩展出很多实用的高级用法。
1. 隔位采样:正步长
当 step > 1 时,切片会在区间内每隔 step - 1 个字符提取一次:
digits = "0123456789"

# 从头到尾每隔1个取1个(提取偶数位字符)
evens = digits[::2]
print("偶数位:", evens)  # 示例输出: 02468

# 从索引 1 开始每隔1个取1个(提取奇数位字符)
odds = digits[1::2]
print("奇数位:", odds)  # 示例输出: 13579
2. 逆序反转字符串:负步长
当 step = -1 时,切片的遍历方向发生反转,从右向左移动。最经典的高频用法是 string[::-1],用于原地生成一个逆序翻转后的新字符串:
word = "level"
is_palindrome = word == word[::-1]
print("是否为回文词:", is_palindrome)  # 示例输出: True

s = "ABCDEFG"
reversed_s = s[::-1]
print("翻转结果:", reversed_s)  # 示例输出: GFEDCBA
六、常用切片模式速查与核心规则总结
为了便于在实际开发中快速对照选择,下表总结了最常用的字符串切片模式及其含义:
| 切片写法 | 操作目标 | 典型示例(以 "Python" 为例) | 返回结果 |
|---|---|---|---|
s[:N] |
截取前 N 位字符 | "Python"[:3] |
'Pyt' |
s[-N:] |
截取后 N 位字符 | "Python"[-3:] |
'hon' |
s[start:stop] |
截取从 start 到 stop-1 的中间部分 | "Python"[2:5] |
'tho' |
s[1:-1] |
剔除首尾字符,保留正文内容 | "Python"[1:-1] |
'ytho' |
s[::2] |
从头到尾隔一个字符提取一次 | "Python"[::2] |
'Pto' |
s[::-1] |
完整逆序反转整个字符串 | "Python"[::-1] |
'nohtyP' |
s[:] |
创建当前字符串的完整浅拷贝 | "Python"[:] |
'Python' |
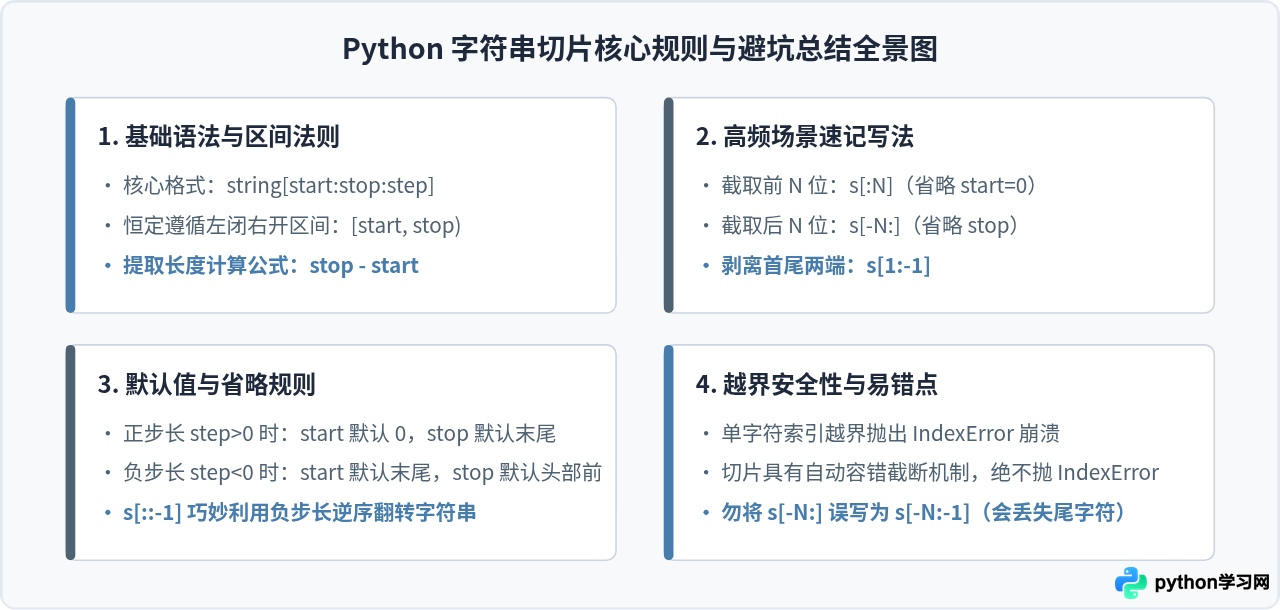
七、结语
Python 字符串切片是一个语法简练但内涵丰富的语言特性。截取前 N 位使用 s[:N],截取后 N 位使用 s[-N:],截取中间使用 s[start:stop] 或 s[1:-1],掌握了这三种基础范式及其背后的左闭右开与索引规则,就能在绝大多数文本处理场景中写出既高效又健壮的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















