


Blender和Calibre:基于Python开发的经典桌面应用软件
深入解析Blender与Calibre两款基于Python开发的经典桌面应用,剖析C/C++与Python混合架构、PyQt工程化实践、性能分工与分发机制。
在工业级 3D 创作软件和专业数字出版领域,Blender 与 Calibre 经常被作为论证 Python 桌面应用上限的典范。本文将直接剖析这两款知名开源软件的架构设计,说明它们如何通过“C/C++ 与 Python 混合架构”以及“Python 驱动复杂业务与 PyQt 原生渲染”的两种路径,兼顾运行效率、开发速度与庞大插件生态,并为桌面客户端开发者提供务实的选型参考与工程借鉴。
一、为什么是 Blender 和 Calibre:两类截然不同的 Python 桌面范式
长久以来,许多开发者受限于 Python 的全局解释器锁(GIL)与运行效率,普遍认为 Python 仅适合编写数据脚本、Web 后端或简单的内部运维工具,无法支撑界面复杂、交互高频的大型桌面客户端。然而 Blender 与 Calibre 的持续演进证明,关键不在于“是否纯用 Python”,而在于如何合理界定 Python 的运行边界与职责分工。
这两款软件代表了桌面应用开发的两种成熟演进路线:
- Blender(宿主胶水模式):以高性能 C/C++ 编写几何运算、物理模拟和实时渲染管线,但将几乎所有上层用户交互、菜单布局、数据检查和插件扩展机制完整交由内置的 Python 解释器驱动。
- Calibre(全栈业务模式):以数十万行 Python 代码构建整体应用程序的业务中枢与数据流转,界面层依托成熟的原生 Qt(PyQt)框架绘制,繁重的解压缩、字符编码判断及底层排版调用 C 扩展,密集计算由外部独立进程隔离执行。
二、Blender 的 Python 架构:胶水语言如何调度顶级 3D 引擎
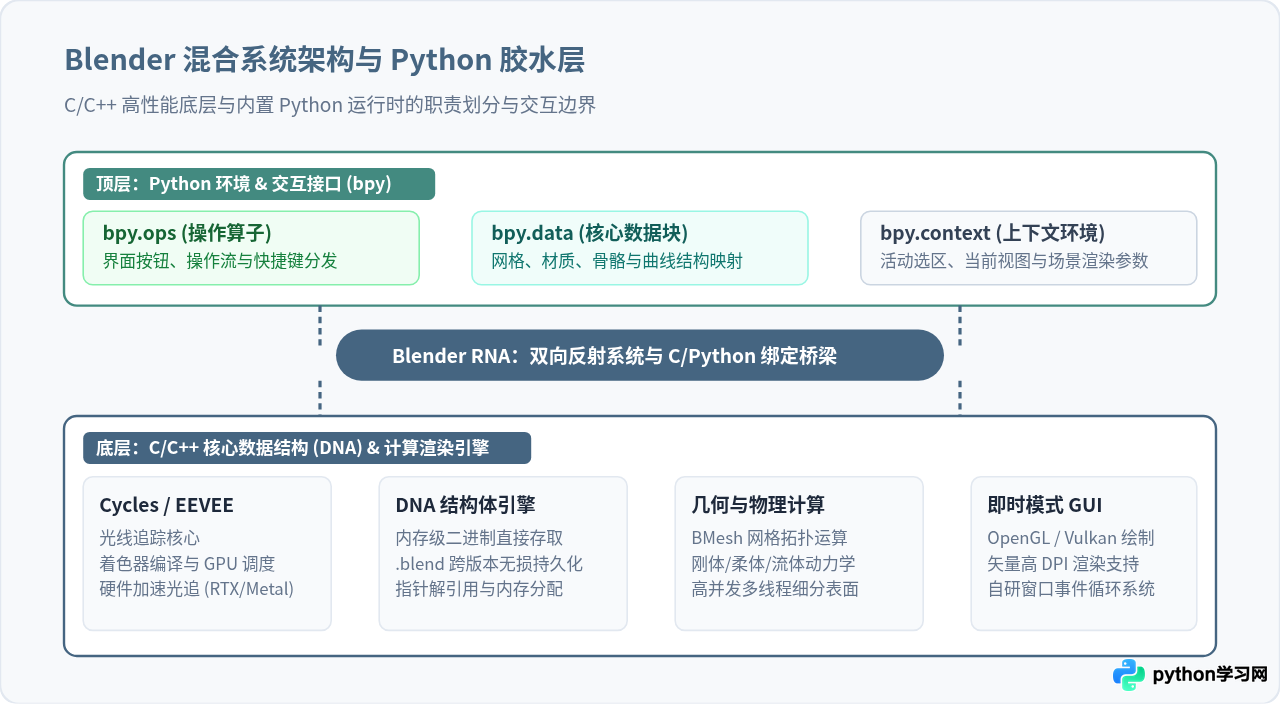
打开 Blender 的界面,点击任何按钮、调整任何材质滑块,其底层都在触发 Python 代码或通过 Python 与内部数据结构进行映射。Blender 并没有将 Python 仅仅视作一个辅助性的“宏脚本”,而是将其深度融合在整个系统设计之中。
Blender 内部采用了一套独特的数据定义与映射体系,即 DNA(底层 C 语言二进制内存结构)与 RNA(面向反射的动态属性系统)。RNA 充当了底层 C 数据与上层 Python 环境之间的粘合剂。当开发者在 Python 中输入 bpy.data.objects['Cube'].location.x = 5.0 时,Python 解释器并不直接操作庞大的几何顶点缓冲区,而是通过 RNA 接口直接定位并修改底层 C 结构体中的对应浮点数字段,随之触发视口重绘。
内置 Python 模块的三大支柱
在 Blender 启动时,它会初始化内嵌的独立 Python 解释器,并动态注入专有的 bpy 包。开发者最常用的有三个子模块:
bpy.context:提供只读为主的全局环境信息,如当前选中的物体(selected_objects)、当前工作模式(对象模式或编辑模式)、当前激活的时间轴帧数。bpy.data:充当场景数据的根入口,包含objects、materials、meshes、cameras等集合,相当于对内存中已加载的整个.blend文件树的遍历容器。bpy.ops:提供了执行用户动作的高层操作算子,例如bpy.ops.mesh.primitive_cube_add()或bpy.ops.render.render()。这些算子直接封装了完整的撤销历史(Undo Stack)和事件派发。
三、实操:从控制台自动化到封装为 Blender Add-on 插件
理解 Blender Python 最直接的方式是在其内置工作区中编写代码。按照以下具体步骤,可以在不到五分钟内完成一段自动化脚本并打包为标准插件:
- 开启工作区:在 Blender 顶部菜单栏点击“Scripting”(脚本)标签页,界面会自动切换为左侧 Python 控制台与信息栏、右侧文本编辑器与 3D 视图。
- 编写自动化脚本:在文本编辑器中新建脚本,输入以下批量排列立方体的代码:
import bpy

# 清理当前场景中选中的网格
bpy.ops.object.select_all(action='DESELECT')

# 沿 X 轴批量生成 5 个立方体并按顺序命名
for i in range(5):
    bpy.ops.mesh.primitive_cube_add(
        size=1.2,
        location=(i * 2.5, 0.0, 0.0)
    )
    current_obj = bpy.context.active_object
    current_obj.name = f"Generated_Cube_{i+1}"
    print(f"创建成功: {current_obj.name}")
点击文本编辑器上方的“Run Script”(运行脚本)按钮,3D 视图中会立刻生成排布整齐的模型,控制台输出创建确认信息。
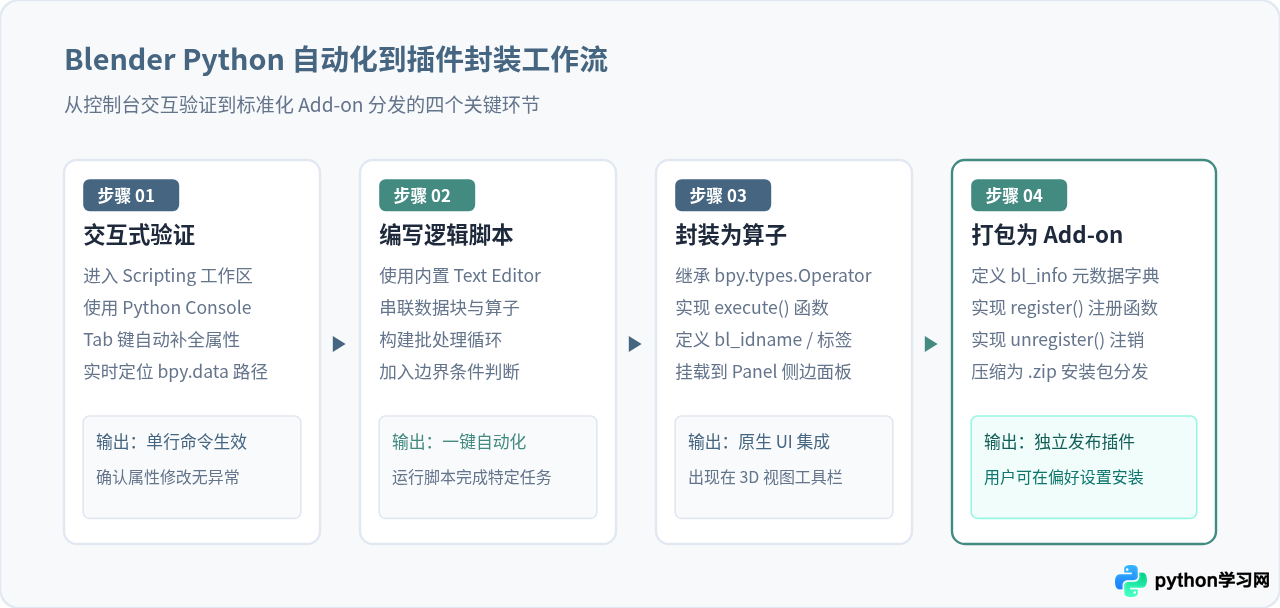
若要将上述逻辑固化为软件内的标准功能,只需补充 bl_info 描述字典与生命周期函数:
bl_info = {
    "name": "批量生成工具",
    "author": "技术示例",
    "version": (1, 0, 0),
    "blender": (3, 6, 0),
    "location": "View3D > Sidebar > 工具",
    "category": "Object",
}

class OBJECT_OT_batch_create(bpy.types.Operator):
    bl_idname = "object.batch_create_cubes"
    bl_label = "批量创建立方体"
    bl_options = {'REGISTER', 'UNDO'}

    def execute(self, context):
        for i in range(5):
            bpy.ops.mesh.primitive_cube_add(size=1.2, location=(i * 2.5, 0.0, 0.0))
        self.report({'INFO'}, "批量生成完成")
        return {'FINISHED'}

def register():
    bpy.utils.register_class(OBJECT_OT_batch_create)

def unregister():
    bpy.utils.unregister_class(OBJECT_OT_batch_create)

if __name__ == "__main__":
register()bpy.ops 内部包含大量的事件广播和撤销记录开销。如果需要处理包含数万个顶点的复杂网格,直接使用 bpy.data.meshes.new() 和 bmesh 底层模块写入顶点与面数组,速度可提升数十倍至数百倍。
四、Calibre 的全栈实践:Python 与 PyQt 构建复杂富客户端
与 Blender 作为“3D 引擎宿主”不同,Calibre 是一个纯粹由 Python 编写主框架的桌面富客户端软件。自 2006 年由 Kovid Goyal 启动以来,Calibre 的代码量已增长至数十万行。它同时支持 Linux、macOS 与 Windows,涵盖数千种电子书格式的元数据识别、格式转换、DRM 插件拓展、本地图书数据库以及集成 Web 阅读服务器。
1. 界面绘制:为什么 PyQt 依然流畅
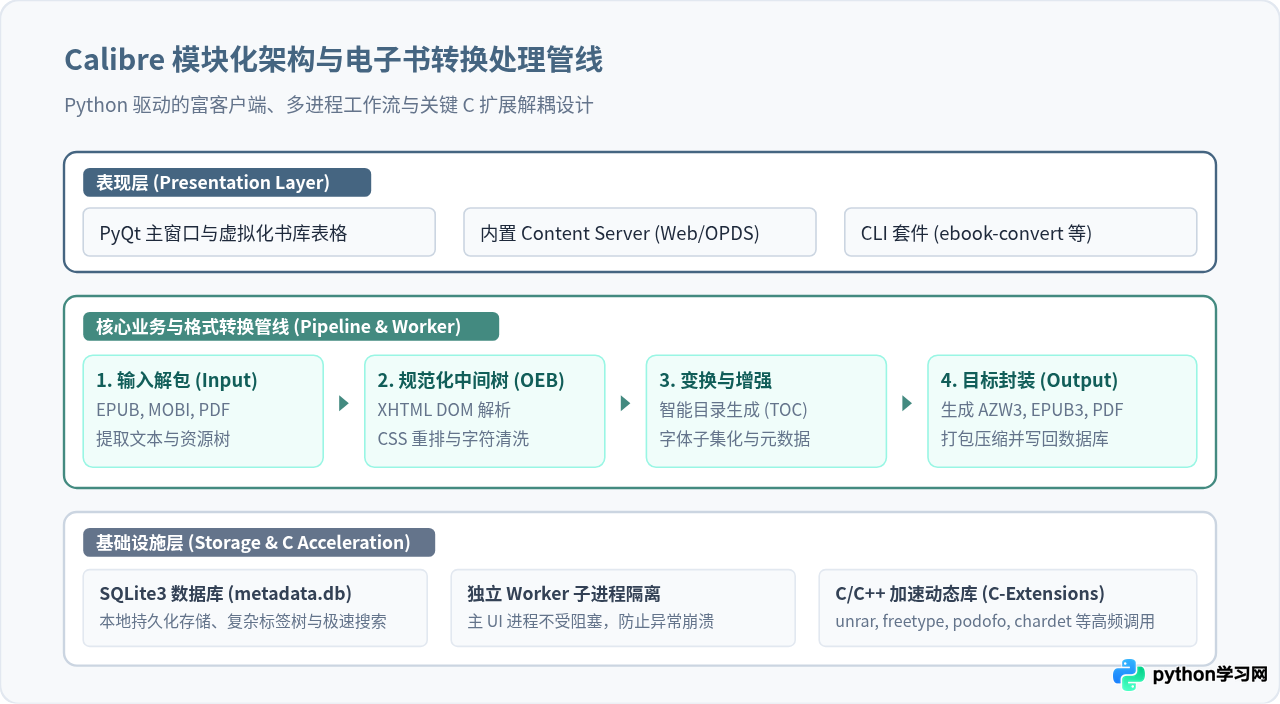
许多人担心 Python 编写 UI 容易出现卡顿或掉帧,但 Calibre 使用了 PyQt(Qt 的 Python 绑定)。在操作系统眼中,Qt 创建的控件与窗口是由底层 C++ 引擎直接调取操作系统原生绘图 API(如 DirectWrite/Direct2D、Cocoa 或 X11/Wayland)进行光栅化与 GPU 渲染的。
Python 在这里主要负责界面组件的布局描述、事件信号槽(Signals & Slots)的连接,以及业务数据的逻辑流转。当用户在包含数万本书籍的表格中高速滚动时,Calibre 采用了 Qt 的 QTableView 与虚拟视图模型(Virtual Model/View Architecture),界面只为可视区域内的几十行数据发起 Python 回调取值,因此滚动体验与纯 C++ 应用毫无差异。
2. 转换管线:统一的内部对象表示
电子书格式极其碎片化,TXT、MOBI、EPUB、CHM、PDF、AZW3 各自遵循完全不同的规范。如果针对每两种格式编写单独的转换器,需要编写成百上千个转换对。
Calibre 在 Python 中设计了一套基于 Open eBook(OEB)标准的通用中间表示层。任何格式的输入文件都先被 Input Plugin 拆解为标准的 HTML/XHTML DOM、CSS 样式表与图片资产包;在管道中间由一系列 Python 过滤器完成文字清洗、章节识别和字体嵌入;最后由 Output Plugin 重新打包成目标格式。这种基于管道过滤器(Pipe-and-Filter)的设计使得新增一种电子书格式时只需提供一个输入或输出插件,极大地降低了系统耦合度。
五、工程挑战:GIL 锁、启动速度与客户端打包分发
不管是 Blender 还是 Calibre,在桌面端采用 Python 都会不可避免地面临三个核心工程挑战:
1. 全局解释器锁(GIL)与长时间计算卡顿
桌面应用最忌讳界面在执行任务时失去响应(例如 Windows 显示“未响应”或 macOS 出现彩球)。
- Calibre 的解决方案:多进程而非多线程。Calibre 并不依赖 Python 原生多线程来执行繁重的格式转换或大量文件的扫描工作,而是通过子进程(
multiprocessing或subprocess)派发独立的 worker 进程。子进程拥有完全独立的 Python 解释器和内存空间,即使转换一本 500MB 的 PDF 导致子进程 CPU 占满或因格式损坏崩溃,主界面所在的 PyQt 进程依然保持 60 帧流畅,并通过进程间通信(IPC / 管道)接收转换进度。 - Blender 的解决方案:下沉到 C/C++ 线程池。对于网格细分、布尔运算、动力学解算等超高负荷操作,Blender 的 Python 算子仅充当配置传递者,实际运算全部下推到底层 C++ 的多线程任务队列(如 Intel TBB 线程池),避开了 GIL 的约束。
2. 启动开销与依赖分发
桌面终端用户不会也不应该通过 pip install 来配置运行环境。两个项目都提供了教科书式的分发方案:
- 完整内嵌独立的 Python 运行环境:Blender 官方发布的安装包中,直接自带了一个经过裁剪的 Python 目录(包含
python.exe/动态链接库与标准库)。它不读取用户操作系统的环境变量PYTHONPATH,避免了与用户本地已安装 Python 版本冲突。 - 单体化打包流水线:Calibre 的构建脚本会先编译专门优化过的 Python 核心,再结合 Qt 的二进制库与所有依赖的 C 扩展,通过定制的打包工具直接生成完全隔离的独立 DMG(macOS)、独立安装包(Windows)或静态 Flatpak/Tarball(Linux)。
六、选型与经验总结:何时在桌面项目中选择 Python
通过审视 Blender 和 Calibre 的实践经验,我们可以得出清晰的架构选型指南:
| 对比维度 | Blender 路线(宿主胶水型) | Calibre 路线(全栈业务型) |
|---|---|---|
| 适用场景 | 3D 建模、音视频非编、科学可视化、机器视觉等重计算软件 | 专业工具、数字资产管理、数据清洗录入、桌面自动化客户端 |
| 主语言占比 | 底层 C/C++ 占约 70%~80%,Python 占约 20%~30% | Python 占约 85% 以上,C/C++ 加速扩展占 15% |
| 界面技术栈 | 自研即时模式 GPU 界面引擎(向 Python 暴露绘制回调) | 成熟的原生跨平台框架(PyQt / PySide) |
| 并发调度 | C/C++ 多线程任务调度器(如 TBB),规避 GIL | 主进程跑 UI,密集运算使用子进程(Worker Process)隔离 |
| 核心收益 | 兼顾极致算力与无限扩展的二次开发社区生态 | 极高的业务功能交付速度与低维护成本 |
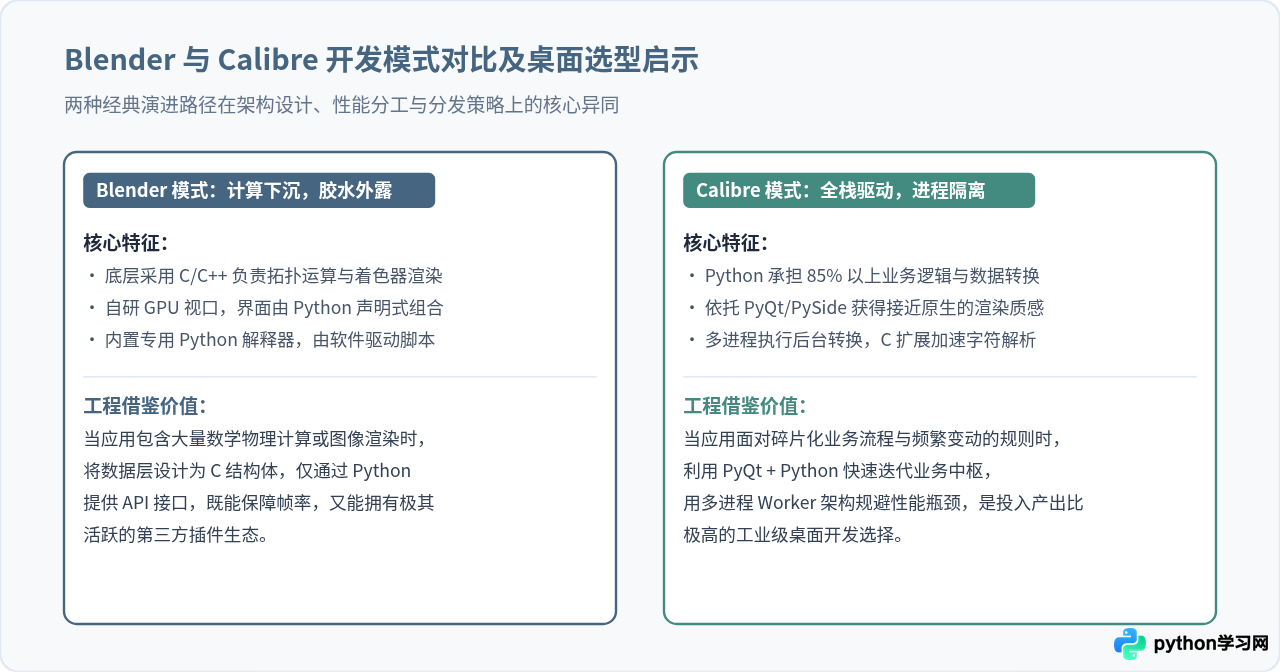
综上所述,Python 完全足以构建世界级的桌面工业软件。关键在于开发者需要摒弃“非黑即白”的纯语言视角:当面对极致算力需求时,参考 Blender 的“计算在底层、交互在上层”;当面对复杂异构的业务流程时,参考 Calibre 的“Qt 绘制外观、Python 调度中枢、多进程护航稳定性”。理解这两种经典架构,不仅能够消除对 Python 桌面性能的误区,也能为新项目的技术选型提供坚实的工程支撑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















