


Python for循环底层原理:迭代器协议与__next__方法
深入解析Python中for循环的底层工作原理,详解可迭代对象与迭代器的区别、迭代器协议的核心方法__iter__与__next__,并通过代码模拟for循环的完整实现机制与实战避坑指南。
在 Python 中,for 循环是我们遍历列表、元组、字典和文件最常用的语法。然而,与 C、Java 等语言中基于下标递增(如 for (int i=0; i<len; i++))的传统计数循环不同,Python 的 for 循环完全建立在迭代器协议(Iterator Protocol)之上。无论是遍历有限的列表,还是读取无限的数据流,Python 统一依靠 iter() 获取迭代器并反复调用 __next__() 方法按需拉取数据,直至捕获 StopIteration 异常安全退出。本文将带你从底层运行机制出发,拆解这一协议的具体运作细节。
一、for循环的底层运行机制
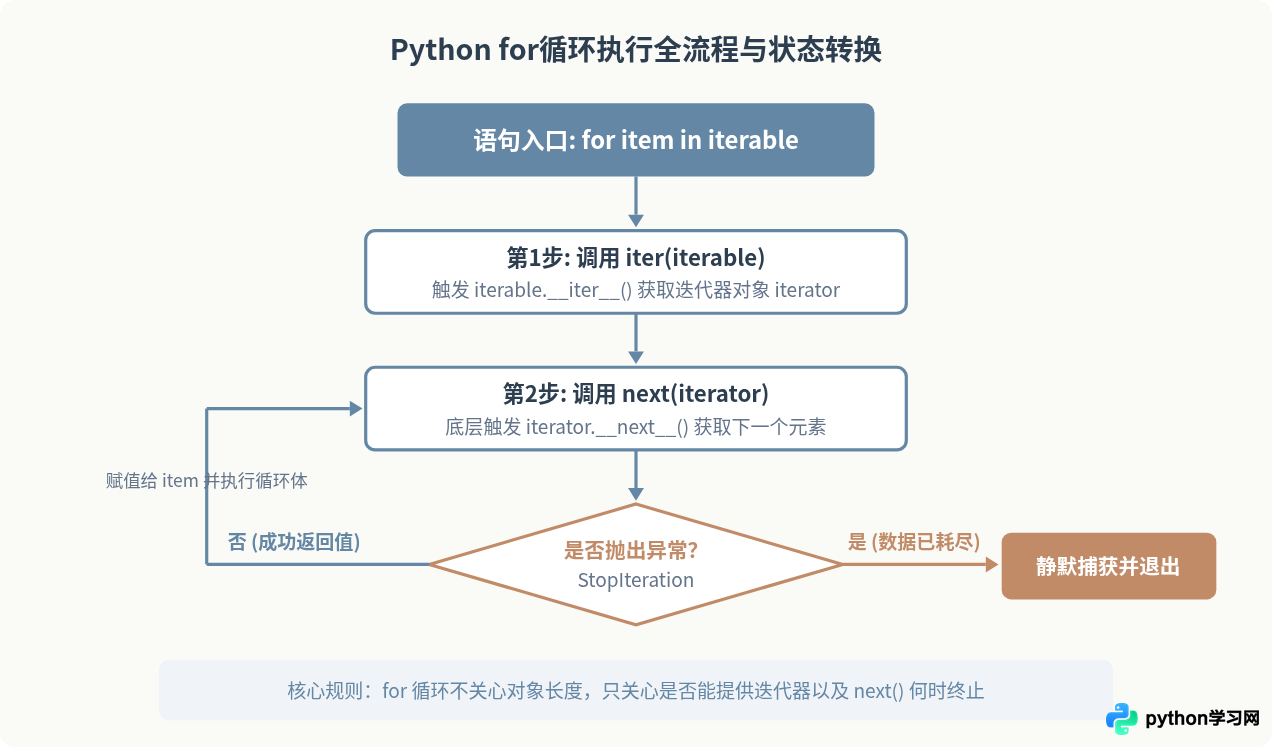
当我们写下一句看似简单的 for item in iterable: 语句时,Python 解释器在虚拟机层面并不是做索引计数,而是默默执行了一套标准的三步状态机流程:
- 获取迭代器:解释器首先调用内置函数
iter(iterable),该函数会在底层触发调用目标对象的__iter__()方法,获取一个专门负责遍历的迭代器对象。 - 拉取元素:在进入循环体后,解释器反复调用
next(iterator),底层触发迭代器对象的__next__()方法,每次取出下一个元素并赋值给循环变量item,随后执行循环体代码。 - 终止退出:当数据已被取尽时,
__next__()方法会主动抛出StopIteration异常。Python 的for循环会自动拦截该异常并优雅退出,整个过程对开发者完全透明,不会对外抛出错误。
代码级等价模拟:用 while 还原 for 循环
为了直观感受这个过程,我们可以用 while 循环、iter()、next() 和异常捕获完全重写一段等价的 for 循环逻辑:
# 传统的 for 循环写法
numbers = [10, 20, 30]
for num in numbers:
    print(num)

# 底层等价的 while 循环模拟
iterator = iter(numbers)  # 等价于 numbers.__iter__()
while True:
    try:
        num = next(iterator)  # 等价于 iterator.__next__()
        print(num)
    except StopIteration:
        # 捕获迭代结束异常,跳出循环
        break
运行上述两段代码,输出结果完全一致。Python 解释器正是通过这一套标准规范,实现了对序列、映射、集合乃至生成器等所有容器结构的统一遍历。
二、核心概念辨析:可迭代对象与迭代器
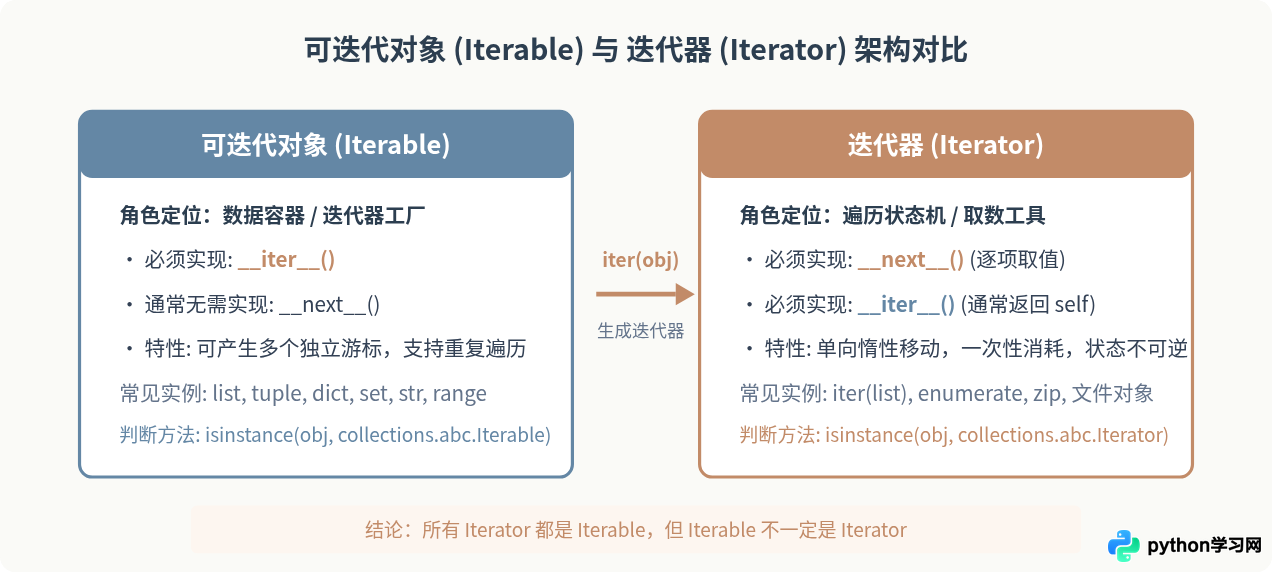
在理解 __next__ 方法前,必须先厘清两个经常被初学者混淆的概念:可迭代对象(Iterable)与迭代器(Iterator)。
从 Python 的面向对象角度看:
- 可迭代对象(Iterable):只要一个类定义了
__iter__()方法(或者在早期协议中定义了支持下标从 0 开始的__getitem__()方法),它就是一个可迭代对象。列表[1, 2, 3]本身只存数据,它没有当前游标位置,因此没有__next__()方法。 - 迭代器(Iterator):必须同时实现
__iter__()和__next__()两个方法。迭代器内部维护了一个游标状态,记录当前取到了哪一步。
为什么迭代器自己还要实现 __iter__()?
因为这样可以保证迭代器本身也是一个合法的可迭代对象,从而可以直接传给 for 循环或任何接收可迭代对象的函数(如 sum()、min())。迭代器的 __iter__() 方法通常极其简单,只包含一句 return self。
三、深入剖析 __next__ 方法的执行流程
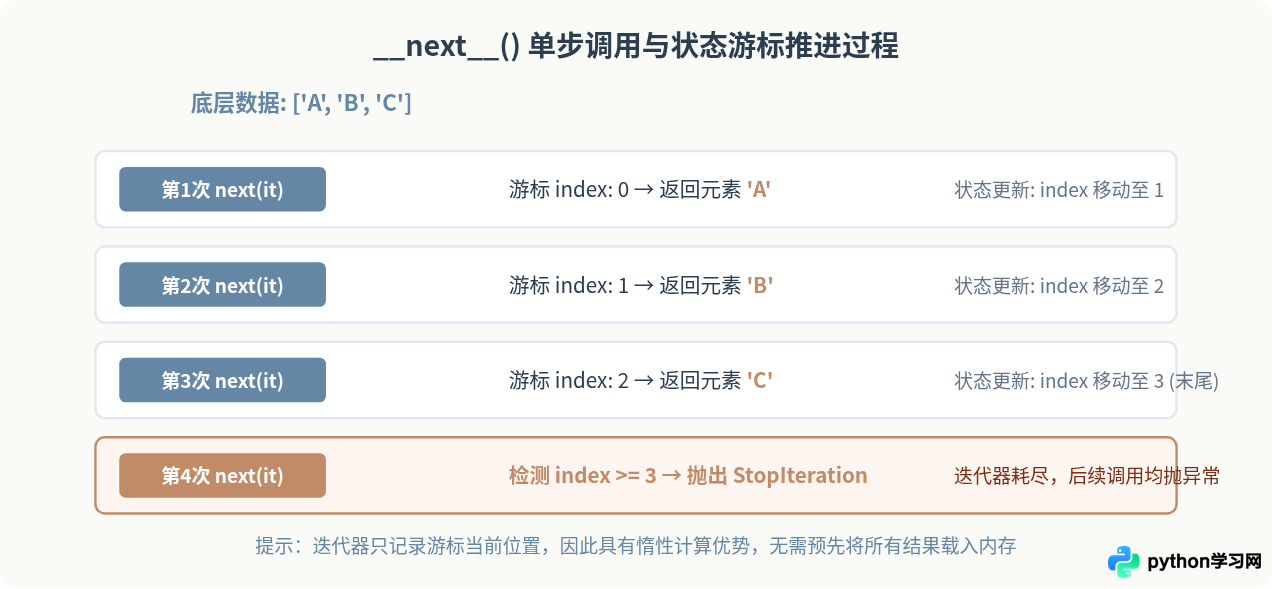
__next__() 是整个迭代器协议中最关键的执行单元。每一次调用该方法,迭代器内部都会发生两件事:
- 根据内部维护的游标状态,计算并返回序列中的下一个元素;
- 推进内部游标。若游标已越界或没有更多可用数据,立即抛出
StopIteration。
为什么必须抛出 StopIteration,而不是返回 None?
这是一个极具设计考量的细节。如果协议规定“没有元素时返回 None”,那么当容器本身就包含 None(例如 [1, None, 2])时,循环就无法区分到底是一个普通的有效元素还是结束标志。而通过独立的异常类型 StopIteration,Python 彻底将“正常返回值”与“控制流终止信号”区分开来,支持安全遍历任意内容的数据序列。
四、手写实战:实现自定义的可迭代对象与迭代器
为了深刻掌握这一原理,我们完全脱离内置列表,亲手编写一个符合迭代器协议的倒计时计数器:
class CountdownIterator:
    """独立的迭代器类:维护遍历状态"""
    def __init__(self, start):
        self.current = start

    def __iter__(self):
        # 迭代器协议规定:__iter__ 返回迭代器自身
        return self

    def __next__(self):
        # 核心方法:返回值并推进状态
        if self.current <= 0:
            raise StopIteration
        val = self.current
        self.current -= 1
        return val


class Countdown:
    """可迭代容器类:每次生成新的迭代器实例"""
    def __init__(self, start):
        self.start = start

    def __iter__(self):
        # 每次被 iter() 调用时,返回一个全新的迭代器
        return CountdownIterator(self.start)
现在,我们用 for 循环测试自定义的类:
# 实例化可迭代对象
cd = Countdown(3)

print("第一轮遍历:")
for x in cd:
    print(x)

print("第二轮遍历:")
for x in cd:
    print(x)
运行结果输出:
第一轮遍历:
3
2
1
第二轮遍历:
3
2
1
正因为 Countdown 作为可迭代容器,在每次循环时其 __iter__() 方法都会创建一个全新的 CountdownIterator 实例,所以它支持多次独立重复遍历。如果直接将 CountdownIterator 传给 for 循环,由于它本身状态会被递减耗尽,第二轮循环将直接退出。
五、核心机制全景与高频避坑指南
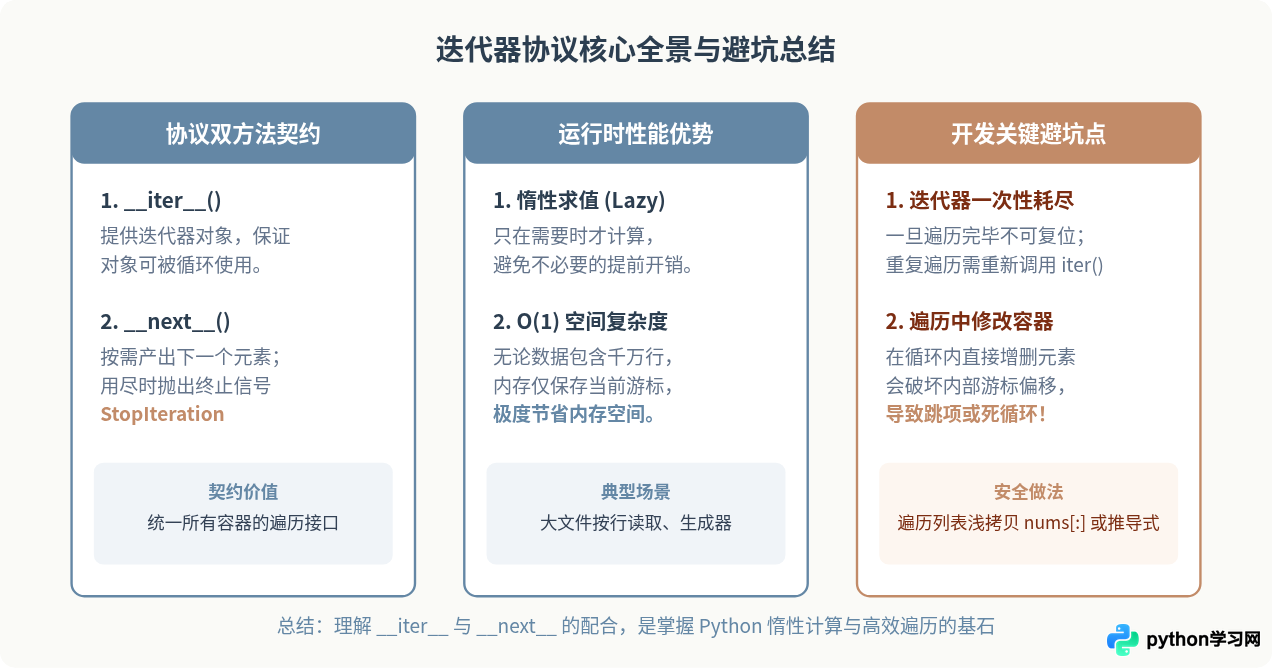
高频避坑清单
避坑 1:迭代器只能向前,无法回头
生成器对象、zip、map、filter 和文件对象等都是迭代器。一旦遍历结束,迭代器就处于耗尽(Exhausted)状态。再次对它执行 for 循环将不会产生任何输出。若需要多次使用,请将其转换为 list 保存,或每次重新生成迭代器。
避坑 2:禁止在遍历列表时直接删除元素
for 循环依赖迭代器内部递增的索引偏移。如果在循环体内执行 list.remove() 或 del,后续元素会向前移动填补空位,导致迭代器下一次移动指针时恰好漏掉紧随其后的元素。推荐做法是遍历原列表的浅拷贝 for item in my_list[:]:,或直接使用列表推导式生成新列表。
结语
Python 的 for 循环表面上简洁优雅,其本质是对迭代器协议的封装。它通过 iter() 获取迭代器、通过 __next__() 推进游标并按需获取元素、通过 StopIteration 优雅终止循环。正是这一套统一而规范的协议,赋予了 Python 强大的惰性求值能力与灵活的流式处理支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















