


推荐5个适合练手的Python机器学习开源项目与数据集
精选5个适合初学者与进阶者练手的Python机器学习开源项目及配套数据集,涵盖表格回归、不平衡分类、计算机视觉迁移学习、自然语言处理微调与时间序列预测,提供完整代码示例与避坑指南。
许多学习者在入门机器学习时,常陷入两个极端:要么仅停留在几行玩具代码上跑预置数据,对真实工程中的特征工程与评估验证毫无概念;要么一开始就尝试下载几十GB的未清洗原始数据或复杂的庞大模型,因算力受限与环境报错而半途而废。适合练手的优质项目,核心在于“业务边界明确、数据规模可控、验证指标可量化,并能完整跑通从数据到产出的闭环”。本文梳理出5个具有代表性的经典Python开源练手项目及其对应数据集,覆盖数值回归、分类预测、计算机视觉、自然语言处理与时间序列预测五大核心方向,帮助你在本地轻量环境下建立起系统、稳健的机器学习工程思维。
一、机器学习练手闭环:标准实战流程
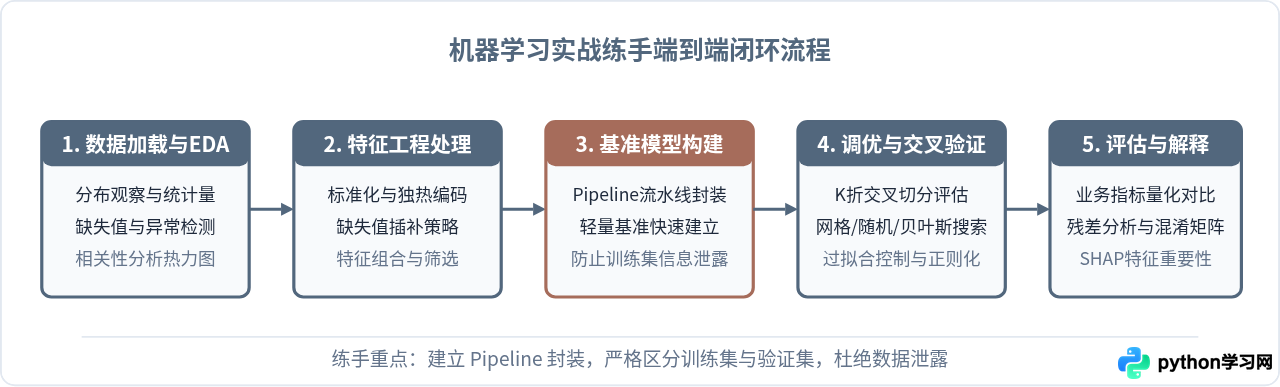
任何一个机器学习练手项目,其价值不仅在于调用了某个模型的 fit() 方法,更在于体验并掌握标准流程中的每个环节。规范的流程通常包括数据探索分析(EDA)、特征工程清洗、基准模型建立、交叉验证与超参数优化,最后进行多维度的测试评估与特征解释。
二、推荐的5个开源练手项目与数据集
1. 基于 Scikit-Learn 的加州房价预测与特征工程流水线
核心对象与目标:连续数值型回归分析,掌握数据缩放、缺失值处理、Pipeline 流水线构建及跨验证评估。
推荐数据集:California Housing Dataset(加州房价数据集,内建于 Scikit-Learn,包含20640条区块样本及8个数值特征)。
加州房价数据集是替代旧版波士顿房价数据集的官方标准推荐。数据规模适中,特征包含经纬度、房龄中位数、街区平均收入、房间数等。在此项目中,核心在于不要“裸跑”线性回归,而是练习使用 sklearn.pipeline.Pipeline 和 sklearn.compose.ColumnTransformer,确保在交叉验证的每一折中,均值与方差缩放器均严格仅基于训练折拟合,从而杜绝数据泄露。
import numpy as np
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split, KFold, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import root_mean_squared_error

# 1. 加载加州房价数据
housing = fetch_california_housing(as_frame=True)
X, y = housing.data, housing.target

# 2. 划分测试集(保持测试集绝对独立)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. 构建规范的特征工程流水线
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('regressor', RandomForestRegressor(n_estimators=100, max_depth=12, random_state=42))
])

# 4. 交叉验证评估基准性能
cv = KFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipeline, X_train, y_train, cv=cv, scoring='neg_root_mean_squared_error')
print(f"5折交叉验证 RMSE 平均值: {-scores.mean():.4f}")

# 5. 全训练集拟合并在测试集检验
pipeline.fit(X_train, y_train)
test_preds = pipeline.predict(X_test)
print(f"独立测试集 RMSE: {root_mean_squared_error(y_test, test_preds):.4f}")
2. 基于 LightGBM 的金融信用违约风险预测
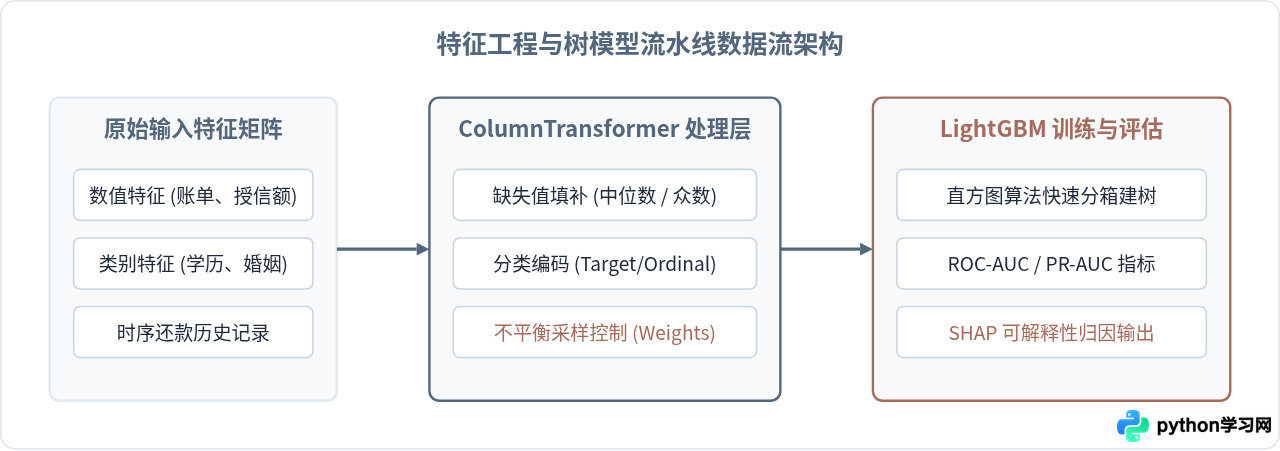
核心对象与目标:高维混合类型数据的二分类预测,掌握类别特征编码、样本不平衡处理及基于树模型的特征重要性分析。
推荐数据集:German Credit Data 或 Kaggle / UCI 信用卡违约数据集(Default of Credit Card Clients Dataset,约3万条金融交易与还款记录)。
在真实的业务建模中,表格数据绝大多数伴随着类别变量(Categorical Features)与正负样本不平衡(正常客户远多于违约客户)。LightGBM 是目前工业界表格建模最常用的梯度提升树库之一。在该项目中,读者应重点掌握如何配置 class_weight='balanced' 或 scale_pos_weight,并使用准确率之外的指标(如 ROC-AUC、PR-AUC)来评估模型效果。
import lightgbm as lgb
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_auc_score, classification_report
import pandas as pd

# 示例:构建轻量违约预测模型
# 假设 X 为特征工程处理后的 DataFrame,y 为 0/1 违约标记
X_train, X_val, y_train, y_val = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

# 针对正负样本不平衡(如负正比9:1),设置 is_unbalance 或 scale_pos_weight
model = lgb.LGBMClassifier(
    n_estimators=300,
    learning_rate=0.05,
    num_leaves=31,
    scale_pos_weight=9.0,
    random_state=42
)

model.fit(
    X_train, y_train,
    eval_set=[(X_val, y_val)],
    callbacks=[lgb.early_stopping(stopping_rounds=30, verbose=False)]
)

val_probs = model.predict_proba(X_val)[:, 1]
print(f"验证集 ROC-AUC 分数: {roc_auc_score(y_val, val_probs):.4f}")
3. 基于 PyTorch 与 torchvision 的 CIFAR-10 图像分类与迁移学习
核心对象与目标:计算机视觉基础任务,理解 DataLoader 数据增强流水线、卷积神经网络(CNN)与轻量主干网络微调。
推荐数据集:CIFAR-10 数据集(包含10个类别的60000张 32x32 彩色图像,内置于 torchvision.datasets)。
MNIST 过于简单,无法充分暴露过拟合和卷积感受野问题;而 ImageNet 数据体量过大,难以在个人电脑上快速迭代。CIFAR-10 恰好处于平衡点。完成该项目时,建议分两步走:先手动搭建一个3层的基础 CNN 网络体验前向传播与反向传播计算;再利用 torchvision.models.mobilenet_v2(pretrained=True),替换最后的全连接层进行迁移微调,直观对比预训练权重带来的收敛速度与准确率优势。
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms

# 1. 规范的图像预处理与增强
transform_train = transforms.Compose([
    transforms.RandomCrop(32, padding=4),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010)),
])

trainset = torchvision.datasets.CIFAR10(root='./data', train=True, download=True, transform=transform_train)
trainloader = torch.utils.data.DataLoader(trainset, batch_size=64, shuffle=True, num_workers=2)

# 2. 迁移学习:加载轻量骨干网络并替换输出分类头
model = torchvision.models.mobilenet_v2(weights=torchvision.models.MobileNet_V2_Weights.DEFAULT)
# 冻结浅层特征提取器
for param in model.features.parameters():
    param.requires_grad = False

# 替换分类头为 10 分类输出
model.classifier[1] = nn.Linear(model.last_channel, 10)

criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.classifier.parameters(), lr=1e-3)
print("模型构建完成,分类头待训练参数量:", sum(p.numel() for p in model.classifier.parameters() if p.requires_grad))
4. 基于 Hugging Face Transformers 的 IMDb 文本情感分析与微调
核心对象与目标:自然语言处理序列分类,掌握 Tokenizer 分词、掩码张量生成及轻量预训练语言模型(如 DistilBERT)的下游微调。
推荐数据集:Large Movie Review Dataset (IMDb 数据集,包含正负情感各25000条电影评论文本)。
NLP 已全面进入 Transformer 与预训练微调范式。利用 Hugging Face 提供的生态(transformers 与 datasets 库),读者可以摆脱繁琐的字符索引映射与循环神经网络调试。通过此项目,你将理解注意力机制模型如何处理截断(truncation)、填充(padding),以及如何利用较小显存(甚至 CPU / 免费 Colab)完成一个高精度的文本情感分类器。
from transformers import AutoTokenizer, AutoModelForSequenceClassification, Trainer, TrainingArguments
from datasets import load_dataset

# 1. 加载数据集与分词器
dataset = load_dataset("imdb", split="train[:2000]")  # 取轻量子集快速练手
tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased")

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True, max_length=128)

tokenized_dataset = dataset.map(tokenize_function, batched=True)

# 2. 加载预训练模型
model = AutoModelForSequenceClassification.from_pretrained("distilbert-base-uncased", num_labels=2)

# 3. 训练参数配置
training_args = TrainingArguments(
    output_dir="./results",
    learning_rate=2e-5,
    per_device_train_batch_size=16,
    num_train_epochs=1,
    weight_decay=0.01,
    logging_steps=50,
)
print("Hugging Face 微调环境准备就绪,包含注意力头数:", model.config.num_attention_heads)
5. 基于 Prophet / Statsmodels 的门店销售时间序列预测
核心对象与目标:时间序列分析与预测,掌握序列平稳性检验、趋势项、周期性(周/月/年)及节假日冲击效应建模。
推荐数据集:Rossmann Store Sales 数据集(包含上千家药店的多年度每日销售额、促销及节假日标注)。
时间序列问题与普通的横截面表格数据有着本质区别:绝不能使用随机打乱(shuffle)的交叉验证,否则会利用未来信息预测过去,导致极具误导性的超高评分。Meta 开源的 Prophet 库将时序分解为可解释的趋势分量、季节分量与节假日影响。练手该项目能让读者深刻理解“滚动时间窗口验证(Time Series Split)”与业务因果约束。
from prophet import Prophet
import pandas as pd

# 数据需格式化为包含 'ds' (日期时间) 和 'y' (预测数值) 的 DataFrame
df_sample = pd.DataFrame({
    'ds': pd.date_range(start='2022-01-01', periods=180, freq='D'),
    'y': [100 + i*0.5 + (i%7)*5 for i in range(180)]
})

# 实例化模型并添加显式季节性
model = Prophet(yearly_seasonality=False, weekly_seasonality=True, daily_seasonality=False)
model.fit(df_sample)

# 生成未来30天日期框架并进行外推预测
future = model.make_future_dataframe(periods=30)
forecast = model.predict(future)

print(forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tail())
三、适合新手的梯度递进学习路径
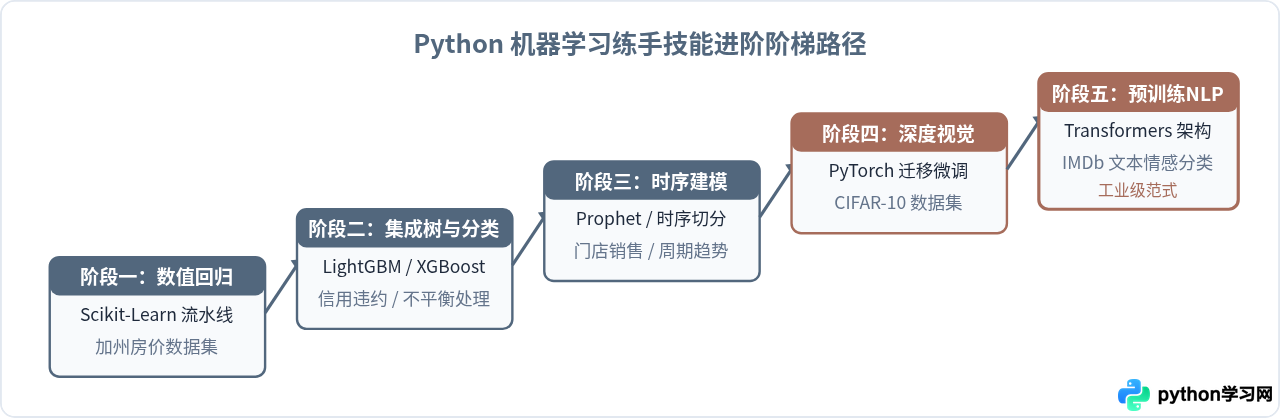
面对不同的领域与技术栈,盲目乱试容易浪费精力。合理的推进节奏是按照“数据类型复杂度”与“工程算力门槛”逐步升级。从结构化数值表格入手扎实基本功,再拓展到非平衡树模型,进而深入神经网络与序列建模。
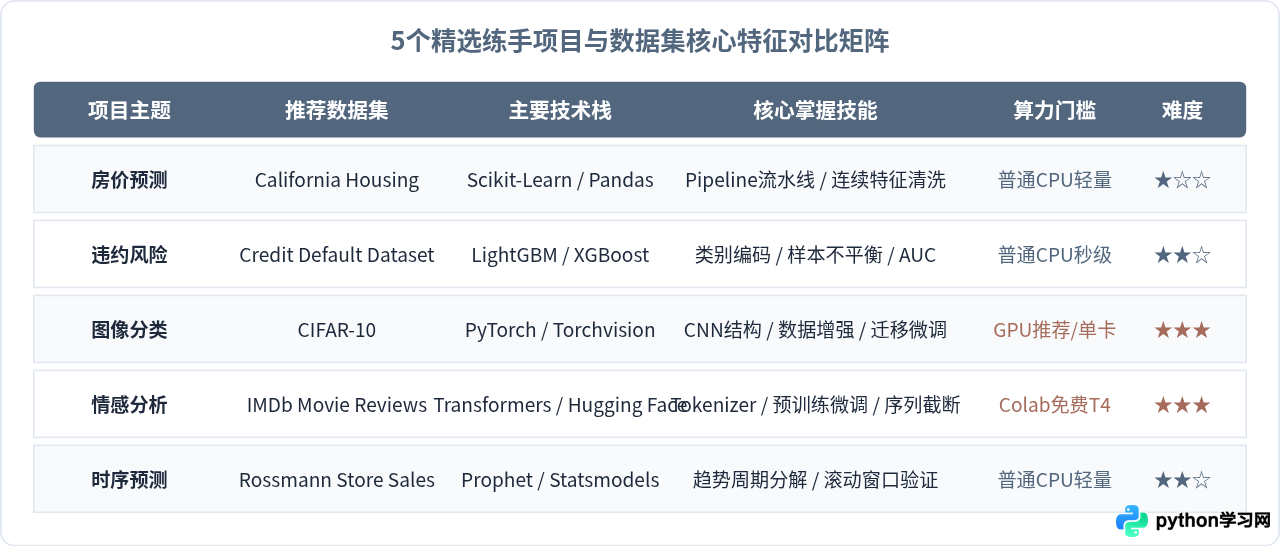
四、5个开源项目与数据集综合维度对比
为了帮助你在不同学习阶段做出最适合的练手选择,下表将上述5个项目的核心维度、算力需求及适合训练的核心能力进行集中梳理:
五、实战注意事项与常见问题排查
- 严防数据穿越(Data Leakage):标准化缩放参数(如
mean_和scale_)与分箱阈值必须且只能基于训练集计算,再通过transform()映射到测试集。坚决避免在全局数据集上调用fit_transform()后再划分训练集和测试集。 - 指标匹配业务真实场景:分类任务中,当负正样本比例超过 5:1 时,准确率(Accuracy)将丧失评估意义。此时必须使用 Precision、Recall、F1-Score 或 PR-AUC(PR曲线下面积)评估对少数类的捕获能力。
- 深度学习显存控制(OOM 排查):在运行 PyTorch 或 Hugging Face 项目时,如果出现
CUDA out of memory,应优先将batch_size减半(如从 64 降至 32 或 16),并使用梯度累积(Gradient Accumulation)维持有效批大小;在评估环节务必包裹with torch.no_grad():以释放计算图显存。 - 时间序列坚决禁用 Shuffle:时间序列模型应采用
sklearn.model_selection.TimeSeriesSplit进行扩展窗口验证,避免将未来的趋势变化泄露给过去的模型输入。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















