


除了写网站,Python还能在金融量化交易中做什么
深入解析Python在金融量化交易中的核心应用场景,涵盖数据采集清洗、因子策略建模、历史回测归因与自动化实盘执行的全流程技术与实践。
很多开发者初识 Python 是从 Django、FastAPI 等 Web 框架或爬虫脚本开始的。然而在金融工程与投资领域,Python 早已不再是辅助性的胶水语言,而是整套量化交易体系的核心研发引擎。从高频行情数据的标准化清洗、海量因子的数学建模,到高保真历史回测评估,乃至对接交易所 API 进行毫秒级自动化报单与风控熔断,Python 覆盖了量化交易全生命周期的每一个环节。
一、全景透视:Python 在量化体系中的分层定位
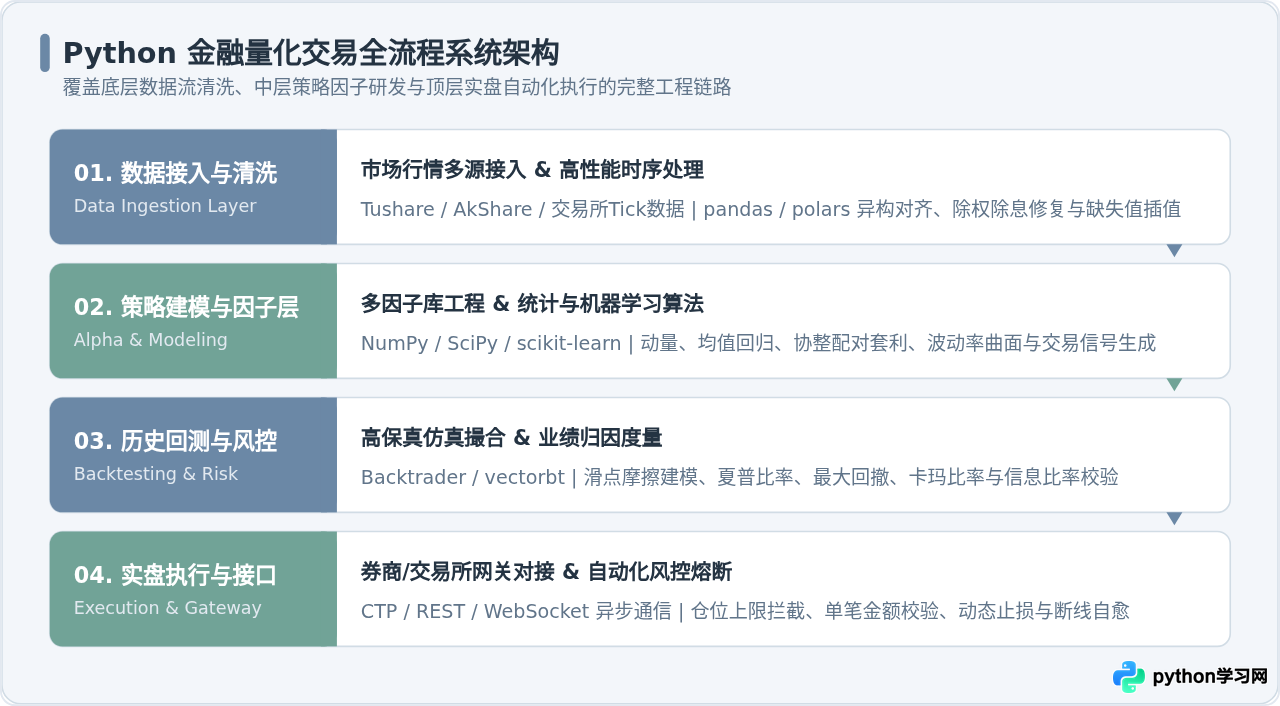
量化交易本质上是将交易假设转化为严谨的数学模型,并在真实市场数据中验证与执行的过程。一个现代量化交易系统通常划分为四个关键层级:数据层、策略与因子层、回测与风控层,以及实盘执行层。Python 凭借其成熟的科学计算生态(NumPy、pandas、SciPy)与专有量化框架,在这四个层级中均承担着中枢调度与核心计算的职责。
二、金融数据的标准化采集与清洗
金融领域的原始数据通常具有极高的异构性,包含行情K线、逐笔成交流(Tick)、期权隐含波动率曲面以及非结构化的上市公司财务报告。Python 在数据处理阶段的核心任务,是建立可靠的清洗管道,消除数据中的杂音与逻辑漏洞。
在日常量化工作中,Python 主要处理以下三类典型数据问题:
- 时序对齐与时间戳规整:不同交易所的开闭市时间和撮合频率不同。Python 可利用 pandas 的重采样(
resample)和向后填充机制,将不同维度的交易对数据对齐到同一时间基准。 - 除权除息与复权计算:股票分红和送配股会导致价格产生跳空断层。量化分析中必须使用前复权(Forward Adjusted)或后复权价格,以真实反映资产收益率,避免误触发虚假交易信号。
- 异常值过滤与缺失填充:包括涨跌停板流动性缺失、临时停牌期处理以及订单薄交叉错位清洗。
以下示例展示了使用 Python 的 pandas 库完成多只标的价格对齐与收益率对数化处理的标准步骤:
import pandas as pd
import numpy as np

def prepare_quant_dataset(raw_dfs: dict[str, pd.DataFrame]) -> pd.DataFrame:
    """
    对齐多标的收盘价并计算对数收益率
    raw_dfs: 格式为 {"标的代码": DataFrame(含 timestamp, close)}
    """
    close_dict = {}
    for symbol, df in raw_dfs.items():
        # 确保时间戳为索引且时区统一
        df['timestamp'] = pd.to_datetime(df['timestamp'])
        df = df.set_index('timestamp').sort_index()
        close_dict[symbol] = df['close']

    # 1. 宽表合并并按统一交易日历对齐
    price_matrix = pd.DataFrame(close_dict)

    # 2. 前向填充停牌缺失值(假定维持停牌前价格),丢弃无交易历史的初始期
    aligned_prices = price_matrix.ffill().dropna()

    # 3. 计算对数收益率:r_t = ln(P_t / P_{t-1})
    log_returns = np.log(aligned_prices / aligned_prices.shift(1)).dropna()

    return log_returns
三、量化策略建模与因子挖掘
当数据准备就绪后,量化研究员的核心工作是构建能够产生超额收益(Alpha)的策略模型。Python 在这一阶段扮演着“数学与逻辑实验室”的角色。
1. 动量与趋势跟踪
基于移动平均线(SMA/EMA)、MACD、布林带(Bollinger Bands)等技术指标捕捉资产价格的惯性运动。Python 的 TA-Lib 库提供底层 C 语言加速,能够瞬间完成数百万行 K 线的指标矩阵计算。
2. 均值回归与统计套利
寻找历史走势高度相关的两种资产(如原油与燃油期货、同一行业的龙头公司A股与H股)。通过 Python 的 statsmodels 进行协整检验(Cointegration Test)。当二者价差偏离历史均值超过设定的置信区间时,买入被低估资产、做空被高估资产,等待价差回归均值获利。
3. 机器学习多因子选股
结合公司基本面财务指标(市盈率、ROE)、量价微观结构(资金流向、波动率因子),利用 scikit-learn 或 LightGBM 训练非线性分类或回归模型,为全市场标的打分排序,构建动态调整的多头投资组合。
四、历史回测与风险归因分析
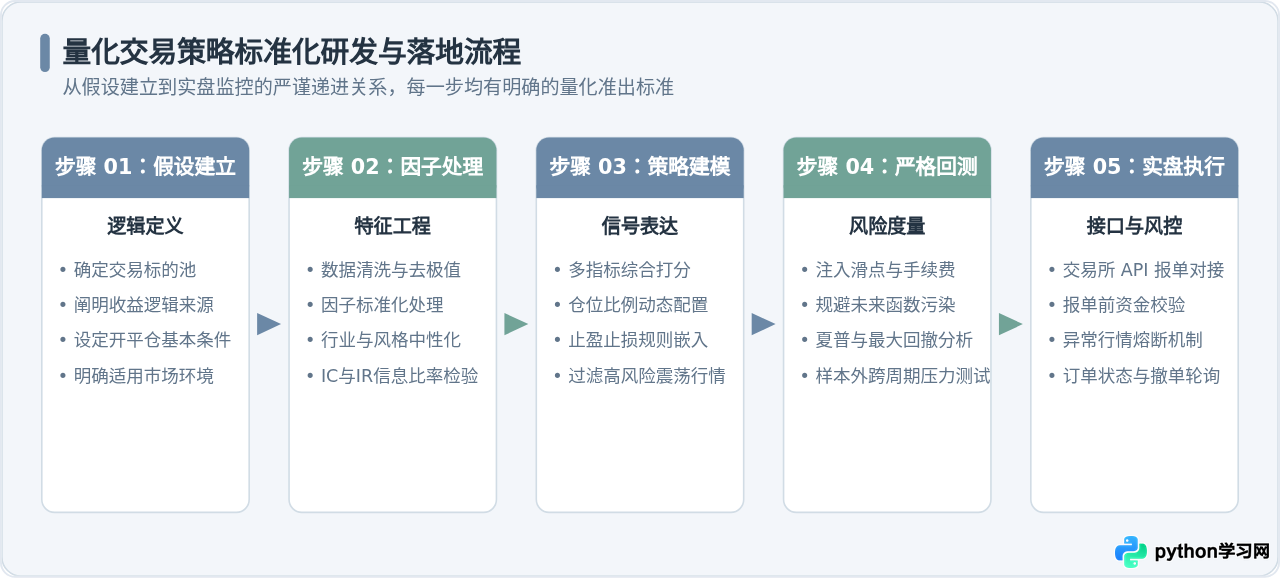
编写策略逻辑往往只需要几十行代码,但验证策略是否具备真实盈利能力则需要庞大的回测系统。很多初学者写出的“高收益”策略在实盘中迅速失效,根本原因在于回测中存在致命的未来函数陷阱(使用了尚未发生的未来收盘价做决策)或忽视交易摩擦成本。
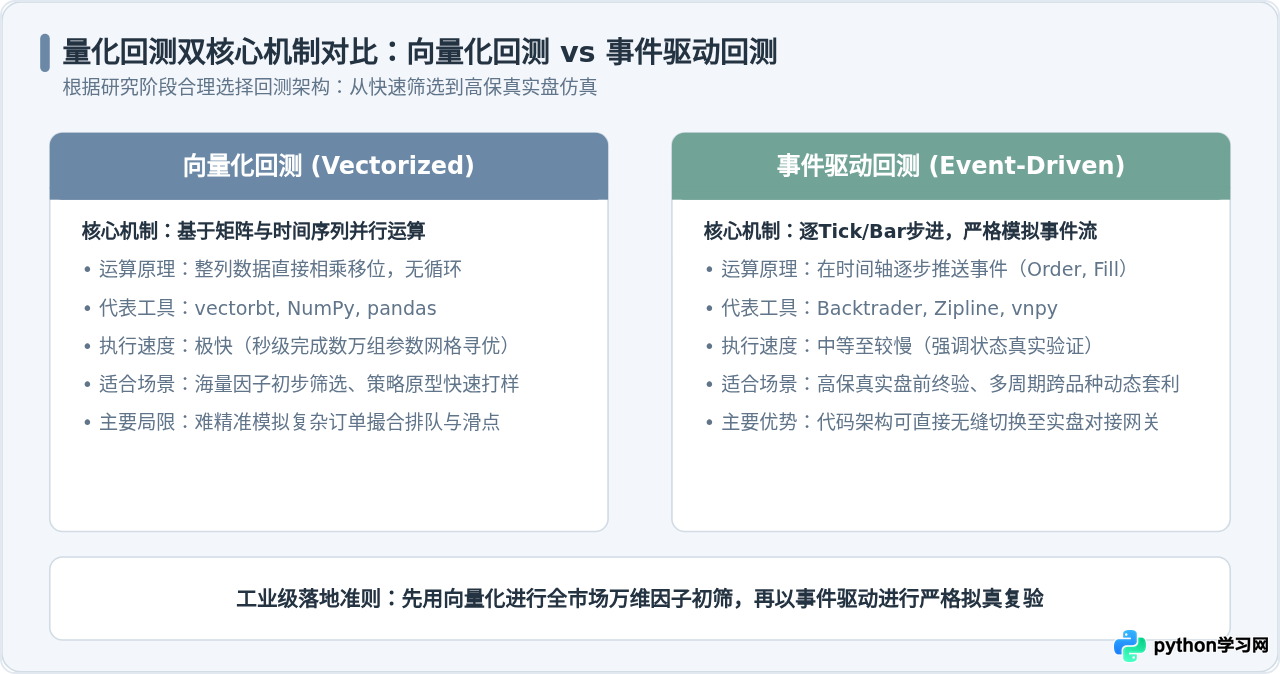
在 Python 生态中,回测技术主要分为两大体系,各自承担不同研究阶段的任务:
为了科学评价策略表现,Python 代码通常会计算一组标准化的风险与收益指标:
| 指标名称 | 计算含义 | 量化参考门槛 |
|---|---|---|
| 年化收益率 (CAGR) | 几何平均复合年化投资回报率 | 需显著超越无风险基准与指数Beta |
| 夏普比率 (Sharpe Ratio) | 每承担一单位总波动所获得的超额回报:(Rp - Rf) / σp | 通常要求 > 1.5,优秀策略通常 > 2.0 |
| 最大回撤 (Max Drawdown) | 资产净值从历史最高峰值到最低谷底的最大跌幅百分比 | 稳健型策略一般严格控制在 10%~15% 以内 |
| 卡玛比率 (Calmar Ratio) | 年化收益率与历史最大回撤的比值:CAGR / |MaxDD| | 比值 > 2.0 代表每承受 1% 回撤能带来 2% 以上年化收益 |
通过 Python 计算夏普比率与最大回撤的典型代码如下:
import numpy as np
import pandas as pd

def calculate_performance_metrics(daily_returns: pd.Series, risk_free_rate: float = 0.02) -> dict:
    """
    计算策略核心风险绩效指标
    daily_returns: 策略每日收益率时序(小数形式)
    risk_free_rate: 年化无风险利率(如 2%)
    """
    trading_days = 252

    # 1. 累计净值曲线
    equity_curve = (1 + daily_returns).cumprod()

    # 2. 年化收益率
    total_return = equity_curve.iloc[-1] - 1
    num_years = len(daily_returns) / trading_days
    cagr = (1 + total_return) ** (1 / num_years) - 1

    # 3. 年化波动率与夏普比率
    ann_volatility = daily_returns.std() * np.sqrt(trading_days)
    sharpe_ratio = (cagr - risk_free_rate) / ann_volatility if ann_volatility != 0 else 0

    # 4. 最大回撤计算 (历史高点滚动最大值与当前净值对比)
    peak = equity_curve.cummax()
    drawdown = (equity_curve - peak) / peak
    max_drawdown = drawdown.min()

    # 5. 卡玛比率
    calmar_ratio = cagr / abs(max_drawdown) if max_drawdown != 0 else 0

    return {
        "CAGR": f"{cagr * 100:.2f}%",
        "Annual_Volatility": f"{ann_volatility * 100:.2f}%",
        "Sharpe_Ratio": round(sharpe_ratio, 2),
        "Max_Drawdown": f"{max_drawdown * 100:.2f}%",
        "Calmar_Ratio": round(calmar_ratio, 2)
    }
五、自动化交易执行与风控熔断机制
回测优秀的策略如果停留在 Jupyter Notebook 里,就只是理论研究。在真实生产环境中,Python 作为实盘执行系统的中控台,通过券商的 CTP 接口、数字资产交易所的 WebSocket / REST 接口,实现 7x24 小时无人值守的自动化交易。
自动化交易系统中最关键的不是“如何开仓”,而是“如何安全地避免系统失控”。一个合格的 Python 自动化交易脚本必须包含完整的报单前校验(Pre-trade Risk Check)机制:
实盘硬性准则:永远不要把策略模型直接连接到下单函数。所有交易信号在到达底层网关前,必须穿过统一的“风控拦截管道”,校验可用资金、单笔最大手数、当日累计亏损上限以及价格偏离度。
class RiskController:
    """实盘交易前置风控拦截器"""
    def __init__(self, max_order_value: float, max_daily_loss_pct: float, initial_balance: float):
        self.max_order_value = max_order_value
        self.max_daily_loss_pct = max_daily_loss_pct
        self.initial_balance = initial_balance
        self.current_balance = initial_balance

    def validate_order(self, symbol: str, price: float, quantity: int, current_balance: float) -> bool:
        self.current_balance = current_balance
        order_value = price * quantity

        # 1. 单笔金额上限校验
        if order_value > self.max_order_value:
            print(f"[风控拒绝] 标的 {symbol} 订单金额 {order_value} 超出单笔上限 {self.max_order_value}")
            return False

        # 2. 账户可用资金覆盖校验
        if order_value > self.current_balance:
            print(f"[风控拒绝] 可用资金不足:需 {order_value},当前 {self.current_balance}")
            return False

        # 3. 当日最大亏损动态熔断
        drawdown_pct = (self.initial_balance - self.current_balance) / self.initial_balance
        if drawdown_pct >= self.max_daily_loss_pct:
            print(f"[风控熔断] 当日亏损达 {drawdown_pct*100:.2f}%,触发全局止损,禁止新开仓!")
            return False

        return True
六、能力进阶全景与实践总结
从单纯的 Web 开发走向金融量化,Python 的核心优势不仅在于语言本身的简明,更在于它打通了“科研探索”与“工业工程”之间的鸿沟。掌握 Python 在量化交易中的应用,需要建立起从数据工程、数理统计到系统风控的复合能力矩阵。
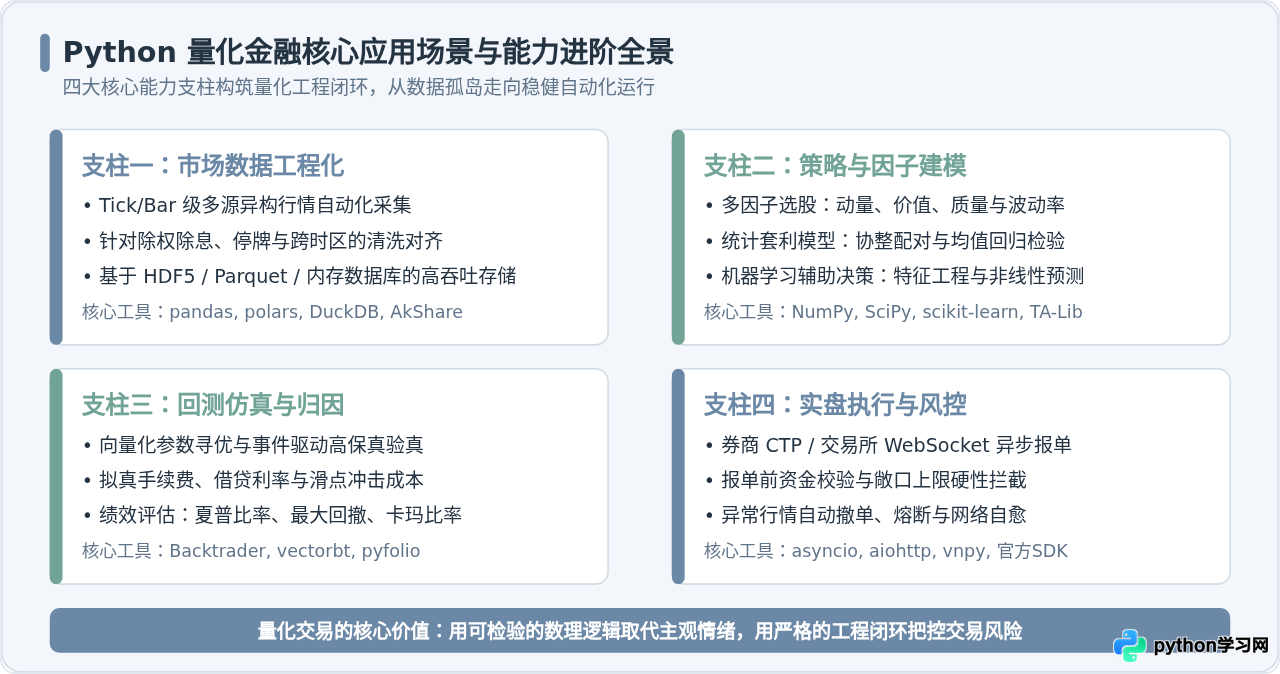
综上所述,Python 在金融量化交易中的角色绝非简单的脚本工具。它向上连接抽象的金融数学假说与机器学习算法,向下直通底层异步网络报单协议与毫秒级状态机。借助清晰的数据流水线、科学的回测检验与稳健的风控架构,Python 为交易者构建起了一套从理论研究到真金白银实盘验证的完整闭环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















