


数据分析面试如何讲清楚Python3.14自由线程的价值?
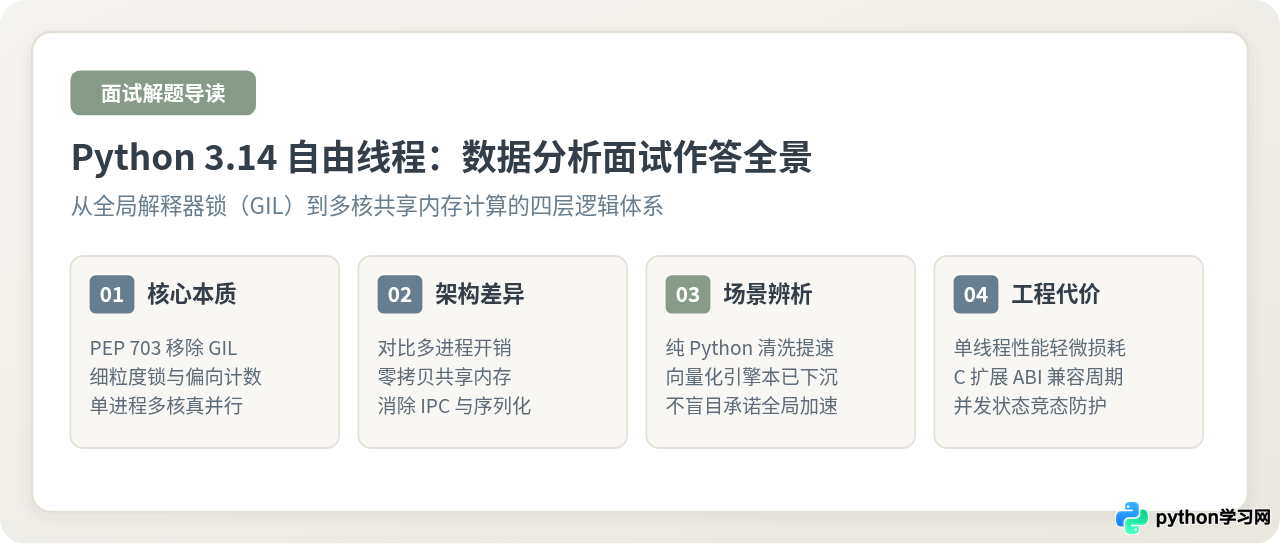
在数据分析岗位面试中,如何条理清晰、层次分明地向面试官讲清楚Python 3.14自由线程的核心价值、机制差异、适用场景与工程边界。
一、面试表达的核心脉络:四步结构化拆解
遇到这类兼具底层机制与业务实践的主题,最忌讳的是直接回答“可以让Python跑满多核”这样单薄的一句话。成熟的工程表达应当遵循“定性本质、对比机制、辨析场景、指出代价”的递进逻辑。
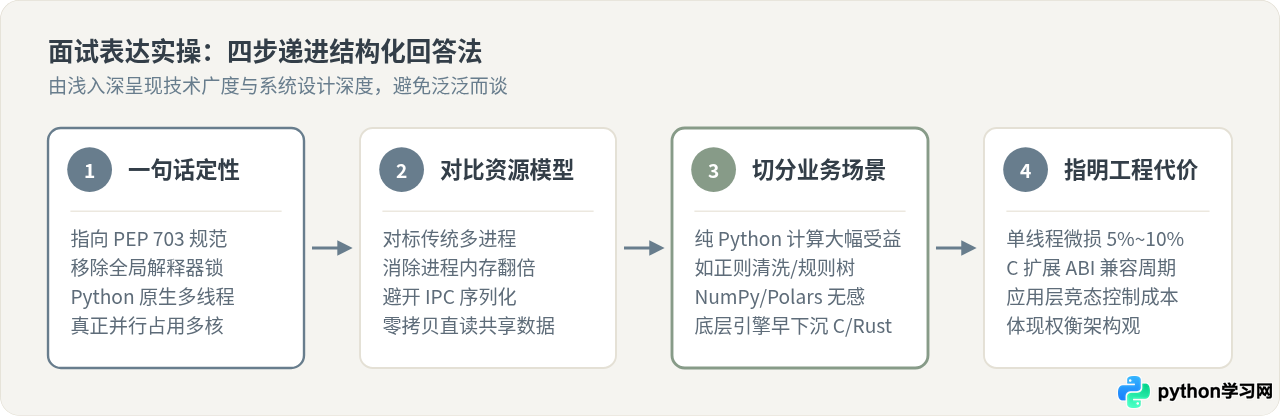
具体来说,建议在面试中按照如下四个步骤有序展开:
- 一句话定性技术本质:明确指出这是 Python 根据 PEP 703 规范、经过 3.13 实验版本后在 3.14 持续完善的无 GIL(Free-threaded)模式。它移除了全局解释器锁,通过内部细粒度锁与偏向引用计数,使原生多线程能够真正并行利用多核 CPU。
- 以资源开销为锚点对比多进程:阐明数据分析中以往依赖
multiprocessing绕过 GIL 时付出的巨额内存复制与 IPC 序列化代价,而自由线程带来了零拷贝的共享堆内存优势。 - 切分业务场景说明收益边界:客观剖析并非所有分析任务都能提速,准确区分“纯 Python CPU 密集清洗”与“底层已释放 GIL 的向量化计算”。
- 指出工程落地的现实代价:主动补充单线程吞吐的轻微损耗、第三方 C 扩展生态的适配周期,以及应用层代码面临的并发竞态防护成本。
二、底层机制与开销对比:多进程 vs 自由线程
为了向面试官展现扎实的技术功底,需要清晰解释为什么传统 Python 多线程无法应对 CPU 密集型任务,以及传统多进程方案在数据分析场景下的痛点。
在传统 CPython 中,全局解释器锁(GIL)确保同一时刻只有一个操作系统线程能执行 Python 字节码。对于纯 Python 编写的复杂计算逻辑,即便开辟了十几个 threading.Thread,它们也只是在单个 CPU 核心上交替轮转,总体耗时甚至会因频繁的线程上下文切换而增加。
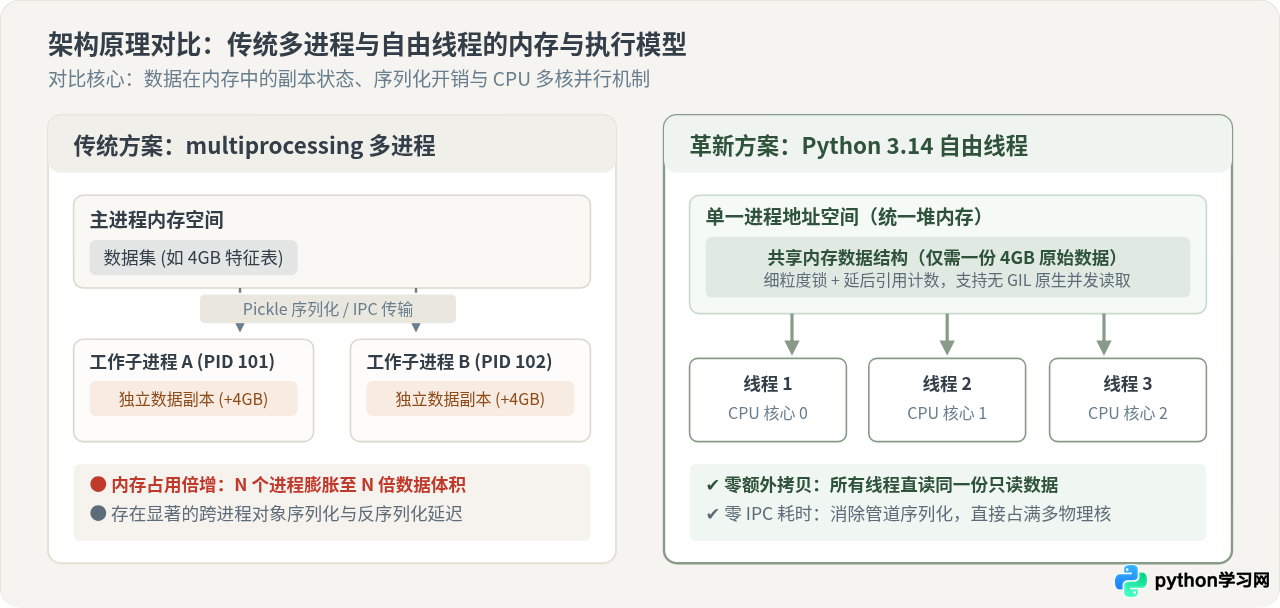
过去数据团队通常使用 multiprocessing.Pool 或 ProcessPoolExecutor 将计算分摊到多个物理核心。在数据分析场景下,这种方案存在严重的工程痛点:
传统多进程方案的现实瓶颈
- 内存空间倍增:操作系统会为每个 Worker 进程创建独立的虚拟地址空间。若主进程持有一份 4GB 的特征数据集,启动 4 个子进程将导致总内存迅速突破 16GB,极易在集群容器中触发 OOM(Out Of Memory)。
- 序列化与反序列化延迟:进程间通信(IPC)必须通过
pickle对数据进行编码和管道传输。当数据结构为海量嵌套字典或长列表时,序列化消耗的 CPU 算力甚至超过了实际业务计算本身。
Python 3.14 自由线程的架构优势
- 零拷贝共享堆内存:所有工作线程共存于同一个进程地址空间内。所有线程可以直接通过内存指针并发读取同一份原始数据表,内存占用始终恒定在 4GB。
- 消除 IPC 编解码损耗:任务分发仅涉及内存引用的传递,几乎没有分发等待与打包时间,能够瞬时拉满所有分配的物理 CPU 核心。
通过一段精简的代码示例,可以直观地对比两种模式在代码形态与资源机制上的本质差别:
# 示例 1:传统多进程方式——面临跨进程序列化与内存多份拷贝
from multiprocessing import Pool

def parse_nested_features(item):
    # 针对每条复杂非结构化字典执行多步自定义正则匹配与规则解析
    return [rule_extract(item) for rule_extract in ACTIVE_RULES]

def run_multiprocess(large_dataset):
    # large_dataset 在分发到 8 个进程时,会被切片并通过 IPC 管道反复 pickle 复制
    with Pool(processes=8) as pool:
        results = pool.map(parse_nested_features, large_dataset)
    return results

# 示例 2:Python 3.14 自由线程方式——共用内存空间,零 IPC 开销
from concurrent.futures import ThreadPoolExecutor

def run_freethreaded(large_dataset):
    # 在 python3.14t(自由线程构建)环境下,多线程直接读取同一堆内存中的 large_dataset
    # 不存在跨进程数据打包,所有 Worker 线程在独立 CPU 核心上全速并发执行
    with ThreadPoolExecutor(max_workers=8) as executor:
        results = list(executor.map(parse_nested_features, large_dataset))
    return results
三、场景辨析:分清哪些场景受益、哪些场景无感
这是区分初级学习者与资深分析师的关键环节。如果在面试中宣称“自由线程会让所有数据分析代码变快 5 倍”,通常会被面试官判定为缺乏实践经验。必须结合数据团队的具体技术栈,明确划定加速收益的生效范围。
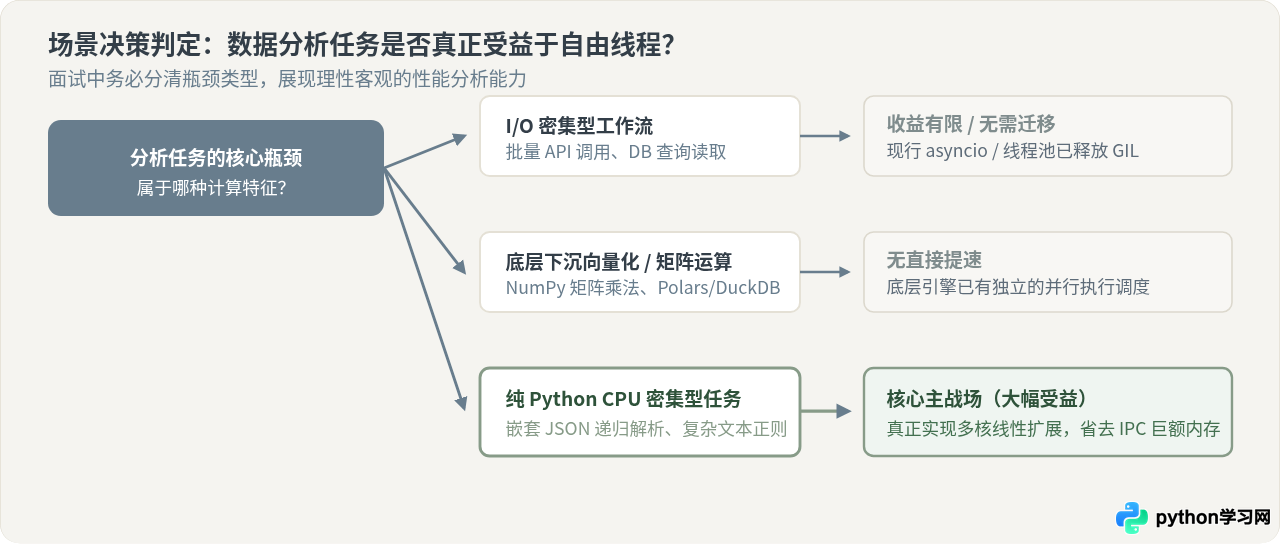
1. 核心受益场景:纯 Python CPU 密集型任务
当数据清洗逻辑无法被底层向量化库封装时,自由线程展现出无可替代的价值:
- 非结构化文本与深层嵌套日志解析:解析多层嵌套的复杂 JSON 树、执行自定义正则表达式提取,或者运行纯 Python 编写的词法分析逻辑。
- 业务规则引擎与风控打标:上千条由风控或业务分析师编写的条件分支树,数据需要在纯 Python 环境下逐行匹配规则。
- 图关系遍历与树搜索:纯 Python 构建的节点拓扑遍历、复杂聚类派生特征计算。
2. 改善微弱或无感场景:底层已下沉的现代分析工具栈
在常规的表格统计或矩阵运算中,自由线程并不会带来额外的速度飞跃:
- NumPy 矩阵运算与 SciPy 科学计算:像矩阵乘法、奇异值分解等稠密计算,底层早已下沉到 BLAS/LAPACK(如 OpenBLAS、Intel MKL)并在 C/Fortran 层释放了 GIL,本身就支持多核并发。
- Polars 与 DuckDB 等现代分析引擎:Polars 基于 Rust 的 Rayon 框架实现内部多线程调度,DuckDB 依托 C++ 原生并发流水线。Python 在其中仅充当声明式 API 调用接口,执行耗时与 Python 解释器本身的锁机制几乎无关。
- 网络与磁盘 I/O 密集型任务:从数据库并发读取表分片、并发调用外部 API 接口时,传统的
asyncio或标准线程池早已能在发生系统调用时主动释放 GIL,自由线程不会带来根本性差异。
四、展现工程视野:讲清代价与现实边界
一个高水准的回答必须包含对技术权衡(Trade-offs)的洞察。任何底层架构的重构都伴随着妥协,面试中主动提及以下三点,能极大增强回答的客观性与可信度:
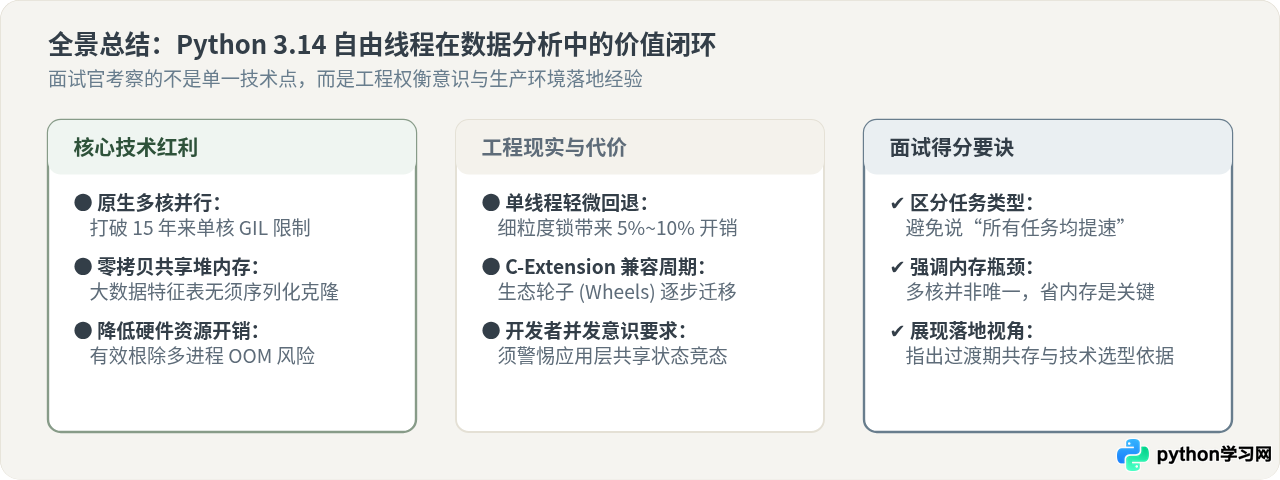
- 单线程性能微幅回退:为了完全移除全局锁,CPython 引入了细粒度锁(如 Mimalloc 分配器隔离)和偏向引用计数(Biased Reference Counting)。这些机制为每一次对象的增减引用引入了额外的指令开销。因此在完全不启用多线程的单核任务中,执行耗时通常会有约 5% 到 10% 的轻度回退。
- 第三方 C 扩展生态的迁移周期:许多老旧的 C-API 扩展默认依赖 GIL 保护其全局模块状态。虽然核心基础库(如 NumPy、PyTorch)正在积极提供自由线程专用的轮子(free-threaded wheels),但社区长尾库和企业私有 C 扩展需要耗费一定周期重新适配无 GIL 编译,短期内仍处于双构建共存期。
- 应用层并发竞态风险:GIL 过去虽然限制了多核性能,但也客观上为一些单字节码操作(如简单的字典取赋值)提供了隐式原子性。在自由线程环境下,Python 应用层如果存在无锁的多线程全局变量并发写入,必须由开发者显式引入互斥锁(
threading.Lock)以避免数据损坏。
五、全景总结与实战应答模板
综合以上各个维度的分析,可以将 Python 3.14 自由线程在数据分析领域的价值总结为如下结构化视图:
在面试现场,如果需要进行一分钟内的精炼作答,可直接使用以下总结表述:
multiprocessing 绕过 GIL 的做法,它最根本的工程优势是支持零拷贝共享堆内存,从根本上解决了大数据集在多进程间传递时导致的内存倍增与 IPC 序列化性能瓶颈。但它的加速收益集中在纯 Python 自定义特征提取、深层文本解析与规则树计算等纯 CPU 密集场景;而对于底层早已下沉到 C/Rust 并自主释放锁的 NumPy、Polars 等向量化引擎,则不会带来直接提升。同时我们也要清醒认识到其单线程约 5%~10% 的额外开销与 C 扩展的适配周期,在实际工程选型中按需平滑落地。”
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















