


Python爬虫爬取招聘数据后的清洗与去重方法
本文系统介绍Python爬虫抓取招聘岗位数据后的清洗与去重方法,涵盖HTML标签过滤、多格式薪资解析标准化、城市与工作经验规整,以及精确ID去重与组合业务指纹去重的核心差异和完整代码实现。
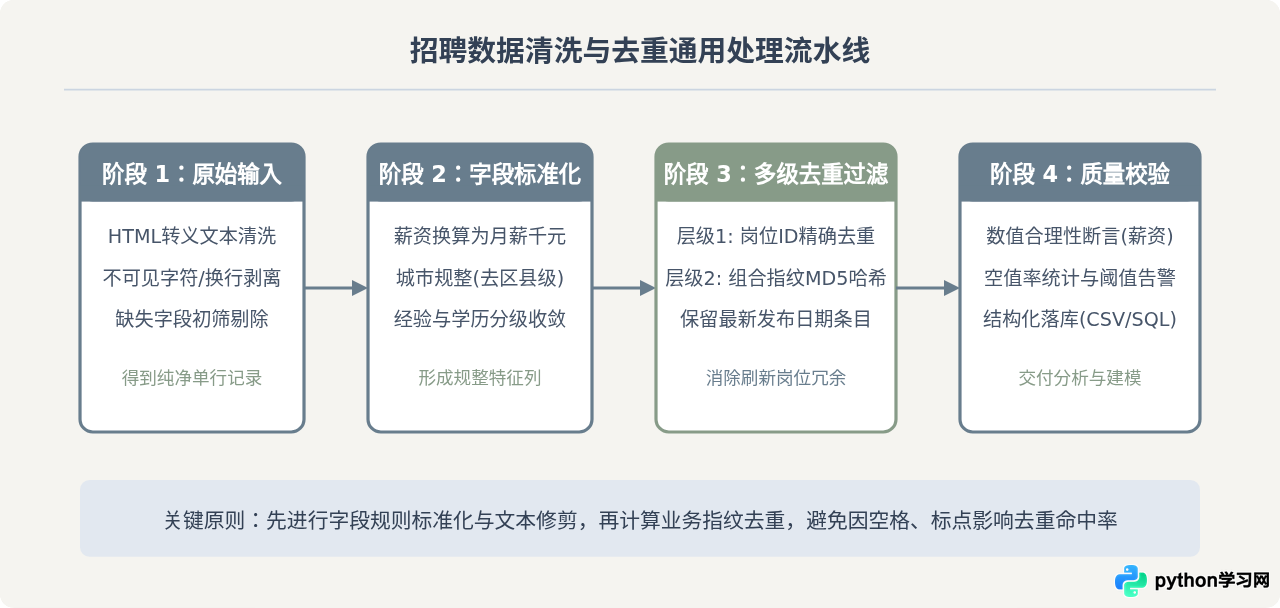
网络爬虫在抓取各类招聘网站的岗位信息后,原始数据通常混杂着嵌套HTML转义字符、混乱的薪资区间写法、非标准地名以及大量重复刷新发布的冗余岗位。解决这些问题的标准路径包括两部分:先利用正则表达式与规则映射完成字段级清洗,将自由文本转为结构化数值;再通过“唯一键判断”配合“多字段组合业务指纹”,彻底剔除机械刷新岗位与重复抓取项。
一、数据清洗的核心任务与具体做法
招聘爬虫获取的原始信息通常是以字典列表或原始数据表形式存在。未经处理的文本直接用于薪酬统计或技能分析会导致严重失真。清洗阶段的核心目标是消除干扰符号,并将离散、多样的表述收敛为统一格式。
1. 基础文本与HTML标签清理
很多招聘网站返回的正文描述包含 、<br/>、连续换行符以及前后空白字符。在Python中,使用内置的 re 模块结合 html.unescape 可以快速还原并剥离多余符号:
import html
import re
def clean_raw_text(text: str) -> str:
if not isinstance(text, str):
return ""
# 解码HTML实体,如 -> 空格, < -> <
text = html.unescape(text)
# 去除HTML标签
text = re.sub(r"<[^>]+>", " ", text)
# 将制表符、连续换行和多余空格压缩为单个空格
text = re.sub(r"\s+", " ", text)
return text.strip()2. 薪资字段的结构化解析
薪资是招聘数据清洗中最复杂的字段。不同平台呈现形态各异,例如“15k-25k·14薪”、“1.5万-2.5万/月”、“300-400元/天”或“面议”。直接保留字符串无法做数值运算,必须拆解为标准统一的基准单位(通常折算为月薪,单位:元或千元/月)。
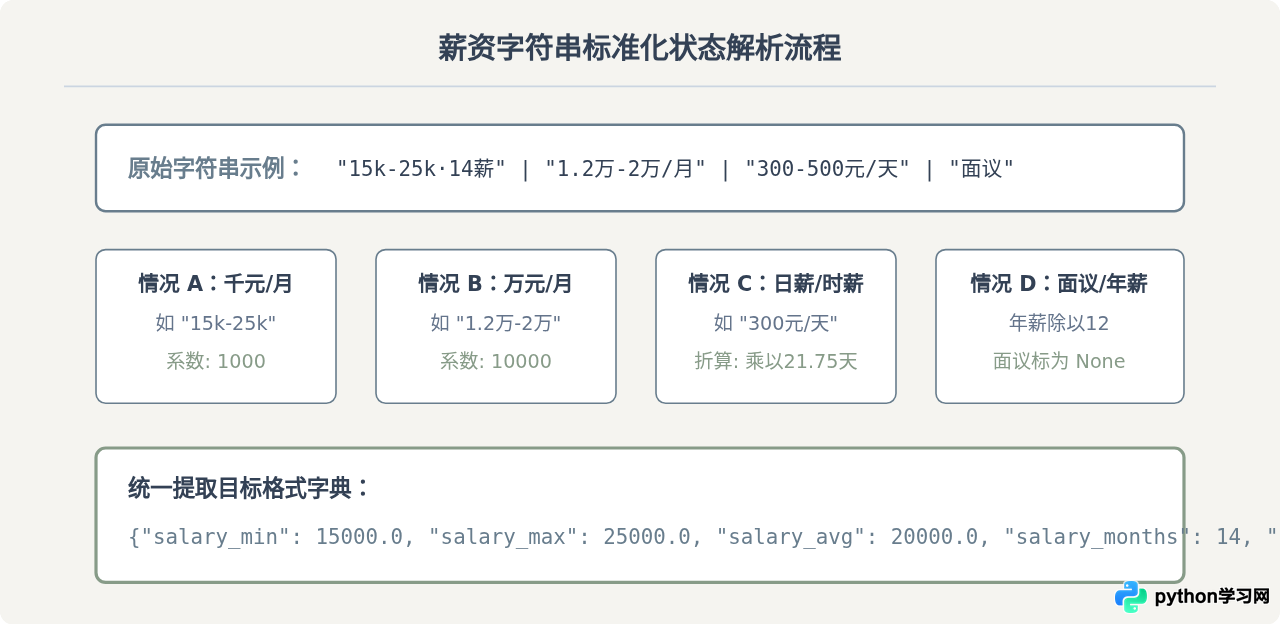
实现该逻辑的通用解析函数如下。函数支持分别提取薪资下限、上限与年终薪数,并自动规整为月薪数值:
import re
from typing import Dict, Any, Optional

def parse_salary(salary_str: Optional[str]) -> Dict[str, Any]:
    default_result = {
        "salary_min": None,
        "salary_max": None,
        "salary_avg": None,
        "salary_months": 12,
        "is_negotiable": False
    }
    if not salary_str or not isinstance(salary_str, str):
        default_result["is_negotiable"] = True
        return default_result

    salary_str = salary_str.strip().lower()
    if "面议" in salary_str or "校招" in salary_str:
        default_result["is_negotiable"] = True
        return default_result

    # 提取多薪数(如 14薪、16薪)
    months = 12
    month_match = re.search(r"(\d+)\s*薪", salary_str)
    if month_match:
        months = int(month_match.group(1))

    # 提取数值区间
    num_match = re.search(r"(\d+(?:\.\d+)?)\s*[-~至到]\s*(\d+(?:\.\d+)?)", salary_str)
    if not num_match:
        return default_result

    low = float(num_match.group(1))
    high = float(num_match.group(2))

    # 根据单位换算基准倍率(以元/月为标准)
    multiplier = 1.0
    if "k" in salary_str or "千" in salary_str:
        multiplier = 1000.0
    elif "w" in salary_str or "万" in salary_str:
        multiplier = 10000.0
    elif "元/天" in salary_str or "天" in salary_str:
        # 日薪按法定月平均计薪日 21.75 天折算
        multiplier = 21.75
    elif "年" in salary_str:
        # 若以年薪展示,除以 12 折算为月薪
        multiplier = 10000.0 / 12.0 if ("万" in salary_str or "w" in salary_str) else 1.0 / 12.0

    min_val = round(low * multiplier, 2)
    max_val = round(high * multiplier, 2)

    return {
        "salary_min": min_val,
        "salary_max": max_val,
        "salary_avg": round((min_val + max_val) / 2, 2),
        "salary_months": months,
        "is_negotiable": False
    }
3. 地点、学历与工作经验规范化
招聘岗位工作地点常存在“北京-朝阳区-望京”、“上海·浦东新区”等混杂写法。在宏观统计时,往往只需要地级市或核心行政区。通过前缀切分或词典映射规整城市字段:
- 城市归一化:使用
re.split(r"[-·/]", text)[0].strip()提取一级地名,并统一去除末尾多余的“市”字(如“北京市”统一为“北京”)。 - 经验要求离散化:将“应届生”、“1-3年”、“3-5年”、“5-10年”、“10年以上”收敛为固定枚举类别,无法匹配的设为“经验不限”。
- 学历要求收敛:映射为“大专及以下”、“本科”、“硕士”、“博士”、“学历不限”五类基准标签。
二、精确去重与组合业务指纹去重的关键差异
爬虫爬取招聘信息时,重复数据的来源有两个截然不同的层面:
- 系统请求重叠:爬虫网络中断重试或多页抓取边界重叠,抓到了完全相同的岗位URL或平台唯一ID。
- 企业重复刷榜:HR在招聘平台隔几天便刷新一次岗位,或者同一个企业针对同个职位发布了多个不同ID的招聘需求,内容、薪酬、地点完全一致。
针对这两种情况,需要对比两种去重做法的关键机制及其影响:
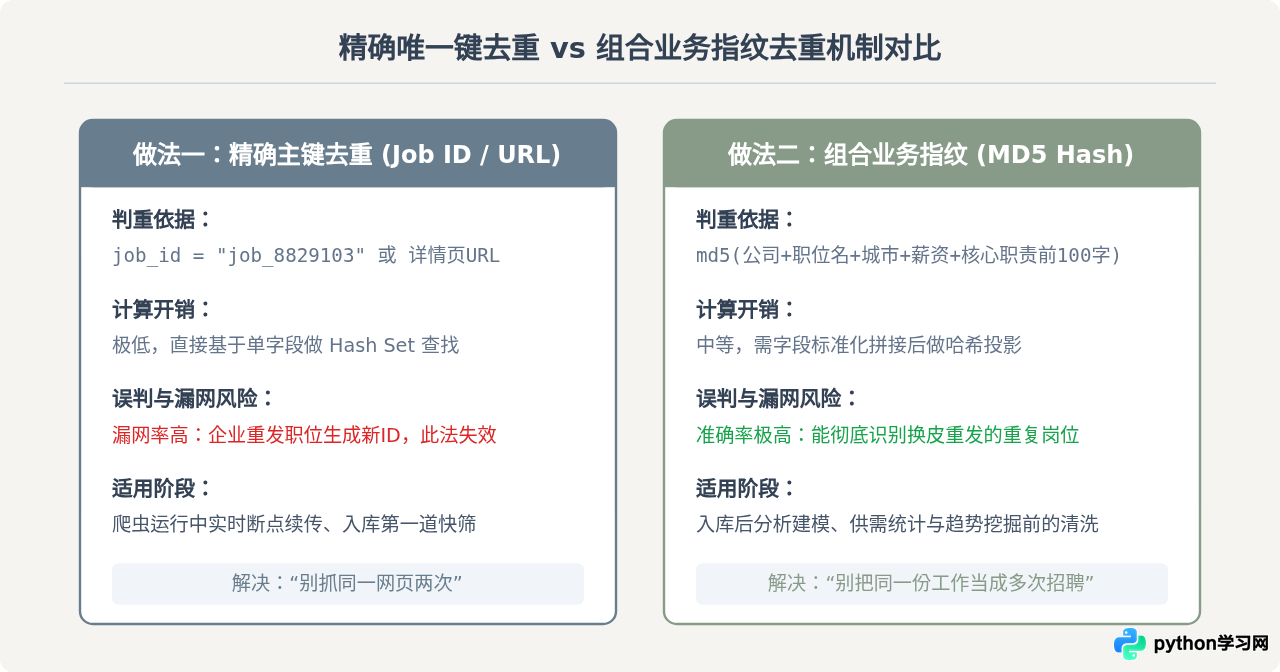
两种去重方法的差异之所以重要,是因为它们解决的问题维度完全不同:
- 精确键去重的局限:如果仅仅对
job_id或url调用drop_duplicates(),只能去除抓取过程中的机械重复。但某公司为了提升曝光率,每天删除旧招聘并重新发布一次(产生新ID),这种伪新岗位会充斥数据集,导致招聘需求量被严重高估。 - 组合指纹去重的权衡:利用“公司全称 + 标准化岗位名 + 城市 + 职责文本特征”计算哈希指纹,能跨ID识别重复。但如果组合字段选择过少(如仅选公司+职位名),当公司确实在同时招聘多个同名技术员时可能出现误删。因此,指纹组合必须包含合理的区分粒度,并在保留记录时明确保留发布时间最新的一条。
三、完整的清洗与去重代码流水线
以下示例展示了使用 pandas 库组织完整清洗与双层去重的可执行流水线,包含字段衍生、指纹计算与冗余淘汰:
import hashlib
import pandas as pd

def generate_business_fingerprint(row: pd.Series) -> str:
    """
    根据核心业务维度生成唯一MD5业务指纹
    """
    # 提取描述前80字参与判重,防止细微调整导致哈希失效
    desc_snippet = str(row.get("job_description", ""))[:80].strip()

    key_components = [
        str(row.get("company_name", "")).strip().lower(),
        str(row.get("job_title", "")).strip().lower(),
        str(row.get("city_clean", "")).strip().lower(),
        str(row.get("salary_avg", "")),
        desc_snippet
    ]
    raw_key = "||".join(key_components)
    return hashlib.md5(raw_key.encode("utf-8")).hexdigest()

def clean_and_deduplicate_pipeline(df: pd.DataFrame) -> pd.DataFrame:
    print(f"原始数据总量: {len(df)} 条")

    # 1. 第一级去重:基于抓取链接或平台ID的精确去重
    if "job_id" in df.columns:
        df = df.drop_duplicates(subset=["job_id"], keep="first")
    elif "url" in df.columns:
        df = df.drop_duplicates(subset=["url"], keep="first")
    print(f"精确ID去重后数据量: {len(df)} 条")

    # 2. 字段级规范化
    df["company_name"] = df["company_name"].fillna("未知公司").astype(str).str.strip()
    df["job_title"] = df["job_title"].fillna("").astype(str).str.strip()

    # 城市规整
    df["city_clean"] = df["city"].fillna("全国").astype(str).apply(
        lambda x: re.split(r"[-·/]", x)[0].replace("市", "").strip()
    )

    # 薪资结构化拆解
    salary_parsed = df["salary"].apply(parse_salary).apply(pd.Series)
    df = pd.concat([df, salary_parsed], axis=1)

    # 3. 构造业务组合指纹
    df["business_fingerprint"] = df.apply(generate_business_fingerprint, axis=1)

    # 4. 第二级去重:基于业务指纹去重(优先保留发布日期更新的记录)
    if "publish_date" in df.columns:
        df["publish_date"] = pd.to_datetime(df["publish_date"], errors="coerce")
        df = df.sort_values(by="publish_date", ascending=False)

    df = df.drop_duplicates(subset=["business_fingerprint"], keep="first")
    print(f"组合业务指纹去重后最终数据量: {len(df)} 条")

    # 5. 异常值剔除(过滤薪资严重不符合常理的数据,如月薪低于1000或超过50万的录入错误)
    valid_salary_condition = (
        (df["salary_avg"].isna()) |
        ((df["salary_avg"] >= 1000) & (df["salary_avg"] <= 500000))
    )
    df = df[valid_salary_condition].copy()

return df.reset_index(drop=True)注意:在计算业务指纹前,务必保证文本全部转为全小写并去掉连续空格。例如 "Python 后端" 与 "python 后端 " 在未做修剪时会生成完全不同的MD5值,进而导致组合去重失效。
四、数据质量核验与总结
清洗与去重完成后,不可直接盲目写入数据库,需要进行最终的完整性核验。通过定义几个简单的断言规则,可以及早拦截由于反爬导致的反常页面结构。
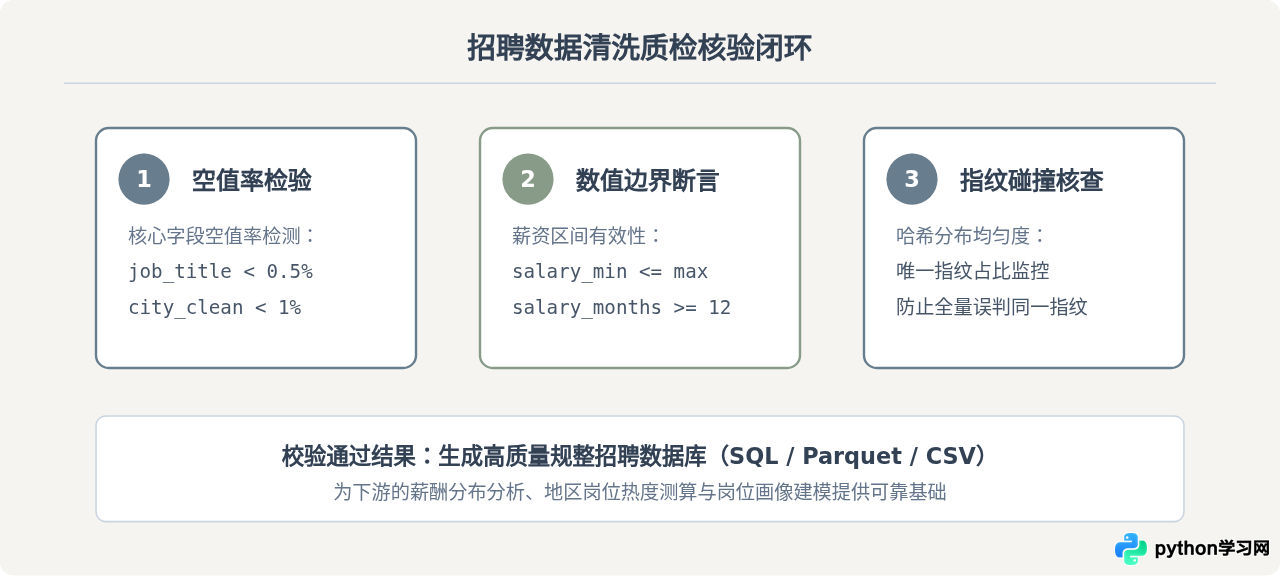
招聘数据的清洗与去重不是单一函数的简单调用,而是规则转换与业务理解紧密结合的工程。先通过正则表达式剥除HTML与文本噪声,将薪资规范化换算为基准月薪,再分步实施精确ID去重与组合业务指纹过滤,才能有效剔除刷榜岗位并确保下游统计指标的准确性与客观性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















