


Python print函数基础用法:sep、end与file参数详解
深入解析Python内置print函数的底层工作原理与参数用法,详细讲解sep分隔符、end结束符与file输出重定向的核心语法、实战示例与避坑指南。
在 Python 编程中,print() 是开发者最先接触也最常用的内置函数之一。绝大多数人在入门时仅用它来输出单一变量或字符串,但当面对批量日志记录、格式化报表拼接以及多项数据对齐等具体场景时,仅使用默认行为往往无法满足需求。本文聚焦讲解 print() 函数中的 sep(元素分隔符)、end(输出结束符)与 file(输出目标通道)三个核心参数,剖析其运作原理、语法约束及常见实操方案,帮助读者写出更规范、精准的输出代码。
一、print 函数的签名与默认输出机制
在 Python 3 中,print() 是一个全功能的内置函数,其官方标准签名定义如下:
print(*objects, sep=' ', end='\n', file=None, flush=False)该函数包含以下五个关键部分:
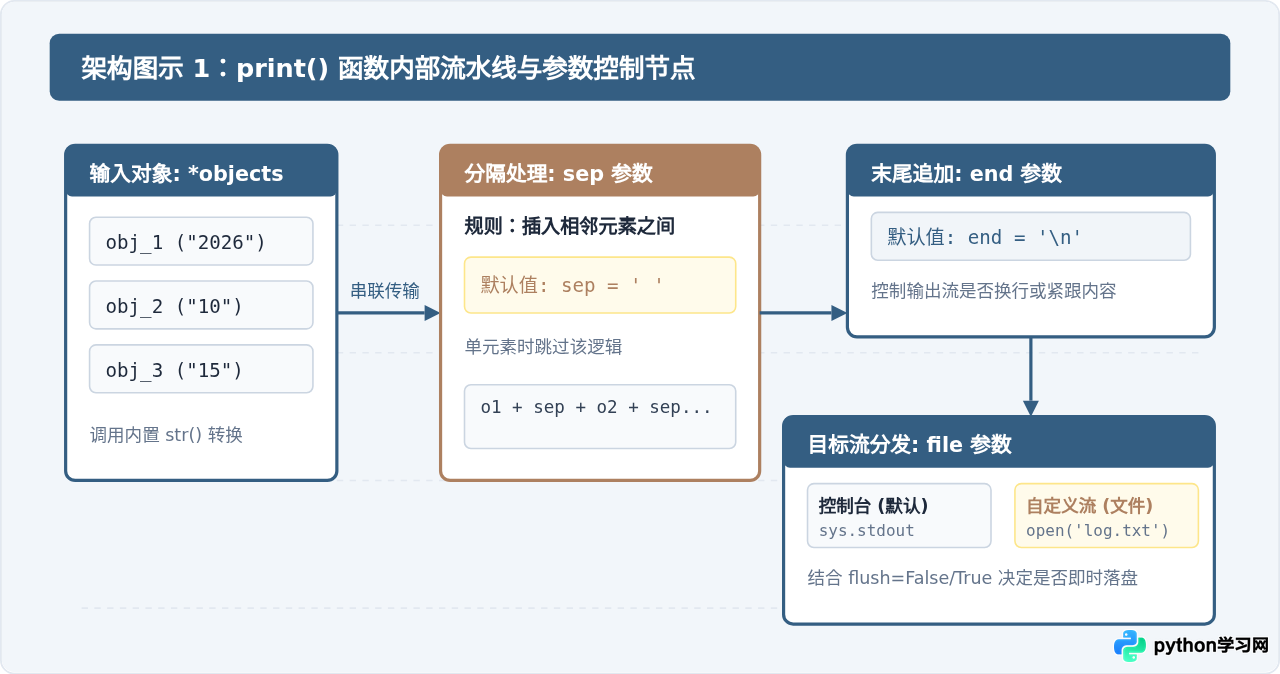
*objects:可变位置参数,支持传入零个、一个或任意多个需要打印的对象。每个对象在输出前都会自动调用str()转换为字符串。sep:多个对象之间的连接分隔符。默认值是一个普通空格' '。end:所有对象全部输出完毕后追加的结尾字符。默认值是换行符'\n'。file:数据流的目标写入对象。默认值为None,在底层解析为标准输出流sys.stdout(通常对应终端控制台)。flush:是否强制刷新缓冲区,默认为False。
当开发者执行 print("hello", "world") 时,函数首先将每个参数转换为字符串,在它们之间插入 sep 指定的空格,最后在末尾追加 end 指定的换行符,并发送到 sys.stdout。这一流水线处理过程如下图所示:
二、sep 参数详解:精确控制元素间距
sep 参数的全称为 separator(分隔符)。当向 print() 传入两个或更多的参数时,sep 决定了这些参数字符串拼接时的中间填充字符。
1. 基础语法与核心约束
使用 sep 时需要注意以下两个重要原则:
- 必须是字符串类型或 None:
sep的取值必须为str或None。如果赋值为整数、列表等非字符串类型,Python 解释器会直接抛出类型异常。例如执行print(1, 2, sep=0)会报错TypeError: sep must be None or a string, not int。当传入None时,其效果与默认的单个空格相同。 - 单参数时静默忽略:如果只向
print()传递了一个参数(例如print("hello", sep="-")),由于不存在“元素之间”的概念,sep将不会生效,终端输出仍然是hello。
2. 常见应用场景示例
在日常开发中,合理调整 sep 可以消除繁琐的手动字符串拼接:
# 场景 1:无缝拼接(消除默认空格)
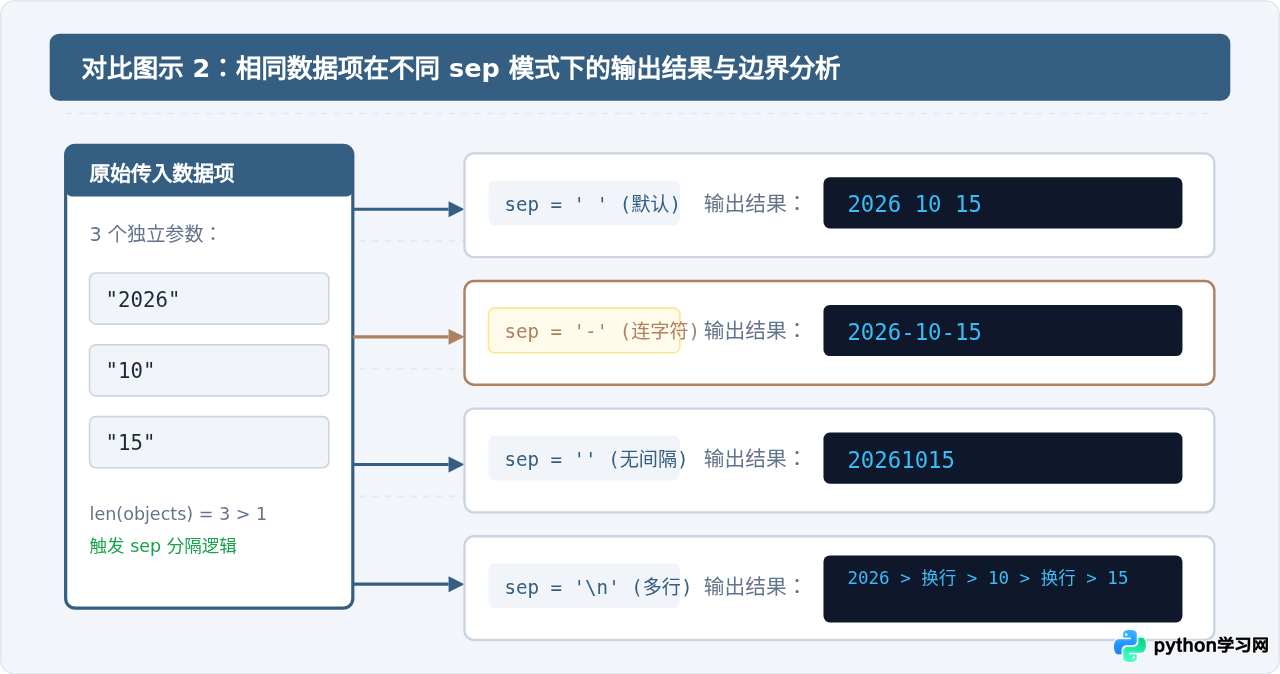
print("user", "name", "id", sep="")

# 场景 2:生成规范日期格式
print(2026, 10, 15, sep="-")

# 场景 3:快速生成逗号分隔的 CSV 数据行
print("Alice", 28, "Engineer", "Beijing", sep=", ")

# 场景 4:利用换行符将多个数据项分行输出
print("第一步: 初始化环境", "第二步: 加载数据", "第三步: 启动计算", sep="\n")2026-10-15
Alice, 28, Engineer, Beijing
第一步: 初始化环境
第二步: 加载数据
第三步: 启动计算
下图展示了相同的三个输入参数在不同 sep 规则下的流式装配效果:
三、end 参数详解:灵活控制行尾与光标流向
每次调用 print(),在所有对象及分隔符输出完成之后,系统都会默认追加一个结束符。end 参数正是用来覆盖默认换行符 '\n' 的关键选项。
1. 为什么默认换行?
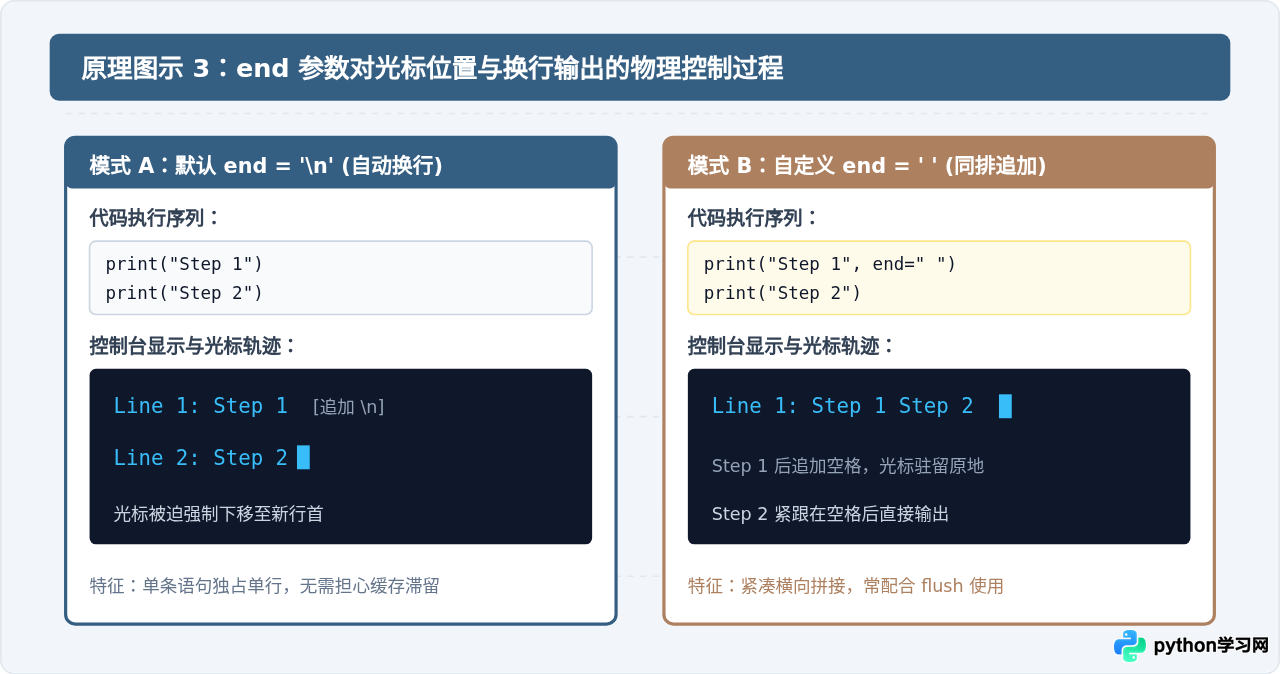
在绝大多数终端输出场景中,一行完整的提示信息或日志记录应当独立成行,因此 Python 将 end 的默认值设计为 '\n'。这导致连续写两条 print() 语句时,两段内容必定呈现在不同行。
2. 常见应用场景与代码实践
当需要让多次 print() 输出在同一行排版,或者在循环打印进度时保持单行刷新,end 参数尤为关键:
# 场景 1:多语句同行输出(使用空格或逗号连接)
print("Loading data", end="... ")
print("Parsing JSON", end="... ")
print("Complete!")

# 场景 2:循环遍历在同一行连续输出
for i in range(1, 6):
    print(f"[{i}]", end=" ")
print()  # 空 print() 仅输出一个默认换行,使终端光标换至下一行

# 场景 3:单行动态进度指示(结合回车符 \r 与 flush=True)
import time
for step in range(1, 4):
    print(f"\r当前处理进度: {step * 33}%", end="", flush=True)
    time.sleep(0.5)
print("\r当前处理进度: 100% 完成!")[1] [2] [3] [4] [5]
当前处理进度: 100% 完成!
当将
end 设置为 ""(空字符串)或非换行字符时,终端可能不会立即刷新屏幕显示,因为许多终端采用“行缓冲”(Line Buffered)策略,只有遇到 '\n' 时才会一次性将缓冲区内容刷新到屏幕。如果需要即时动态更新(如进度条动画),请务必同时显式声明 flush=True。
下图清晰对比了 end='\n' 与 end=' ' 在两次连续 print() 调用时的光标轨迹与排版机理:
四、file 参数详解:轻松实现标准输出与重定向
在默认情况下,print() 的 file 参数值为 None。当 file 为 None 时,函数内部会自动将其指向 sys.stdout,也就是操作系统的标准输出通道,因此所有打印内容都会直接呈现在当前运行的终端屏幕上。
1. 重定向至磁盘文件
通过向 file 参数传入一个具备可写权限的文件对象(File Object),可以直接将输出流重定向至外部文本文件。这种写法非常适合轻量级的执行报告导出或简单数据记录:
# 配合 with 语句安全打开文件并写入
with open("report.log", mode="w", encoding="utf-8") as f:
    print("=== 系统执行诊断报告 ===", file=f)
    print("运行环境:", "Python 3.12", sep=" ", file=f)
    print("检查项 1: 网络连通正常", file=f)
    print("检查项 2: 数据表索引就绪", file=f)
    print("=== 报告生成完毕 ===", file=f)

# 文件追加模式(使用 mode="a")
with open("report.log", mode="a", encoding="utf-8") as f:
    print("[INFO]", "追加一条新的心跳记录", sep=" - ", file=f)
相比传统的 file.write(),使用 print(..., file=f) 具有两大显著优势:
- 自动类型转换:
write()方法要求传入的必须是纯字符串,若传入数字或元组必须手动write(str(val));而print()会对所有对象自动调用str()。 - 自带格式化拼装:可以同时复用
sep和end参数,无需手动补\n或手动插入分隔符。
2. 重定向至标准错误流 sys.stderr
在 Linux/Unix 命令行环境或自动化流水线中,标准输出(stdout,文件描述符 1)与标准错误(stderr,文件描述符 2)常常需要分流捕获。如果程序发生严重错误或警告,推荐将输出导向 sys.stderr:
import sys

# 正常业务数据输出至 stdout
print("Processed 100 records successfully.", file=sys.stdout)

# 异常告警信息定向至 stderr
print("WARNING: Config key 'timeout' not found, using default 30s.", file=sys.stderr)任何赋给
file 的对象,其底层必须实现类似流协议的 write(string) 方法。如果传入只读模式打开的文件对象(如 mode="r"),运行时会抛出 io.UnsupportedOperation: not writable;如果传入不支持该方法的任意普通对象,则会报错 AttributeError: 'X' object has no attribute 'write'。
五、三个参数的协同工作与决策路径
在复杂的控制台交互或数据导出场景中,sep、end 与 file 常常组合使用。为了在编码时快速选取正确的参数组合,可参考以下全景决策流程:
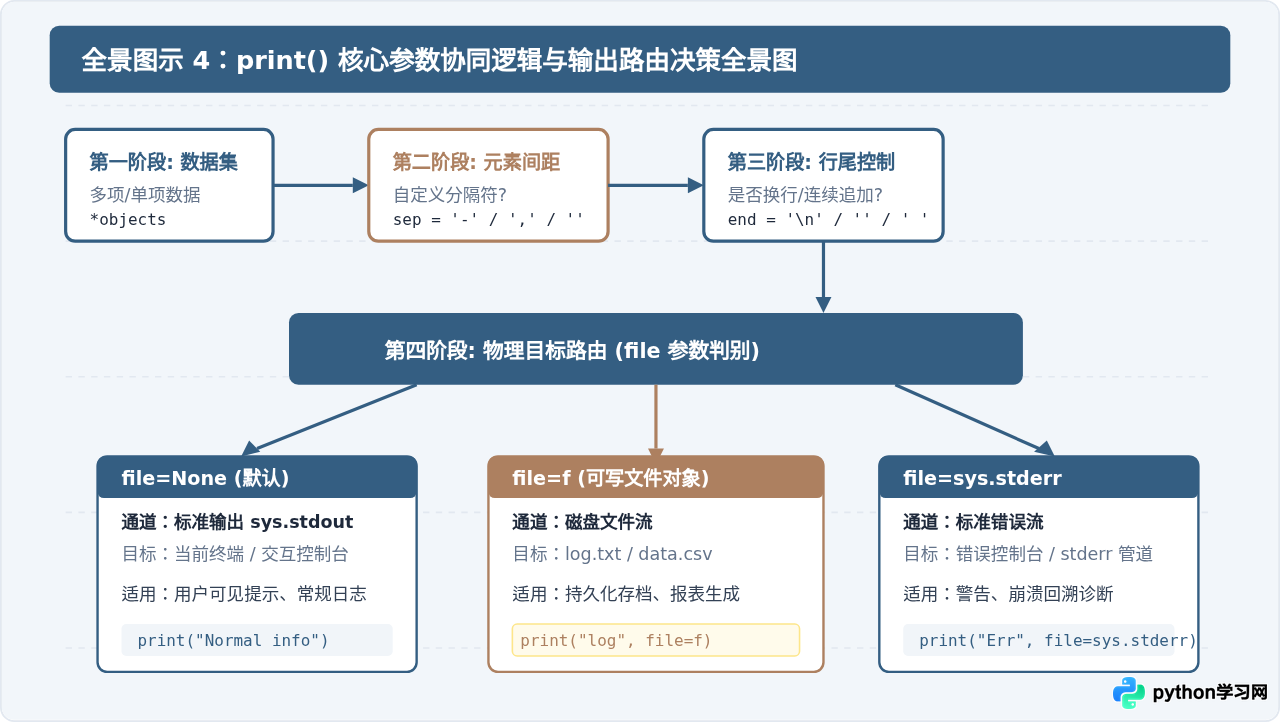
综合实战:构建多列数据文件导出工具
以下示例结合了 sep、end 与 file,演示如何无需引入第三方库,仅用 print() 纯净导出一份结构化文本报表:
import sys

records = [
    ("ID", "Name", "Score", "Level"),
    (1001, "Li Hua", 95, "A"),
    (1002, "Zhang San", 82, "B"),
    (1003, "Wang Wu", 67, "C")
]

try:
    with open("student_report.csv", mode="w", encoding="utf-8") as outfile:
        for row in records:
            # 使用 sep 设定 CSV 字段分隔符,使用 file 写入文件流
            print(*row, sep=",", end="\n", file=outfile)
    print("报表已顺利生成至 student_report.csv")
except OSError as err:
    # 遇到 I/O 错误时将诊断信息打印至标准错误
    print(f"写入文件失败: {err}", file=sys.stderr)
六、高频易错点总结
- 参数拼写混淆:初学者偶尔会误将
sep拼写为split或delimiter,或者将end误写为last。由于 Python 关键字参数严格按名称匹配,传入错误参数名会直接引发TypeError: 'xxx' is an invalid keyword argument for print()。 - 误解 sep 的作用对象:
sep是作用在不同的位置参数之间,而不是单个字符串内部。如果执行print("apple,banana,cherry", sep=";"),输出并不会被替换为分号,因为整个内容只是一个字符串参数。 - 混淆文件模式与写权限:重定向至
file时,所打开的文件对象必须具备写入权限(mode="w"或mode="a")。如果误以只读模式(mode="r")打开并传入file,将在运行时遭遇异常中断。
掌握 sep、end 与 file 的用法,能使我们在编写日常脚本、格式化数据预览与构建基础日志管道时,以极简的原生语法达成清晰优雅的控制效果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















