


Python高效读取大型Excel文件:openpyxl只读模式与内存优化
深入解析Python使用openpyxl处理超大型Excel文件时的内存瓶颈与解决策略,详解read_only只读模式原理、iter_rows流式提取、核心避坑指南及技术选型。
当尝试用 Python 读取一个体积超过 100MB、包含数十万行数据的 .xlsx 文件时,很多开发者会遇到脚本运行几分钟后突然内存暴涨数 GB,甚至直接抛出 MemoryError 被操作系统强行终止(OOM)的情况。解决这一痛点的关键在于:放弃默认的 DOM 全量载入方式,开启 openpyxl 的流式只读模式(read_only=True),并配合 iter_rows(values_only=True) 逐行迭代数据,将内存占用稳定压制在数十兆字节的常数级别。
一、为什么常规加载会发生内存膨胀?
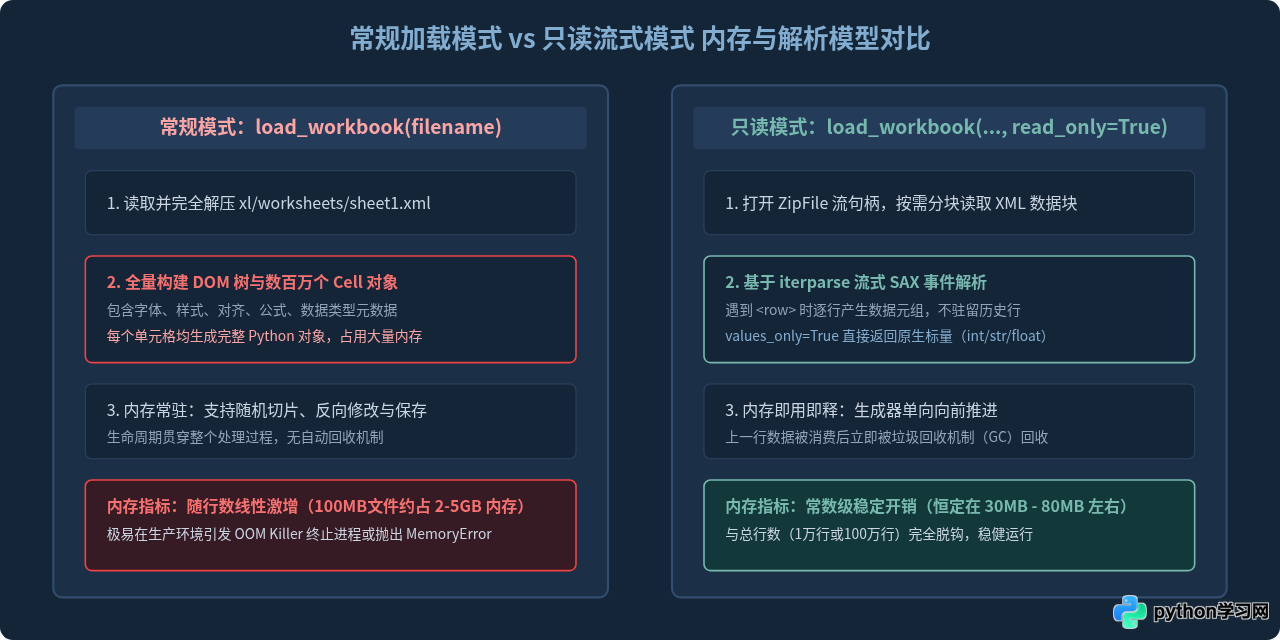
现代 Excel 的 .xlsx 格式本质上是一个使用 Zip 压缩的 XML 包。在解压缩后,XML 文件的真实体积往往比原始 .xlsx 大 5 到 10 倍。例如一个 150MB 的 Excel 文件,解包后底层的 XML 数据体量可能高达 1GB 到 1.5GB。
在默认情况下,openpyxl.load_workbook(filename) 采用的是文档对象模型(DOM)机制。它会在启动时完整解压整个 XML,并在内存中为每一个单元格构造一个高度封装的 Cell 对象。每个 Cell 对象不仅保存单元格的字符串或数值,还保存了对应的数据类型、字体、填充、边框、坐标、公式缓存及格式化规则。数百万个细粒度 Python 对象的实例化和字典引用,直接导致内存占用呈指数级爆炸。
二、openpyxl 只读模式的核心用法与操作步骤
启用只读模式的方法非常直接:在调用 load_workbook 时将 read_only 参数设为 True。配合 iter_rows(values_only=True),可以在完全不创建重量级 Cell 实例的前提下,直接读取各单元格的纯数值或字符串。
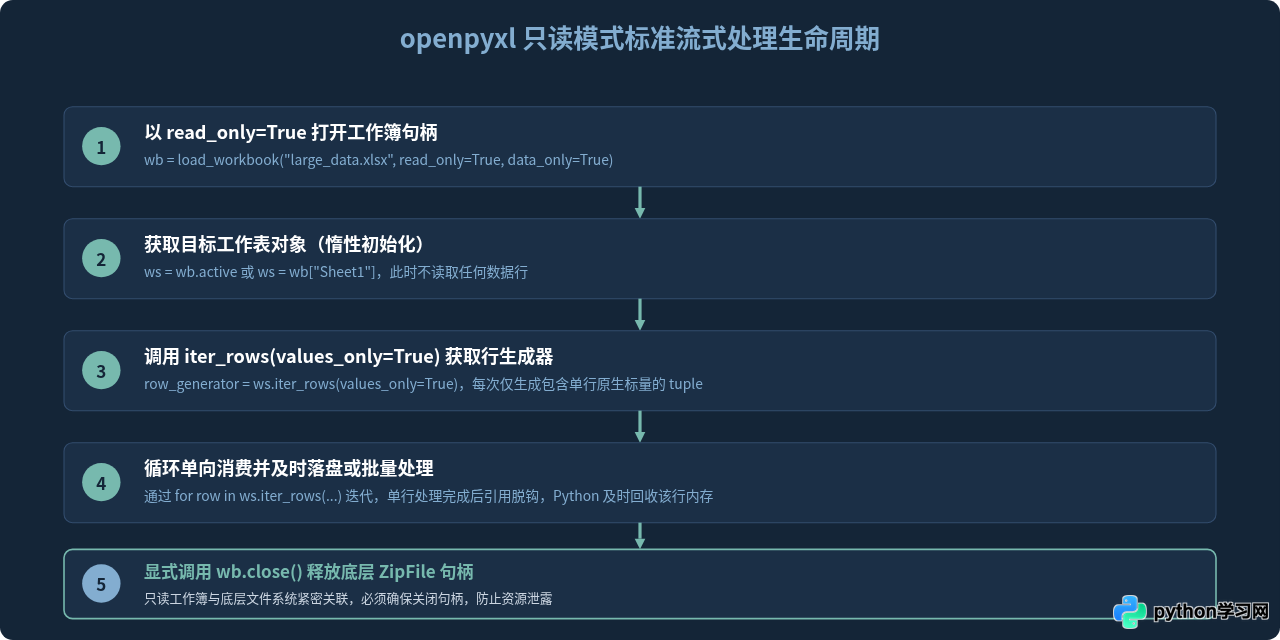
下面是一个标准的流式处理代码模板。该示例读取一个大型 Excel 文件,提取第一行为表头,并将后续数据逐批写入数据库或外部存储:
import openpyxl

def process_large_excel(file_path):
    # read_only=True 启用流式解析
    # data_only=True 读取公式计算后的值而不是公式字符串
    wb = openpyxl.load_workbook(filename=file_path, read_only=True, data_only=True)

    try:
        # 获取首个工作表
        sheet_names = wb.sheetnames
        ws = wb[sheet_names[0]]

        # 获取行迭代器
        row_iterator = ws.iter_rows(values_only=True)

        # 1. 提取表头
        try:
            headers = next(row_iterator)
        except StopIteration:
            return  # 空工作表

        print(f"检测到字段列表: {headers}")

        # 2. 逐行流式处理
        total_rows = 0
        batch_buffer = []
        batch_size = 5000  # 每 5000 行批量处理一次

        for row in row_iterator:
            total_rows += 1
            batch_buffer.append(row)

            if len(batch_buffer) >= batch_size:
                # 模拟批量插入数据库或持久化写入
                flush_batch(batch_buffer)
                batch_buffer.clear()

        # 消费剩余批次
        if batch_buffer:
            flush_batch(batch_buffer)
            batch_buffer.clear()

        print(f"流式读取完成,累计处理 {total_rows} 行数据。")

    finally:
        # 必须显式关闭工作簿,释放 Zip 句柄与底层临时资源
        wb.close()

def flush_batch(data_chunk):
    # 此处执行业务批量处理,例如 executemany 或批量落盘
    pass
三、关键优化细节与必须规避的陷阱
虽然 read_only=True 能极大地减少内存占用,但由于底层工作方式从 DOM 树改为了单向流式事件监听,代码的编写方式和 API 表现存在显著差异。如果忽视这些差异,可能会导致读取结果错误或重新陷入性能陷阱。
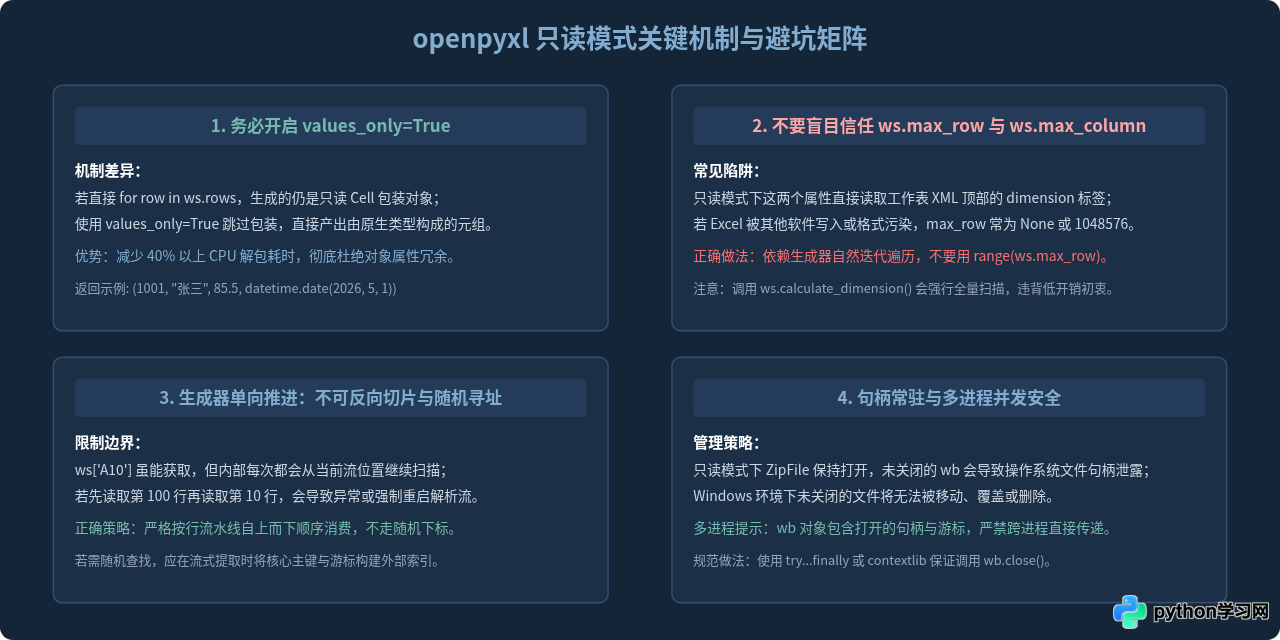
实用提示:在只读模式下,如果只需要读取指定的列范围,可以通过 ws.iter_rows(min_row=2, min_col=1, max_col=5, values_only=True) 来限定解析边界。底层的 XML 解析器会跳过非目标列的字段解析,进一步减少 CPU 开销。
四、更进一步:大型 Excel 数据处理的技术选型对比
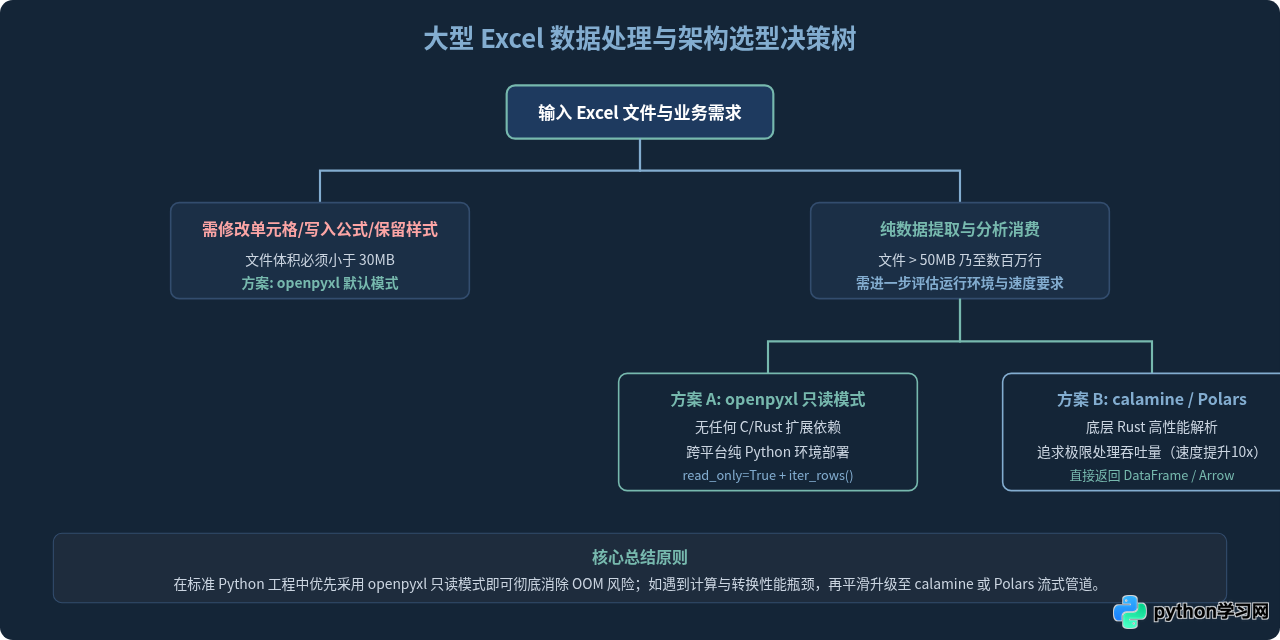
虽然 openpyxl 的 read_only=True 彻底解决了内存暴涨问题,但在面对超大规模数据(例如百万行以上)时,纯 Python 实现的解析速度可能成为新的瓶颈。根据不同的业务场景,选用最适宜的工具链才能达到性能与稳定性的最佳平衡。
| 处理方案 | 内存消耗 | 读取速度 | 适用典型场景 |
|---|---|---|---|
| openpyxl (普通模式) | 极高 (2-5GB+) | 慢 | 小型文件(<20MB),需频繁修改单元格格式、公式或样式回写 |
| openpyxl (read_only) | 极低 (30-80MB) | 中等 | 中大型 .xlsx 文件(50-500MB),纯数据提取,且希望保持纯 Python 无外部 C 编译依赖 |
| calamine (python-calamine) | 低 (50-100MB) | 极快 (Rust核心) | 超大 Excel 读取。底层基于 Rust 实现,解析速度是 openpyxl 的 5 到 15 倍 |
| Polars (read_excel) | 中等 (流式列存) | 极快 | 需要对大文件进行复杂聚合、过滤、数据清洗并直接导出为 Parquet 或 Arrow |
| pyxlsb | 低 | 快 | 针对 Excel 二进制工作簿(.xlsb 格式),体积小且读取速度优于 .xlsx |
五、结语
处理大型 Excel 文件的核心在于改变数据消费的思维模式——从一次性将整个文件搬进内存的“整体装载”,转变为按需解析、用完即弃的“流水线消费”。
在实际工程中,只需牢记 read_only=True、values_only=True、按行单向迭代以及在 finally 块中调用 wb.close(),即可在零外部依赖的前提下,以数十兆内存平稳解析几百兆的复杂 Excel 表格,彻底告别服务器内存告警。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















