


Python字符串清洗技巧:strip、replace与join的高效组合
深入解析Python中strip、replace与join三大核心字符串处理方法的机制与边界,掌握高效串联清洗文本的高性能组合模式。
在数据采集、接口调用及日志解析等实际业务中,原始文本常常伴随首尾多余空白、不可见换行符、冗余特殊字符以及混乱的内部间距。高效清洗这类数据无需一律依赖复杂的正则表达式,借助 Python 内建的 strip、replace 与 join 三个原生字符串方法,通过合理的顺序编排与链式组合,就能以极低的内存开销与执行成本完成绝大多数文本标准化工作。
一、清洗流程架构与执行管线
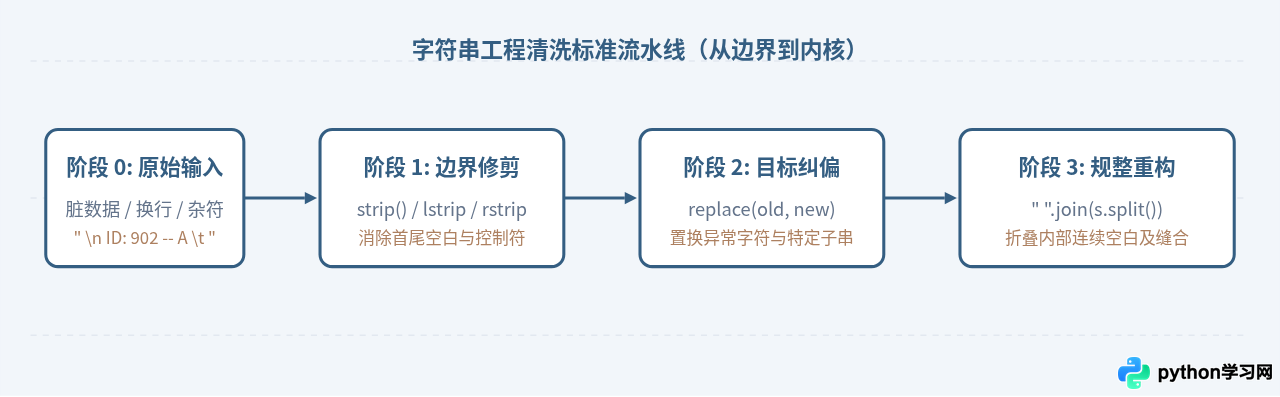
对杂乱文本进行清洗时,若随意调用函数,不仅容易产生不必要的中间字符串对象,还可能因处理顺序不当导致边缘情况遗漏。最稳健的清洗管线通常遵循“边界去噪 → 字符纠偏 → 结构重组”三步法:首先清除文本外围的空白与修饰符,再修正文本内部已知的错误子串或异常标点,最后按规范间距重组单词序列。
二、核心三方法的功能边界与作用机制
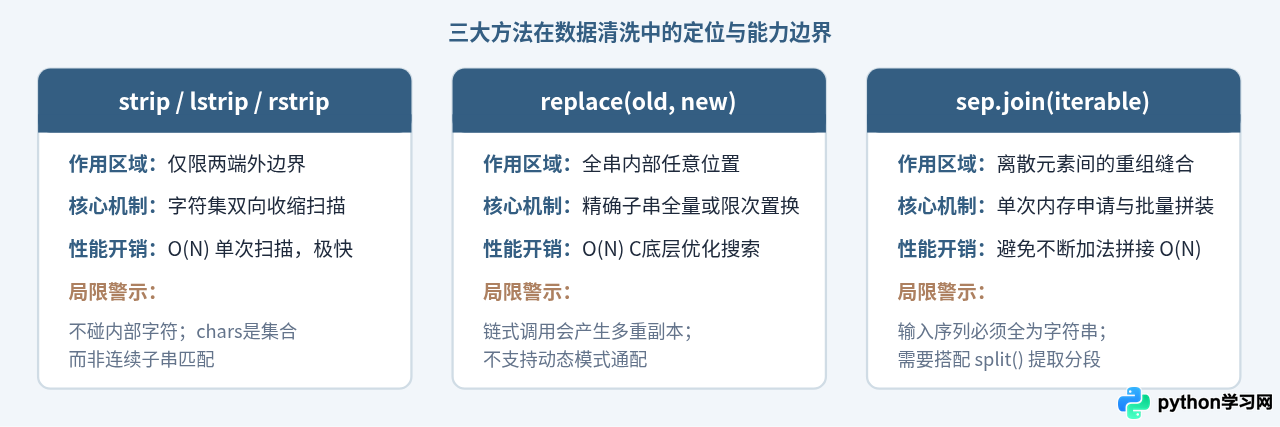
在设计高效清洗组合之前,必须准确掌握每个方法的核心职责与其不能越过的边界:
strip([chars]):专门负责去除字符串开头与末尾的指定字符集。默认剔除所有空白符(包括空格、\t、\n、\r、\v、\f)。注意:它完全不触及字符串内部的内容。replace(old, new[, count]):在整个字符串范围内查找并替换目标子串。它是绝对精确匹配,不区分词边界;当仅需替换已知错误标记或标准化固定符号时,其 C 语言级底层实现远快于正则表达式。join(iterable):利用指定连接符将可迭代对象中的所有元素缝合成新字符串。当与split()结合时,它能以极致的内存布局将任意连续不规则空白折叠为唯一定长分隔符。
三、经典清洗场景与高效组合模式
模式 1:strip + replace 消除脏包装与非法符号
在抓取表格文本或 CSV 导出内容时,单元格经常带有双引号、制表符及反斜杠转义字符。使用 strip 清理外围引号,紧接着使用 replace 替换内部特殊转义,可以做到直截了当的解构:
# 示例:处理带有多余引号和转义符的原始字段
raw_text = '  "\"Python 自动化清洗\"" \t\n '

# 先修剪两端空白及外层双引号,再修正内部转义
cleaned = raw_text.strip().strip('"').replace(r'\"', '"')
# 示例输出: 'Python 自动化清洗'
模式 2:split + join 规范化内部多重混乱空白
很多开发者试图通过多次 replace(" ", " ") 去除连续空格,这种循环写法效率低下且无法一次性处理制表符与换行符。Python 的 split() 在不传参数时,会自动将任意长度的连续空白字符(空格、\t、\n 等)作为统一分隔符切分并剔除两端空白,配合 " ".join() 即可瞬间完成空白折叠:
# 示例:处理掺杂多重空格、Tab 和换行的脏句子
messy_line = "数据清洗    技巧:\tstrip, \n replace 与   join "

# 不传参 split() 会折叠所有连续空白并切分,再由 join 以单个空格连接
normalized = " ".join(messy_line.split())
# 示例输出: '数据清洗 技巧: strip, replace 与 join'
模式 3:三者协作的复合清洗时序
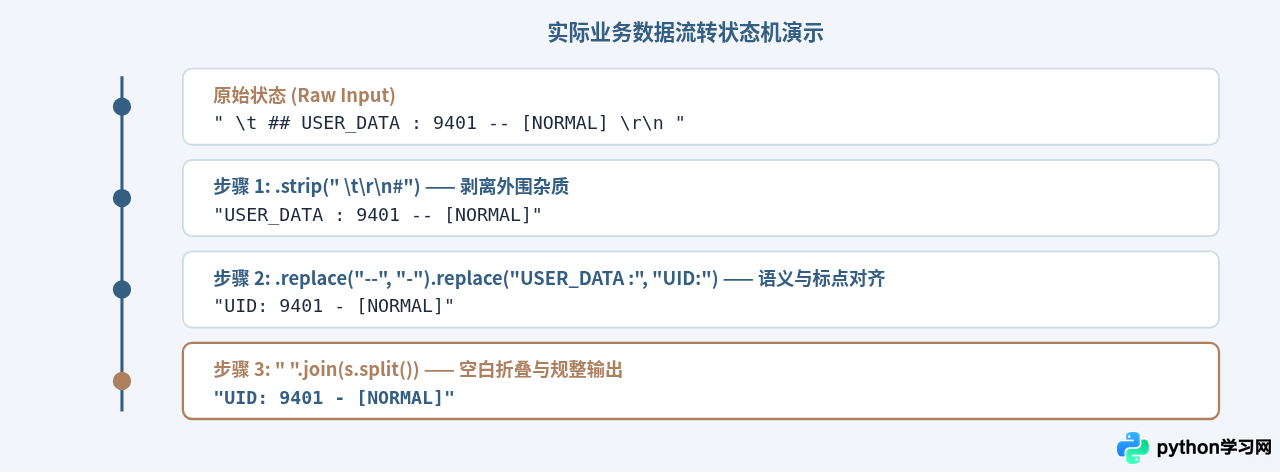
面对更复杂的实际记录(例如字段带有废弃前缀、下划线占位符与脏标点),我们可以让三者协同运作:先用 strip 截断边缘杂质,再用 replace 统一业务标记,最后借由 split().join() 重组标准格式。
四、常见误区与避坑指南
很多初学者容易误写 "https://example.com".strip("https://")。在 Python 中,strip 的参数代表的是一个字符集合(Character Set),只要两端出现集合中的任意字符就会被持续剥离,直到遇到非集合字符为止。如果目标是严格剥除确定的前后缀,在 Python 3.9 及以上版本应优先使用 removeprefix() 与 removesuffix(),而在老版本中则应使用切片或精确判断。
在实际编码中还应警惕以下两点性能与逻辑陷阱:
- 避免在循环体中使用
+累加拼接:Python 字符串是不可变对象,循环累加会导致频繁开辟新内存并拷贝旧字符,时间复杂度急剧恶化为 O(N²)。始终应在列表中收集清洗好的分段,最后一次性调用"".join(list)。 - 大批量多字符替换优先使用
str.translate():如果需要连续调用五六次replace()去除或替换单个标点符号,每次调用都会产生完整的中间临时字符串。对于单字符映射,预先构建str.maketrans()并调用translate()会比连缀多个replace()快 3 到 5 倍。
五、清洗策略决策指南与工程落地
在面对未知文本清洗任务时,可参照以下决策路径选取最合适的函数组合:
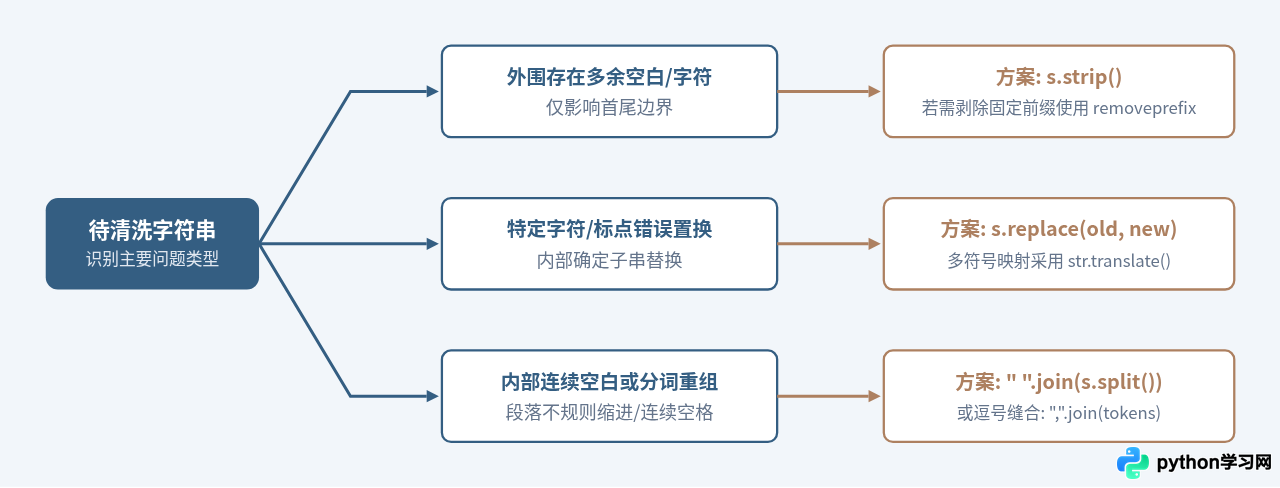
标准工程清洗函数实现
下面是一个封装好的可复用清洗函数,它将 strip、replace 与 join 有机结合,可作为批量文本预处理的参考模版:
def sanitize_text(text: str) -> str:
    """
    通用文本清洗函数:
    1. strip 去除两端不可见控制字符
    2. replace 规范常见中文全角符号与脏标记
    3. split + join 折叠多重空白并保证单词间距单一
    """
    if not isinstance(text, str):
        return ""

    # 第一步:首尾去噪
    stage1 = text.strip()
    if not stage1:
        return ""

    # 第二步:针对性纠偏常见非规范符号
    stage2 = (
        stage1.replace("\ufeff", "")   # 去除 UTF-8 BOM 标记
              .replace("\u3000", " ")  # 将全角空格替换为半角空格
              .replace(",", ",")      # 统一英文逗号(按业务需要)
    )

    # 第三步:折叠内部多重空白并缝合
    final_cleaned = " ".join(stage2.split())
    return final_cleaned

# 验证测试
if __name__ == "__main__":
    sample = "  \ufeff【用户数据】 \u3000 Python字符串清洗   技巧,高效实战 \n\r\t "
    result = sanitize_text(sample)
    print("清洗前:", repr(sample))
    print("清洗后:", repr(result))
    # 示例输出: '【用户数据】 Python字符串清洗 技巧,高效实战'
掌握这三个内建函数的机制差异与组合逻辑后,面对多数文本清洗需求即可快速写出简洁、直观且执行性能极佳的代码,而无需过早引入复杂繁重的外部工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















