


Python高效拼接字符串:join方法与+运算符性能对比
深入对比Python中str.join()方法与+运算符在字符串拼接时的性能差异与底层内存机制,提供基准测试代码、选型指南与工程最佳实践。
+ 运算符直观简短;但在集合聚合或循环遍历场景下,使用 str.join() 能避免反复分配内存与全量拷贝,执行效率往往有数十倍甚至上百倍的提升。本文通过底层内存机制剖析、基准性能实测与多场景选型对照,讲透两种拼接方式的核心差异与使用准则。
一、底层机制:为什么+与join在规模扩大后差异巨大
在 Python 语言中,字符串对象(str)是不可变类型(immutable)。这意味着一旦一个字符串在内存中完成分配,其内部存储的字符序列便无法被原地扩容或就地修改。正是这一核心设计,决定了 + 运算符与 str.join() 方法在处理规模数据时产生本质性能鸿沟。
1. 加号运算符的累加拷贝瓶颈
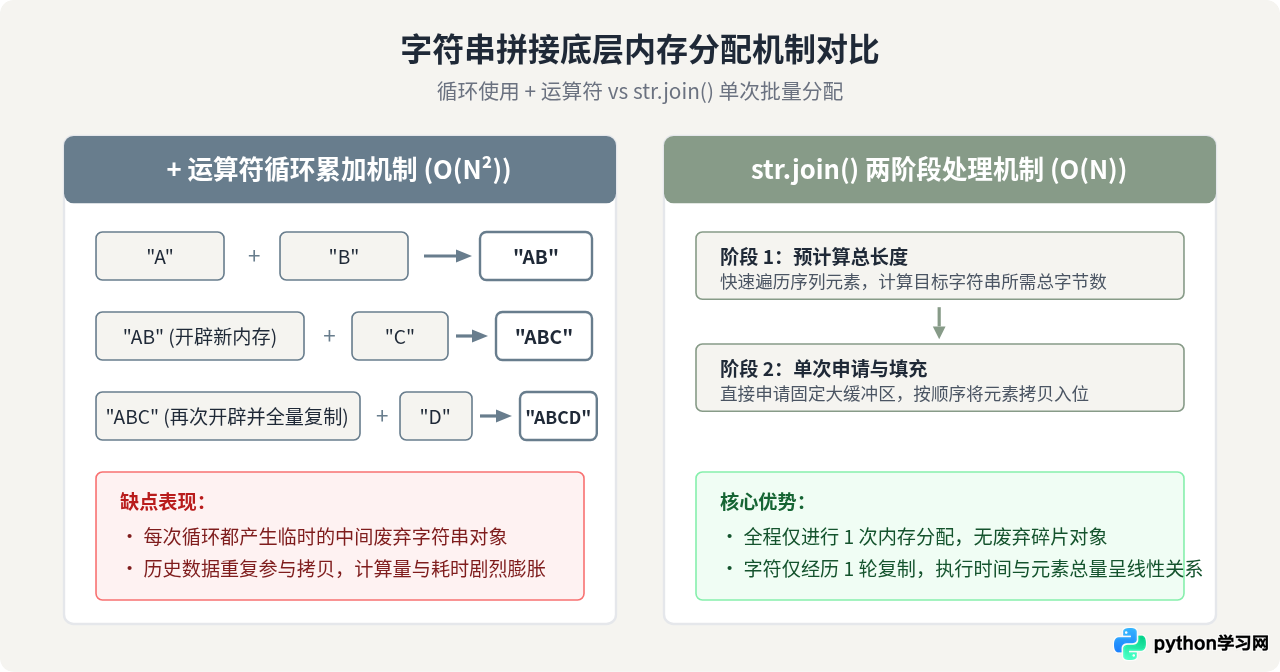
当执行 s = s + item 时,Python 解释器必须在内存中开辟一块能够容纳两部分字符之和的新内存块,然后分别将 s 与 item 的内容逐字节复制到新块中,最后将变量名 s 重新绑定到新对象。在遍历包含 $N$ 个字符串的列表时,每次追加都会把之前已经拼好的所有字符再次完整拷贝一次。整个累加过程累计复制的字符总量呈等差数列累加,算法复杂度上升至 $O(N^2)$。
2. join方法的两阶段单次分配
与持续开辟小块内存不同,str.join() 采用两阶段(Two-pass)处理方案。第一阶段,解释器遍历一遍传入的可迭代对象,统计所有子字符串的长度之和以及必要分隔符的长度;第二阶段,系统在堆内存中一次性申请恰好容纳最终结果的大缓冲区,随后按顺序批量将各子串复制到缓冲区相应偏移处。因此,整个过程仅产生一次内存分配与单轮字符复制,时间复杂度严格保持为 $O(N)$。
二、性能测量:使用 timeit 模块实测基准差距
为了准确量化性能差异,我们使用 Python 标准库中的 timeit 模块进行严谨测试。避免使用简陋的 time.time() 差值,因为 timeit 会自动规避垃圾回收干扰并进行多次重试采样,结果更加客观可信。
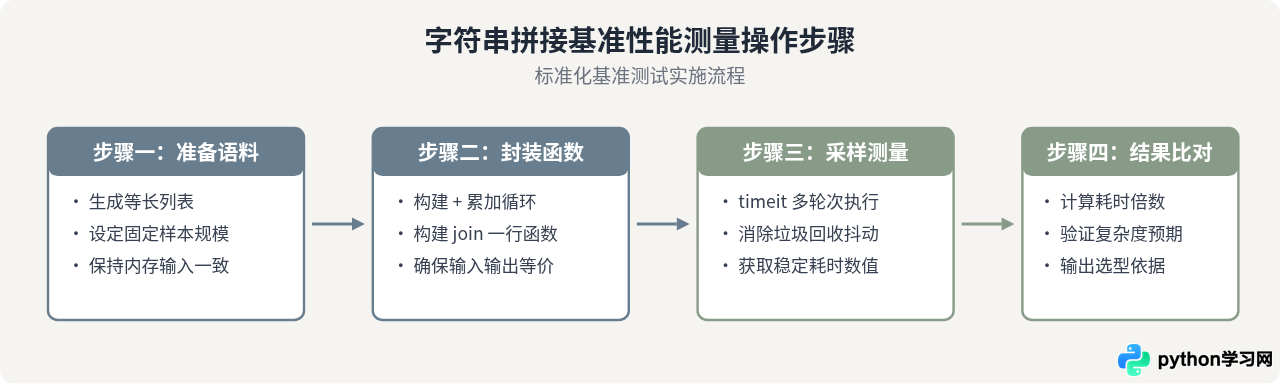
测试步骤与实施代码
- 准备语料序列:构造一个包含 5,000 个短字符串的列表(每个元素为包含 10 个字符的固定短串)。
- 封装拼接逻辑:分别构建循环使用
+累加的函数与直接调用"".join()的函数。 - 统一采样评测:设定相同的重复执行次数(如每个方法执行 100 次循环),记录最小耗时并进行比对。
import timeit

# 1. 准备测试数据:5,000 个长度为 10 的短字符串
words = ["benchmark_"] * 5000

# 2. 待测函数 A:使用 + 循环拼接
def concat_with_plus(items):
    result = ""
    for item in items:
        result = result + item
    return result

# 3. 待测函数 B:使用 join 方法拼接
def concat_with_join(items):
    return "".join(items)

# 4. 执行性能基准测试(分别执行 100 次)
time_plus = timeit.timeit(lambda: concat_with_plus(words), number=100)
time_join = timeit.timeit(lambda: concat_with_join(words), number=100)

print(f"+ 运算符耗时: {time_plus:.4f} 秒")
print(f"join 方法耗时: {time_join:.4f} 秒")
print(f"性能比值 (Plus / Join): {time_plus / time_join:.2f} 倍")
实测数据典型表现(示例参考)
| 元素数量 (N) | 循环 + 运算符耗时 (秒) | str.join() 耗时 (秒) | 相对速度差异 |
|---|---|---|---|
| 10 个 | 0.00018 s | 0.00015 s | 两者相近 (无明显差异) |
| 100 个 | 0.00220 s | 0.00055 s | join 快约 4 倍 |
| 1,000 个 | 0.08200 s | 0.00310 s | join 快约 26 倍 |
| 10,000 个 | 7.95000 s | 0.02800 s | join 快约 280+ 倍 |
从实测数据能够清晰看到:当待拼接数量仅有十来个以内时,两者的绝对用时都在亚毫秒级别,差别微乎其微;而随着元素规模增加到数千乃至数万时,+ 运算符由于反复申请内存和拷贝字符,耗时呈现剧烈陡升,而 join 始终保持平缓上升。
s += item 有时并未产生预想中那么夸张的耗时。这是因为 CPython 针对最后一个且唯一的字符串引用实现了一种就地重分配(realloc)优化。然而,这种优化属于解释器的未承诺实现细节,一旦对象被全局引用、在列表传递中存在其他强引用、或在多线程/协程中共享,该优化便会立刻失效退化为 $O(N^2)$。因此在生产工程中绝不可依赖 += 的偶发优化。
三、不同场景下的拼接方案选型指南
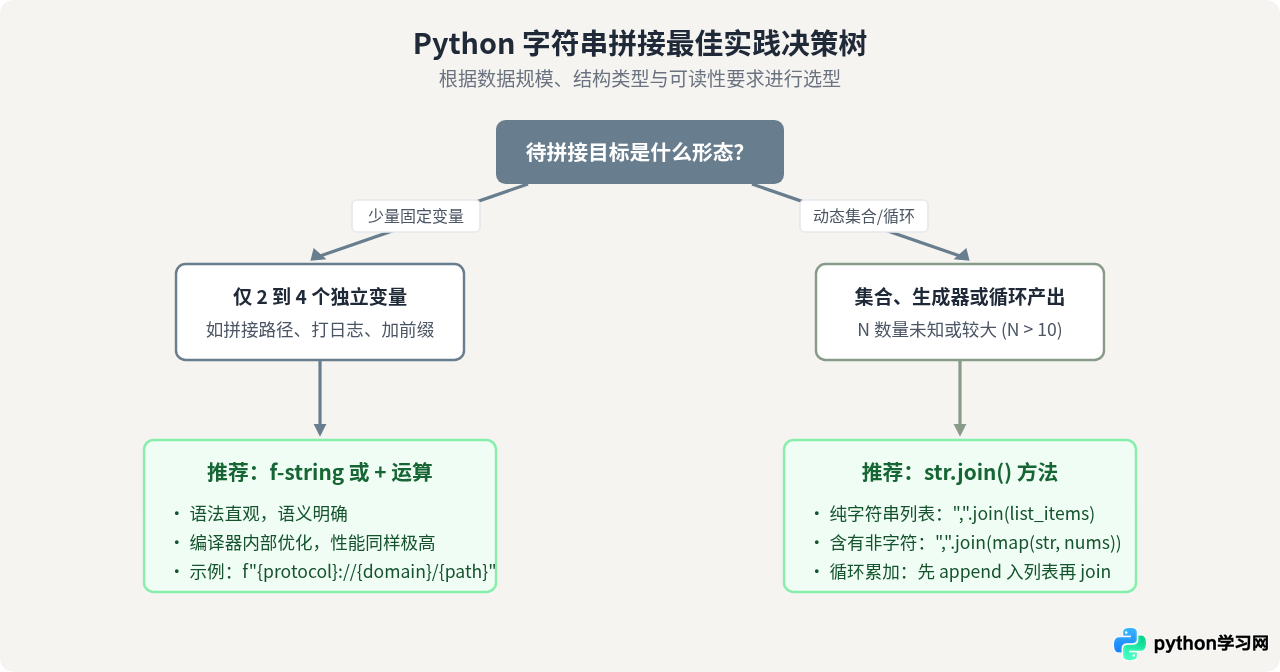
虽然 str.join() 拥有更优秀的渐进复杂度,但并不意味着所有拼接场景都要生硬替换。合理根据数据源形态与变量个数进行针对性选型,才是兼顾运行效率与代码可读性的正确做法。
常见代码对比与注意事项
1. 循环内追加字符串的反模式与正解:
# ❌ 低效反模式:循环中不断执行 +=
output = ""
for record in large_dataset:
    output += record.to_text() + "\n"

# ✅ 规范高效做法:先收集到 list,循环结束后一次性 join
chunks = []
for record in large_dataset:
    chunks.append(record.to_text())
output = "\n".join(chunks)
2. 包含非字符串类型的数据:
+ 运算符在左右操作数类型不一致时会抛出 TypeError;而 str.join() 同样要求可迭代对象内的元素全部为 str。如果列表包含整数、浮点数或字典,推荐使用 map(str, iterable) 结合 join,不仅免去了手动循环,而且执行效率极佳:
ids = [101, 102, 103, 104, 105]

# 优雅高效地将数字列表转为逗号分隔的 SQL 条件或参数
id_string = ",".join(map(str, ids))
# 输出结果: "101,102,103,104,105"
四、核心要点总结
理解底层原理有助于写出更加健壮优雅的 Python 代码。在面对字符串拼接需求时,牢记“少量直观、批量聚集”的原则:
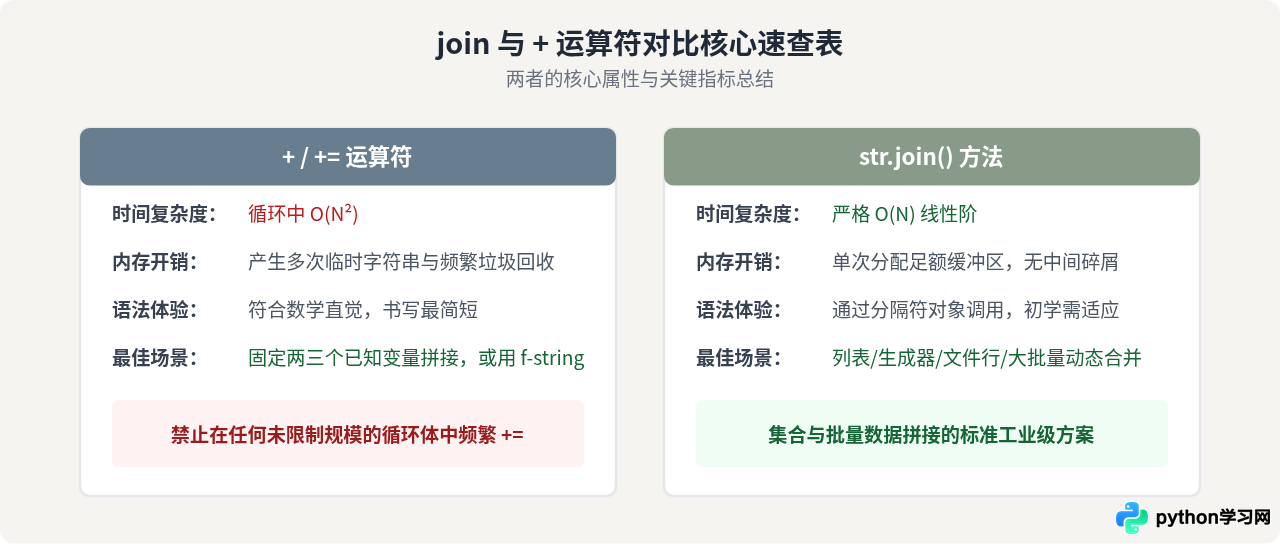
- 2 到 3 个固定变量拼接:优先使用
f"{var1}_{var2}"或直接用+,代码直观清晰且开销极小。 - 批量元素或迭代器集合:无条件选用
"".join(sequence),享受线性时间复杂度与低内存开销。 - 非字符串序列:组合使用
map(str, sequence)与join(),简洁兼顾高性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















