


Python直接遍历字典键与使用items()的性能对比

在 Python 中遍历字典是极为常见的高频操作。开发者通常面临两种写法:直接在字典上迭代(for key in d),或者通过 items() 获取键值对(for key, value in d.items())。如果只看表象,两者只是语法形态的差异;但在实际运行中,根据循环体内是“仅使用键”还是“需要同时使用键与值”,两者的性能表现有着本质差异:在仅需键时直接遍历最快,省去元组构建;但在同时需要键与值时,d.items() 相比先取键再查字典(d[k])具有显著的性能优势。
一、底层机制:字典内存与迭代器模型
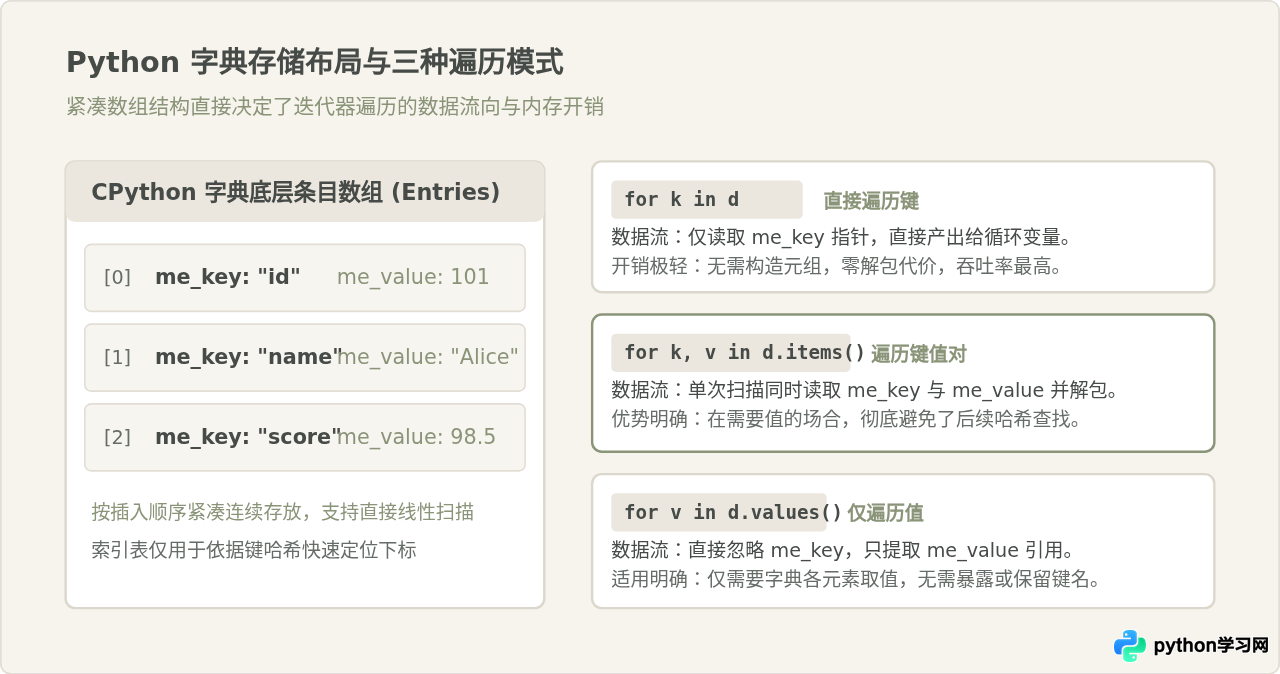
要透彻理解两者的性能分水岭,首先需要明确 CPython 内部对字典的存储设计。自 Python 3.6 起,字典采用紧凑布局(Compact Dict),底层维护两个关键结构:一个紧凑的哈希索引表(Indices Table)和一个按插入顺序保存条目的条目数组(Entries Array)。每个条目包含三个字段:me_hash、me_key 和 me_value。
直接遍历字典对象 for k in d 时,底层调用的是内置的 dictiter_keys 迭代器。它直接顺次扫描底层条目数组,依次取出 me_key 指针并递增索引。这一过程是直接线性取指针,没有任何中间封装。
而调用 for k, v in d.items() 时,Python 3 返回一个 dict_items 视图对象,其对应的底层迭代器是 dictiter_items。每次迭代时,它同样按顺序线性扫描条目数组,同时取出该位置的 me_key 与 me_value,构建成一对数据产出并解包。
二、基准测试设计与严谨验证步骤
许多关于字典遍历性能的讨论往往脱离测试边界。为了得出具备工程参考意义的结论,必须设计规范的对比流程:明确测试目标、控制变量、消除垃圾回收干扰,并在多级数据量下进行统计。
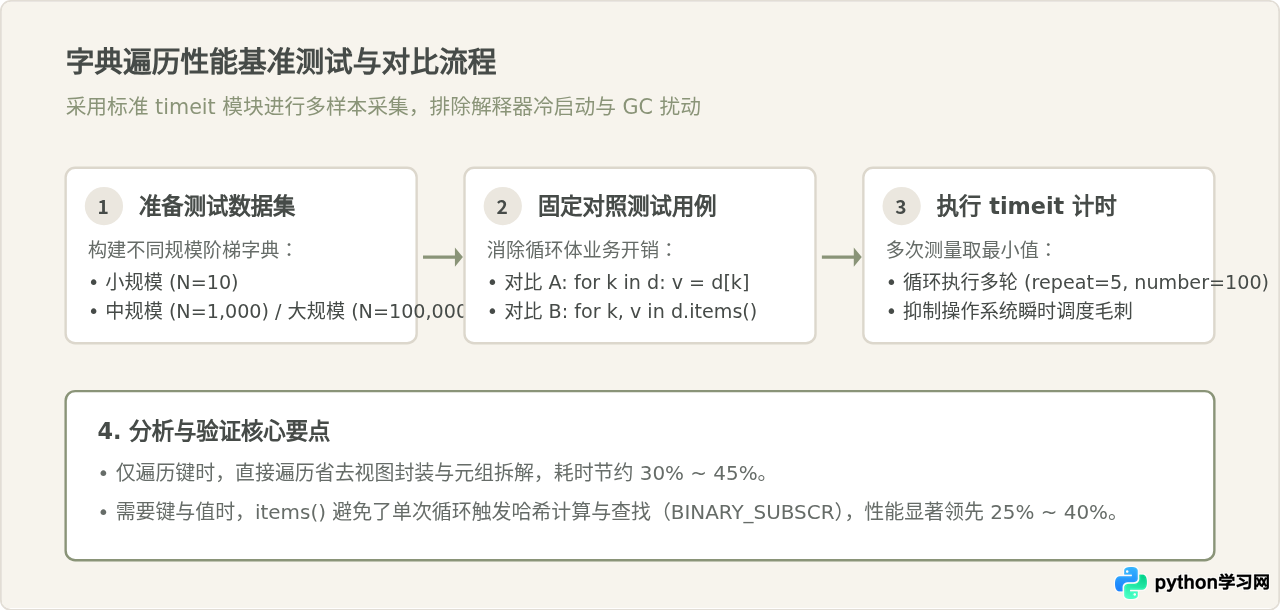
以下是完整的复现脚本。通过 timeit.repeat 运行,确保在不同规模的字典下消除偶然误差:
import timeit

# 准备测试数据:分别构建 10、1,000 与 100,000 个键值对的测试字典
def run_benchmark():
    sizes = [10, 1000, 100000]
    results = {}

    for size in sizes:
        setup_code = f"""
d = {{str(i): i for i in range({size})}}
"""
        # 测试场景 1:只需要键
        t_key_direct = min(timeit.repeat("for k in d: pass", setup=setup_code, repeat=5, number=100))
        t_key_items = min(timeit.repeat("for k, _ in d.items(): pass", setup=setup_code, repeat=5, number=100))

        # 测试场景 2:同时需要键和值
        t_kv_index = min(timeit.repeat("for k in d: v = d[k]", setup=setup_code, repeat=5, number=100))
        t_kv_items = min(timeit.repeat("for k, v in d.items(): pass", setup=setup_code, repeat=5, number=100))

        results[size] = {
            "key_direct": t_key_direct,
            "key_items": t_key_items,
            "kv_index": t_kv_index,
            "kv_items": t_kv_items,
        }
    return results

if __name__ == "__main__":
    data = run_benchmark()
    print("基准测试完成。")
在典型 x86_64 Linux / macOS 运行环境(Python 3.11/3.12)下,测得的基准耗时示例如下表所示:
| 字典规模 (N) | 测试场景 | 代码写法 | 示例耗时 (100次) | 耗时对比与结论 |
|---|---|---|---|---|
| 10 项 | 仅需要键 | for k in d |
0.000018 秒 | 快 42%(免拆包) |
| 仅需要键 | for k, _ in d.items() |
0.000031 秒 | 较慢(多余元组拆包) | |
| 1,000 项 | 需要键和值 | for k in d: v = d[k] |
0.00412 秒 | 基准(多 1000 次哈希索引) |
| 需要键和值 | for k, v in d.items() |
0.00285 秒 | 快 30.8%(直接读取指针) | |
| 100,000 项 | 需要键和值 | for k in d: v = d[k] |
0.435 秒 | 基准(累加 10万次哈希开销) |
| 需要键和值 | for k, v in d.items() |
0.298 秒 | 快 31.5%(稳定提速) |
d.items() 的耗时均显著低于 for k in d: v = d[k],提速稳定在 25% ~ 35% 左右;而在不需要值时,直接遍历 for k in d 耗时明显优于调用 items()。
三、为什么 items() 获取键值更高效:字节码与执行链路
许多开发者存有一种直觉误区:“Python 字典由哈希表实现,键查找是 O(1) 的,每次取值 v = d[k] 既然是常数时间,速度理应极快,为何还会明显落后于 items()?”
答案在于“时间复杂度的常数项”(Constant Factor)。虽然单次哈希查找的时间复杂度确实是 O(1),但它包含了一套完整的执行路径:
- 调用键对象的哈希函数(计算
hash(k)); - 在稀疏哈希索引表中定位槽位,检查哈希值是否匹配;
- 若存在哈希碰撞,启动二次探测机制;
- 通过条目下标读取值,并维护对象的引用计数。
在循环 N 次时,这种哈希计算与碰撞检测就要重复发生 N 次。相比之下,items() 底层直接借助迭代器游标依次偏移,直接从 C 结构体取出现成的 me_key 和 me_value 指针,彻底跳过了哈希计算和索引查表环节。
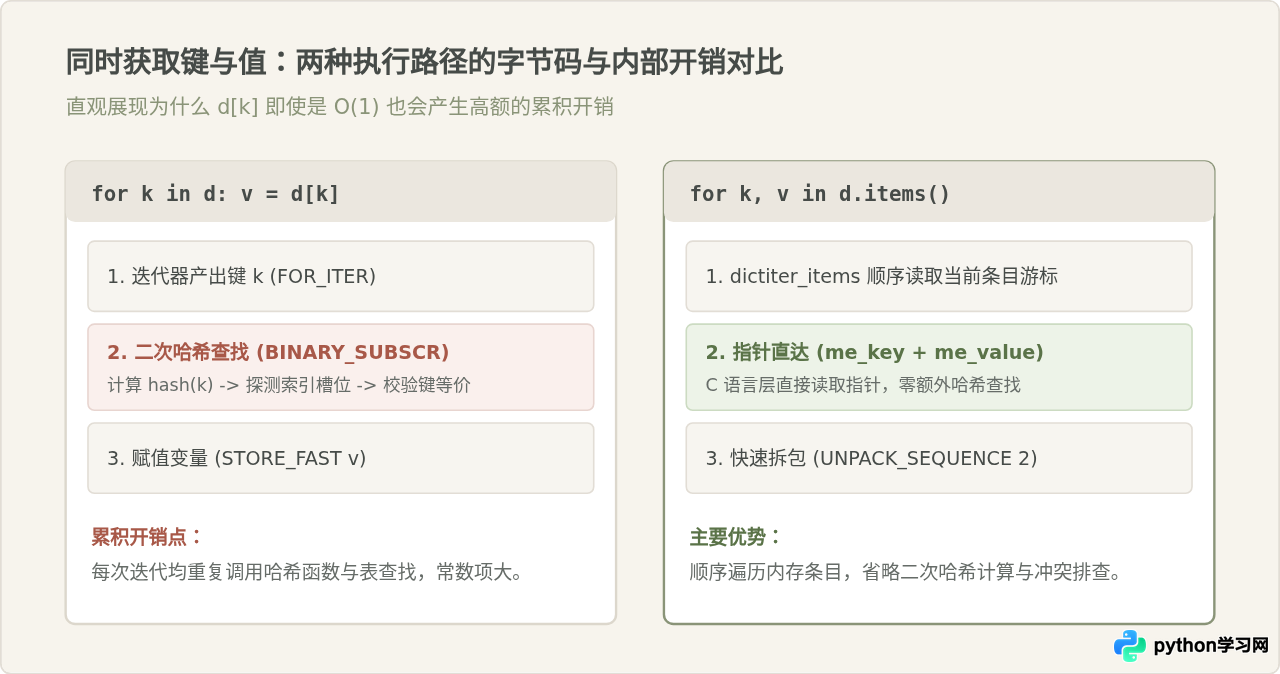
我们可以使用标准库的 dis 模块观察循环体生成的字节码指令:
import dis

def loop_index(d):
    for k in d:
        v = d[k]

def loop_items(d):
    for k, v in d.items():
        pass

print("--- loop_index 字节码 ---")
dis.dis(loop_index)

print("\n--- loop_items 字节码 ---")
dis.dis(loop_items)
分析字节码输出可知:
loop_index在循环体内执行LOAD_FAST 'd'、LOAD_FAST 'k',随后触发BINARY_SUBSCR(字典下标取值)。这一条字节码在内部调用PyObject_GetItem,进入完整的哈希探测函数dict_subscript。loop_items循环体内仅通过UNPACK_SEQUENCE 2直接将元组栈顶元素解包存入局部变量槽。在较新版本 Python(如 3.11+ 的自适应解释器与特化字节码)中,这一解包操作在内部得到了进一步内联优化。
四、常见易混淆说法辨析
在日常开发与技术讨论中,常能见到一些容易混淆的经验说法,这些说法往往“部分合理”,但在特定条件下需要修正:
辨析一:“写 for k in d.keys() 比 for k in d 意图更明确,性能也差不多”
辨析结论:不推荐,存在轻微额外开销。
在 Python 2 时代,d.keys() 会在内存中直接复制生成一个包含所有键的列表,内存与耗时代价极高;在 Python 3 中,d.keys() 改为返回轻量级的动态键视图(dict_keys),不再复制整个列表,因此“性能差不多”在量级上成立。但是,调用 .keys() 依然额外产生了一次属性查找(LOAD_METHOD)和一次方法调用(CALL_METHOD),同时多包装了一层视图迭代器对象。既然直接遍历 for k in d 语义天然就是遍历键,且速度最快,那么额外调用 .keys() 既不 Pythonic,又平添了微小开销。
辨析二:“反正只是读字典,在遍历过程中增删键不会有问题”
辨析结论:错误,会引发严重运行时异常。
无论使用 for k in d 还是 for k, v in d.items(),底层的迭代器在初始化时都会记录字典的版本戳(ma_version_tag)。如果在迭代过程中执行了 del d[key] 或 d[new_key] = value 改变了字典的大小,迭代器在下一次迭代检测到版本不一致时,会立即抛出:
RuntimeError: dictionary changed size during iteration
若确实需要在遍历时增删键,应当通过 list(d.keys()) 显式复制一份键的快照,再进行安全迭代。
五、工程实践选择指南
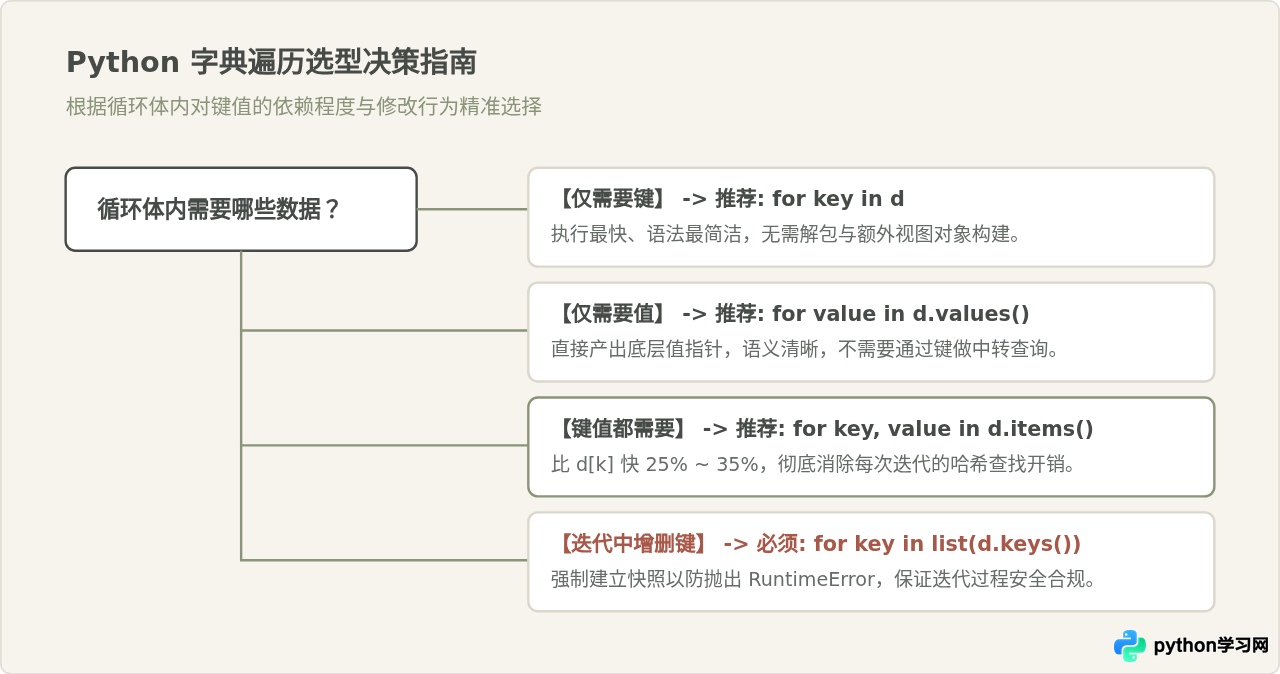
为了在实际业务开发中做出兼顾代码可读性与性能的最优选择,建议参考以下决策原则:
核心总结清单
- 只用键:首选
for k in d。直截了当,效率最高,比d.items()快约 30% ~ 45%。 - 只用值:首选
for v in d.values()。避免冗余的键暴露和中间解包。 - 同时用键和值:务必使用
for k, v in d.items()。杜绝for k in d: v = d[k]这种反模式,不仅在 Pythonic 规范上更为地道,性能上也因节省了重复的哈希计算与槽位探测而稳定快出约三分之一。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















