


python必背源代码字符串反转代码
深入解析Python中实现字符串反转的经典必背源代码,涵盖切片步长语法、reversed内置迭代器、双指针交换、列表转换与递归等5种核心实现方案,详解底层机制与性能差异。
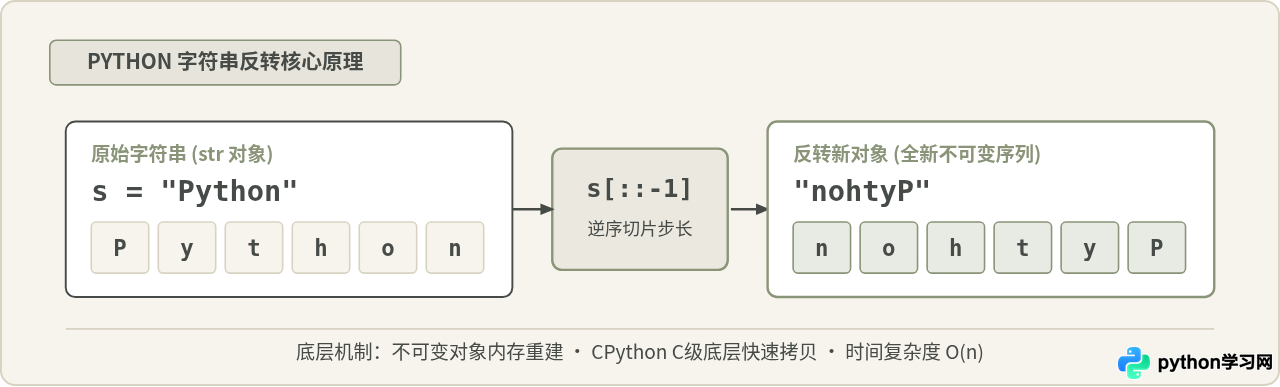
在 Python 中,字符串属于不可变序列(immutable sequence),这意味着任何针对字符串的修改都不能在其原内存地址上直接进行,而是必须通过某种计算规则构建出一个包含目标字符顺序的全新字符串。反转字符串(String Reversal)是日常业务数据清洗、回文检测以及技术面试中频次极高的基础操作。解决这一问题有多种途径,从性能极致的一行切片语法,到规范的迭代器组合,再到底层考察的双指针原地交换,理解并背诵这些核心源代码不仅能帮助我们应对开发需求,更能让我们彻底摸透 Python 底层的内存设计逻辑。
一、首选工业级解法:切片步长语法 s[::-1]
在绝大多数实际工程项目中,反转字符串的标准答案就是切片语法 s[::-1]。它的语法最为精炼,且在 CPython 解释器内部直接由 C 语言循环进行底层内存数据拷贝,没有任何额外的 Python 函数调用栈与对象打包开销,运行效率在所有方法中稳居第一。
核心源代码实现
def reverse_by_slice(s: str) -> str:
    # 使用完整扩展切片语法,步长为 -1 表示从右向左逐字符提取
    return s[::-1]

# 运行示例
original_str = "Hello, Python!"
result = reverse_by_slice(original_str)
print(f"原始字符串: {original_str}")
print(f"反转结果: {result}")反转结果: !nohtyP ,olleH
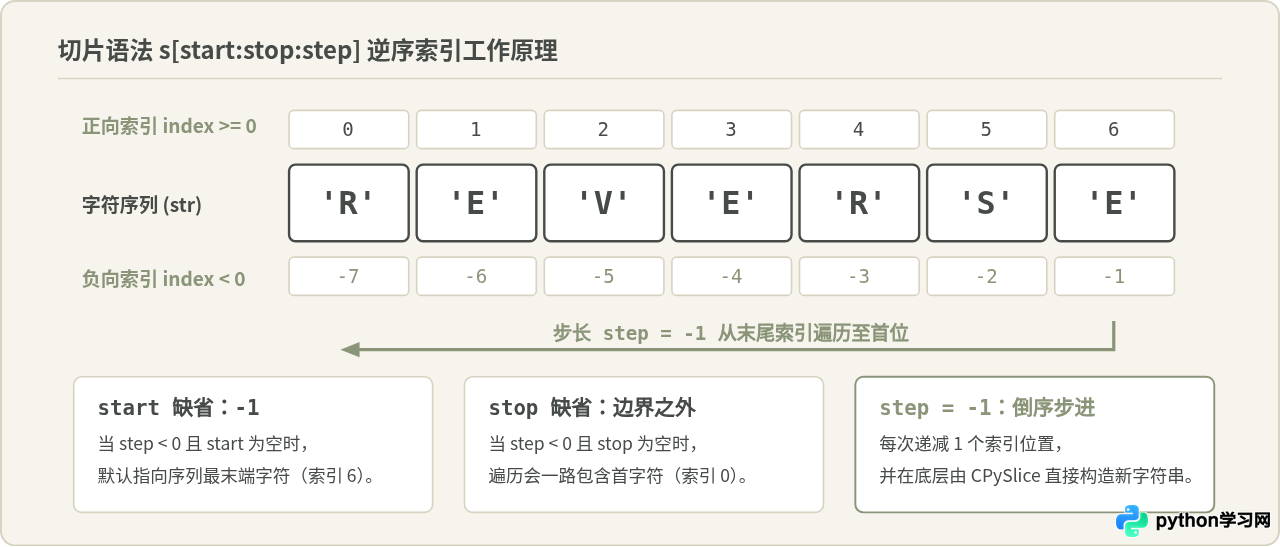
切片步长语法运行机制解析
Python 切片完整语法形式为 s[start:stop:step]:
- start(起始索引):当步长
step > 0时,缺省值为0;而当step < 0时,缺省值自动调整为-1,即指向序列末尾字符。 - stop(终止索引):切片遵循左闭右开区间。当
step < 0且stop留空缺省时,系统会将边界延伸至索引0之前(数学意义上的-len(s) - 1),确保最左侧的第一个字符也被完整提取。 - step(步进跨度):传入
-1意味着游标每次递减 1 个单位,从末尾向前推进。
初学者常常会误以为可以直接调用 s.reverse(),运行后会抛出 AttributeError: 'str' object has no attribute 'reverse'。原因在于 Python 标准库的命名哲学:list.reverse() 是一个原地修改(in-place mutation)方法,直接改变原列表内部指针并返回 None;而 str 具有严格的不可变性(immutability),任何试图原地修改字符串的操作在语法层面均被禁止。因此,字符串的反转必须生成新对象,无法定义就地修改的 .reverse() 成员方法。
二、标准库推荐流式解法:reversed() 结合 ''.join()
如果你希望代码更具自解释性,或者正在处理一个未知的可迭代序列(如包含字符的生成器或自定义序列容器),内置函数 reversed() 是最为规范的选择。配合 ''.join(),可以构建清晰且具备高可读性的生产级反转代码。
核心源代码实现
def reverse_by_reversed_join(s: str) -> str:
    # reversed(s) 返回一个反向迭代器,通过 ''.join() 将字符聚合为新字符串
    return "".join(reversed(s))

# 运行示例
target = "DataFrame"
print(reverse_by_reversed_join(target))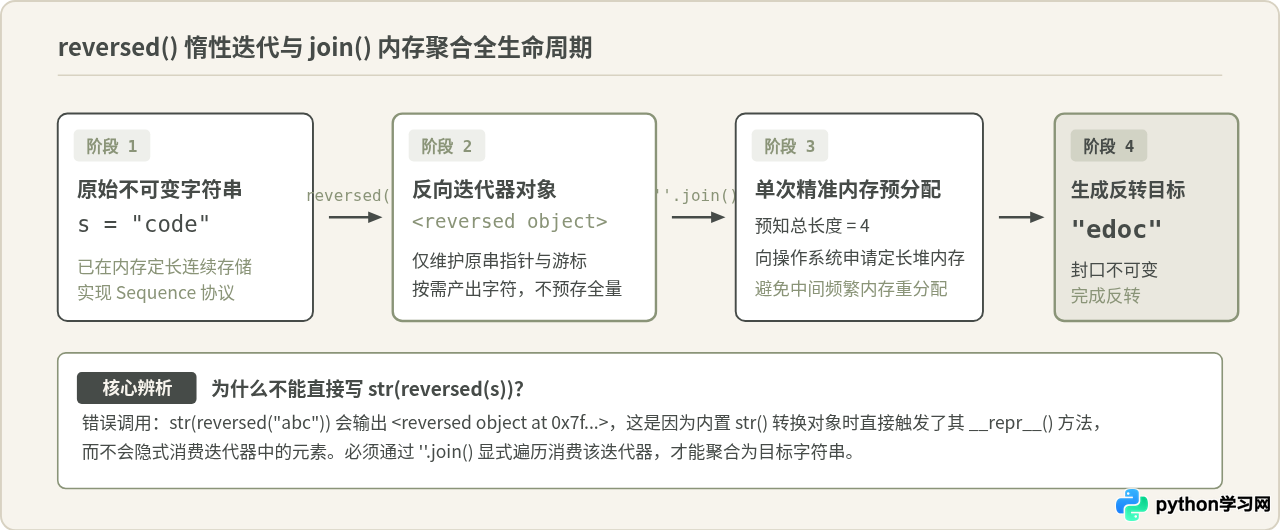
底层工作过程与避坑说明
reversed() 是 Python 提供的内置序列反向迭代协议入口。当传入一个字符串 s 时,它并不会立即在内存中创建整份反转副本,而是返回一个 <reversed object>。该对象内部只记录了原字符串的地址引用以及一个从 len(s) - 1 递减的整数索引计数器,具备极佳的内存轻量性。
真正分配内存并组装字符串的操作发生在 ''.join(...) 阶段。在 CPython 实现中,str.join() 具有专门的优化路径:它会先遍历可迭代对象或直接读取已知序列的总长度,向操作系统一次性申请一块定长的目标内存区域,然后按顺序填入各个字符并封口返回。这种机制彻底规避了频繁扩展堆内存的碎片化消耗。
三、算法面试核心考察:双指针原地对称交换法
在算法与数据结构面试中,面试官往往会明确限制:“禁止使用切片 [::-1] 与内置 high-level 函数,请手写反转算法”。此题考察的核心是序列原地对调与双指针向中心逼近的思想。
核心源代码实现
def reverse_by_two_pointers(s: str) -> str:
    # 第一步:因 str 不支持原地索引修改,先转换为可变列表
    char_list = list(s)

    # 第二步:定义左右双指针,分别指向首位和末位
    left = 0
    right = len(char_list) - 1

    # 第三步:循环对调字符,双指针向中间同步逼近
    while left < right:
        char_list[left], char_list[right] = char_list[right], char_list[left]
        left += 1
        right -= 1

    # 第四步:将交换完成的列表重新拼接回字符串
    return "".join(char_list)

# 运行示例
sample_code = "algorithm"
print(reverse_by_two_pointers(sample_code))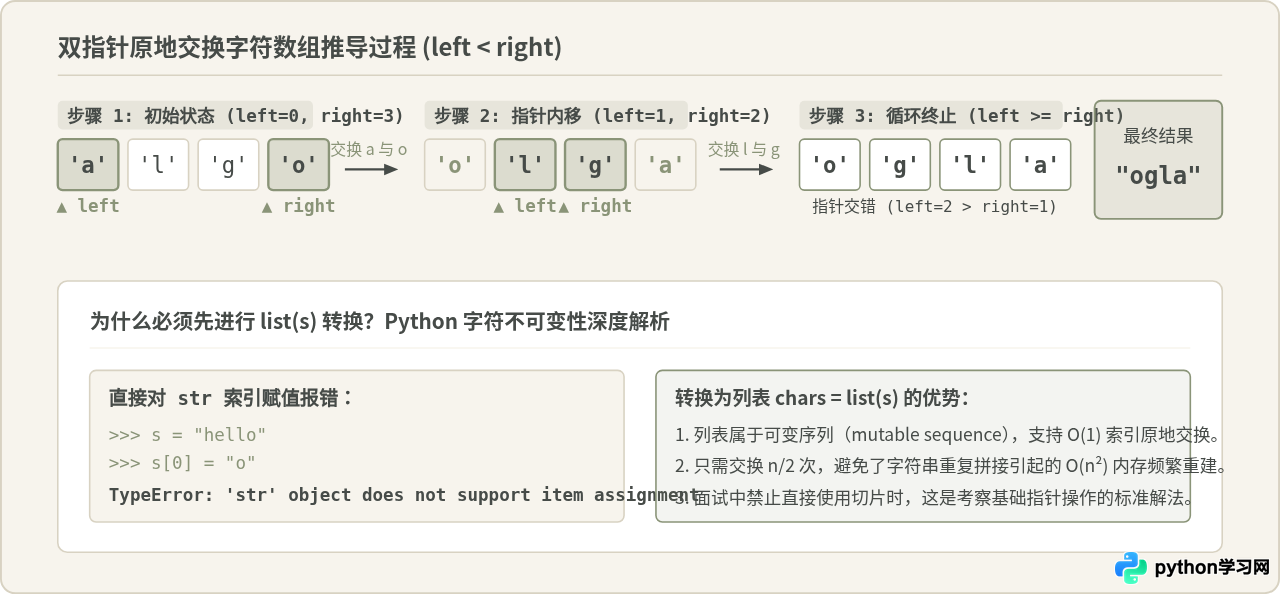
算法步骤与关键边界说明
- 类型转换准备:执行
char_list = list(s)。由于 Python 字符串在物理内存中被保护为只读字节串,直接执行s[left] = s[right]将触发TypeError。将其转为列表后,获得了连续的可变指针容器。 - 循环终止条件:判断条件为
while left < right。对于偶数长度字符串(如 4 个字符),两指针完成全部交换后恰好相交(left=2, right=1);对于奇数长度字符串(如 5 个字符),中间的字符无需移动,两指针在中间重合时(left=right=2)循环自然终止。 - 对调操作:利用 Python 元组解包语法
a, b = b, a,无需额外声明中间临时变量temp即可完成对称位置数据的安全交换。
初学者容易写出如下累加循环:
# 严重的反模式(低效代码)
res = ""
for char in s:
    res = char + res  # 每次循环都会创建全新字符串并复制已有内容
由于字符串不可变,每一次 char + res 都会在内存中开辟全新空间,并将之前已经累加的所有字符逐个拷贝过去。处理长度为 n 的字符串时,总拷贝次数为 1 + 2 + 3 + ... + n ≈ n²/2,算法时间复杂度急剧恶化为 O(n²)。当输入文本达到几十万字符时,程序会出现极严重的卡顿。
四、思维延伸与算法变体:递归实现与函数式归约
除了上述三大必背方法外,在计算机科学的函数式编程和分治思维教学中,递归和归约也是展示逻辑推导的经典示例。
1. 递归分治实现
def reverse_recursive(s: str) -> str:
    # 递归基准终止条件(Base Case):空串或单字符直接返回
    if len(s) <= 1:
        return s
    # 递归递推式:反转剩余子串 + 拼接首字符
    return reverse_recursive(s[1:]) + s[0]

# 运行示例
print(reverse_recursive("recursion"))工程局限提醒:递归算法虽然在数学结构上极为优美,但在 Python 中存在实际约束。Python 解释器默认设有调用栈深度上限(可通过 sys.getrecursionlimit() 查看,通常为 1000 级)。当待反转字符串长度超过该深度时,会直接抛出 RecursionError: maximum recursion depth exceeded。此外,每一层递归都会产生子串切片开销,因此此方案仅用于算法原理教学,不适用于生产环境。
2. 函数式归约(reduce)实现
from functools import reduce

def reverse_by_reduce(s: str) -> str:
    # 将每个新字符累加在当前累积结果的前端
    return reduce(lambda acc, char: char + acc, s, "")

# 运行示例
print(reverse_by_reduce("functional"))五、5种反转代码核心特性对比与工程选型指南
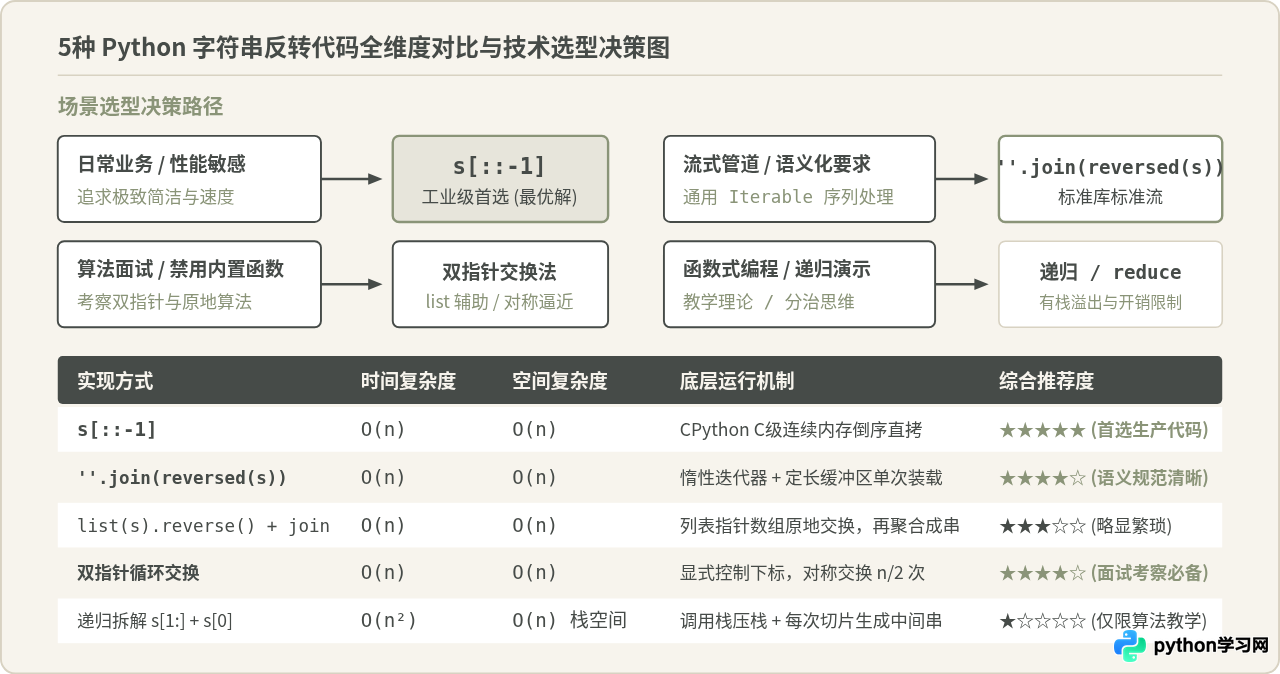
为了帮助读者根据实际场景精准选型,下表对 Python 中常见的 5 种反转代码进行了多维度对比:
| 实现方法 | 典型核心代码 | 时间复杂度 | 额外空间复杂度 | 主要适用场景 |
|---|---|---|---|---|
| 切片法 | s[::-1] |
O(n) | O(n) | 日常业务开发首选,C 底层极速运行 |
| reversed 迭代法 | ''.join(reversed(s)) |
O(n) | O(n) | 通用迭代器处理、注重代码可读性与语义化 |
| 列表内置反转 | chars=list(s); chars.reverse(); ''.join(chars) |
O(n) | O(n) | 已有字符列表需要反转并组装的复合操作 |
| 双指针交换法 | while left < right: swap(...) |
O(n) | O(n) | 编程算法面试、考察基础数据结构与指针控制 |
| 递归分治法 | reverse(s[1:]) + s[0] |
O(n²) | O(n) 栈深度 | 递归理论教学、树与链表逆序思维推演 |
六、进阶注意事项:Unicode 组合字符与边界检查
在处理国际化文本或富文本时,字符串反转还存在一个容易被忽视的细节:Unicode 组合字符(Combining Grapheme Clusters)。
例如带声调的字母(如 é,由基础字符 e 与组合声调符号 ́ 组成)或带肤色修饰的 Emoji(如 👍🏻)。在 Python 的标准 str 索引体系中,它们被视作两个独立的 Unicode 码点(Code Points)。如果直接使用 s[::-1] 反转,修饰符会被排在基础字符之前,导致原本的字符发生渲染错乱甚至变成两个乱码符号。
# Unicode 组合字符反转边界示例
accent_char = "é"  # 实际展示为带重音的 é
print(list(accent_char))  # 输出: ['e', '́']

reversed_accent = accent_char[::-1]
print(repr(reversed_accent)) # 输出: '́e'(声调跑到前面,结合发生异常)解决方案:若业务场景涉及大量复杂多语言文本或 Emoji 表情包处理,建议在反转前使用 Python 标准库 unicodedata.normalize('NFC', s) 进行标准等价合成,或者引入第三方专用字形簇库(如 grapheme 库)按人类视觉感知的“字形簇”(Grapheme Cluster)为单元进行分割反转,从而确保特殊符号的展示完整性。
总结
掌握 Python 字符串反转代码的关键在于理解字符串的不可变性与切片步长机制:
- 实际生产项目毫不犹豫选用
s[::-1],代码最短、意图明确、执行速度最快。 - 希望代码具备良好的自解释性或处理通用迭代序列时,使用
''.join(reversed(s))。 - 面试中遇到原地算法考核时,熟练写出双指针向中心对称交换模板,并能清晰向面试官解释为什么必须先转换为列表。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















