


Python爬虫工作原理详解:从发送请求到数据提取
深入解析Python网络爬虫的核心工作原理,从客户端构建与发送HTTP请求,到服务器响应状态解析,再到HTML与JSON数据的精准提取与结构化落地,全流程拆解爬虫底层机制。
网络爬虫的本质是一个自动化的网页请求与数据提取程序。在日常网络交互中,用户通过浏览器输入网址并获取排版美观的信息;而Python爬虫则是通过编写脚本,程序化地模拟浏览器行为,向目标网站服务器发送HTTP/HTTPS网络请求,接收并解析返回的响应内容,最终从海量文本或结构化数据中精确定位所需字段并完成存储。理解爬虫的核心并不在于死记硬背第三方库的API,而在于掌握从底层网络交互到DOM文档对象模型解析的完整数据流向。
一、爬虫底层运行机制与全链路架构
无论爬虫程序规模如何庞大或逻辑如何复杂,其基本工作回路始终围绕“请求(Request)- 响应(Response)- 解析(Parse)- 存储(Store)”四个核心环节循环运转。爬虫扮演客户端角色,直接使用套接字或封装好的HTTP客户端向目标服务器发起TCP握手及TLS加密通信,随后传输标准的HTTP报文。
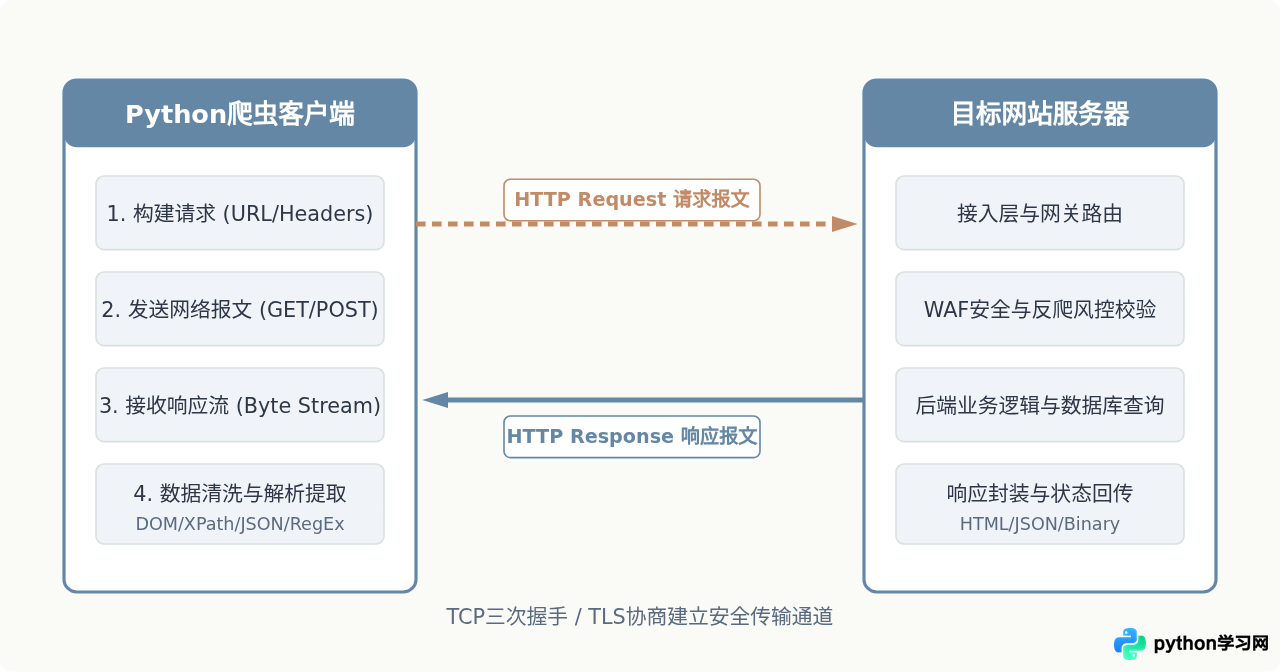
二、第一阶段:构建与发送网络请求
在HTTP协议规范中,请求是由客户端主动发起的通信动作。服务器依赖请求报文判断客户端的具体意图及来源合法性。爬虫在第一阶段的核心任务就是构造出符合目标接口规范的标准HTTP请求。
1. 常见HTTP请求方法与应用场景
爬虫中最常用的请求动作包含以下两种:
- GET 请求:用于向服务器索取数据。参数通常直接追加在URL末尾(Query String,例如
https://example.com/search?keyword=python&page=1)。GET请求是获取文章内容、搜索列表、公开静态资源的主要途径。 - POST 请求:用于向服务器提交数据以创建或修改资源。请求数据存放于HTTP请求体(Body)中,常见于用户登录、表单提交、复杂筛选条件查询或逆向API数据抓取。
2. 请求头(Request Headers)的关键字段与伪装
如果直接使用Python原生库且不作任何配置发送请求,默认携带的 User-Agent 往往包含 Python-urllib 或 python-requests。许多Web服务器与WAF(Web应用防火墙)会直接拦截该类请求并返回403 Forbidden。因此,在请求头中配置必要的模拟参数是保证请求被正确响应的基本前提:
| 字段名 | 字段作用 | 爬虫处理原则 |
|---|---|---|
User-Agent |
标识客户端的浏览器类型、版本及操作系统环境 | 必须显式配置为常见桌面浏览器的合法UA字符串,避免使用脚本默认标识。 |
Referer |
表明当前请求是从哪个页面链接跳转而来的 | 针对防盗链保护的图片、视频或子级数据接口,必须携带正确的来源页面URL。 |
Cookie |
存储服务器下发的用户身份状态与会话令牌 | 用于访问需要登录授权的页面或保持特定访问会话状态。 |
Accept-Encoding |
声明客户端支持的数据压缩算法(如 gzip, deflate, br) | 成熟的高级库(如 requests)会自动解压缩,但在底层处理时需注意解码匹配。 |
三、第二阶段:接收响应与数据流向判断
服务器处理请求后,会向爬虫回传HTTP响应报文。响应报文包含三大部分:状态行(包含HTTP状态码)、响应头(Response Headers)以及响应体(Response Body)。爬虫必须根据状态码与媒体类型(Content-Type)确定后续的数据处置方案。
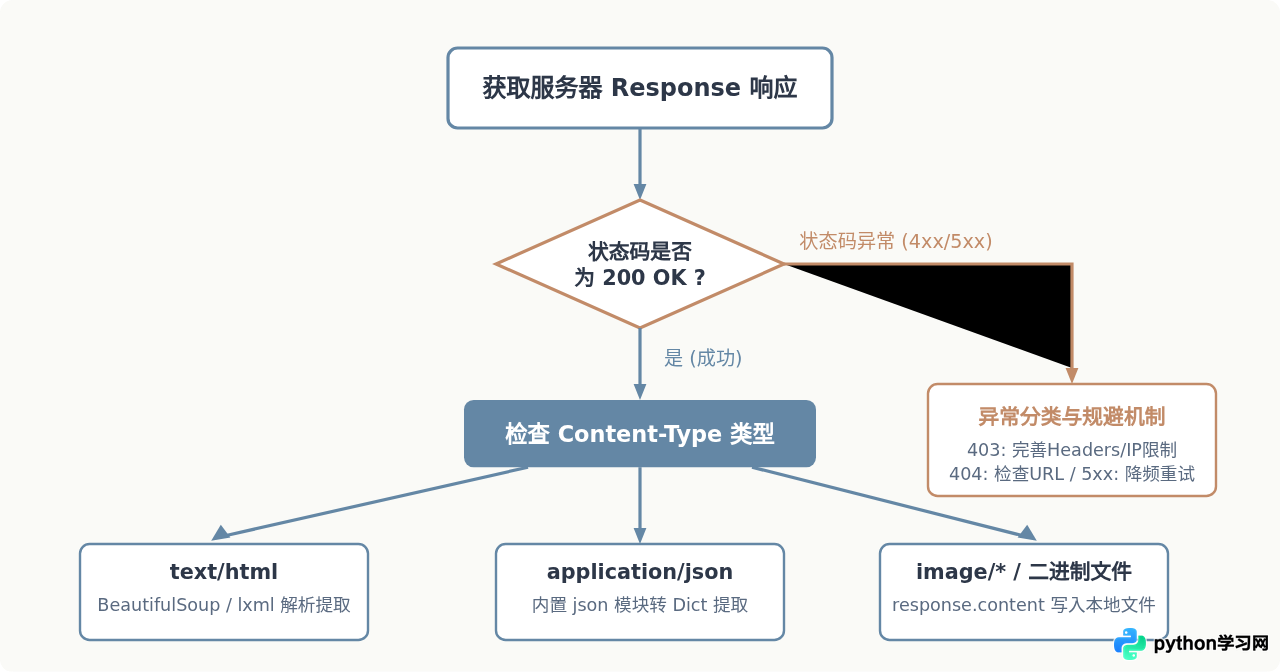
在处理响应体时,有两个容易混淆的属性:response.text 与 response.content。其中,response.content 获取的是未经解码的原始字节序列(Bytes),适合处理图片、音频、PDF等二进制媒体流;而 response.text 则是根据推测或声明的编码(如 UTF-8, GBK)将字节流解码为字符串。当出现中文乱码时,往往是因为HTTP头声明的编码与网页源码实际元标记(meta charset)不一致,需要手动纠正编码设置。
四、第三阶段:数据解析与精准提取技术
获取到HTML文本后,下一步是将无规律的纯字符串转化为可按层级检索的结构化节点树。网页结构是由HTML标签嵌套构建的DOM树,爬虫的数据提取工作本质上就是在DOM树上按特征寻找目标叶子节点并取出文本或属性值。
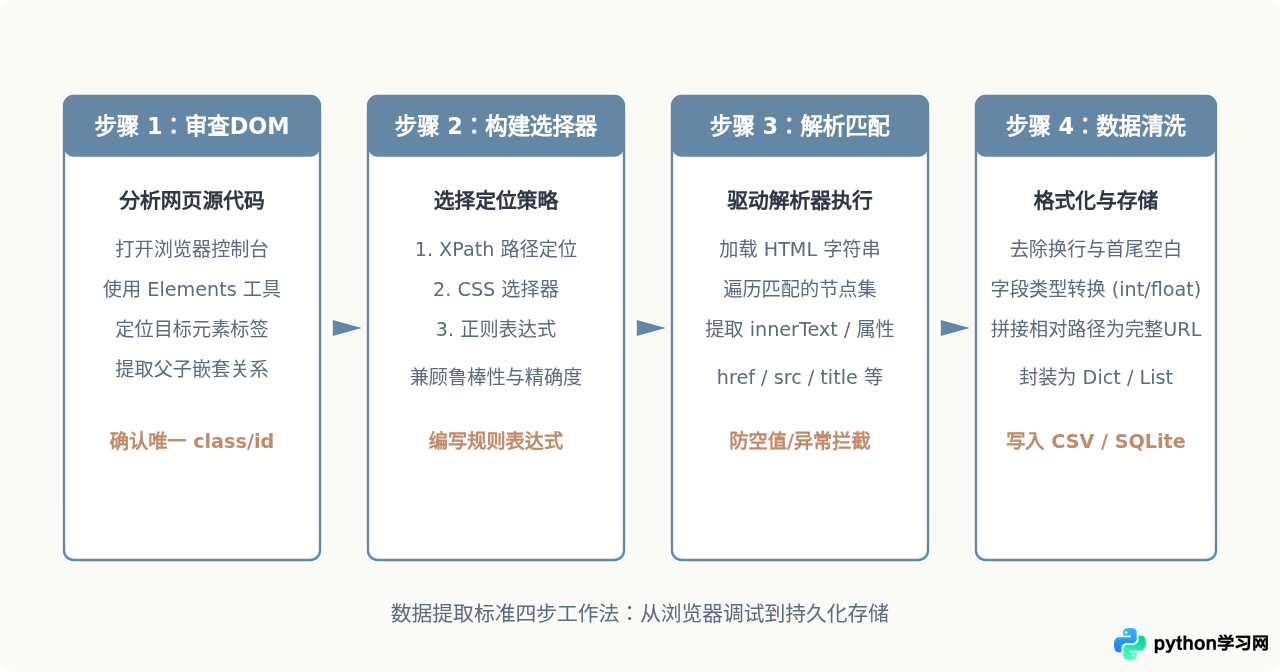
主流提取工具的对比与选型
在Python生态中,处理网页解析主要有三种主流手段:
- BeautifulSoup (bs4):语法友好,支持多种底层解释器(如
html.parser或lxml)。特别适合初学者与结构规整的小型网页,提供了find(),find_all()以及select()CSS选择器语法。 - XPath (lxml):基于C语言实现的底层库,解析速度极快,在大型工业级爬虫中应用极广。通过类似于文件系统路径的语法(如
//div[@class='news-card']//h3/text())精准检索节点,支持沿轴反向查找。 - 正则表达式 (re):基于纯文本字符串模式匹配。不需要构建DOM树,内存消耗极小,适合从包含内嵌JavaScript的
<script>标签内提取特定变量值,或从文本中提取电话、邮箱、统一编号等特定格式串。
五、实战示例:从请求发送到数据提取全流程代码走查
下面给出一个基于 requests 和 BeautifulSoup 的标准采集闭环示例。代码展示了如何配置Header伪装、发送GET请求、检测状态码、解析HTML以及安全提取字段:
import requests
from bs4 import BeautifulSoup
import time

def fetch_book_titles():
    # 1. 目标地址与请求头构建
    url = "https://example.com/books"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
                      "(KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        # 2. 发起网络请求(设置超时时间避免程序无限挂起)
        response = requests.get(url, headers=headers, timeout=10)

        # 3. 校验状态码
        if response.status_code != 200:
            print(f"请求失败,HTTP状态码: {response.status_code}")
            return []

        # 确保编码正确
        response.encoding = response.apparent_encoding

        # 4. 初始化解析器构建DOM树
        soup = BeautifulSoup(response.text, "html.parser")

        # 5. 定位数据卡片列表并提取内部属性与文本
        book_items = []
        cards = soup.select("div.book-card")

        for card in cards:
            title_node = card.select_one("h2.title")
            price_node = card.select_one("span.price")
            link_node = card.select_one("a.detail-link")

            # 容错处理:确保节点存在才取值
            title = title_node.get_text(strip=True) if title_node else "未知标题"
            price = price_node.get_text(strip=True) if price_node else "0.00"
            link = link_node.get("href", "") if link_node else ""

            book_items.append({
                "title": title,
                "price": price,
                "link": link
            })

        return book_items

    except requests.exceptions.Timeout:
        print("错误:请求连接超时")
    except requests.exceptions.ConnectionError:
        print("错误:网络连接失败,请检查DNS或网络连接")
    except Exception as e:
        print(f"解析过程中发生未预期异常: {e}")
    return []

if __name__ == "__main__":
    results = fetch_book_titles()
    print(f"成功采集到 {len(results)} 条数据示例:")
    for item in results[:3]:
print(item)注意:在编写数据提取代码时,绝对不要对属性调用采取链式无保护访问(例如直接调用 card.select_one("h2").text)。当个别页面结构发生微调或广告插播时,select_one 返回 None 将直接导致 AttributeError 崩溃。始终建议在提取前使用三元表达式或条件判断进行容错解包。
六、异常排查与合规防护机制
在实际运行过程中,网络环境波动、目标站反爬措施以及数据格式异构是爬虫不可避免面对的问题。掌握故障排查顺序与合规边界是构建稳定爬虫的保障。
1. 常见故障排查顺序
- 403 Forbidden:优先检查
User-Agent是否缺少;检查请求是否依赖防盗链Referer;检查是否触发了目标网站基于IP频次的限流策略。 - 404 Not Found:检查URL拼装逻辑,注意多余斜杠(//)或参数编码(URL Encoding)是否遗漏。
- 提取结果为空列表:这是初学者最容易遇到的问题。90%以上的原因在于目标网站采用了前端JavaScript渲染(如Vue、React构建的单页应用)。在浏览器中看到的内容是由JS动态加载API填入的,而Python发送基础GET请求拿到的HTML只是一副空骨架。此时应通过F12网络面板(Network)寻找后端实际返回数据的JSON接口,直接爬取该接口往往效率更高。
2. 频率控制与礼貌爬取
爬虫在本质上是对服务器算力资源的额外消耗。无节制的高并发请求不仅容易导致目标服务器负载过高,也必然触发严格的防火墙封禁规则。在编写爬虫时,应主动遵循目标网站根目录下的 robots.txt 协议,合理设置请求间隔(例如使用 time.sleep()),保持数据采集的克制与合规。
七、总结
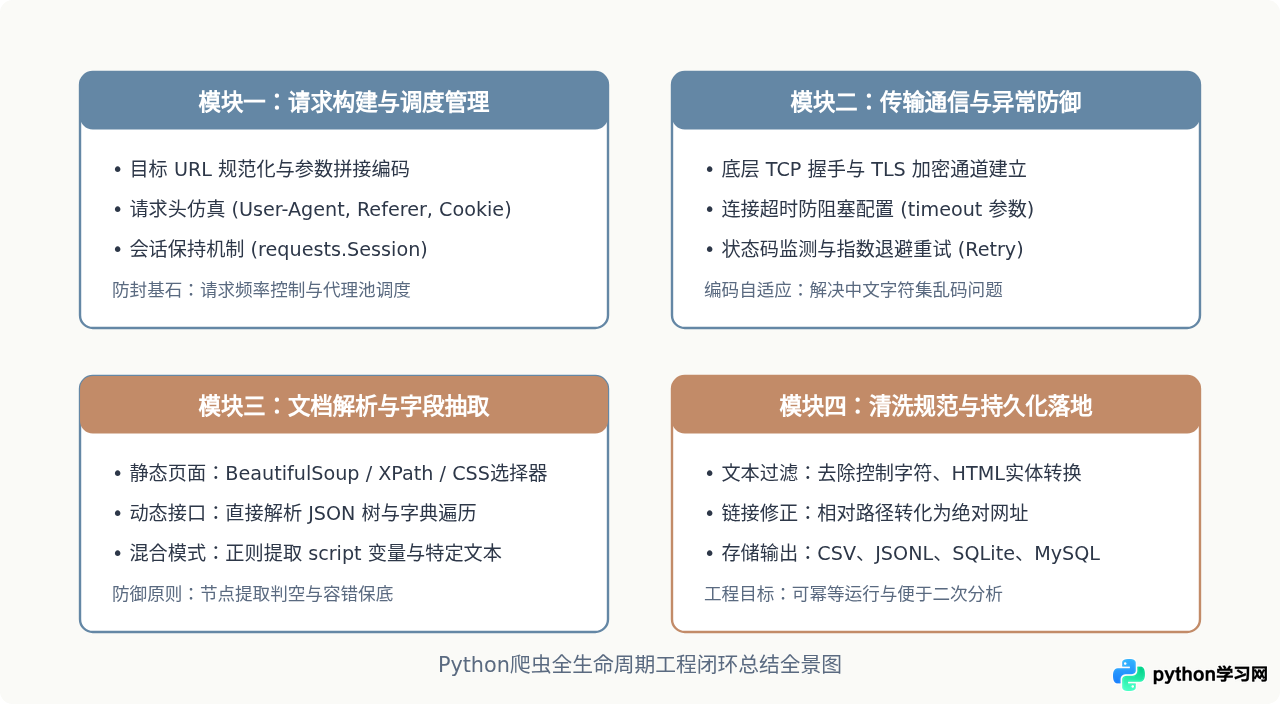
Python爬虫的底层原理可以概括为两件事:在网络层扮演合格的客户端,在数据层做好结构化解析。从发送请求开始,通过合理配置URL、方法及Headers,跨越传输层将诉求送达服务器;在接收到响应后,根据状态码判断执行结果,根据Content-Type明确内容属性;最后运用XPath、CSS选择器或内置JSON引擎,将原本非结构化或半结构化的文本转换为标准字典和表格数据。掌握这套完整的工作机理,面对形形色色的网页时便能迅速理清数据脉络,写出鲁棒且高效的抓取脚本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















