


利用Python注解实现自定义数据验证的逻辑原理
深入解析利用Python类型注解实现自定义数据验证的核心逻辑原理,涵盖元数据存储、运行时拦截、参数绑定以及基于Annotated的规则求值体系。
一、核心机制定位:为什么 Python 解释器不自动验证注解
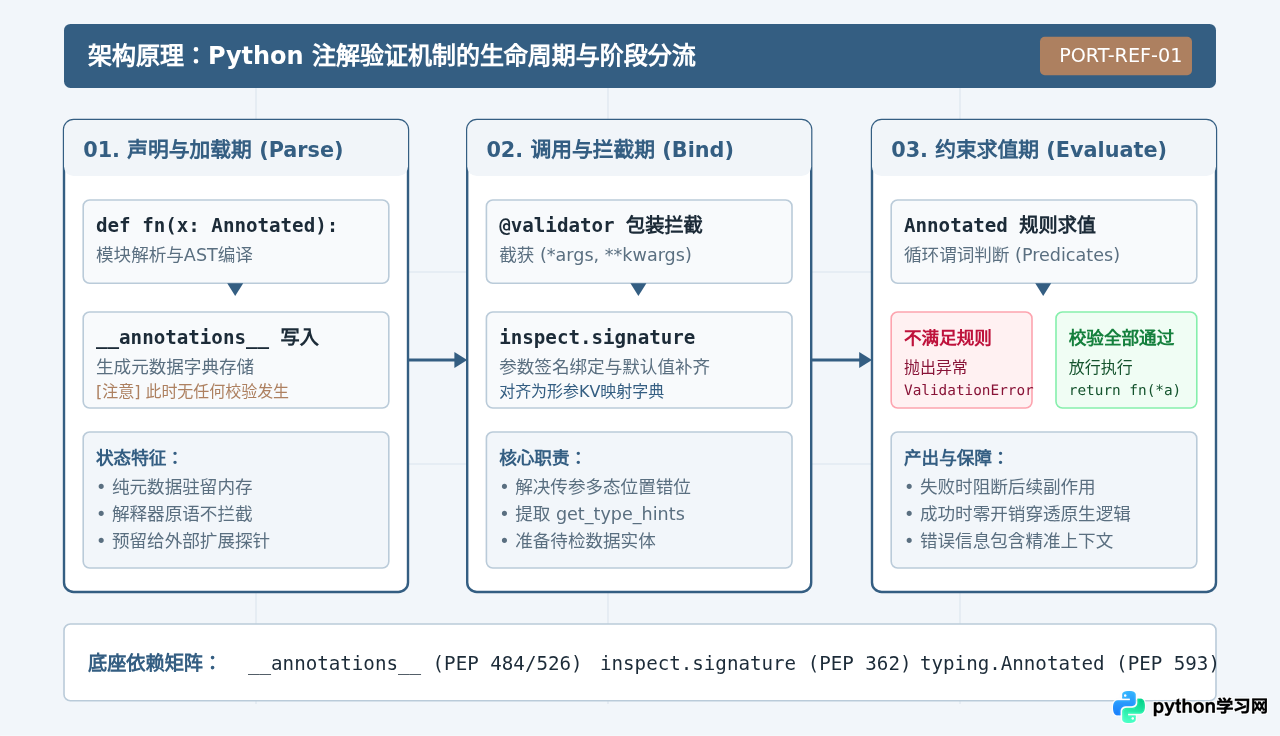
在 Python 中,通过冒号声明的类型提示(如 def query(limit: int):)在被 Python 解释器编译时,并不会生成任何类型检查相关的字节码操作指令(如 CHECK_TYPE 之类的虚构指令)。相反,解释器只执行了一项任务:将这些类型声明构造成一个标准的 Python 字典,并挂载到函数或类对象的 __annotations__ 属性上。
这就决定了 Python 官方规范(PEP 484 与 PEP 526)对注解的定位:注解是供静态类型检查器(如 Mypy、Pyright)、IDE 和运行时第三方工具读取的纯元数据。如果在代码中传入与注解不符合的实参(例如将字符串 "100" 传入标注为 int 的形参),Python 运行时引擎默认会正常执行,直到遇到不支持的操作时才抛出异常。
因此,若要让注解承担“数据验证”的职责,就必须在函数调用或类实例化时插入一段主动执行的逻辑,主动读取该元数据,并将实际传入的值与预期规则进行对比。
二、关键工程支撑:参数签名绑定(inspect.signature)
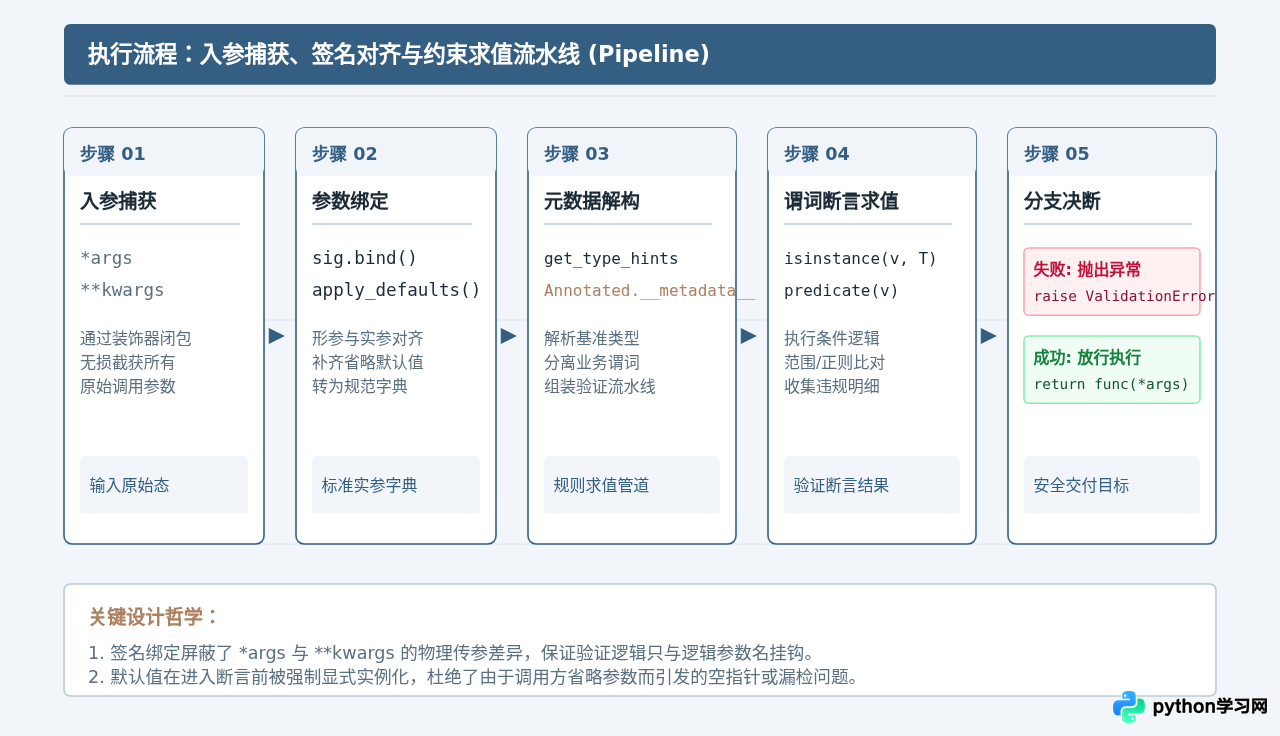
许多初学者尝试编写基于注解的验证器时,往往会直接在装饰器中遍历 *args。然而,Python 的调用方式极其灵活,同一个形参既可以通过位置传递,也可以通过关键字传递,还可以依赖缺省默认值。直接比对 args 极易发生参数错位。
为了让传入的实际参数与形参注解准确对齐,标准库中的 inspect.signature(基于 PEP 362)是核心工具。它的处理逻辑分为以下三步:
- 提取函数签名:通过
sig = inspect.signature(func)获取函数形参列表,包括参数名、默认值以及每个形参的annotation声明。 - 绑定实参映射:调用
bound_args = sig.bind(*args, **kwargs)。该方法会根据 Python 调用的官方对齐算法,将任意形式传入的实参映射为以形参名为 Key 的有序字典(bound_args.arguments)。如果缺少必填参数或传入了未知参数,此步会直接抛出标准TypeError。 - 补齐默认值:调用
bound_args.apply_defaults()。如果某些参数定义了缺省值且调用时未显式传入,该方法会自动将默认值注入映射字典中,确保后续验证器面对的是一份完整、真实的数据视图。
三、约束表达的演进:PEP 593 Annotated
普通类型注解(如 age: int)只能声明基础数据类型,无法表达具体的业务约束(例如“年龄必须在 18 到 65 岁之间”或“字符串必须匹配特定正则”)。如果为了表达业务约束而定义过多的伪类型,会导致类型系统混乱,且无法被静态类型检查器良好支持。
Python 3.9 正式引入了 PEP 593(Flexible function and variable annotations),其核心产物是 typing.Annotated。它允许在保留原始基础类型的同时,附加任意数量的业务元数据:
from typing import Annotated

# 第一个参数是真正的基准类型,后续参数是任意用户自定义元数据
PositiveInt = Annotated[int, GreaterThan(0), Description("必须大于0的整数")]
Annotated 的优雅之处在于完全解耦:静态检查器(Mypy)会直接忽略后面的元数据,把 PositiveInt 视为标准的 int;而运行时验证器则可以通过反射接口单独取出这些元数据,执行精准的断言判断。
四、纯原生验证器的完整工程实现
下面是一个纯原生、零外部依赖的轻量级参数验证器实现。代码展示了如何结合 inspect.signature 与 typing.Annotated 完成高效、准确的数据验证:
import inspect
from functools import wraps
from typing import Annotated, Any, Callable, get_origin, get_args, get_type_hints

class ValidationError(Exception):
    """自定义验证失败异常"""
    def __init__(self, param_name: str, value: Any, message: str):
        self.param_name = param_name
        self.value = value
        self.message = message
        super().__init__(f"参数 '{param_name}' (值: {value!r}) 验证失败: {message}")

class Predicate:
    """约束谓词基类"""
    def __call__(self, val: Any) -> bool:
        raise NotImplementedError
    def error_message(self) -> str:
        return "未能满足约束条件"

class Range(Predicate):
    """数值范围约束"""
    def __init__(self, min_val: float = float("-inf"), max_val: float = float("inf")):
        self.min_val = min_val
        self.max_val = max_val

    def __call__(self, val: Any) -> bool:
        return self.min_val <= val <= self.max_val

    def error_message(self) -> str:
        return f"数值必须在区间 [{self.min_val}, {self.max_val}] 内"

class NonEmptyStr(Predicate):
    """非空字符串约束"""
    def __call__(self, val: Any) -> bool:
        return isinstance(val, str) and len(val.strip()) > 0

    def error_message(self) -> str:
        return "字符串不能为空白"

def validate_call(func: Callable) -> Callable:
    """运行时参数验证装饰器"""
    sig = inspect.signature(func)
    # 使用 include_extras=True 确保提取 Annotated 的附加元数据
    type_hints = get_type_hints(func, include_extras=True)

    # 预处理:构建形参与验证规则的映射缓存,避免每次调用重复解析
    param_rules: dict[str, tuple[type, list[Predicate]]] = {}
    for name, hint in type_hints.items():
        if name == "return":
            continue
        origin = get_origin(hint)
        if origin is Annotated:
            base_type, *metadata = get_args(hint)
            predicates = [m for m in metadata if isinstance(m, Predicate)]
            param_rules[name] = (base_type, predicates)
        else:
            param_rules[name] = (hint, [])

    @wraps(func)
    def wrapper(*args: Any, **kwargs: Any) -> Any:
        # 1. 绑定传入的实际参数并补齐默认值
        bound_args = sig.bind(*args, **kwargs)
        bound_args.apply_defaults()

        # 2. 遍历绑定的参数进行验证
        for name, value in bound_args.arguments.items():
            if name not in param_rules:
                continue

            base_type, predicates = param_rules[name]

            # 基础类型断言(若声明了具体类型)
            if isinstance(base_type, type) and not isinstance(value, base_type):
                raise ValidationError(
                    name, value, f"类型不匹配,期望 {base_type.__name__},实收 {type(value).__name__}"
                )

            # 附加约束谓词求值
            for pred in predicates:
                if not pred(value):
                    raise ValidationError(name, value, pred.error_message())

        # 3. 校验全部通过,执行原生函数
        return func(*args, **kwargs)

    return wrapper
下面是使用该验证器进行测试的实际业务场景代码:
# 业务模型定义
ValidAge = Annotated[int, Range(18, 65)]
ValidUsername = Annotated[str, NonEmptyStr()]

@validate_call
def register_user(username: ValidUsername, age: ValidAge, role: str = "member"):
    return {"status": "success", "user": username, "age": age, "role": role}

# 1. 正常调用
res = register_user("Alice", 25)
# 结果: {'status': 'success', 'user': 'Alice', 'age': 25, 'role': 'member'}

# 2. 违反范围约束
try:
    register_user("Bob", 15)
except ValidationError as e:
    # 捕获异常: 参数 'age' (值: 15) 验证失败: 数值必须在区间 [18, 65] 内
    pass

# 3. 违反非空约束
try:
    register_user("   ", 30)
except ValidationError as e:
    # 捕获异常: 参数 'username' (值: '   ') 验证失败: 字符串不能为空白
    pass
五、机制延伸:函数级装饰器 vs 类属性描述符
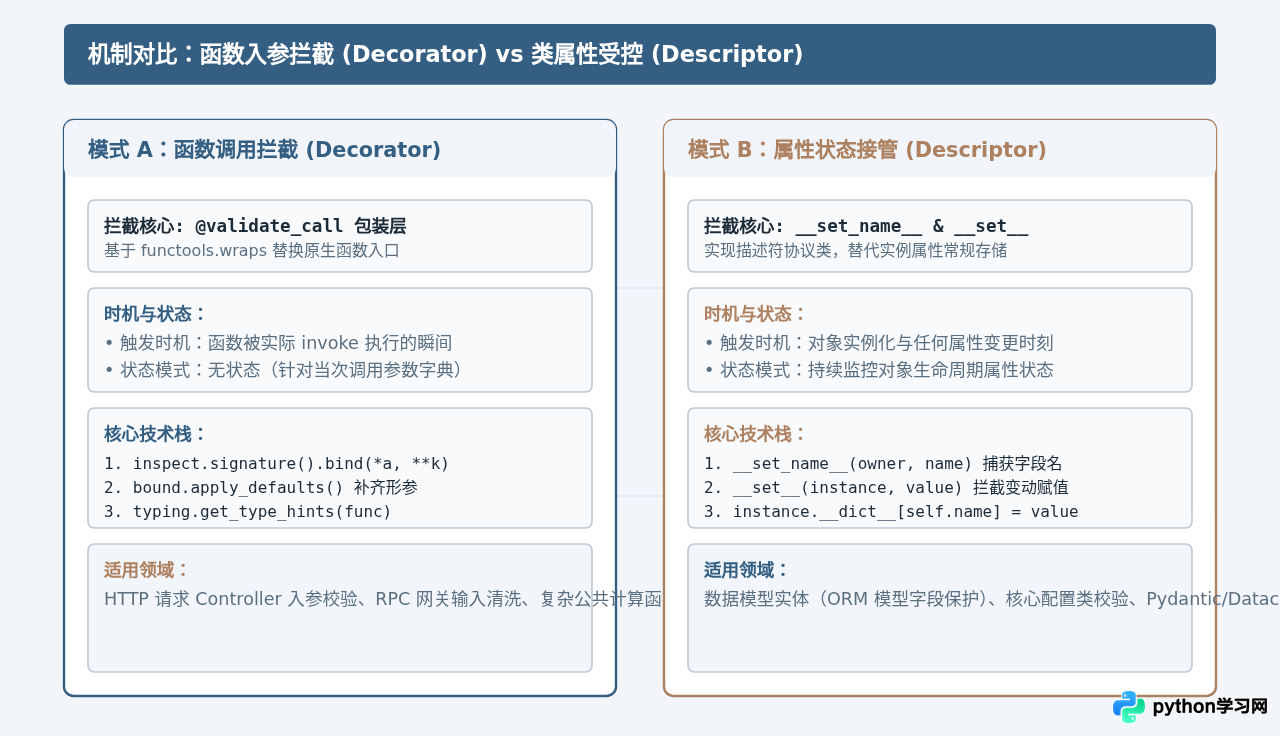
除了在函数调用入口处进行拦截外,自定义数据验证的另一个常见阵地是类对象的属性赋值(例如数据传输对象 DTO 或配置项校验)。在这两种场景下,虽然元数据都源自 __annotations__,但拦截原理却截然不同:
- 函数级拦截(Decorator 模式):依赖闭包和
inspect.signature,生命周期属于“瞬态”。只在函数调用的边界点发生,对函数内部的局部变量状态无感知。 - 类属性拦截(Descriptor 描述符协议):依赖对象的
__set_name__与__set__协议,或者通过元类重写__setattr__。它的生命周期伴随实例的整个存活期,能够在属性被重新赋值的任意时刻触发验证,确保内部状态始终合法。
六、深层原理与工程避坑指南
在实现生产级自定义注解验证器时,有三个极易被忽视的关键陷阱必须妥善处理:
1. PEP 563 与延迟求值问题
自 Python 3.7 起引入了 from __future__ import annotations(PEP 563)。该特性会将所有的注解直接以字符串字面量的形式保存在 __annotations__ 中,例如将 int 存为 'int'。
func.__annotations__ 读取注解。直接读取会拿到字符串,导致 isinstance 或 get_origin 发生语法或逻辑错误。必须统一使用 typing.get_type_hints(func, include_extras=True),该标准函数会自动获取当前模块命名空间(globals() 和 locals()),并安全地将字符串还原为真正的类型对象。
2. 反射调用的性能开销与缓存
inspect.signature 的反射解析开销相对高昂。若在装饰器包装函数内部每次都重新执行 inspect.signature(func),会导致接口吞吐量显著下降(每秒调用可能会慢数倍)。
优化原则:签名、参数规则提取与 Predicate 列表必须在装饰器初始化阶段(即模块加载期)完成一次性解析并缓存在闭包变量中。在包装函数(wrapper)中,只保留 sig.bind 和谓词循环计算。
3. 复杂泛型类型的递归验证
如果注解是复杂容器(如 list[int] 或 dict[str, User]),直接使用 isinstance(val, list) 只能验证外层容器类型,无法验证容器内部元素的合法性。
若要支持容器内嵌校验,需要通过 get_origin() 判断容器类型(如 list),再通过 get_args() 取得子项类型,并进行递归遍历。在工程实践中,对于过大的列表或深层字典,全量递归扫描可能带来较大 CPU 开销,通常建议提供采样校验或限制最大扫描深度。
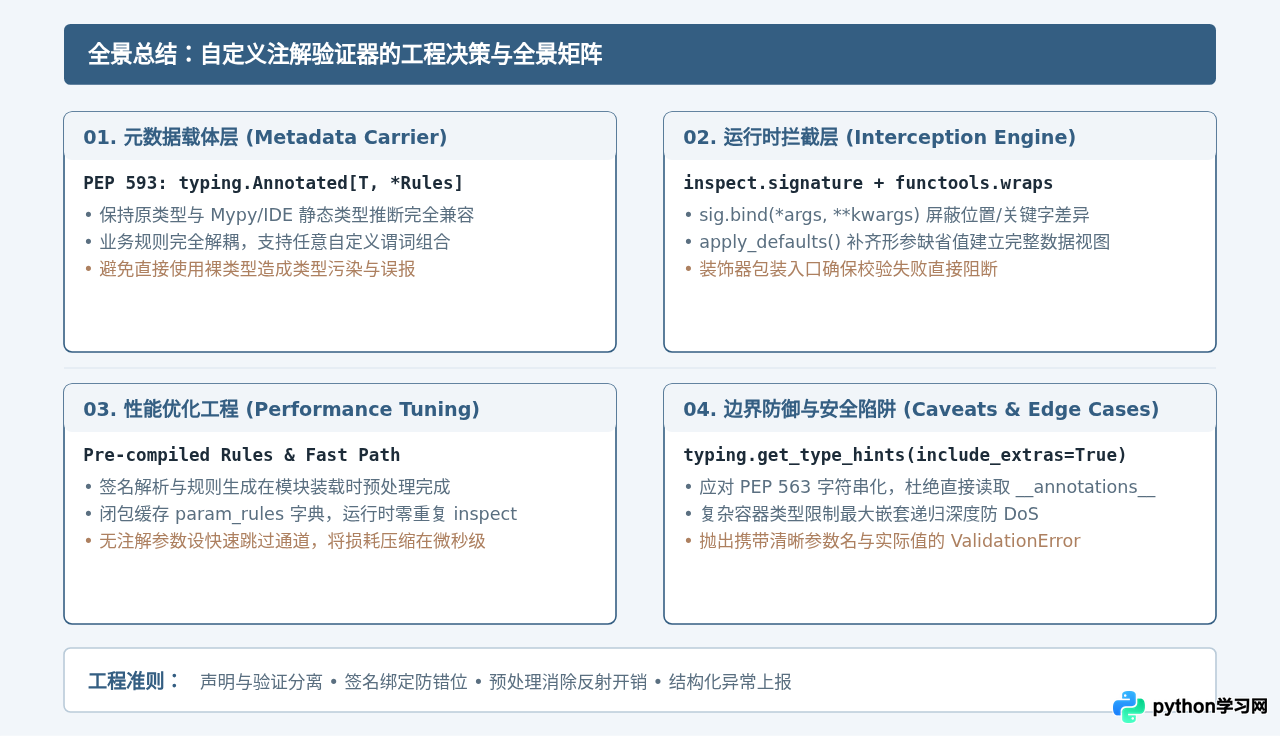
七、总结与落地实施清单
利用 Python 注解实现自定义数据验证,并不是违背 Python 的设计初衷,而是充分利用其元编程能力对语言特性的合理解耦与延伸。在自行构建或选型验证系统时,可以参考以下实施清单进行对照自查:
| 检查维度 | 标准要求 | 未达标后果 |
|---|---|---|
| 元数据声明 | 使用 typing.Annotated 组合类型与约束 |
直接自定义复杂类型会导致 Mypy 报错或丢失 IDE 自动补全 |
| 参数绑定 | 使用 inspect.signature().bind() 并调用 apply_defaults() |
关键字传参或缺省默认值时发生错位或漏检 |
| 元数据提取 | 统一调用 typing.get_type_hints(fn, include_extras=True) |
在开启未来注解模式时取得字符串字面量导致程序崩溃 |
| 调用性能 | 签名与规则在装饰器初始化阶段解析并缓存 | 每次调用执行反射解析导致高并发场景性能骤降 |
| 异常反馈 | 提供包含参数名、违规值、具体规则描述的结构化异常 | 上游调用方只能捕获模糊的报错,难以精确定位错误来源 |
掌握这一整套逻辑原理,不仅能在不引入重型依赖的情况下自制出精巧的领域验证框架,也能在面对 Pydantic、Marshmallow 或 Web 框架的参数校验异常时,做到迅速定位底层执行流,写出更具可靠性与自省力的高质量 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















