


Python怎么实现嵌套字典与列表的深度数据校验

深度数据校验的核心任务,是逐层遍历嵌套的字典与列表,并在遇到类型不符、键缺失或取值越界时,精确报告出错位置的层级路径。解决这一问题的标准路径通常包含两种:对于无外部依赖的轻量场景,可以通过递归函数配合“路径堆栈”自主实现;对于复杂的业务系统,则应采用基于类型注解或规范标准的成熟校验库。本文将先解析递归校验与路径追踪的算法实现,随后通过具体代码展示边界处理,并给出不同工程阶段的选型建议。
层级解构:嵌套数据的校验模型
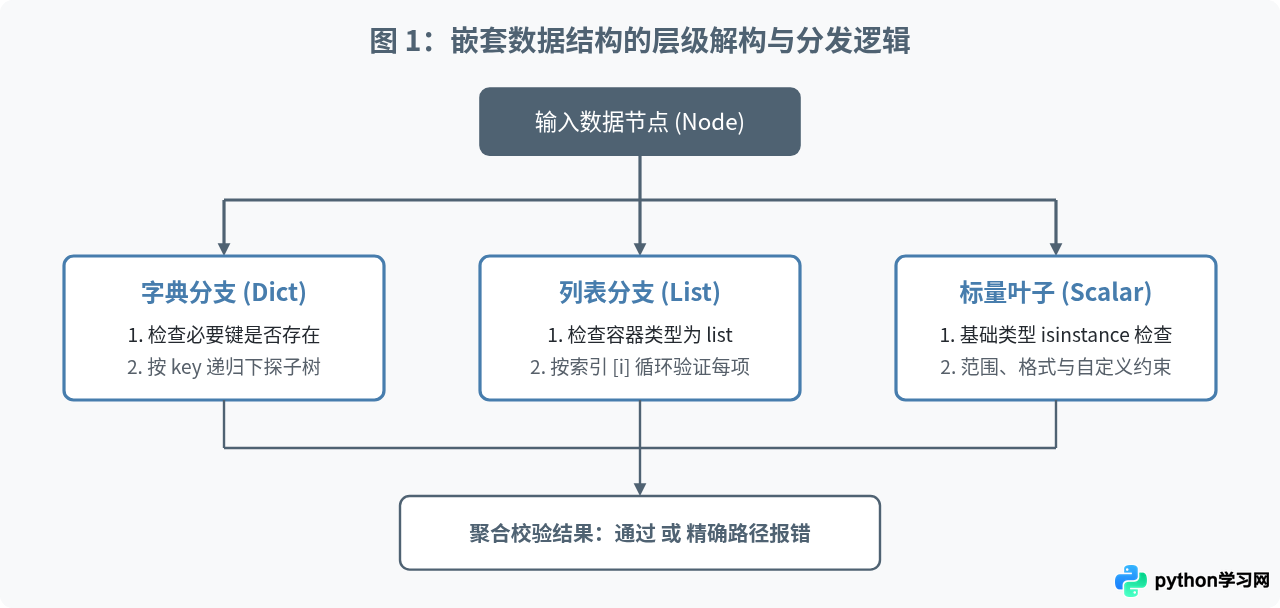
当外部数据(如网络请求的 JSON 载荷或复杂配置文件)进入 Python 程序时,其结构通常由字典、列表和基础标量类型混合嵌套而成。普通浅层校验仅能判断最外层对象是否为字典,却无法获知深层节点的合规性。要实现深度校验,必须将数据与预设的“规则模式(Schema)”进行递归比对。
在解构过程中,校验器将遇到三种节点形态:字典节点、列表节点与叶子标量。对于字典节点,需要核验必填键的存在性并递归进入子属性;对于列表节点,需要遍历其中的每个元素并执行相同的子规则检查;对于叶子标量(如字符串、整数、布尔值),则执行最终的类型与取值判定。图 1 展示了这一层级解构与分发校验的逻辑体系。
算法实现:基于递归与路径追踪的校验器
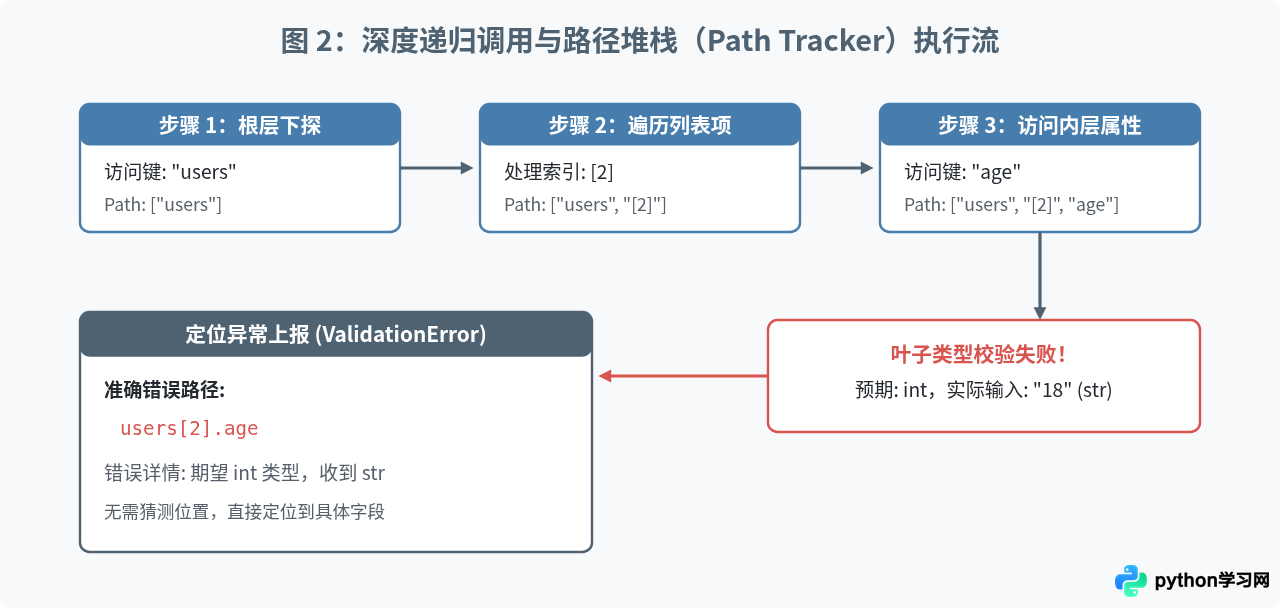
实现深度校验时,最关键的一点是维护调用链路的“路径堆栈”。如果仅仅抛出一个简单的 TypeError: expected int,调用者根本无法得知是第几个列表项中的哪一个深层键出现了错误。因此,校验函数在每次递归下探时,都必须把当前处理的键名或列表索引压入路径链中。
下面的原生实现定义了一个规则解析器:规则本身由 Python 字典和列表组织,规则末梢可以是期望的数据类型(如 int、str),也可以是更深层的规则。图 2 展示了当校验器在列表第 2 项的嵌套字典中发现字段类型不符时,路径信息的构建与返回过程。
完整原生实现代码
以下为一个无任何外部依赖的递归校验函数实现。代码通过一个轻量规范体系,对多层字典与包含同质对象的列表完成深度扫描,并支持错误累积。
def validate_deep(data, schema, path=""):
    """
    深度递归数据校验器
    :param data: 待校验的原始数据(支持字典、列表、标量)
    :param schema: 校验模式定义
    :param path: 当前递归对应的层级路径描述
    :return: 错误信息列表(空列表表示全部通过)
    """
    errors = []

    # 1. 规则为字典:当前节点必须是 dict,并递归校验每个键
    if isinstance(schema, dict):
        if not isinstance(data, dict):
            current_loc = path if path else "根节点"
            return [f"[{current_loc}] 类型错误: 期望 dict,实际为 {type(data).__name__}"]

        # 逐一核验 schema 中声明的所有键
        for key, sub_schema in schema.items():
            sub_path = f"{path}.{key}" if path else str(key)
            if key not in data:
                errors.append(f"[{sub_path}] 缺失必填字段")
            else:
                errors.extend(validate_deep(data[key], sub_schema, sub_path))

    # 2. 规则为单元素列表 [item_schema]:当前节点必须是 list,且每个元素符合 item_schema
    elif isinstance(schema, list):
        if not isinstance(data, list):
            current_loc = path if path else "根节点"
            return [f"[{current_loc}] 类型错误: 期望 list,实际为 {type(data).__name__}"]

        item_schema = schema[0] if len(schema) > 0 else object
        for idx, item in enumerate(data):
            sub_path = f"{path}[{idx}]"
            errors.extend(validate_deep(item, item_schema, sub_path))

    # 3. 规则为基础类型(如 int, str, float, bool)
    elif isinstance(schema, type):
        # 注意:Python中 bool 是 int 的子类,需单独甄别布尔值与纯整数
        if schema is int and isinstance(data, bool):
            errors.append(f"[{path}] 类型错误: 期望 int,实际为 bool")
        elif not isinstance(data, schema):
            errors.append(f"[{path}] 类型错误: 期望 {schema.__name__},实际为 {type(data).__name__}")

    # 4. 规则为可调用的自定义判定函数 (lambda x: ...)
    elif callable(schema):
        try:
            if not schema(data):
                errors.append(f"[{path}] 校验未通过自定义约束: 值 '{data}' 不符合条件")
        except Exception as e:
            errors.append(f"[{path}] 自定义规则执行异常: {str(e)}")

    return errors
测试执行与结果验证
为验证该函数的深度定位能力,我们构造一组存在多处深层缺陷的数据载荷,包括深层属性类型错误、列表元素缺失键以及标量越界:
# 定义校验 Schema
user_schema = {
    "group_id": int,
    "members": [
        {
            "id": int,
            "name": str,
            "profile": {
                "age": lambda x: isinstance(x, int) and 0 <= x <= 120,
                "tags": [str]
            }
        }
    ]
}

# 构造包含错误的测试数据
payload = {
    "group_id": "1001",  # 根层错误: 应当为 int,传入了 str
    "members": [
        {
            "id": 1,
            "name": "Alice",
            "profile": {
                "age": 28,
                "tags": ["admin", "dev"]
            }
        },
        {
            "id": 2,
            "name": "Bob",
            "profile": {
                "age": 150,  # 深度错误: 年龄超出自定义约束范围
                "tags": ["user", 123]  # 深度错误: tags[1] 应为 str,传入了 int
            }
        }
    ]
}

# 执行校验
validation_errors = validate_deep(payload, user_schema)
for err in validation_errors:
    print(err)
运行该段示例代码,控制台将输出清晰的路径化错误报告:
[示例输出]
[group_id] 类型错误: 期望 int,实际为 str
[members[1].profile.age] 校验未通过自定义约束: 值 '150' 不符合条件
[members[1].profile.tags[1]] 类型错误: 期望 str,实际为 intbool 是 int 的子类(即 isinstance(True, int) 为 True)。如果数据中要求纯整型,校验逻辑中必须显式防范传入布尔值的情况,否则 {"count": True} 将被误判为合法整数。
边界处理与健壮性策略
在生产环境中,嵌套数据往往包含诸多特殊边界情况,若处理不当,可能导致程序崩溃或误报。以下几点是在编写深度校验时必须注意的细节:
- 空容器处理:空列表
[]或空字典{}是否合法?如果业务允许空列表,则遍历逻辑自然跳过;如果要求列表不能为空,需要在列表规则中增加长度限制。 - None 与可选字段:很多字段在业务上属于选填项(允许为
None或键不存在)。在定义规则时,可以通过封装Optional(int)或Union[int, None]对象来标识该键允许跳过。 - 递归层数限制:Python 默认的最大递归深度通常为 1000(可通过
sys.getrecursionlimit()查看)。尽管常见业务 JSON 很少达到上千层嵌套,但处理恶意构造的超深结构时,必须设置递归深度阈值,防止栈溢出。
方案选型:原生实现 vs 现代声明式工具
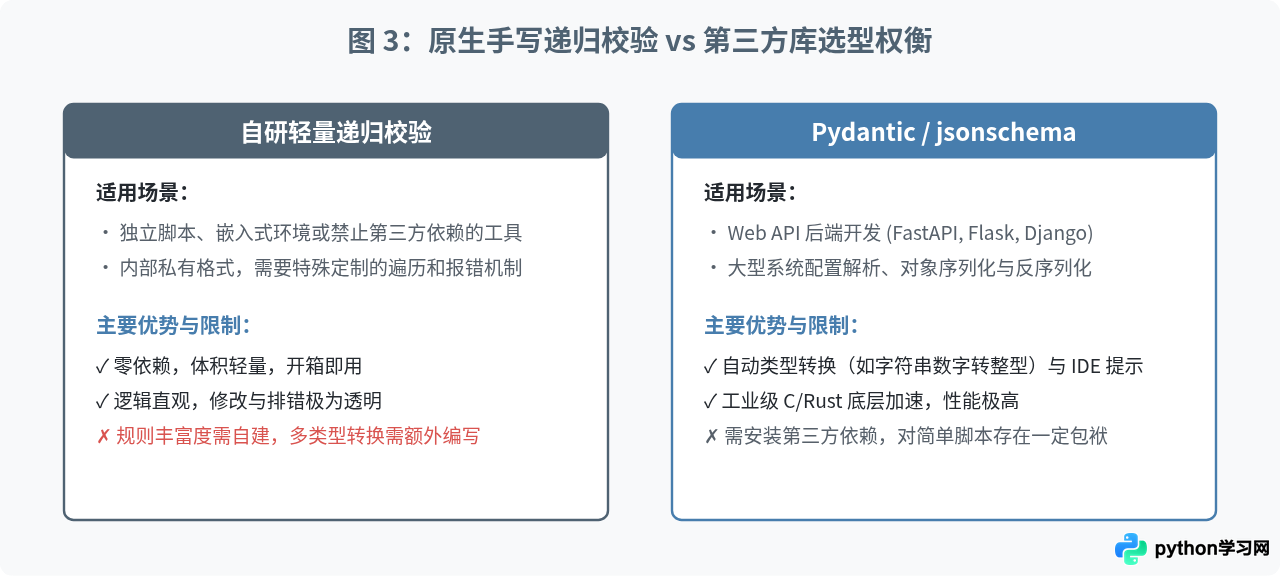
虽然通过递归可以完全掌控校验逻辑,但随着项目规模扩大,手动维护 Schema 语法可能带来额外的开发与沟通成本。在实际工程落地时,应根据项目的依赖要求与复杂度做出合理选择:
Pydantic 现代模式示例
如果项目允许引入依赖,采用 Pydantic 可以通过声明式数据模型实现相同的深度校验,代码表达更为紧凑,并且原生自带错误定位:
from pydantic import BaseModel, Field
from typing import List

class ProfileModel(BaseModel):
    age: int = Field(ge=0, le=120)
    tags: List[str]

class MemberModel(BaseModel):
    id: int
    name: str
    profile: ProfileModel

class GroupModel(BaseModel):
    group_id: int
    members: List[MemberModel]

# 当传入错误数据时,Pydantic 将自动捕获多层错误:
# 抛出的 ValidationError 将精确指明 members -> 1 -> profile -> age 越界
总结与实施要点
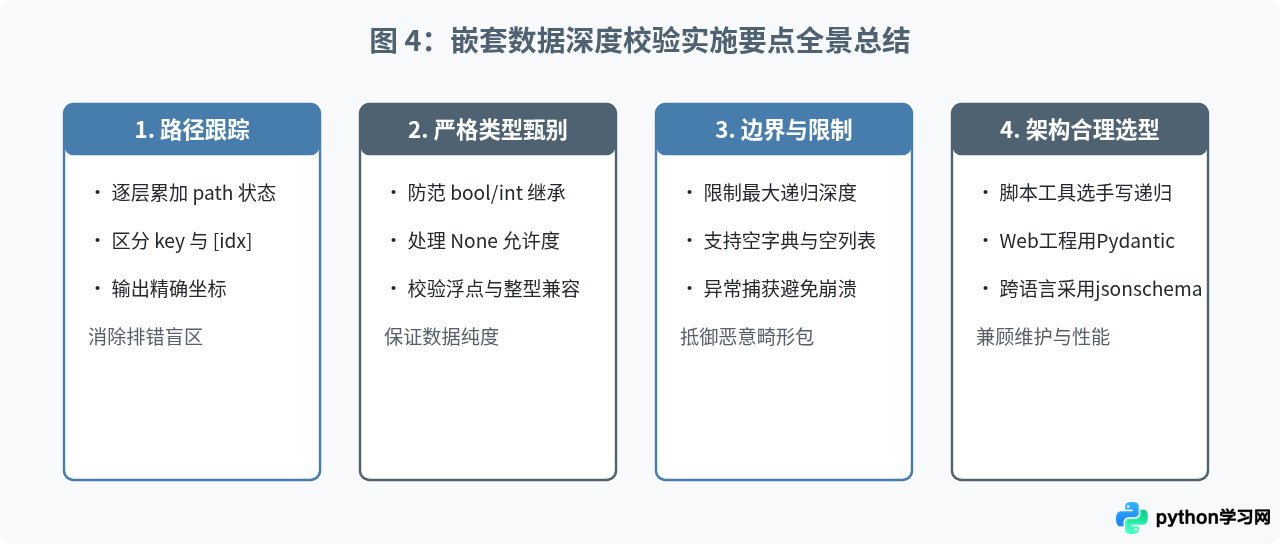
实现嵌套字典与列表的深度校验,核心在于解构节点类型与维护路径状态。不论采取哪种具体实现,都应遵循以下四项工程化原则:
- 路径必须语义化:任何报错信息都应明确体现层级索引(如
data[0].meta.author),避免产生模糊的“类型不符”报错。 - 类型隔离严格:防范 Python 常见隐式转换问题(如布尔值与整数的关系),明确约束只接受目标类型。
- 错误收集与中断模式选择:根据场景选择是“遇到第一个错误即返回(Fail Fast)”还是“完整扫描收集所有错误(Collect All)”。面向用户表单或批量数据时,收集全量错误体验更优。
- 性能与栈深度防范:对于极端超深数据,应评估递归深度限制,避免栈溢出。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















