


基于Python注解实现数据验证:Pydantic应用示例
本文详解如何利用Python原生类型注解结合Pydantic实现高效、健壮的运行时数据验证。涵盖BaseModel定义、自动类型转换、字段约束、自定义验证器及嵌套模型实战。
一、核心机制:Python 注解如何驱动运行时验证
在传统 Python 编码中,如果需要确保外部传入的数据(如 HTTP 请求体、JSON 配置文件、数据库查询结果)结构合法,通常需要编写大量重复的 isinstance()、键值存在性判断及异常捕获分支。这类代码不仅冗长,而且容易因为漏判而导致运行时错误。
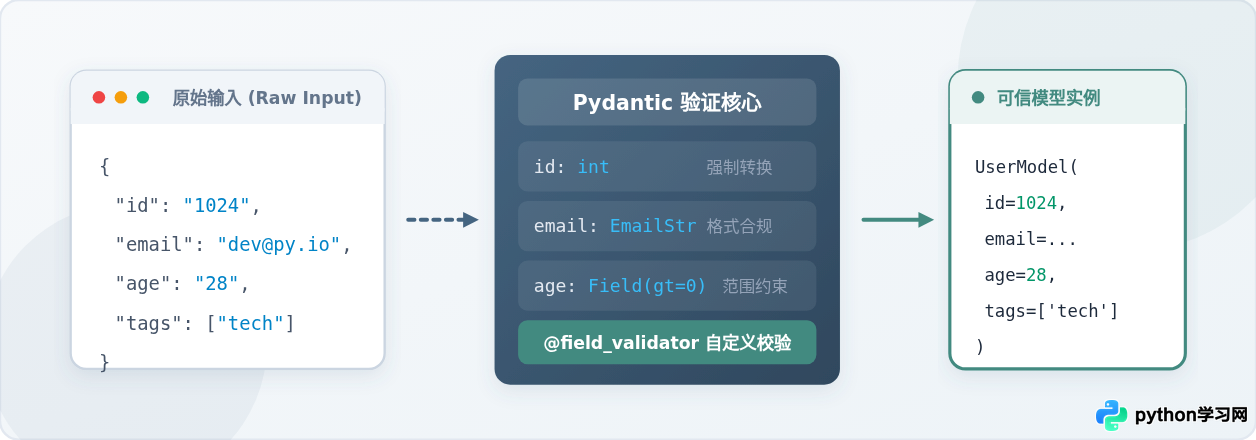
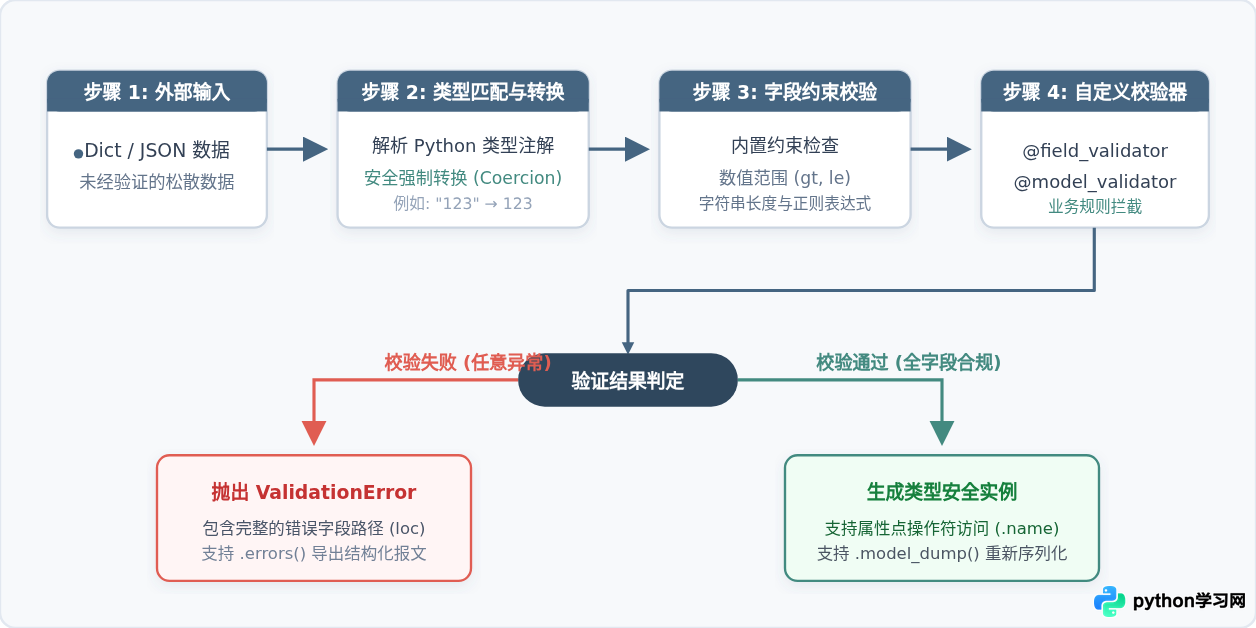
Pydantic 的核心类 BaseModel 通过元类机制在类定义时读取属性的类型注解。当外部数据字典实例化该模型时,Pydantic 将按顺序触发各字段的解析管线:先做数据预解析,再根据类型注解进行兼容性类型转换,随后执行 Field 范围约束,最后调用自定义校验器。
二、基础模型定义与自动类型转换
要实现数据验证,首先需要继承 pydantic.BaseModel 并使用标准 Python 类型注解声明字段。Pydantic 兼容 Python 标准库中的常见类型,包括基础标量(int、str、float、bool)、复合容器(list、dict、set、tuple),以及来自 typing 模块的 Optional、Union 等。
1. 快速上手代码示例
下面演示一个用户注册入参模型的定义,并展示合规数据载入时的自动类型转换(Coercion):
# user_model.py
from datetime import datetime
from typing import Optional, List
from pydantic import BaseModel

class UserProfile(BaseModel):
    user_id: int
    username: str
    is_active: bool = True
    signup_date: Optional[datetime] = None
    tags: List[str] = []

# 模拟外部传入的原始字典(包含字符串形式的数字与日期)
raw_data = {
    "user_id": "10086",                     # 字符串格式数字,将自动转为 int
    "username": "zhangsan",
    "is_active": "yes",                      # 常用布尔字符串表示,自动解析为 True
    "signup_date": "2026-05-20T14:30:00",    # ISO 8601 字符串,自动转为 datetime 对象
    "tags": ["developer", "python"]
}

user = UserProfile(**raw_data)

print(f"解析结果: {user}")
print(f"user_id 类型: {type(user.user_id)}, 值: {user.user_id}")
print(f"is_active 类型: {type(user.is_active)}, 值: {user.is_active}")
print(f"signup_date 类型: {type(user.signup_date)}, 值: {user.signup_date}")
关键机制解释:
- 自动类型转换(Coercion):在默认宽容模式下,传入的
"10086"会被安全转换为整型10086,字符串"yes"、"1"、"true"会自动解析为布尔值True,标准的 ISO 日期字符串会被解析为datetime实例。 - 默认值机制:
is_active和tags设置了默认值。如果在入参字典中省略这两个字段,模型将自动填充默认值,而不会报错。 - 可选字段:
Optional[datetime]明确允许字段为None,既符合静态类型规范,又兼顾了业务数据中非必填字段的场景。
2. 异常拦截与 ValidationError 剖析
当输入数据无法安全转换为指定类型,或者缺失了没有默认值的必填字段时,Pydantic 会立即抛出 pydantic.ValidationError。该异常不是简单的报错,而是包含了精确到字段名、错误类型、提示信息及非法入参的完整结构体。
from pydantic import ValidationError

invalid_payload = {
    "user_id": "not_a_number",  # 无法转换为整型
    # 缺少必填字段 username
    "tags": "not_a_list"        # 要求 List[str],传入了单个字符串
}

try:
    UserProfile(**invalid_payload)
except ValidationError as e:
    # 格式化打印所有校验失败项
    for err in e.errors():
        print(f"字段路径: {err['loc']} | 错误提示: {err['msg']} | 错误类型: {err['type']}")
err['loc'] 会以元组形式精准记录错误发生的位置。对于深层嵌套的模型或列表索引,loc 可以是 ('items', 2, 'price'),极大方便了 Web 框架直接向前端返回精细化的表单校验错误。
三、高级字段约束与注解架构:Field 与 Annotated
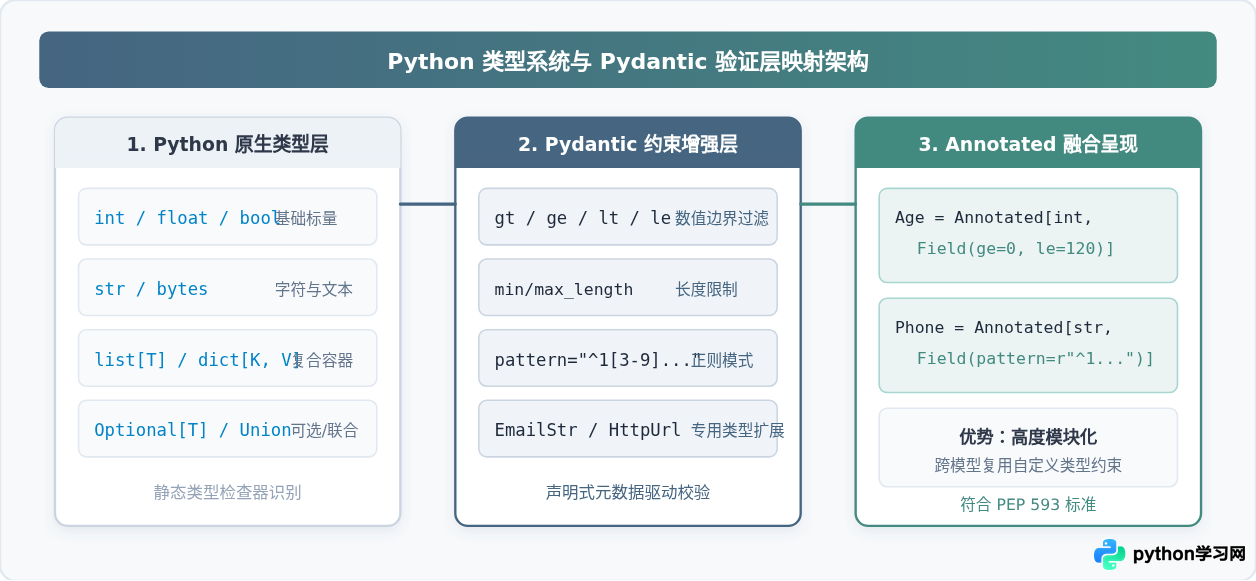
单纯的类型声明(如 int 或 str)只能限制数据的类别,无法表达更细致的数值范围、字符串长度或正则规则。Pydantic 提供了 Field() 函数,配合 Python 3.9+ 推荐的 typing.Annotated 语法,能够将约束声明与基础类型清晰解耦。
代码示例:使用 Field 与 Annotated 进行严格边界限制
# account_schema.py
from typing import Annotated
from pydantic import BaseModel, Field, ValidationError

# 通过 Annotated 定义具备明确约束的可复用类型别名
NonEmptyStr = Annotated[str, Field(min_length=1, max_length=50, description="非空字符串,限50字")]
ScoreInt = Annotated[int, Field(ge=0, le=100, description="分数必须在0到100之间")]
MobilePhone = Annotated[str, Field(pattern=r"^1[3-9]\d{9}$", description="中国大陆标准手机号")]

class AccountCreationRequest(BaseModel):
    username: NonEmptyStr
    score: ScoreInt = 60
    phone: MobilePhone
    # 直接在字段上使用 Field
    balance: float = Field(default=0.0, ge=0.0, description="账户余额不可为负数")

# 1. 尝试传入非法手机号及越界分数
invalid_account = {
    "username": "alice",
    "score": 150,             # 超过 le=100
    "phone": "12345678901",    # 无法通过正则 ^1[3-9]\d{9}$
    "balance": -20.5           # 无法通过 ge=0.0
}

try:
    AccountCreationRequest(**invalid_account)
except ValidationError as e:
    for err in e.errors():
        field = err["loc"][0]
        msg = err["msg"]
        print(f"[{field}] 校验拦截: {msg}")
四、自定义验证器:字段级与模型级校验
常规的类型转换和边界过滤无法解决所有业务规则。例如:
- 字段级校验:特定字段的去空格、强制转小写、违禁词过滤、特定格式校验(如 ISBN 校验码)。
- 模型级多字段校验:注册时“密码”与“确认密码”必须一致、查询请求中“结束时间”必须大于等于“开始时间”。
在现代 Pydantic(v2)中,这两种需求分别由 @field_validator 和 @model_validator 装饰器承担。
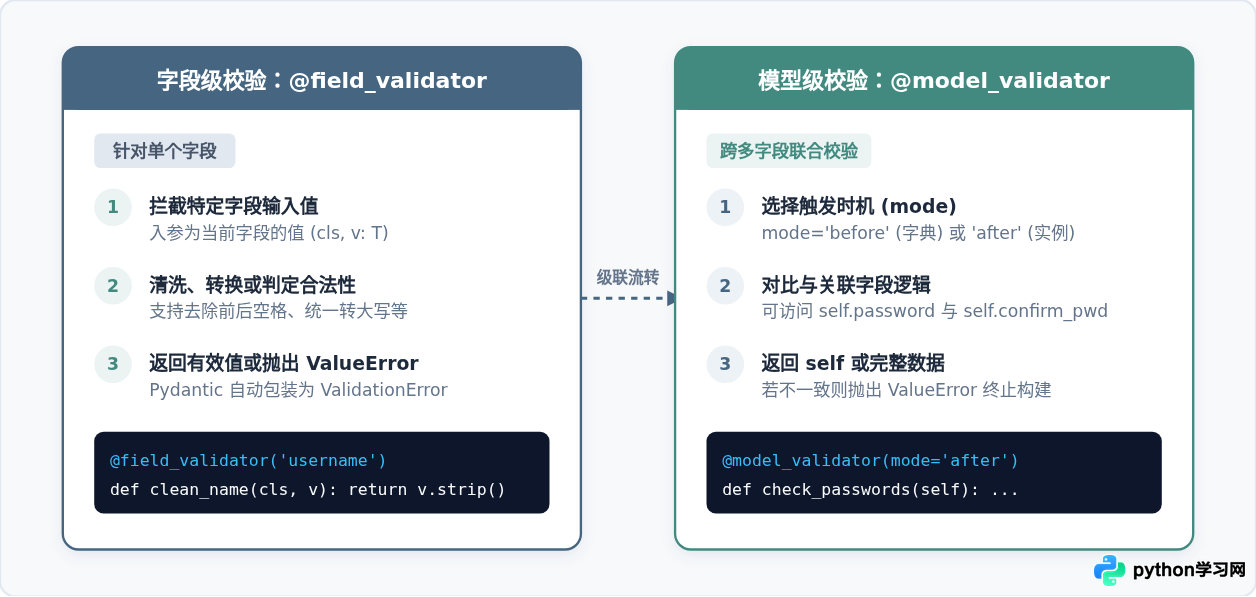
代码示例:注册表单密码一致性与用户名合法性校验
# register_validator.py
from pydantic import BaseModel, field_validator, model_validator

class UserRegistrationForm(BaseModel):
    username: str
    password: str
    confirm_password: str

    # 1. 字段级校验:保证用户名纯字母数字且转为小写
    @field_validator("username")
    @classmethod
    def validate_username(cls, value: str) -> str:
        trimmed = value.strip().lower()
        if not trimmed.isalnum():
            raise ValueError("用户名只能包含英文字母与数字")
        if len(trimmed) < 4:
            raise ValueError("用户名有效长度不能少于 4 位")
        return trimmed

    # 2. 字段级校验:密码最小长度
    @field_validator("password")
    @classmethod
    def validate_password_strength(cls, value: str) -> str:
        if len(value) < 8:
            raise ValueError("密码长度至少需包含 8 个字符")
        return value

    # 3. 模型级校验:跨字段确认两次输入密码是否相同
    @model_validator(mode="after")
    def verify_password_match(self):
        if self.password != self.confirm_password:
            raise ValueError("两次输入的密码不一致,请重新输入")
        return self

# 测试用例 A: 用户名含非法字符
try:
    UserRegistrationForm(
        username="john_doe!",
        password="secret_pass_123",
        confirm_password="secret_pass_123"
    )
except ValueError as e:
    print(f"用例 A 拦截: {e}")

# 测试用例 B: 两次密码不匹配
try:
    UserRegistrationForm(
        username="johndoe",
        password="secret_pass_123",
        confirm_password="different_password"
    )
except ValueError as e:
    print(f"用例 B 拦截: {e}")
五、嵌套模型与层级数据结构验证
在真实的微服务或 Web API 场景下,传入的数据往往不是扁平的键值对,而是深层嵌套的树状结构(例如电商订单中包含收件人地址对象和订单项列表)。
Pydantic 允许直接将一个 BaseModel 子类作为另一个 BaseModel 的类型注解,从而实现无缝的级联递归校验。
# order_nested_model.py
from typing import List
from pydantic import BaseModel, Field, ValidationError

class OrderItem(BaseModel):
    product_id: int
    name: str = Field(..., min_length=1)
    price: float = Field(..., gt=0, description="单价必须大于 0")
    quantity: int = Field(1, ge=1, le=99, description="购买数量 1-99 件")

class ShippingAddress(BaseModel):
    province: str
    city: str
    detail: str = Field(..., min_length=5)

class OrderPayload(BaseModel):
    order_sn: str
    customer_id: int
    shipping_address: ShippingAddress          # 嵌套单一子模型
    items: List[OrderItem]                    # 嵌套子模型列表

    @property
    def total_amount(self) -> float:
        # 计算订单总价
        return sum(item.price * item.quantity for item in self.items)

# 传入复杂的深层嵌套数据,并在其中一个子项故意引入错误(价格为 -10)
raw_order = {
    "order_sn": "ORD-20261102-001",
    "customer_id": 9527,
    "shipping_address": {
        "province": "广东省",
        "city": "深圳市",
        "detail": "高新科技园南区某大厦 8 楼"
    },
    "items": [
        {"product_id": 101, "name": "Python 高性能编程", "price": 89.0, "quantity": 1},
        {"product_id": 102, "name": "机械键盘", "price": -10.0, "quantity": 2}  # 非法负值价格
    ]
}

try:
    OrderPayload(**raw_order)
except ValidationError as e:
    for err in e.errors():
        print(f"精确定位路径: {err['loc']} -> 原因: {err['msg']}")
注意观察 ('items', 1, 'price') 这个路径定位,它清晰标明了:items 列表下标为 1 的元素中,price 字段未满足 gt=0 的约束。无论数据嵌套深度有多大,Pydantic 都能自动追踪并准确汇报出错点。
六、工程落地与选型决策指南
在生产环境中落地基于 Python 注解的 Pydantic 验证方案时,建议从严格模式、性能需求和序列化出口三个维度制定规范。
| 维度 | 默认宽容模式 (Lax Mode) | 严格模式 (Strict Mode) | 适用场景建议 |
|---|---|---|---|
| 类型转换策略 | 自动将 "123" 转为 int,"true" 转为布尔 |
严格匹配,传入 "123" 预期 int 直接报错 |
对外公开 API 建议宽容解析;内部 RPC / 微服务通信建议严格模式 |
| 配置方式 | BaseModel 默认行为 |
类中声明 model_config = ConfigDict(strict=True) |
金融计算、高安全性校验场景启用 strict=True |
| 多余字段处理 | 默认忽略未声明的字段 (extra='ignore') |
可配置禁止多余字段 (extra='forbid') |
防止前端拼写错误提交废弃参数,配置 extra='forbid' |
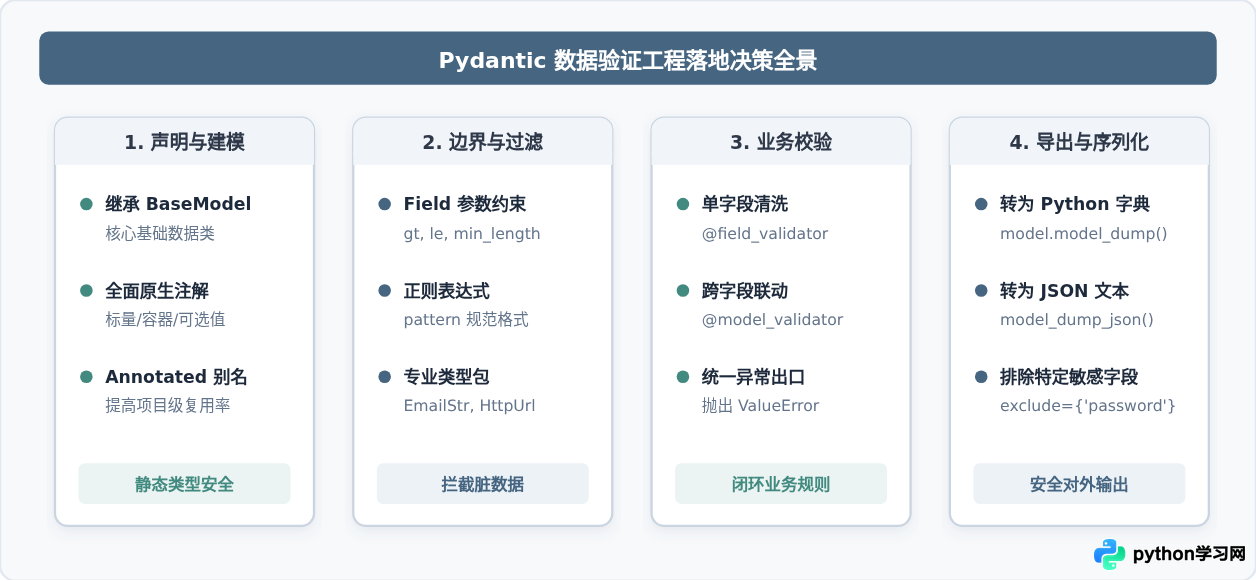
model.model_dump(exclude={'password'}) 屏蔽敏感信息,并使用 model_validate_json() 直接跳过 Python 原生 json.loads() 获得更快的解析性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















