


Python使用csv模块读取CSV文件的基础代码示例
详细讲解 Python 使用内置 csv 模块读取 CSV 文件的基础代码示例,涵盖 csv.reader 与 csv.DictReader 的使用方法、表头跳过、编码与换行符处理等核心细节。
读取 CSV 文件在日常数据处理中非常普遍。Python 标准库自带了 csv 模块,无需额外安装第三方依赖即可直接处理逗号分隔值文件。本文直接通过基础代码示例,讲解如何使用 csv.reader 和 csv.DictReader 两种核心方式读取数据,并说明跳过表头、编码设置及换行符处理等关键细节。
一、准备测试数据文件
为了能够直接运行后面的示例代码,我们先假定当前代码运行目录下有一个名为 employees.csv 的数据文件,包含以下内容:
name,department,salary
张三,技术部,12000
李四,市场部,9500
王五,运营部,8800
二、使用 csv.reader 按行读取数据
csv.reader 是最基础的读取工具。它接收一个已经打开的文件对象,将每一行按逗号切分,并返回一个字符串列表(List of Strings)。
1. 基础读取代码
import csv

# 使用 with 语句确保读取完成后自动关闭文件句柄
with open('employees.csv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file)
    for row in reader:
print(row)['name', 'department', 'salary']
['张三', '技术部', '12000']
['李四', '市场部', '9500']
['王五', '运营部', '8800']2. 跳过表头并提取字段
在实际业务中,我们通常需要跳过第一行的表头,只处理具体的数据行。因为 csv.reader 生成的是迭代器对象,可以直接使用 Python 内置的 next() 函数跳过首行:
import csv

with open('employees.csv', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file)

    # 提取并跳过首行标题
    header = next(reader)
    print("表头字段:", header)

    # 遍历后续数据行
    for row in reader:
        name = row[0]
        department = row[1]
        salary = int(row[2])  # 注意:csv读取出的数据均为字符串,数值需手动转换类型
print(f"姓名: {name}, 部门: {department}, 薪资: {salary}")表头字段: ['name', 'department', 'salary']
姓名: 张三, 部门: 技术部, 薪资: 12000
姓名: 李四, 部门: 市场部, 薪资: 9500
姓名: 王五, 部门: 运营部, 薪资: 8800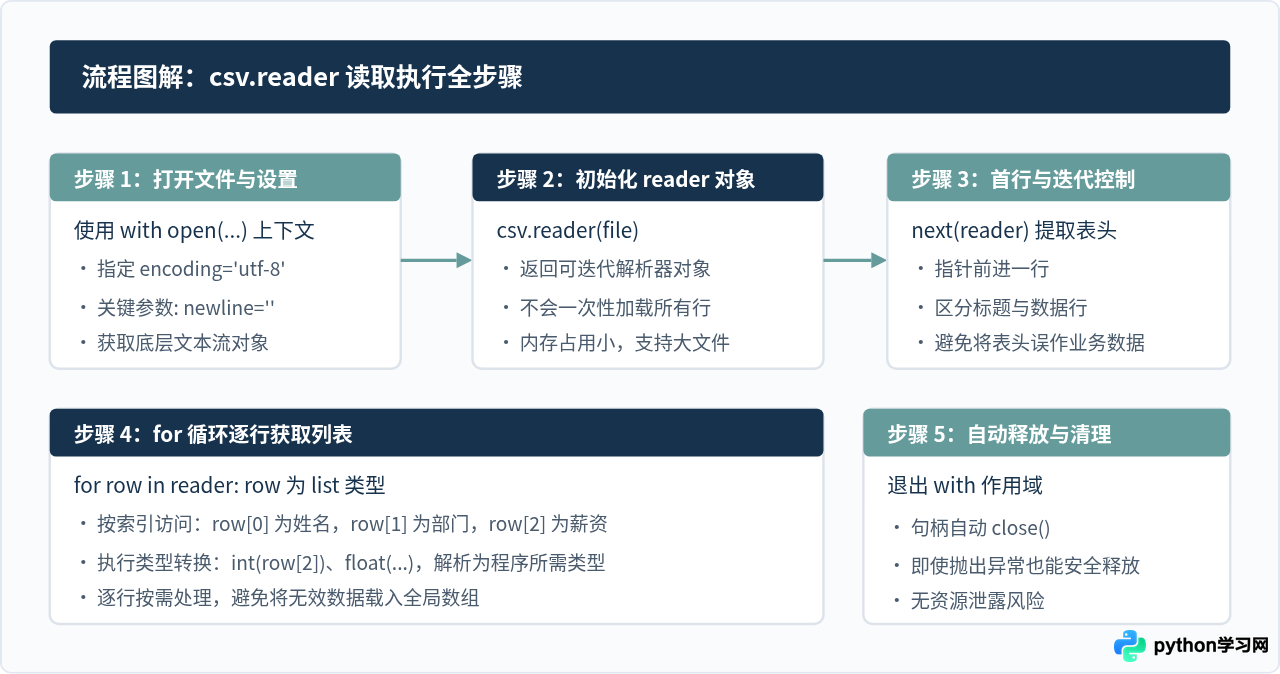
三、使用 csv.DictReader 按列名读取数据
如果 CSV 文件的列很多,或者列的相对顺序可能会发生调整,使用数字索引(如 row[0]、row[1])维护起来容易出错。这时推荐使用 csv.DictReader。
csv.DictReader 会自动把第一行识别为字典的键(Key),并将后续的每一行数据映射为以这些键为索引的字典对象。
1. DictReader 基础代码
import csv

with open('employees.csv', mode='r', encoding='utf-8', newline='') as file:
    # 实例化 DictReader,默认将首行识别为字段名
    reader = csv.DictReader(file)

    # fieldnames 属性保存了自动提取出的表头字段列表
    print("解析到的列名:", reader.fieldnames)

    # 逐行读取,此时每行数据均为字典结构
    for row in reader:
        # 直接通过列名读取字段,语义清晰
        name = row['name']
        dept = row['department']
        salary = int(row['salary'])
print(f"员工: {name:4} | 部门: {dept:6} | 薪资: {salary}")解析到的列名: ['name', 'department', 'salary']
员工: 张三 | 部门: 技术部 | 薪资: 12000
员工: 李四 | 部门: 市场部 | 薪资: 9500
员工: 王五 | 部门: 运营部 | 薪资: 8800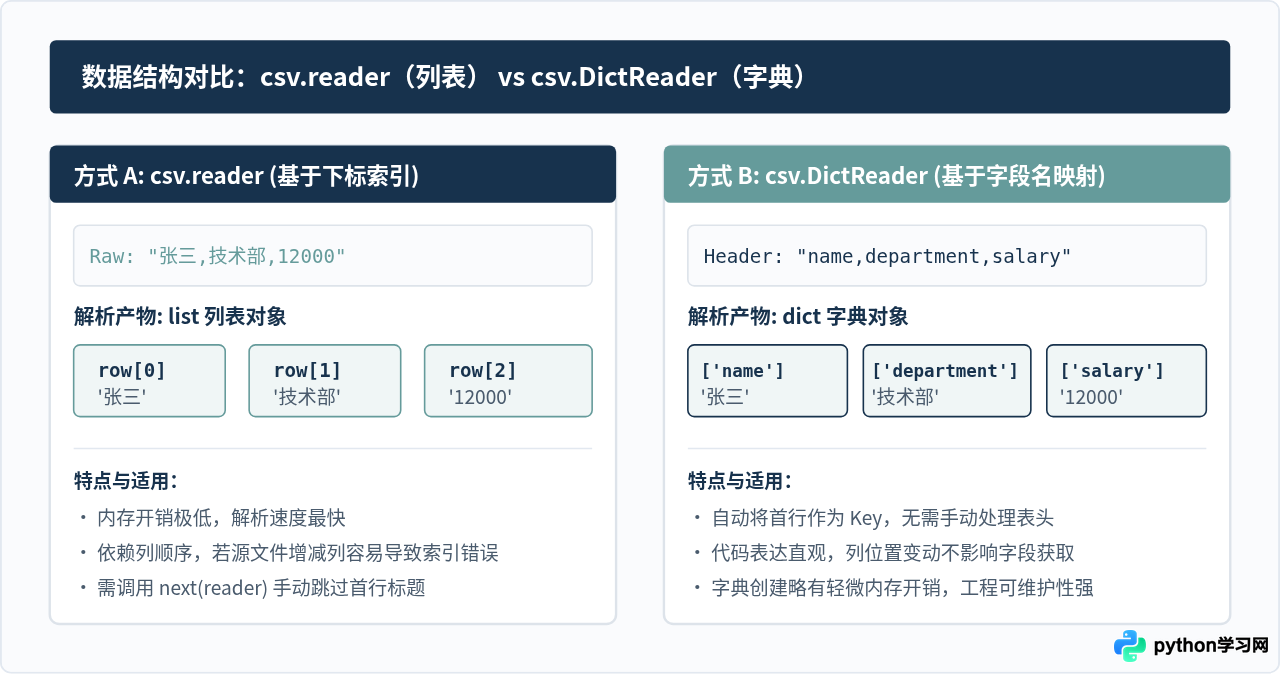
四、读取 CSV 文件时的核心注意事项
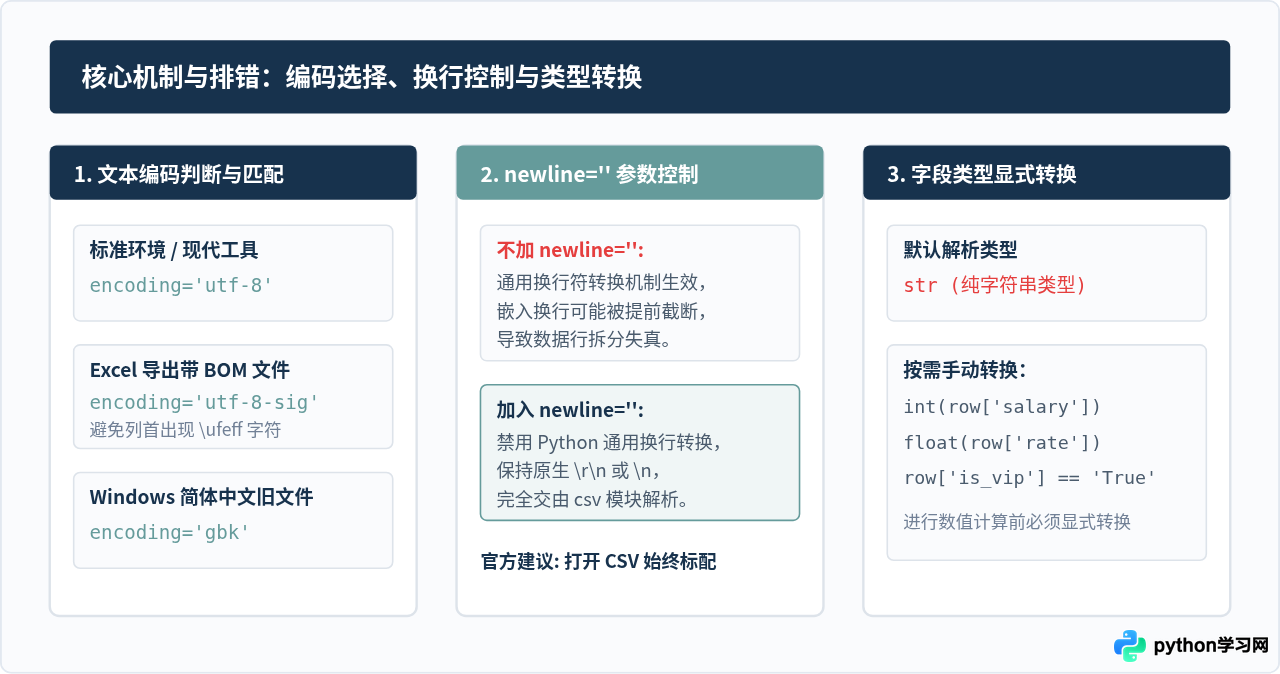
在使用 csv 模块时,有三个最常见的问题需要引起注意:编码格式匹配、换行符参数 newline='',以及读取出来的值全为字符串类型。
Python 官方文档明确要求:使用
csv 模块读取或写入文件时,open() 应该传入 newline=''。如果不传该参数,Python 的文本读取器会自动将不同操作系统的换行符(如 \r\n 或 \r)统一转为 \n,这可能导致单元格内部包含换行符时解析失误,或产生意外的空行。传入 newline='' 之后,换行符的具体识别将完全交由 csv 解析器内部处理。
• 如果是在 macOS/Linux 下生成的 CSV,通常为标准
utf-8。• 如果文件来自 Windows 版 Microsoft Excel 导出的“CSV UTF-8”,文件头部通常带有一个 BOM 标记(
\ufeff)。此时若用 encoding='utf-8' 读取,第一列的列名开头会包含多余的 \ufeff,导致 row['name'] 报 KeyError。解决办法是使用 encoding='utf-8-sig',Python 会自动剔除 BOM 标记。• 如果是老版 Excel 默认直接另存的 CSV,在简体中文系统下通常是
gbk 编码,需要明确指定 encoding='gbk'。
五、处理特殊分隔符与包含逗号的单元格
并非所有表格文件都严格以英文逗号分隔。例如制表符分隔文件(TSV)使用 \t,部分 European 格式文件使用分号 ;。同时,有的文本单元格内部本身就包含逗号,这时会使用引号包裹。
1. 指定自定义分隔符(delimiter)
import csv

# 读取以分号(;)分隔的文件
with open('custom_delimiter.txt', mode='r', encoding='utf-8', newline='') as file:
    reader = csv.reader(file, delimiter=';')
    for row in reader:
        print(row)
2. 处理含有逗号或换行的单元格
当 CSV 文件中有字段包含逗号时(例如地址 "Haidian, Beijing"),标准做法是用双引号将整个字段括起来。csv 模块默认已开启对双引号包裹字段的识别,会自动将引号内部的逗号作为普通字符处理,而不会截断成两个字段:
import csv
import io

# 使用 StringIO 模拟内存中的特殊 CSV 文本
sample_data = '''id,title,address
101,"Python基础教程","海淀区, 北京市"
102,"数据分析实战","天河区, 广州市"
'''

file = io.StringIO(sample_data.strip())
reader = csv.DictReader(file)

for row in reader:
print(f"ID: {row['id']} | 书名: {row['title']} | 地址: {row['address']}")ID: 101 | 书名: Python基础教程 | 地址: 海淀区, 北京市
ID: 102 | 书名: 数据分析实战 | 地址: 天河区, 广州市六、方案总结与选型参考
在 Python 生态中读取 CSV 数据主要有三种常见途径:内置的 csv.reader、内置的 csv.DictReader,以及第三方数据分析库 pandas.read_csv()。日常开发中可根据任务规模与后续处理方式合理选择:
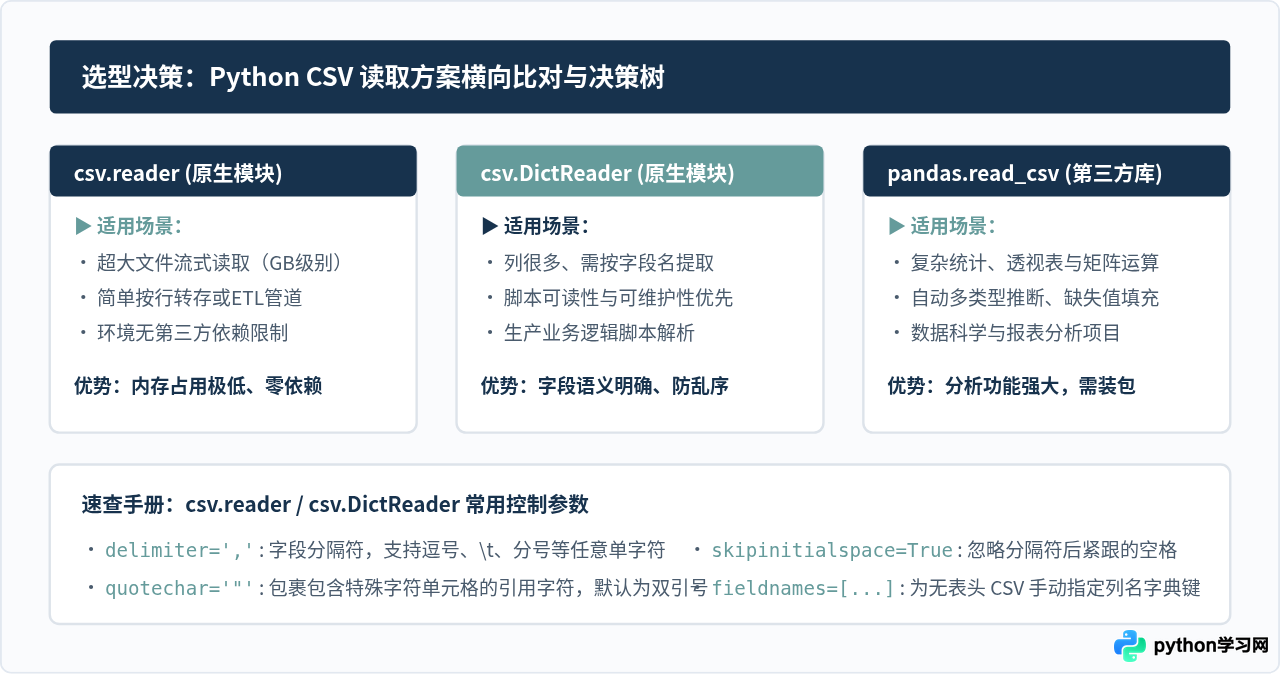
- 如果只是简单的单行遍历、过滤提取或无外部依赖的运维脚本,直接使用
csv.reader或csv.DictReader是最轻量、高效的选择。 - 如果涉及多表连接、分组统计或矩阵运算,建议使用
pandas.read_csv()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















