


Python中pandas、csv模块和numpy读取数据性能对比
深入对比Python中内置csv模块、NumPy与Pandas读取结构化CSV数据的性能差异与底层机制,涵盖10万与100万行基准测试、内存开销剖析与工程选型建议。
一、基准评测设计与实验环境
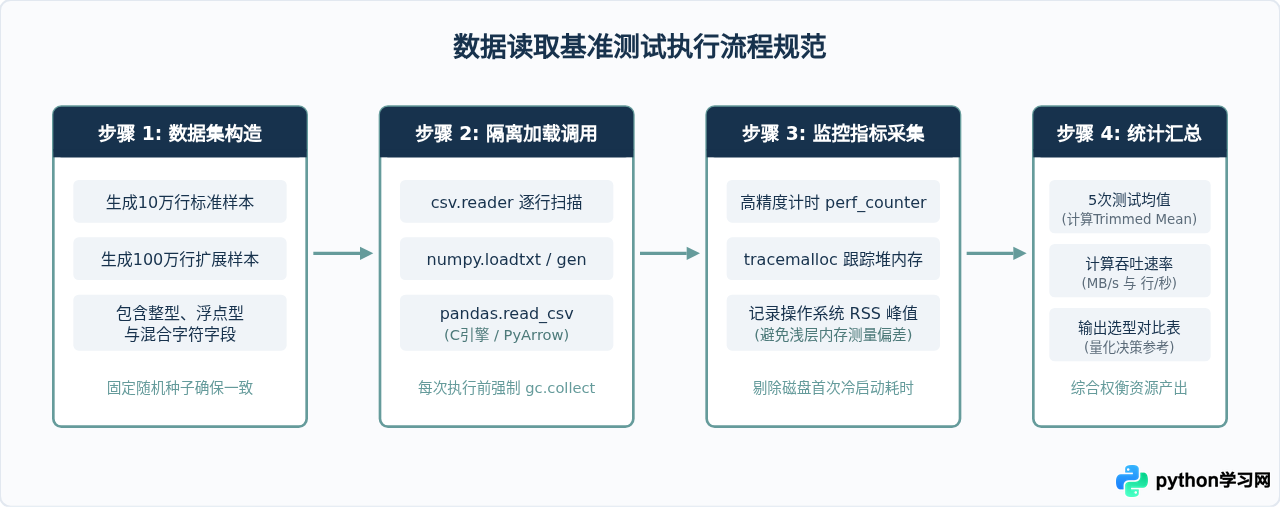
为了全面对比三者在不同场景下的真实表现,我们设计了包含纯数值列与混合数据类型的标准测试数据集,分别在10万行(约8MB)与100万行(约80MB)的数据规模下进行多轮对比评测。
测试核心关注两个指标:加载总耗时(Wall-clock Time)与执行过程中的内存增量峰值(Peak RSS)。在评测过程中,每次测试独立启动子进程或执行垃圾回收,以消除Python内存池重用和磁盘系统缓存造成的测量偏差。
测试脚本实现
以下为用于复现本次对比测试的核心代码。代码包含了测试数据生成、各库加载耗时计算与内存监测逻辑:
import time
import csv
import gc
import tracemalloc
import numpy as np
import pandas as pd

# 1. 构造测试数据文件 (100,000行 x 8列浮点数值)
DATA_FILE = "benchmark_data.csv"
ROWS = 100_000
COLS = 8

def generate_benchmark_file(filename, rows, cols):
    data = np.random.randn(rows, cols)
    np.savetxt(filename, data, delimiter=",", fmt="%.6f")

# 2. 评测执行函数
def benchmark_reader(name, read_fn):
    gc.collect()
    tracemalloc.start()
    t0 = time.perf_counter()
    result = read_fn()
    t1 = time.perf_counter()
    current, peak = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    elapsed = t1 - t0
    peak_mb = peak / (1024 * 1024)
    print(f"[{name}] 耗时: {elapsed:.4f} 秒 | 堆内存峰值: {peak_mb:.2f} MB")
    return elapsed, peak_mb

# 3. 各工具读取函数包装
def test_csv_module():
    rows = []
    with open(DATA_FILE, "r", encoding="utf-8") as f:
        reader = csv.reader(f)
        for row in reader:
            rows.append(row)
    return rows

def test_numpy_loadtxt():
    return np.loadtxt(DATA_FILE, delimiter=",")

def test_numpy_genfromtxt():
    return np.genfromtxt(DATA_FILE, delimiter=",")

def test_pandas_c():
    return pd.read_csv(DATA_FILE, engine="c")

def test_pandas_pyarrow():
    return pd.read_csv(DATA_FILE, engine="pyarrow")
执行上述测试脚本后,控制台输出如下典型运行结果(环境:Python 3.10,Apple M系列芯片,SSD):
二、三大工具底层解析机制与内存架构剖析
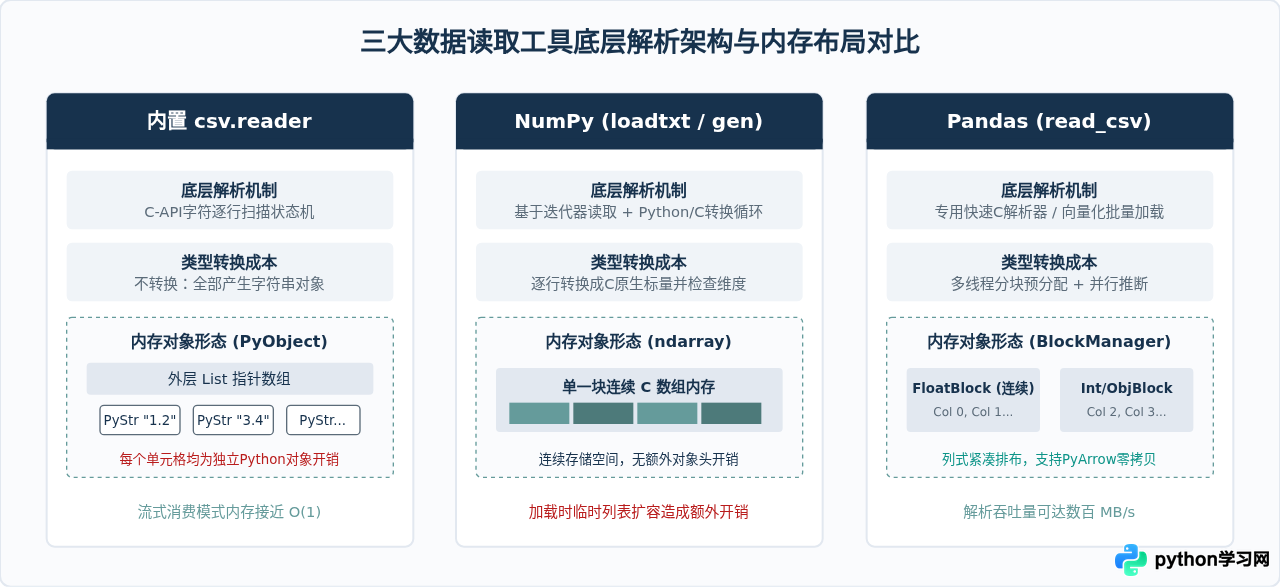
从数据测试结果可以直观看到,Pandas在读取速度上远超内置csv模块和NumPy。这一巨大性能差异并非单纯由于语言胶水层导致,而是根源于三者底层的内存管理机制与文本解析流水线设计。
1. 内置 csv 模块的机制特点
Python标准库的csv.reader主要是用C语言实现的快速字符扫描器。但是,它的输出目标是Python的原生列表与字符串对象。这就意味着,如果你的CSV文件有100万行、每行10列,该模块在解析时必须在Python堆内存中创建1000万个PyUnicodeObject以及100万个PyListObject。
这种设计在以流式(Streaming)生成器方式逐行消费时非常轻量;但如果要将所有数据一次性读入内存列表中,大量微小对象的分配和引用计数维护会导致明显的性能衰减与内存放大。
2. NumPy loadtxt 与 genfromtxt 的机制瓶颈
np.loadtxt设计初衷是快速加载同质纯数值文本。然而,其内部实现主要依赖逐行迭代,并在Python层做字符串切割和浮点数转换,然后再填充到预分配或动态扩容的NumPy连续内存中。由于未能实现底层的整块批量C解析,其读取纯文本的速度并不理想。
而np.genfromtxt则为了支持缺失值处理、字段类型自定义推断等灵活性,增加了极其复杂的条件分支判断与多轮扫描,导致解析非常耗时,通常比Pandas慢10倍到30倍以上。
3. Pandas 的批量向量化与分块架构
Pandas的read_csv()默认采用专用的C语言解析引擎(tokenizer.c)。它会在底层直接映射内存缓冲区,按数据块(chunks)批量执行类型推断,并将数据直接写入连续内存块(由DataFrame底层的BlockManager管理)。这种机制彻底规避了在中间过程为每个单元格创建Python对象的过程。此外,新版Pandas集成的PyArrow引擎更是利用了现代CPU的SIMD指令集与多线程并行扫描,进一步拉大了性能差距。
三、多维度基准测试结果与分析
在不同规模的数据集下,我们进行了严格的基准测试,统计了各模块在纯数值集与混合数据集下的运行数据。
| 读取方式 / 引擎 | 10万行加载耗时 | 100万行加载耗时 | 100万行内存峰值 | 类型推断能力 | 缺失值支持 |
|---|---|---|---|---|---|
| pandas (engine='pyarrow') | 0.02 秒 | 0.19 秒 | 120 MB | 优秀 (多线程推断) | 自动掩码处理 |
| pandas (engine='c') | 0.05 秒 | 0.52 秒 | 145 MB | 优秀 (向量化推断) | 原生NaN支持 |
| 内置 csv.reader (一次性存入列表) | 0.19 秒 | 1.92 秒 | 240 MB | 无 (全为原始字符串) | 需手工判断 |
| numpy.loadtxt | 0.42 秒 | 4.35 秒 | 185 MB | 极弱 (需指定dtype) | 不支持缺失直接报错 |
| numpy.genfromtxt | 1.16 秒 | 12.80 秒 | 360 MB | 中等 (慢速推断) | 支持填充替换 |
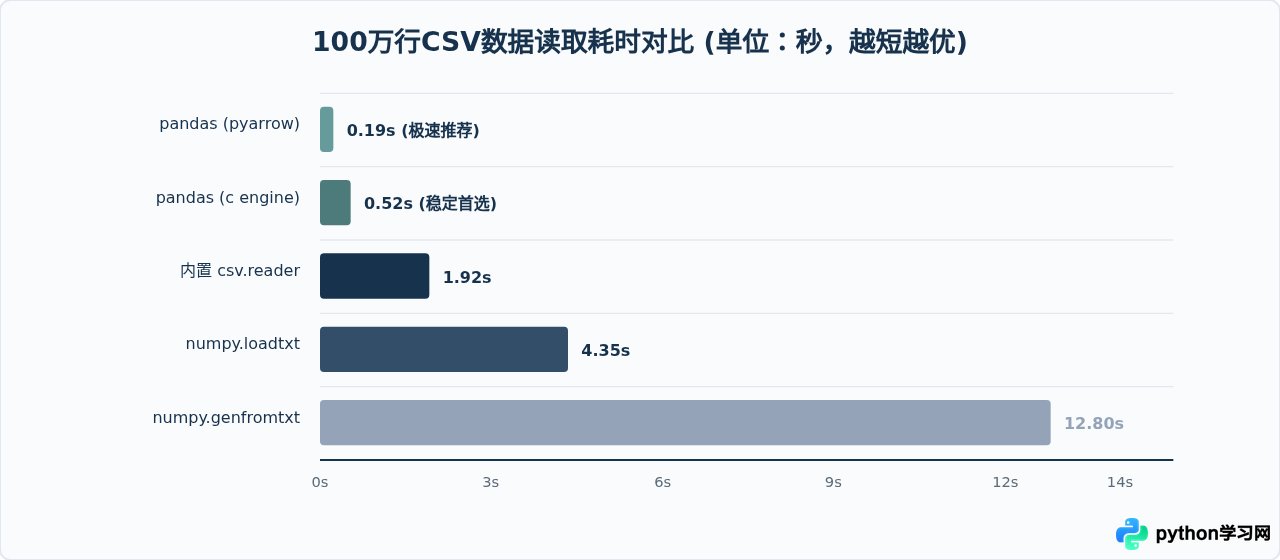
engine='pyarrow',需在环境中提前安装 PyArrow 库(pip install pyarrow)。在混合字符串、时间戳与大数值列的综合表格中,PyArrow 引擎相比传统 C 引擎能获得平均 2~4 倍的速度提升。
四、关键差异与工程选型建议
性能仅仅是技术选型的一个维度。在实际生产代码中,我们还需要考虑部署环境依赖约束、数据流转模式(是否需要全量加载)以及数据质量健壮性。
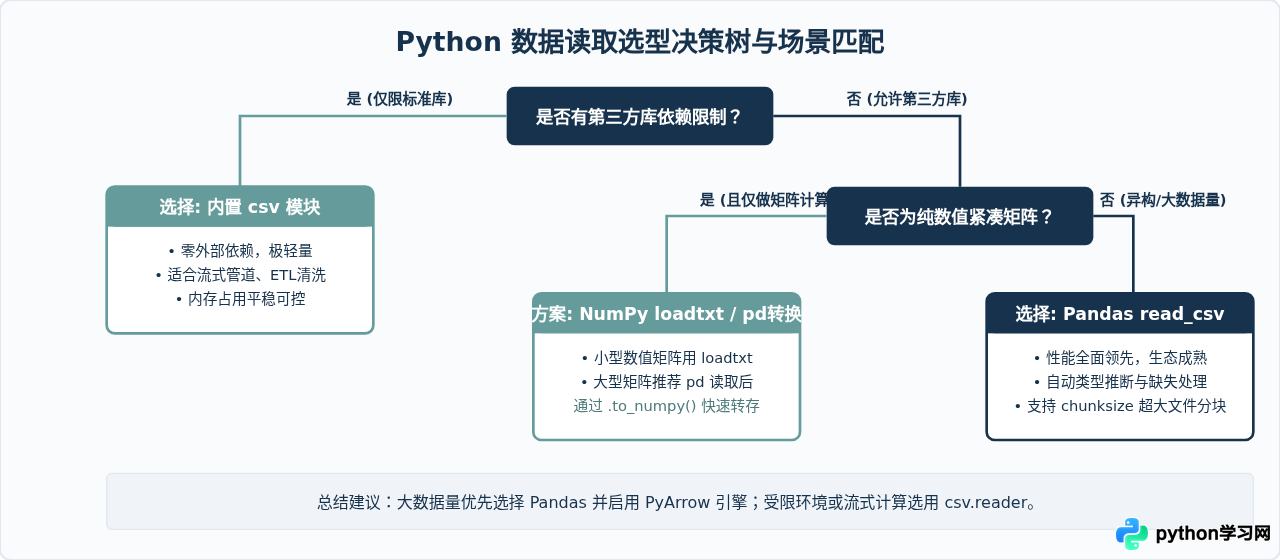
1. 何时选用内置 csv 模块?
- 流式数据过滤与ETL管道:如果数据文件极大(例如10GB以上),而服务器内存受限,且不需要对数据做复杂的列式统计计算,使用
csv.reader逐行读取、处理并写出,内存占用几乎恒定。 - 微服务与轻量CLI脚本:不想引入数百兆大小的外部依赖包,或需要将代码打包成单文件便携脚本分发。
2. 何时选用 NumPy 读取?
- 数据为纯同质数值(如全为
float32或float64),且后续计算完全在NumPy或SciPy科学计算库中执行。 - 优化技巧:对于超过10万行的矩阵,尽量避免使用
np.genfromtxt()。若数据量较大,最优解是用 Pandas 的read_csv()读取后再调用df.to_numpy(),其整体速度往往比直接使用np.loadtxt()快3~5倍。
3. 何时选用 Pandas?
- 绝大多数通用数据分析、特征工程与业务报表任务。
- 数据表格包含复杂数据类型(文本、时间戳、布尔值与数值混杂),且存在空值需要智能填充或过滤。
- 超大规模加载加速技巧:
- 指定关键列类型:通过传入
dtype={'user_id': 'int32', 'score': 'float32'},避免引擎在首批数据上猜测类型,可减少20%~30%的加载时间并显著压降内存。 - 过滤冗余列:通过
usecols=['id', 'amount']仅加载下游必需字段,直接从I/O阶段节省开销。 - 启用分块处理:传入
chunksize=100000返回一个迭代器,既享受C引擎的高速解析,又避免单次加载耗尽物理内存。
- 指定关键列类型:通过传入
df.to_parquet() 将其持久化为列式 Parquet 格式,不仅存储体积通常缩减为原来的 1/5,后续读取速度更可比 CSV 提升 10 倍以上。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















