


多个Python装饰器叠加时,执行顺序是怎么的?
深入解析Python中多个装饰器叠加时的执行顺序,从语法糖展开的定义期装配,到函数调用期的进出栈洋葱模型流程,结合完整代码示例与高清内联架构图,彻底讲透执行机制与工程实践准则。
假设你在编写一个核心的接口函数,为了保障接口的安全与性能,在函数定义上方连续叠放了权限拦截 @require_auth、日志耗时 @log_timing 与数据缓存 @cache_data 三个装饰器。但在测试时却出现了令人困惑的现象:原本预期未授权的请求应该被立即拦截,终端却依然打出了耗时日志,甚至还写入了缓存记录。之所以会出现与预期不符的行为,根本原因在于没有理清多个装饰器叠加时的两阶段执行顺序。
先给出一个明确直接的结论:多个装饰器叠加时,其执行顺序必须分为“加载定义期”与“运行调用期”两个不同阶段来看待。在 Python 模块导入或函数定义时,装饰器的装配顺序是自下而上(由内向外)进行的;而在函数实际被调用执行时,其内部逻辑则是按照自上而下进入前置代码、自下而上回溯后置代码的“洋葱模型”顺序运转的。
一、原理剖析:装饰器语法糖的等价展开
在 Python 中,装饰器符号 @ 本质上是一个语法糖。要理解多个装饰器的生效机制,首先要回到高阶函数的原始调用形式。当一个函数上方只有一个装饰器时,例如:
@decorator_a
def target():
    pass
这行语法糖在被 Python 解释器读取编译时,完全等价于执行了一次函数调用并重新赋值:target = decorator_a(target)。装饰器接收原函数对象作为参数,并返回一个包装后的新可调用对象(通常为内部函数 wrapper)。
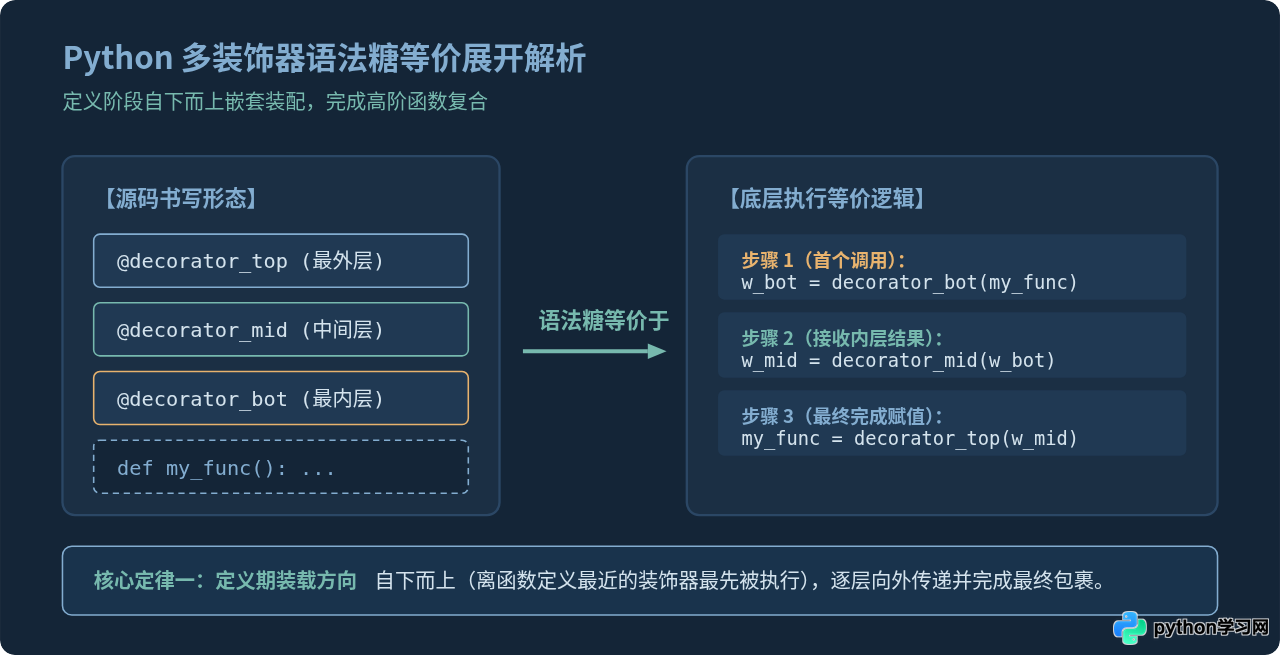
当多个装饰器自上而下垂直叠放时:
@decorator_a
@decorator_b
@decorator_c
def target():
    pass
Python 解释器在语法解析阶段,会严格遵循自内向外(即代码书写中自下而上)的原则进行嵌套包裹。上面的代码完全等价于下面这一行标准的嵌套函数赋值表达式:
target = decorator_a(decorator_b(decorator_c(target)))从数学和函数复合的角度来看,这相当于复合函数 $A(B(C(f)))$。最靠近原始函数定义的 decorator_c 必须首先接收 target 并完成包裹;其返回的新函数对象再作为参数传给上一层的 decorator_b;最后,decorator_b 生成的函数对象再传给最顶层的 decorator_a。最终赋回给变量名 target 的,其实是最外层 decorator_a 返回的包装对象。
二、运行调用链路:像洋葱一样的调用栈流转
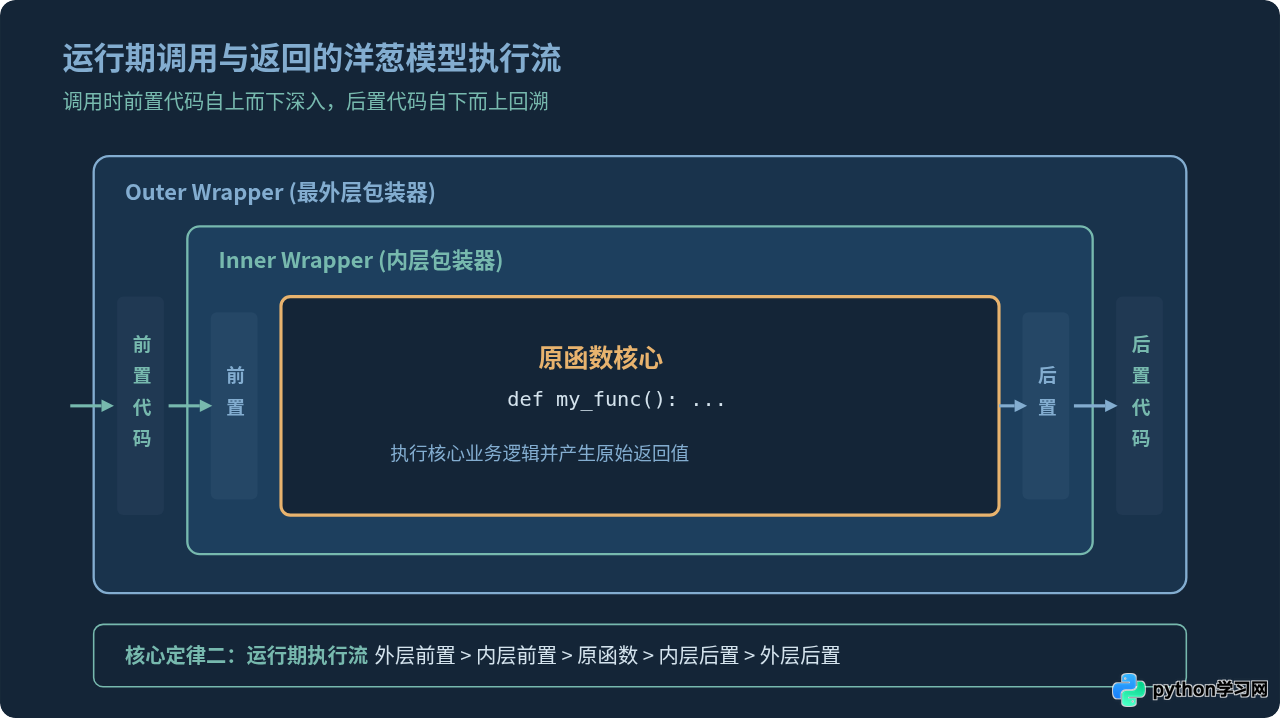
一旦模块加载完成,最终得到的 target 函数已经不再是最初由 def target() 声明的函数指针,而是被包装了三层闭包函数的最外层包装函数 wrapper_a。当我们发起函数调用 target() 时,程序会怎样走呢?
这时的执行模型与 Web 框架中间件(如 WSGI、Django 中间件或 Koa 洋葱模型)完全一致:
- 外层前置进入(自上而下):调用从最外层的
wrapper_a开始进入,执行wrapper_a内部调用下一层函数之前的代码(前置逻辑); - 中层前置穿透:
wrapper_a内部调用func(),实际上进入了中间层的wrapper_b,执行wrapper_b的前置代码; - 内层前置穿透:
wrapper_b内部调用func(),进入最内层的wrapper_c,执行其前置逻辑; - 到达目标核心:
wrapper_c最终调用到了最初始的target()原函数,执行核心业务逻辑; - 原函数返回出栈(自下而上):
target()执行完毕并返回值,控制权交回wrapper_c,执行其后置代码(收尾逻辑); - 中层后置收尾:
wrapper_c退出并返回值,控制权交回wrapper_b,执行其后置代码; - 外层后置收尾:
wrapper_b退出,最终回到最外层wrapper_a执行其后置逻辑,并将最终结果返回给调用者。
三、代码实测:用具体示例追踪执行轨迹
为了让读者直观印证上述两个阶段的先后顺序,我们编写一个最小可复现的验证脚本。在该脚本中,我们在每个装饰器的定义外层、wrapper 内部前置位置、wrapper 内部后置位置分别打印标记:
import functools

def decorator_one(func):
    print("[加载期] 正在装配 decorator_one")
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        print("[调用期] >>> decorator_one 前置逻辑开始")
        result = func(*args, **kwargs)
        print("[调用期] <<< decorator_one 后置逻辑结束")
        return result
    return wrapper

def decorator_two(func):
    print("[加载期] 正在装配 decorator_two")
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        print("[调用期]   >>> decorator_two 前置逻辑开始")
        result = func(*args, **kwargs)
        print("[调用期]   <<< decorator_two 后置逻辑结束")
        return result
    return wrapper

print("--- 步骤 1: 开始定义并装配函数 ---")

@decorator_one
@decorator_two
def greet(name):
    print(f"[调用期]     === 目标函数 greet 正在执行: Hello, {name}! ===")
    return f"ok:{name}"

print("--- 步骤 2: 函数装配完毕,准备发起首次调用 ---")
greet("Alice")
print("--- 步骤 3: 调用结束 ---")
在终端中直接运行该脚本,终端实际输出的完整日志如下:
--- 步骤 1: 开始定义并装配函数 ---
[加载期] 正在装配 decorator_two
[加载期] 正在装配 decorator_one
--- 步骤 2: 函数装配完毕,准备发起首次调用 ---
[调用期] >>> decorator_one 前置逻辑开始
[调用期]   >>> decorator_two 前置逻辑开始
[调用期]     === 目标函数 greet 正在执行: Hello, {name}! ===
[调用期]   <<< decorator_two 后置逻辑结束
[调用期] <<< decorator_one 后置逻辑结束
--- 步骤 3: 调用结束 ---
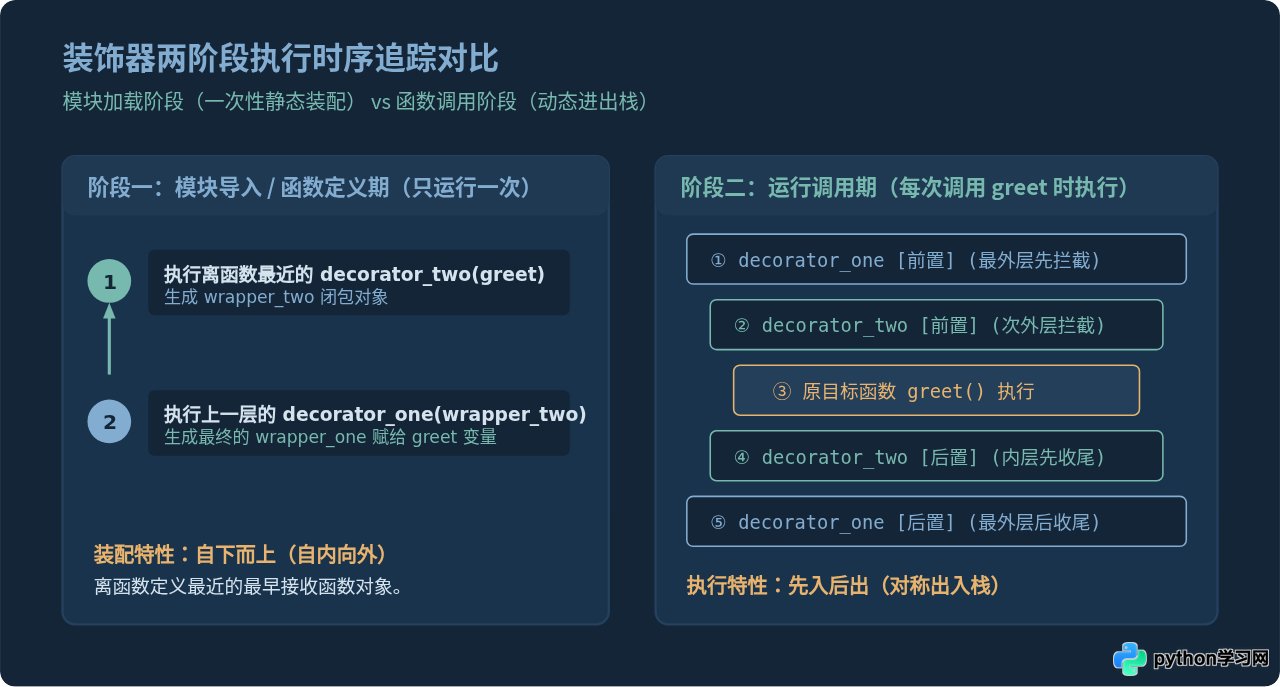
分析这份输出可以清晰印证两个结论:
- 在步骤 1 中,
greet函数刚完成定义,decorator_two先打印出装配日志,随后才是decorator_one。这充分证明了定义期的装配确实是从下往上进行的; - 在步骤 2 中,调用
greet("Alice")时,最外层的decorator_one前置逻辑先执行,接着是decorator_two前置逻辑,然后是目标函数本身;函数执行完毕后,内层的decorator_two后置逻辑先执行完毕,最外层的decorator_one后置逻辑最后收尾。
四、进阶场景与工程实践陷阱
在实际工程项目中,装饰器往往不是简单的无参结构,可能还会结合带参数装饰器以及元数据保留工具。这些场景会给执行顺序带来更多细节考量。
1. 带参数装饰器的执行时序
当装饰器本身支持接收配置参数时(例如 @validate(role="admin")),装饰器外层会包裹一层工厂函数。例如:
@deco_factory("A")
@deco_factory("B")
def action():
pass很多开发者会产生疑惑:此时工厂函数的调用顺序又是怎样的?答案是:工厂函数的求值调用是自上而下顺次执行的,但返回的装饰器函数的装配绑定仍然是自下而上的。Python 解释器在编译此代码时,会先求出装饰器对象:
# 第一步:自上而下计算工厂函数,获取真实装饰器
dec_a = deco_factory("A")
dec_b = deco_factory("B")

# 第二步:自下而上进行语法糖嵌套装配
action = dec_a(dec_b(action))
因此,如果你在工厂函数顶层打印日志,会发现参数传入阶段是按照从上到下的顺序求值的,但紧接着的函数包装依然遵循底层的自下而上规则。
2. functools.wraps 的多层传递
当函数被多层包装后,如果不使用 functools.wraps,函数的 __name__、__doc__ 以及类型注解都会被最外层的 wrapper 覆盖。在多个装饰器叠加的场景下,每一个中间装饰器的内部 wrapper 函数都必须显式使用 @functools.wraps(func)。这样元数据才能像接力棒一样,从最内层的真实函数一直无损传递到最外层,避免日志系统或 API 文档生成器读取到错误的函数名。
3. 多装饰器的工程排列原则
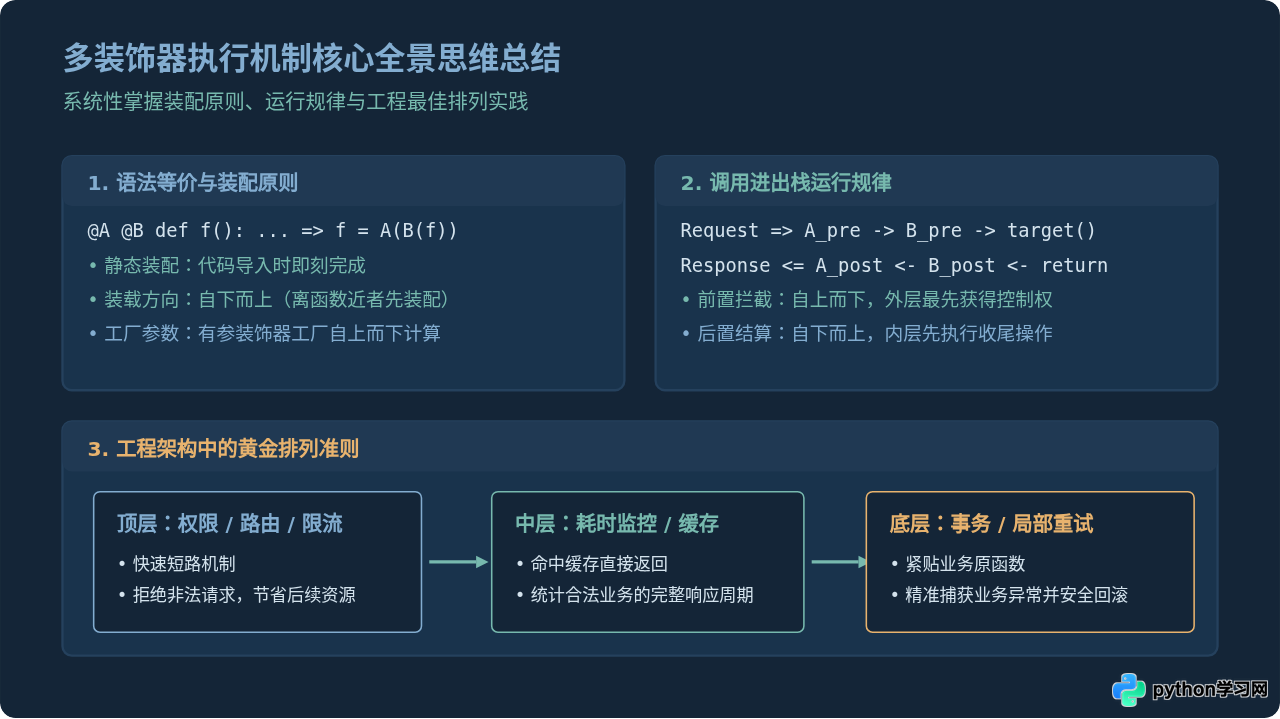
由于运行期前置逻辑是自上而下执行的,如果某个装饰器在满足特定条件时会直接中断执行(例如抛出异常、重定向或直接返回错误响应),那么该装饰器下方的所有内层装饰器和原函数都将不会被执行。基于这一机制,工程中建议遵循以下从外到内的排列顺序:
| 摆放位置 | 建议摆放的装饰器类型 | 典型场景与设计原因 |
|---|---|---|
| 最外层 (顶层) | 路由分发、快速失败与安全防护 | @app.route、@require_auth、@rate_limit。若权限校验或频率限制不通过,直接在最外层快速中断,避免产生后续无谓的资源消耗。 |
| 中间层 | 环境准备、全局监控与数据缓存 | @log_request、@cache_page。在确认请求合法后,再进行耗时统计或缓存查找。 |
| 最内层 (底层) | 事务管理、核心重试与类型转换 | @db_transaction、@retry_on_failure。紧贴原业务函数,确保只对真正的核心代码进行数据库事务回滚或失败重试。 |
五、全文总结
回顾核心问题“多个Python装饰器叠加时,执行顺序是怎么的?”,我们只需牢记以下三句话口诀:
- 装配定义阶段:自下而上。距离函数定义越近的装饰器越先执行函数对象的接收与包装;
- 调用进入阶段:自上而下。函数被调用时,最外层装饰器的前置逻辑最先执行,承担安全校验与快速失败职责;
- 执行返回阶段:自下而上。原函数执行完毕后,控制权逐层回溯,内层装饰器的后置逻辑先结算,最外层后置逻辑最后收尾。
在日常开发中,只要时刻牢记 @A @B def f() 等价于 f = A(B(f)),并将业务中的拦截器按“越需快速熔断越靠外、越贴近业务数据越靠内”的规则排列,就能写出结构严谨、执行顺畅的高质量 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















