


pandas3.0迁移到老项目有哪些必须注意的风险?
深入剖析将既有老项目升级至 pandas 3.0 所面临的核心风险,涵盖 Copy-on-Write 强制启用、PyArrow 默认字符串后端、废弃 API 与 inplace 移除、下游生态库断裂等问题,并提供四阶段渐进式迁移与测试避坑指南。
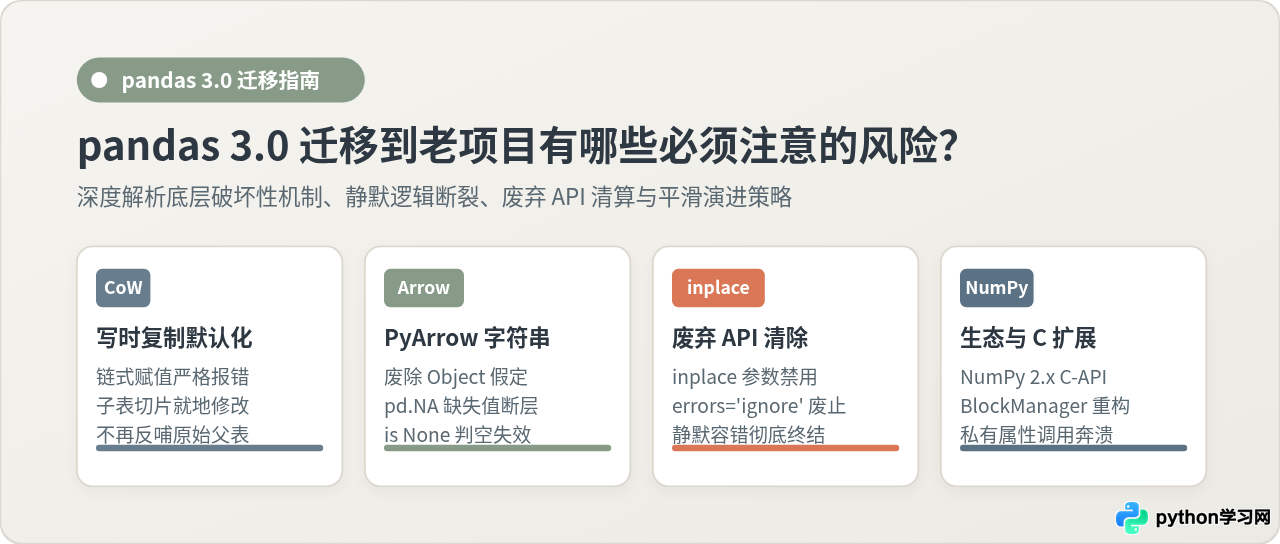
pd.NA 破坏原有的 is None 与 np.isnan 判空逻辑)、inplace=True 与静默容错参数彻底被移除,以及私有 BlockManager 重构引发下游生态与 C 扩展直接崩溃。老项目升级绝不可直接修改依赖版本上线,必须在 2.2+ 环境中完成警告清零与影子验证。
一、Copy-on-Write 强制启用:切片就地修改与视图逻辑全面失效
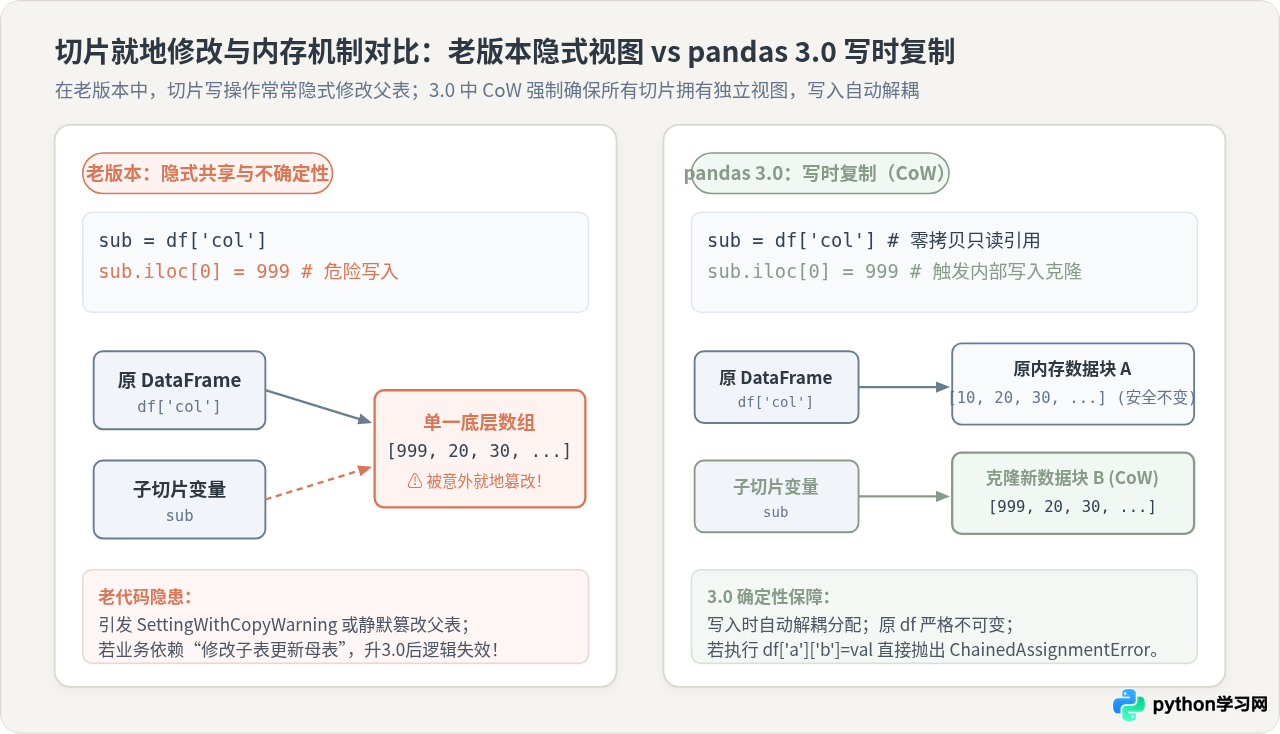
在 pandas 2.0 之前的历史版本中,从 DataFrame 截取子集(如 sub = df['col'] 或 sub = df.iloc[0:10])时,底层究竟是返回原数据的“视图(View)”还是独立的“副本(Copy)”,往往取决于内部内存的连续性和单个 Block 的分布。这种不确定性导致了臭名昭著的 SettingWithCopyWarning。许多老项目为了规避警告甚至编写了依赖“修改子表能顺带改变父表”的副作用代码。
在 pandas 3.0 中,Copy-on-Write(写时复制,CoW)成为唯一的不可选运行模式。任何切片或索引选取操作都会延迟克隆:在只读时共享同一块底层内存;而一旦尝试对切片或原对象执行任何写入或修改操作,pandas 会立即在内部克隆出独立内存块。这直接导致两个严重的迁移风险:
- 静默的业务逻辑脱节(最隐蔽 Bug):如果老项目中存在“提取切片 -> 在切片上做数据清洗或标注 -> 期望原 DataFrame 自动同步更新”的写法,在 3.0 中该操作将变成纯局部修改,原 DataFrame 的数据完全保持原样,程序不报任何错误但计算结果出现致命偏差。
- 链式赋值直接抛出
ChainedAssignmentError:老代码常见的形如df['price'][df['price'] < 0] = 0的链式修改,在 3.0 中会直接抛出硬性异常并中断进程。
老代码高危案例与 3.0 规范重构
以下展示老项目中常见的切片副作用代码,以及升级到 pandas 3.0 时必须采取的规范改写方式:
# 【老项目常见翻车代码:依赖子表修改反哺母表】
subset = df[df['status'] == 'pending']
subset['status'] = 'processed'
# ⚠️ 2.x 历史行为:可能修改 df,并抛出 SettingWithCopyWarning
# 💥 3.0 致命后果:subset 自动复制新内存,原 df['status'] 依旧是 'pending'!业务数据静默落空!

# 【pandas 3.0 官方推荐改写方案:使用 .loc 单一原子操作】
df.loc[df['status'] == 'pending', 'status'] = 'processed'

# 【若确实需要维护独立子集并进行修改,显式解耦生命周期】
subset = df[df['status'] == 'pending'].copy()
subset['status'] = 'processed' # 明确其为局部变量,不与 df 产生纠缠.iloc[] = 或直接属性赋值。凡是期望“子表变动同步到母表”的逻辑,必须重构成基于 .loc 的主表直接定位修改,或者使用 df.update() 显式合并。
二、默认字符串后端转为 PyArrow:类型假定崩塌与缺失值陷阱
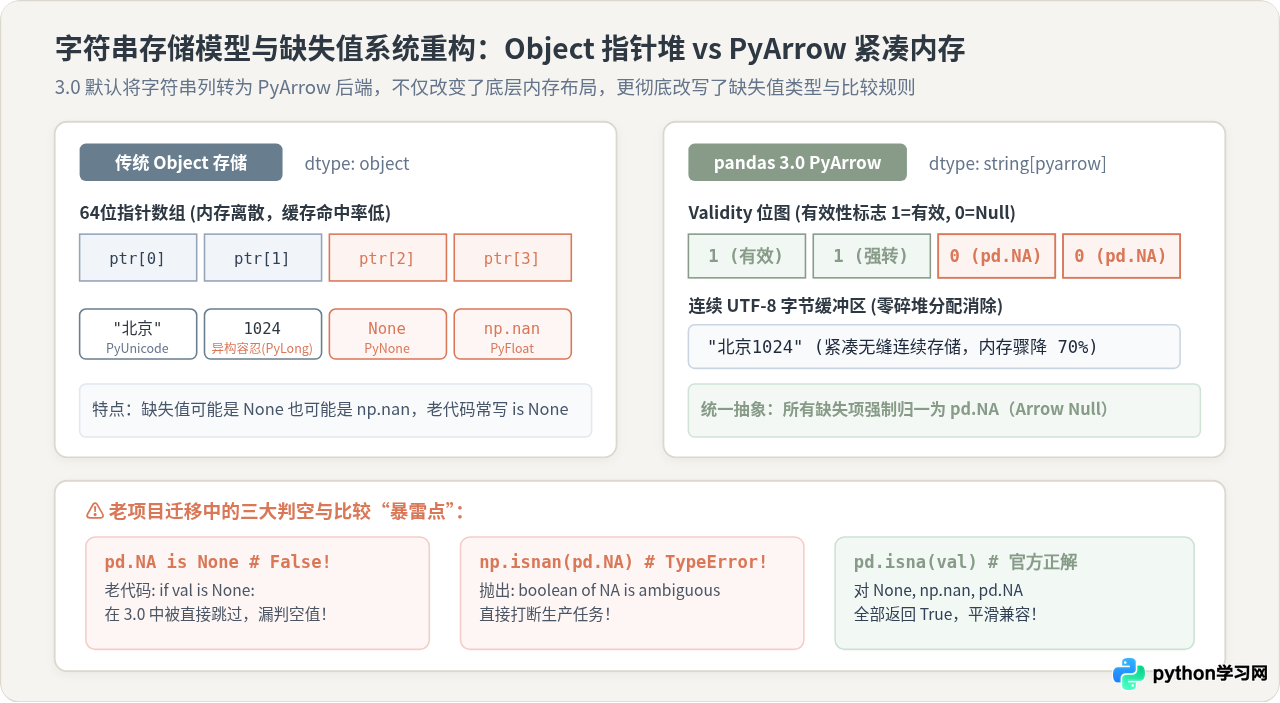
历史上 pandas 的文本列默认采用 Python 堆内存的 object 存储模式。一个 object 列实质上是一个存放 64 位指针的数组,每个指针指向 Python 堆中单独分配的 PyUnicode 字符串对象。这种机制极为低效,但老项目往往因此产生了一种“坏习惯”:将字符串列当成无所不能的“垃圾桶”,整型、浮点、字典、列表与字符串共存于同一列。
pandas 3.0 将默认字符串后端全面转向 PyArrow(即 string[pyarrow])。文本数据由底层的 Arrow 内存池以紧凑的连续字节数组(Contiguous Bytes Buffer)统一管理。这一飞跃带来了 5 至 10 倍的内存节约与极高的缓存命中率,但老项目迁移时将直接面临以下类型断裂风险:
- 异构数据注入直接报错:PyArrow 字符串列是严格的强类型列。如果在已有文本列中直接写入非字符串标量(例如
df.loc[0, 'str_col'] = 123),或者构造 DataFrame 时混杂复杂对象,Arrow 会强制校验或直接抛出TypeError/ArrowTypeError。 - 缺失值系统从
None/np.nan变为pd.NA:传统object列中的空缺可能由 Python 原生None或浮点np.nan表达。而在 PyArrow 中,空缺由 Arrow 的 Validity Bitmap(有效性位图)统一标记,映射到 Python 层即为统一标量pd.NA。
老代码判空逻辑的“连环暴雷”
在处理缺失数据时,老项目的 Python 业务逻辑通常包含很多原生条件判断。当底层缺失值变为 pd.NA 时,这些看似无害的代码将引发严重事故:
| 老项目代码写法 | 在 2.x (object 列) 的行为 | 在 3.0 (PyArrow 列) 的行为 | 正确重构方式 |
|---|---|---|---|
if val is None: |
当缺失项为 None 时判定成功 |
返回 False(漏判空值)pd.NA is None 为 False,缺失值被当成有效数据进入下游! |
推荐写法if pd.isna(val): |
if np.isnan(val): |
当缺失项为 np.nan 时判定成功 |
抛出 TypeErrorboolean value of NA is ambiguous,直接崩溃中断任务! |
推荐写法if pd.isna(val): |
if val: 或 if not val: |
根据非空字串求布尔值 | 抛出 TypeErrorpd.NA 遵循三值逻辑,无法直接转换为 Python 布尔标量 |
推荐写法if pd.notna(val) and val != "": |
df['name'] == 'Alice' |
空值项返回 False,生成标准的布尔 Series |
缺失值项返回 pd.NA,生成 boolean[pyarrow] Series(含空值) |
过滤时若需严格布尔掩码,使用 df['name'].eq('Alice').fillna(False) |
# 【老项目迁移中的危险函数示范】
def clean_username(val):
    # ⚠️ 历史老写法:在 3.0 中当 val 为 pd.NA 时,此分支无法命中!
    if val is None or (isinstance(val, float) and np.isnan(val)):
        return "UNKNOWN"
    return str(val).strip().lower()

# 【3.0 健壮的重构规范写法】
def clean_username_v3(val):
    # ✅ 使用官方统一判空接口,完美覆盖 None, np.nan 与 pd.NA
    if pd.isna(val):
        return "UNKNOWN"
    return str(val).strip().lower()
三、废弃 API 清算与静默容错终结:inplace=True 彻底退出历史舞台
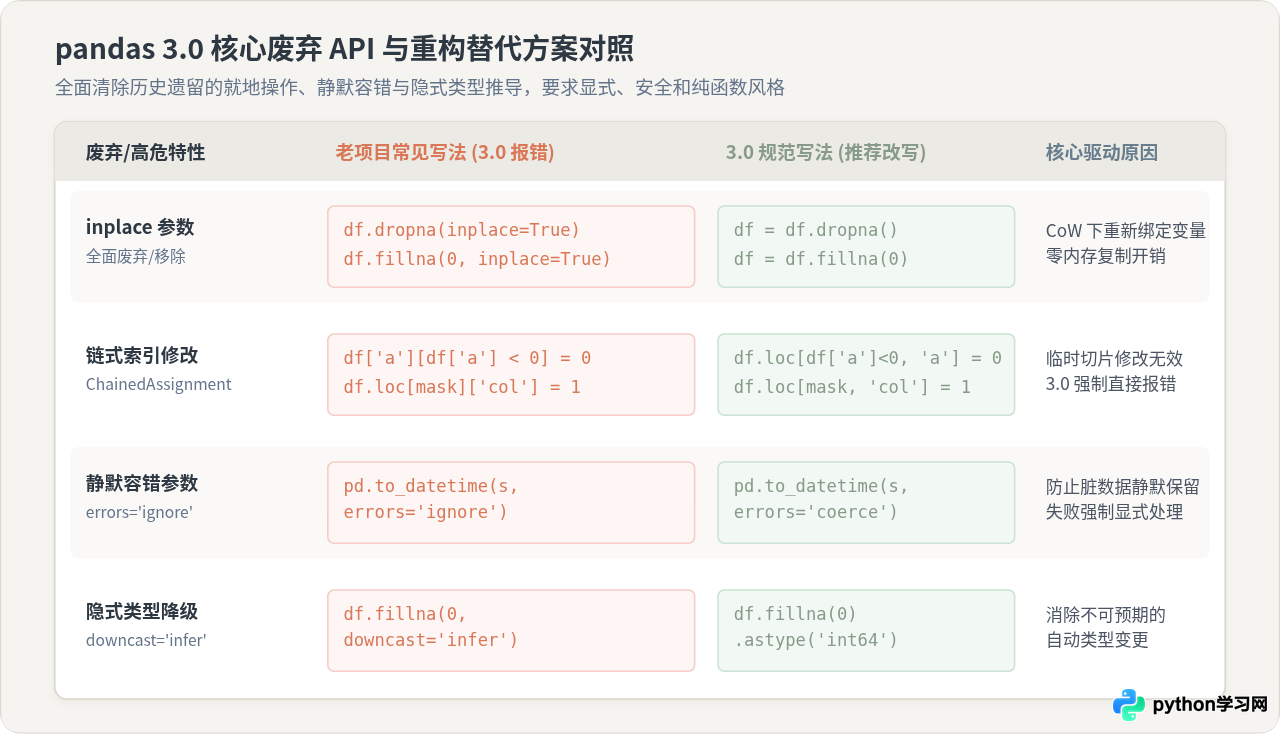
pandas 早期版本存在大量为了迎合初学者的“便利参数”,例如无处不在的 inplace=True、允许静默忽略错误数据的 errors='ignore',以及自动改变数据类型的 downcast='infer'。在长期的工业实践中,这些参数不仅没有带来内存优化的好处,反而破坏了代码的可预测性与函数纯度。
在 pandas 3.0 中,配合 CoW 架构的落地,官方对核心 API 进行了深度清洗:
1. 为什么 inplace=True 必须被清除?
许多开发者误以为 df.fillna(0, inplace=True) 或 df.dropna(inplace=True) 能够节省内存。实际上,在旧版 pandas 内部,大部分 inplace 操作依然是在生成新的内存数组后替换原有的 Block 引用,内存并没有真正就地减少。而在 3.0 的写时复制(CoW)机制下,写出 df = df.fillna(0) 并不会对未修改的列进行深拷贝,变量重新绑定的开销无限接近于零。因此,pandas 3.0 在绝大部分主流算子中正式移除或废弃了 inplace 参数,传递 inplace=True 将直接引发 TypeError 或明确异常。
2. errors='ignore' 的取缔对数据管道的冲击
在旧版 ETL 脚本中,开发者在解析时间或数值时常写:
df['date'] = pd.to_datetime(df['raw_date'], errors='ignore')
若解析遇到脏数据,旧版 pandas 会静默保留原字符串,不做任何转换。这导致大量脏数据潜伏在下游分析中。pandas 3.0 彻底废除了 errors='ignore'。现在只能在 errors='raise'(严格报错)与 errors='coerce'(无法解析则置为 NaT 或 NaN)之间二选一。若不修改代码,任务将直接在启动阶段抛出参数错误异常。
3. 降级推断(downcast)与时区混合运算收紧
老代码中通过 df.fillna(0, downcast='infer') 期望将浮点列自动转为整型的做法不再受支持,必须显式调用 .astype() 进行类型转换。此外,时区感知(tz-aware)与无时区(tz-naive)的 DatetimeIndex 或 Series 之间的算术混用与拼接在 3.0 中被硬性拦截,必须在操作前通过 tz_localize() 或 tz_convert() 显式统一口径。
四、下游生态与 C 扩展断层:BlockManager 变更与 NumPy 2.x 连锁反应
除了代码层面的 API 调整,老项目迁移到 pandas 3.0 往往会遭遇外部依赖库与底层扩展的“环境断崖”:
- NumPy 2.x 升级强制联动:pandas 3.0 的构建与运行强依赖于 NumPy 2.x 系列。NumPy 2.0 重构了 C-API 并改变了底层标量数据表示。如果老项目中混杂了旧版本编译的第三方轮子(如老版本
scipy、scikit-learn、tables、bottleneck等),导入时可能会遇到A module that was compiled using NumPy 1.x cannot be run in NumPy 2.x的致命导入错误。 - 内部私有
BlockManager接口清空:很多历史悠久的开源库或企业自研 Cython / C 扩展,为了追求极致性能,直接访问了df._data或df._mgr这类内部私有对象。pandas 3.0 对底层存储管理器进行了重构,直接调用私有属性的代码将抛出AttributeError,甚至引发 C 内存段错误(Segmentation Fault)。 - ORM 与存储适配器版本断裂:SQLAlchemy 在老项目(如 1.4.x 及更早分支)中直接与 pandas 交互的函数,可能无法适配 pandas 3.0 的 Arrow 字符串类型映射,需升级到 SQLAlchemy 2.0+ 对应版本。同样,旧版
fastparquet与openpyxl引擎也需要同步拉升版本以识别新的数据类型。
五、老项目平滑升级实操路径:四阶段渐进式验证方案
面对如此众多的破坏性变更,老项目切忌直接在生产环境中将 requirements.txt 改为 pandas>=3.0。最稳健的迁移路径应当分为以下四个阶段闭环推进:
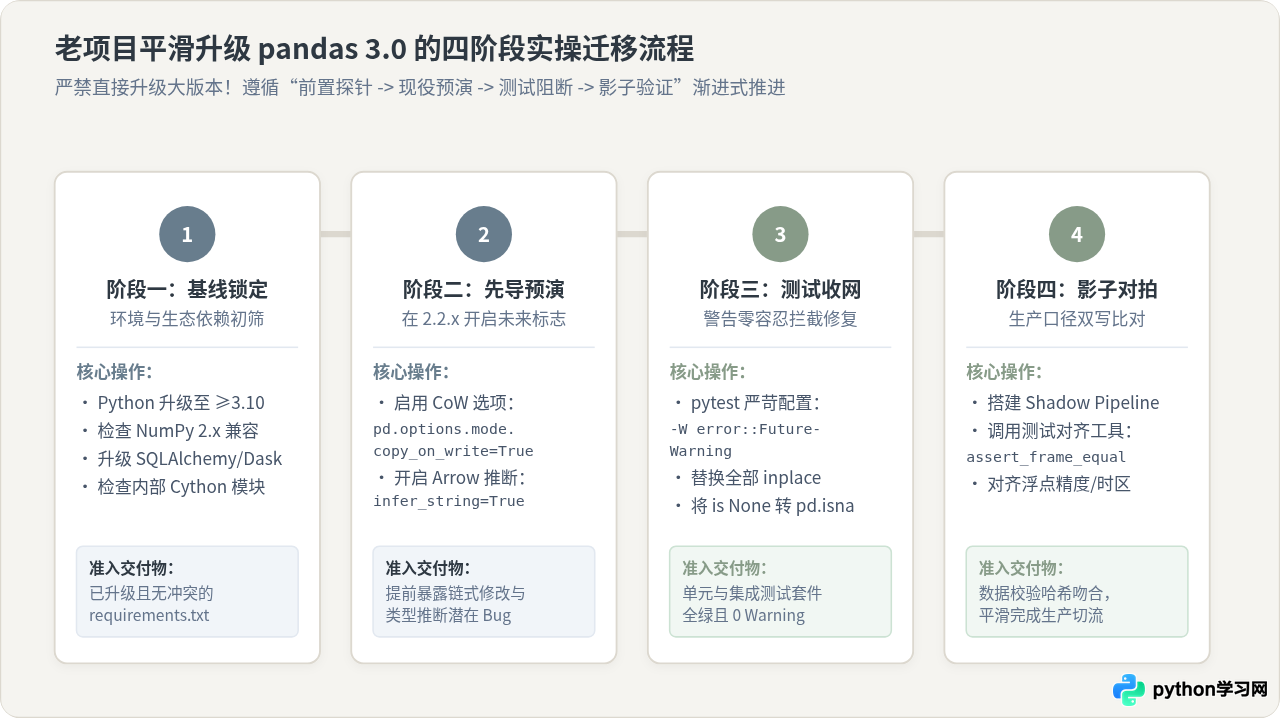
阶段一:基线探测与下游生态依赖前置升级
在修改任何业务逻辑之前,首先确认运行环境 Python 版本不低于 3.10。对 pyproject.toml 或 requirements.txt 中的周边依赖进行排查,重点将 numpy 升级到 2.0+ 候选版本,同步升级 sqlalchemy>=2.0、scikit-learn>=1.4 等核心数据栈,确保这些库在当前环境下无 ABI 冲突。
阶段二:在现役 pandas 2.2+ 环境中开启“未来模式”预演
无需立即安装 3.0,在当前 pandas 2.2.x 运行环境中,通过配置预先激活 3.0 的核心行为:
import pandas as pd

# 1. 开启写时复制(提前暴露出所有非法链式赋值与切片副作用)
pd.options.mode.copy_on_write = True

# 2. 提前开启默认字符串推断为 PyArrow 后端
pd.options.future.infer_string = True
将上述选项注入开发或测试环境的入口文件。此时所有即将失效的代码会以最真实的形式提前暴露,但底层依然处于受控的 2.x 环境中,排查阻力最小。
阶段三:单元测试开启 FutureWarning 零容忍模式
利用 pytest 的告警过滤机制,把即将到期的弃用告警全部转为错误,迫使团队在开发阶段彻底清理:
# pytest.ini 配置示例
[pytest]
filterwarnings =
    error::FutureWarning
    error::DeprecationWarning
error:.*ChainedAssignment.*:UserWarning执行测试套件:pytest tests/。逐步完成如下重构清单:
- 将所有
inplace=True剔除,改写为变量重新绑定; - 全局搜索
is None与np.isnan(),将涉及 Series/DataFrame 元素的值替换为pd.isna(); - 将
pd.to_datetime中的errors='ignore'调整为errors='coerce'并追加缺失值回填; - 将所有切片链式索引重构为标准的
.loc[row_indexer, col_indexer]。
阶段四:影子管道(Shadow Pipeline)数值与类型对拍上线
针对核心批处理或 ETL 管道,搭建双写影子环境:一边运行旧版代码,一边运行基于 pandas 3.0 改造后的代码。读取同一批生产输入快照,通过测试断言函数验证输出一致性:
from pandas.testing import assert_frame_equal

# 对拍新旧管道的输出 DataFrame
assert_frame_equal(
    legacy_df,
    v3_df,
    check_dtype=False,      # 第一步先容忍 string 类型从 object 变成 arrow string
    check_exact=False,      # 浮点数值允许合理公差
    rtol=1e-5,
    atol=1e-8
)
对拍连续稳定运行数个批次且指标无偏差后,方可完成正式生产切流。
六、总结与核心防御法则速查
升级到 pandas 3.0 绝非简单的版本号迭代,而是一次代码规范化与性能现代化的契机。通过提前梳理内存视图、类型系统与废弃参数,老项目不仅能避免隐藏的生产事故,还能享受 PyArrow 带来的巨大内存降本与吞吐提升。
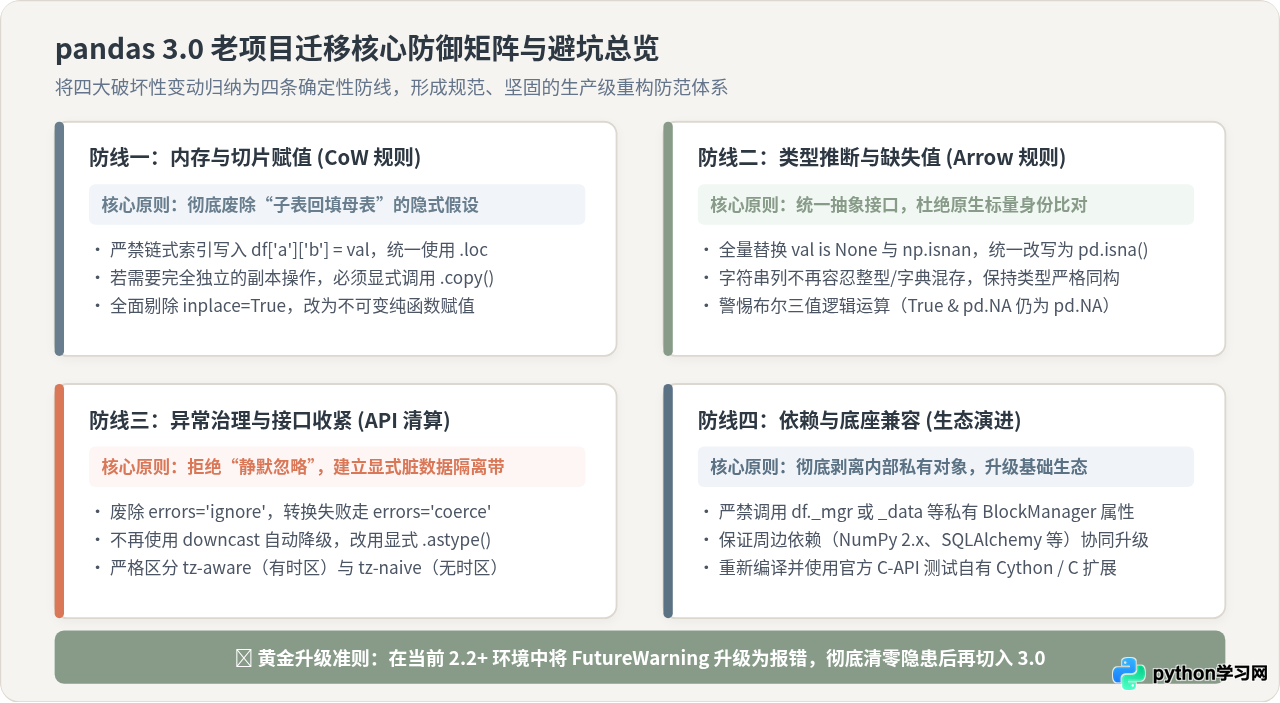
- [ ] 内存操作:全局已无
inplace=True;链式赋值全部改造为.loc;需要脱离原表独立存在的切片均显式追加.copy()。 - [ ] 判空与比较:文本列已废除
val is None与np.isnan(val)假定,统一收敛至pd.isna();空值参与的布尔过滤已考虑三值逻辑。 - [ ] 错误处理:所有
to_datetime与to_numeric均移除errors='ignore',改为coerce配合显式异常清洗。 - [ ] 生态依赖:NumPy 已平滑升级至 2.x 系列;SQLAlchemy 升级至 2.0+;内部扩展无直接调用
_data/_mgr私有属性。 - [ ] 测试与灰度:在 2.2+ 环境中已开启
mode.copy_on_write=True并完成pytest -W error::FutureWarning零告警清零。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















