


Python基本数据类型有哪些:六大标准类型详解
深入解析Python官方六大标准数据类型:Number(数字)、String(字符串)、Tuple(元组)、List(列表)、Set(集合)与Dictionary(字典)。系统讲解可变性差异、底层内存机制、核心语法及实际开发中的选型要点。
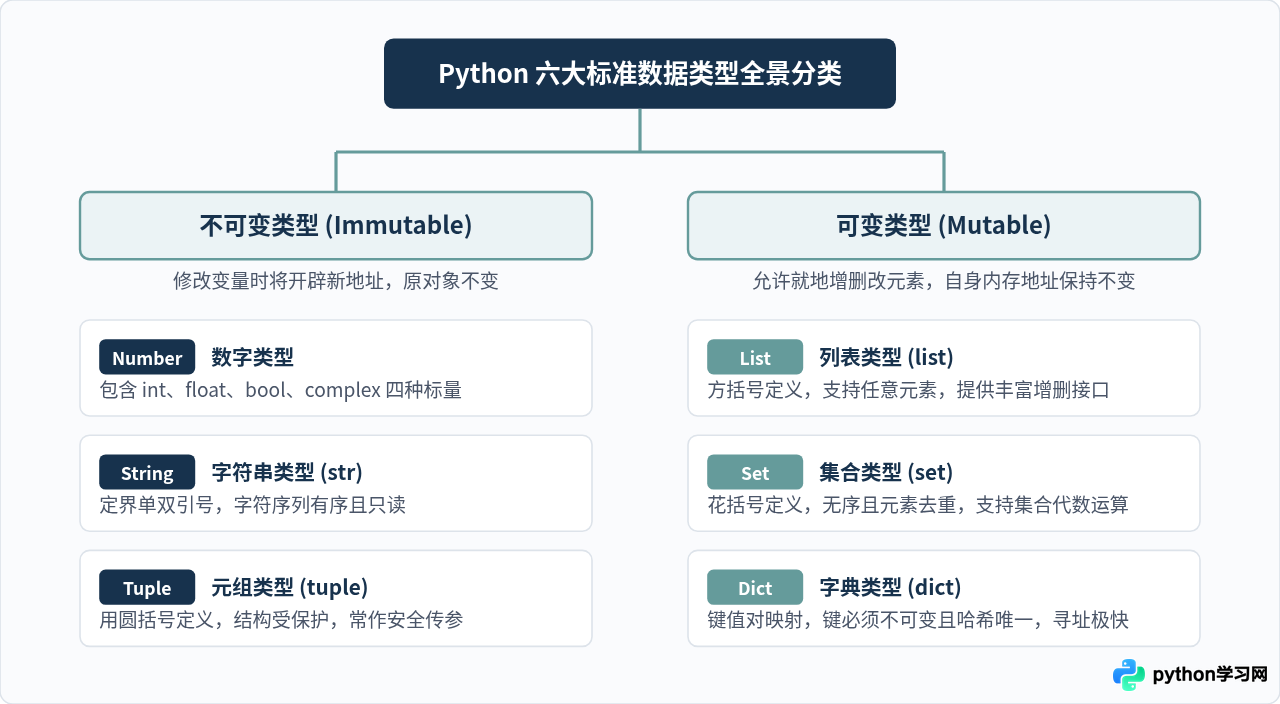
Python 官方定义的六大标准数据类型分别是:Number(数字)、String(字符串)、List(列表)、Tuple(元组)、Set(集合)以及 Dictionary(字典)。根据数据被分配后其内存中的值是否允许被就地修改,这六种类型可清晰地划分为两大阵营:不可变数据类型(Number、String、Tuple)与可变数据类型(List、Set、Dictionary)。理解这六种基础类型的特征、语法构造与底层特性,是编写高质量、高效率且不易出错的 Python 代码的关键基石。
一、不可变数据类型详解
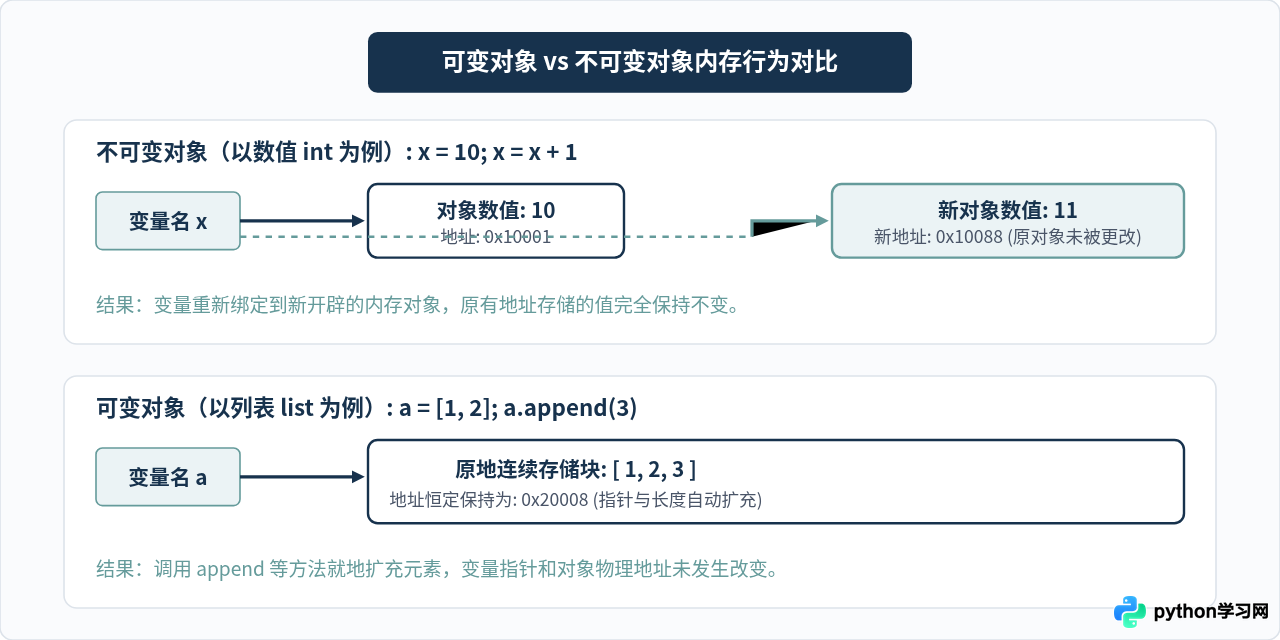
不可变类型的核心特征在于:一旦在内存中分配,其对象本身的数值或状态就无法被更改。当尝试对该类型的变量进行累加、替换或切片赋值等修改操作时,Python 并不会修改原有内存块中的数据,而是会在内存中开辟一个全新的对象,并将变量名重新指向这个新地址。
1. Number(数字类型)
Python 3 中的数字类型由四分子类构成,无需显式声明变量类型,解释器会根据赋值字面量自动推断:
- int(整型):在 Python 3 中整数具有任意精度,不会产生传统语言中的 32 位或 64 位整型溢出。例如
count = 1024。 - float(浮点型):由双精度浮点数实现,满足 IEEE 754 标准,支持标准十进制表示法与科学计数法。例如
ratio = 3.14159、expo = 1.2e-4。 - bool(布尔型):只有两个常量值
True和False。布尔型实际上是int的直接子类,在算术计算中True会被视作数值1,False会被视作数值0。 - complex(复数):由实部和虚部构成,虚部使用字母
j或J表示。例如z = 3 + 4j,可通过z.real与z.imag访问实部与虚部。
2. String(字符串类型)
字符串是用单引号 '、双引号 " 或三引号 ''' / """ 界定的连续文本字符序列。在 Python 中,单字符同样作为长度为 1 的字符串处理,不存在单独的 char 类型。
# 字符串基本定义与操作
message = "Python,DataTypes"
raw_path = r"C:\new_project\tasks"  # 原始字符串,不转义反斜杠

# 索引与切片访问
first_char = message[0]     # 'P'
sub_str = message[0:6]      # 'Python'
reversed_str = message[::-1] # 'sepyTataD,nohtyP'
由于字符串不可变,试图通过下标进行赋值(如 message[0] = 'J')会直接引发 TypeError: 'str' object does not support item assignment 异常。任何字符串替换操作(如 replace())均返回包含新内容的新字符串对象。
3. Tuple(元组类型)
元组是使用小括号 () 定义的有序序列。元组中各个元素用逗号隔开,元素允许为任意数据类型。由于元组具备不可变性,它常被用作函数的安全多返回值、配置参数传递以及作为字典的合法键(Key)。
避坑提示:定义仅包含一个元素的单元素元组时,必须在元素末尾添加英文逗号(如 single = (42,))。如果缺少逗号,解释器会把小括号解析为普通的数学运算优先级括号,从而使变量退化为整数类型。
二、类型判定与转换标准操作流程
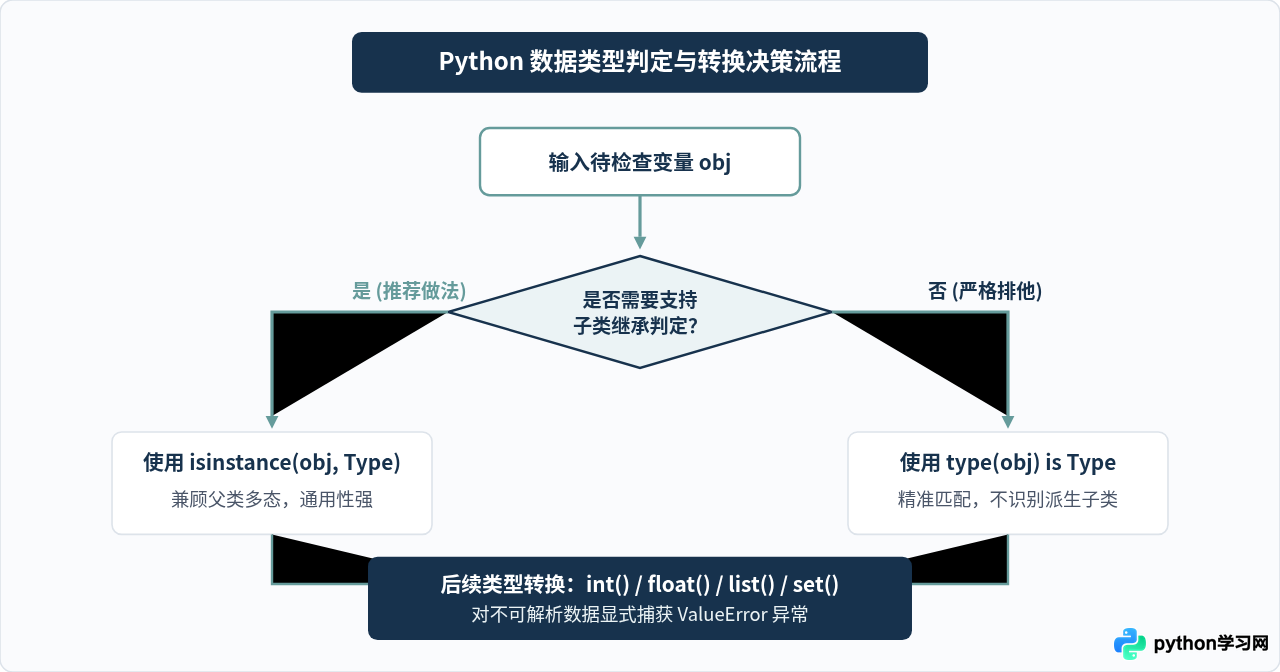
在日常开发与数据交互过程中,我们经常需要对未知入参进行类型校验或强制格式转换。以下是标准的类型判断与类型安全转换决策流程:
三、可变数据类型详解
可变类型的核心特征是:对象被创建后,能够直接在原内存块上就地修改其包含的元素或内容。其对象的内存唯一标识符(即 id())在整个生命周期中保持恒定不变。
4. List(列表类型)
列表使用方括号 [] 声明,是 Python 中最通用、使用频率最高的有序可变序列。列表内部维持一个动态数组结构,支持随时插入、追加、排序和切片替换。
# 列表常用操作与就地修改
fruits = ["apple", "banana"]
fruits.append("orange")    # 就地追加元素
fruits[0] = "cherry"       # 就地替换元素
fruits.extend(["pear"])    # 批量合并序列
print("列表修改后:", fruits)  # 示例输出: 列表修改后: ['cherry', 'banana', 'orange', 'pear']
5. Set(集合类型)
集合使用花括号 {} 或构造函数 set() 声明。集合是一组无序、不重复且元素必须为可哈希(不可变)类型的无序集合体。集合底层由哈希表(Hash Table)实现,因此其成员归属判定(x in my_set)的平均时间复杂度达到 $O(1)$。
# 集合去重与集合运算
raw_data = [1, 2, 2, 3, 4, 4, 5]
unique_set = set(raw_data)     # 快速去重: {1, 2, 3, 4, 5}

set_a = {1, 2, 3}
set_b = {3, 4, 5}
intersection = set_a & set_b   # 交集运算: {3}
union_set = set_a | set_b # 并集运算: {1, 2, 3, 4, 5}避坑提示:如果要创建一个空集合,必须使用 set()。若直接书写 empty_obj = {},Python 会将其优先解析为空字典(dict),而非空集合。
6. Dictionary(字典类型)
字典由键值对(Key-Value Pair)构成,格式为 {key: value}。自 Python 3.7 起,标准字典在规范层面上明确保证了保留元素的键插入顺序。字典的键必须满足可哈希性(通常使用 int、float、str 或 tuple),不可使用列表或字典等可变对象作为键。
# 字典定义与安全访问
user_profile = {
    "uid": 10086,
    "username": "developer",
    "roles": ["admin", "editor"]
}

# 推荐使用 get() 进行带默认值的安全访问
nickname = user_profile.get("nickname", "未设置")
user_profile["status"] = "active"  # 就地添加新字段
四、可变对象与不可变对象的底层内存机制对比
很多初学者在编写函数、传递默认参数或处理对象复制时产生 Bug,其根源往往是没有厘清可变对象与不可变对象在赋值和修改时对内存引用的区别。通过观察对象的地址标识 id() 可以清晰验证其内在逻辑:
五、开发中必须注意的三大常见陷阱
1. 函数默认参数不要使用可变对象
Python 中的默认参数只会在函数被首次定义和解析时计算一次。若在参数默认值中直接指定列表或字典(如 def append_item(val, container=[])),多次调用且未传参时,所有调用方将共享这同一个列表对象,导致数据异常累积。标准做法是将默认值设定为不可变的 None:
# 规范推荐写法
def append_item(val, container=None):
    if container is None:
        container = []  # 每次调用时独立生成新列表
    container.append(val)
    return container
2. 浅拷贝与深拷贝的界限
使用切片 lst[:] 或 lst.copy() 仅能完成浅拷贝(Shallow Copy)。若列表内部嵌套了子列表或字典,浅拷贝只会复制最外层容器,内部子对象的引用仍旧被共享。要实现真正完全独立的副本,必须使用标准库中的 copy.deepcopy()。
3. 循环遍历中直接修改列表的跳项风险
在 for item in my_list: 循环体内直接执行 my_list.remove(item) 会导致底层数组索引向前平移,造成部分连续元素被跳过漏判。若需根据条件过滤元素,推荐使用列表推导式或生成新列表:clean_list = [x for x in my_list if filter_rule(x)]。
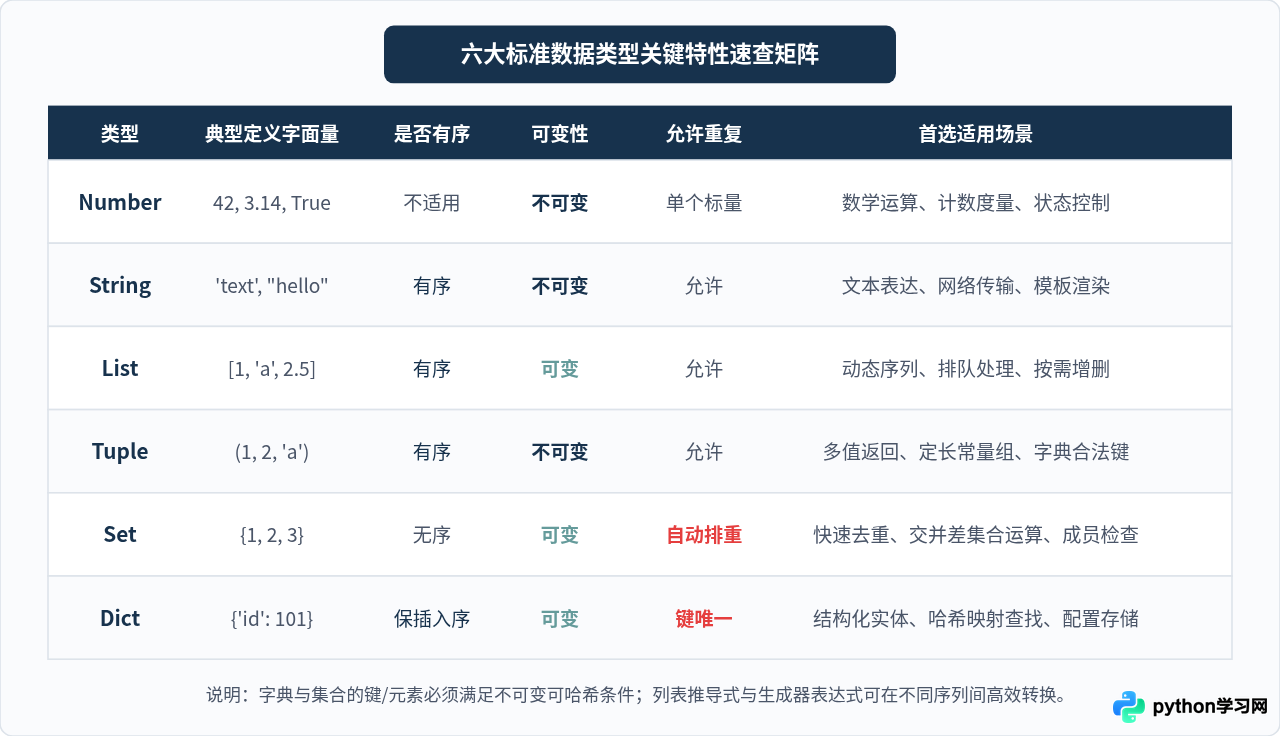
六、六大标准数据类型选型速查矩阵
在面对具体的业务场景时,选用何种类型应当基于数据是否需要保序、是否需要排重以及访问频次等多维度进行权衡:
总结
掌握 Python 的六大标准数据类型,核心不在于死记硬背语法糖,而在于深入理解“有序性”与“可变性”两大约束维度。不可变对象(数字、字符串、元组)具备先天的线程安全与状态稳定性,适合表达常量与静态结构;而可变对象(列表、集合、字典)提供了极高的就地操作灵活性与算法吞吐能力。结合 isinstance() 的严谨判定与深浅拷贝的明确界限,便能在实际工程开发中写出兼具可读性与健壮性的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















