


Python 3与Python 2的主要区别及为何Python 2已停止维护
全面解析Python 3与Python 2在文本编码、核心语法、内置函数与运行机制上的本质差异,并深入阐述Python 2在2020年正式终止维护的技术动因与存量系统迁移排查步骤。
Python 2 与 Python 3 的根本分歧不是几处语法细节的调整,而是为了解决语言早期在文本编码与类型体系上的深层设计缺陷,由官方主动推行的一次非向后兼容升级。Python 官方已于 2020 年 1 月 1 日正式终结对 Python 2 的全部技术支持(End of Life, EOL)。理解两者的核心机制差异与历史背景,不仅有助于维护存量项目,也能帮助开发者更严谨地编写现代 Python 代码。
一、核心机制变革:文本与二进制数据的严格划分
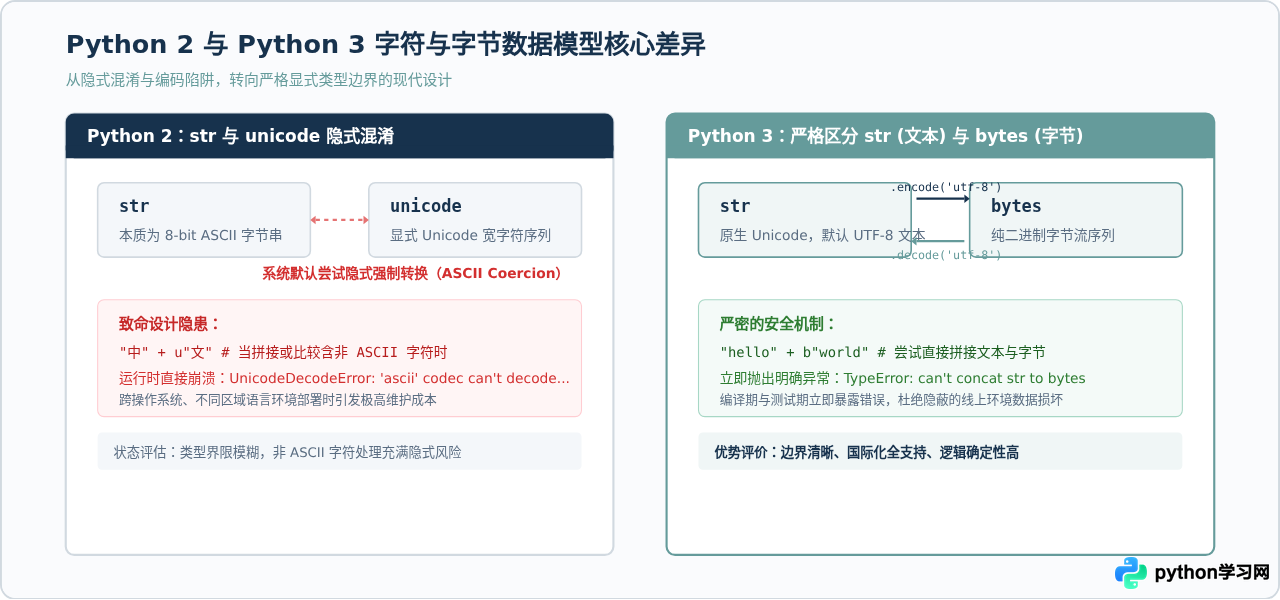
在 Python 2 中,字符处理一直是开发者最容易遭遇报错的痛点。Python 2 的 str 类型本质上是原始的 8 位字节串(bytes),而文本类型则由单独的 unicode 表示。当代码尝试将 str 与 unicode 拼接或比较时,Python 2 会尝试使用系统默认的 ASCII 编码隐式解码该字节串。一旦数据中出现中文等非 ASCII 字符,就会静默抛出令无数开发者困扰的 UnicodeDecodeError。
Python 3 从根源上重构了数据模型:
str原生代表 Unicode 字符:所有字符串均为符合 Unicode 规范的文本序列,源码默认采用 UTF-8 编码。bytes专门承载二进制数据:网络传输、文件读取、加密哈希等底层二进制数据必须使用bytes类型。- 强制显式编解码:文本与二进制数据严禁隐式混合。文本转二进制必须调用
str.encode(),二进制解析为文本必须调用bytes.decode()。
# Python 3 规范写法:必须通过显式方法进行格式转化
text = "人工智能"
raw_bytes = text.encode("utf-8")  # 得到 bytes 对象: b'\xe4\xba\xba\xe5\xb7\xa5\xe6\x99\xba\xe8\x83\xbd'
restored_text = raw_bytes.decode("utf-8")  # 还原为 str 对象
二、日常开发中的高频语法与内置行为差异
除了字符底层的重构,Python 3 对日常使用频率极高的内置函数与基本运算做出了多项关键改进,修正了不合直觉的遗留行为。
1. Print 语句变更为 Print 函数
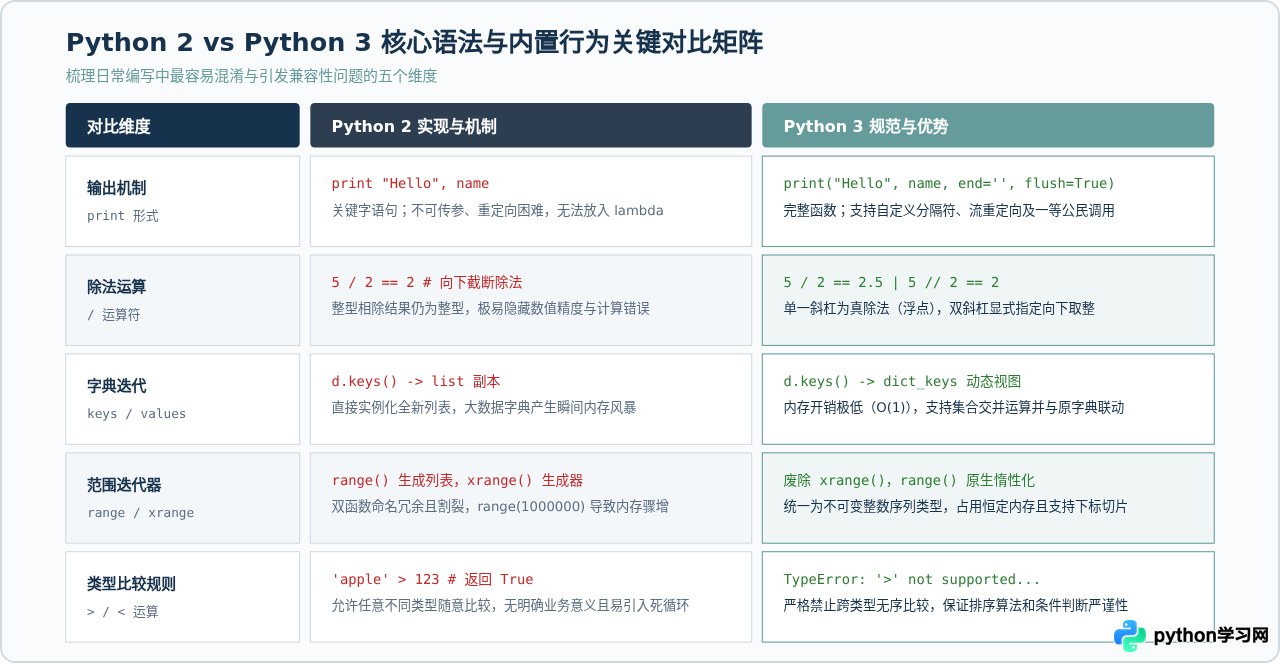
Python 2 中 print 是特殊关键字语句(如 print "Result:", 100)。由于不是函数,无法像常规函数那样传递、重定向或者在 Lambda 表达式中使用。Python 3 将其正式改为内置函数 print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False),提高了语法的规整性和组合能力。
2. 整数除法规则改变
在 Python 2 中,除法运算符 / 对两个整数相除默认执行地板除(向下取整截断),例如 5 / 2 的结果是整数 2。这经常导致初学者计算百分比时出现 0 的静默错误。在 Python 3 中,/ 统一为真除法(True Division),5 / 2 得到浮点数 2.5;若需向下取整截断,必须显式使用双斜杠整除运算符 //(例如 5 // 2 == 2)。
3. 字典操作与惰性迭代器普及
在 Python 2 中,调用 dict.keys()、dict.values() 或 dict.items() 会立即在内存中构建并返回一个包含所有元素的全新列表。当字典包含数百万条记录时,这会产生不必要的内存峰值。Python 3 将这些方法改为返回轻量级的动态“视图对象”(View),按需迭代且与原字典同步变动。同理,Python 2 中区分 range()(立即生成列表)与 xrange()(生成器);Python 3 则完全废弃了 xrange,将 range() 本身设计为轻量级惰性迭代对象。
4. 异常处理语法与类型比较严密化
Python 2 允许使用逗号分隔捕获异常(如 except Exception, e),容易与元组捕获混淆;Python 3 统一强制使用 except Exception as e。此外,Python 2 允许无逻辑关联的不同数据类型进行大小比较(例如 'abc' > 123 会返回 True,因为 Python 2 内部按类型名称字符串排序);Python 3 则直接抛出 TypeError,防止异构比较掩盖代码逻辑漏洞。
三、为何 Python 2 已在 2020 年正式停止维护?
很多初学者会产生疑问:既然 Python 2 拥有庞大的存量代码,为什么 Python 官方(PSF,Python Software Foundation)不能持续维护它?这一决策背后是技术发展的必然规律与生态资源的理性选择。
1. 打破向后兼容性的历史包袱
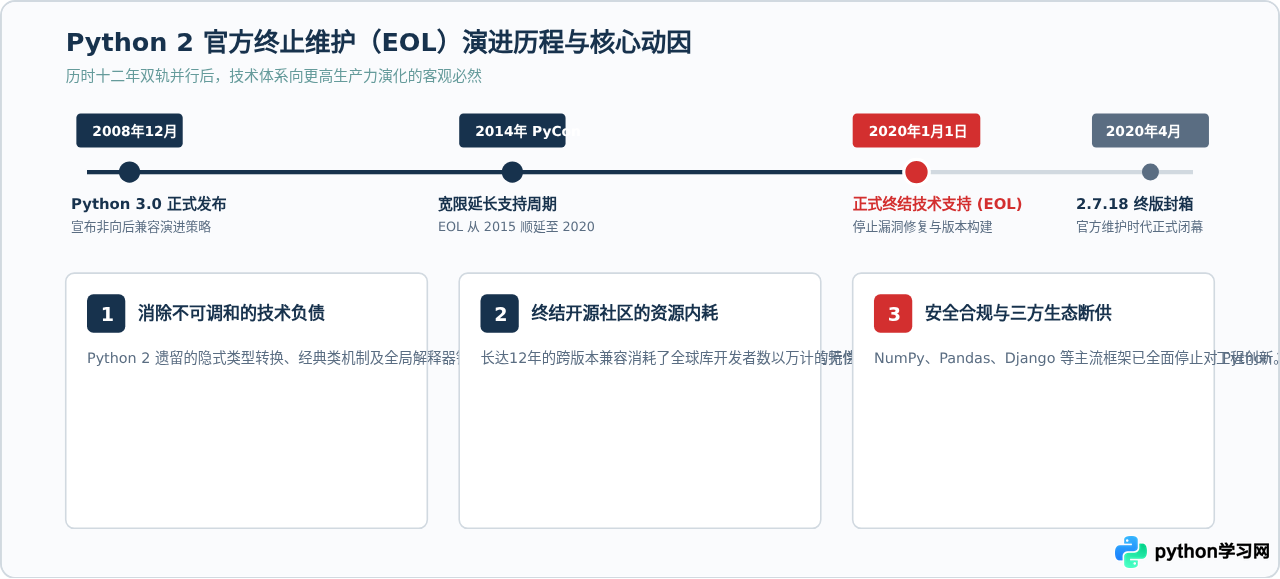
Python 3.0 早在 2008 年 12 月就已发布。当时 Guido van Rossum 和核心团队意识到,如果保留向后兼容性,就无法根除 str/unicode 的隐式转换缺陷,也无法清理历史积累的旧式类(Classic Classes)、杂乱的标准库模块结构以及低效的内存机制。为了让 Python 具备适应现代互联网和数据工程的高质量语言底座,必须允许不兼容升级。
2. 双轨维护对社区资源的巨大损耗
在 Python 3 发布后的十多年间,整个开源社区陷入了严重的双版本撕裂。所有主流开源库(如 NumPy、Requests、Django 等)的维护者必须花费双倍精力和时间编写兼容代码(例如使用 six 库兼容语法),核心开发团队也必须同时维护 Python 2.7 和 Python 3.x 两套分支。原本预计在 2015 年终结 Python 2,但为了给大型企业遗留系统充分的迁移过渡期,官方将寿命延长至 2020 年 1 月 1 日,这一过渡期已足足持续了 12 年。
3. 安全风险与生态断代不可逆
停止维护意味着官方不再为 Python 2.7 提供任何安全修复、Bug 补丁以及新操作系统平台适配。自 2020 年起暴露的 SSL/TLS 协议缺陷、哈希碰撞拒绝服务漏洞(DoS)及解析器安全隐患均无法在 Python 2 上得到官方修补。继续在生产环境中运行 Python 2 将直接违反各类企业安全合规标准。
四、存量 Python 2 项目现代化迁移实战路径
如果当前企业或个人仍有运行在 Python 2 环境下的历史脚本,应遵循标准工程方法分阶段升级至 Python 3。切忌直接盲目改写代码,建议按照以下四个标准化步骤执行。
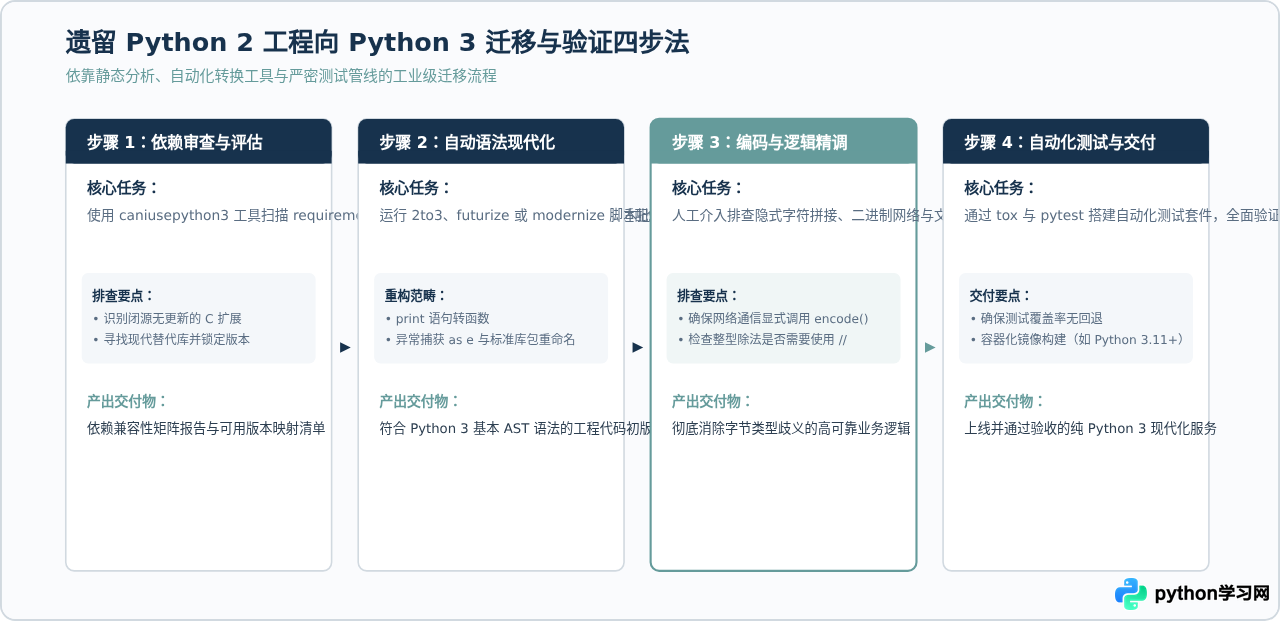
迁移常用命令示例
# 1. 检查当前项目的第三方依赖兼容性
pip install caniusepython3
caniusepython3 -r requirements.txt

# 2. 预览指定代码目录在 2to3 规则下的修改建议
2to3 -d path/to/project

# 3. 确认无误后就地写入转换修改(建议先提交 Git 版本控制)
2to3 -w path/to/project五、总结
Python 3 并非 Python 2 的简单增量更新,而是针对 8-bit 字节串混淆、整数除法截断、旧式类冗余等核心设计缺陷所进行的全面清障。Python 2 的正式终结是整个开源生态历经 12 年长跑后的必然归宿。对于现代软件工程,全面拥抱 Python 3 不仅消除了潜在的安全合规隐患,更能充分享受类型注解(Type Hints)、异步编程(asyncio)、结构化模式匹配(Pattern Matching)以及解释器性能深度优化所带来的巨大技术红利。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















