


Python可变类型与不可变类型区别:内存机制与使用陷阱
深入解析Python中可变类型与不可变类型的核心区别,从底层的对象内存模型、变量引用绑定展开,结合默认参数陷阱、深浅拷贝和原地操作符等经典陷阱提供切实有效的避坑实践。
很多初学者接触 Python 时都会遇到一个令人困惑的现象:给一个变量重新赋值,另一个同名赋值的变量毫发无损;而给一个列表追加元素,另一个本以为独立的列表变量却跟着发生了改变。这种行为差异并不是语法特例,而是由 Python 底层的内存引用机制与对象的“可变性(Mutability)”决定的。理解可变与不可变类型的核心界限,是规避意外数据篡改、编写健壮程序的基石。
一、核心界定:什么是可变类型与不可变类型?
在 Python 中,所有数据都是对象,变量名本质上只是指向这些内存对象的“标签”(引用)。当对象在内存中被创建之后,其内部的值是否允许就地修改,决定了它的类型归属:
- 不可变类型(Immutable Types):对象一旦分配内存并创建,其内部状态便固定不可变。若想改变变量的值,解释器必须在内存中开辟新区域生成新对象,并让变量名重新指向新地址。常见类型包括:
int、float、str、tuple、frozenset、bytes、bool。 - 可变类型(Mutable Types):对象创建后,其内部存储的数据内容可以直接修改(如增删改元素),且对象在内存中的首地址保持不变。常见类型包括:
list、dict、set、bytearray。
我们可以使用内置函数 id() 查看对象在 CPython 中的内存地址,直观验证两者的本质区别:
# 1. 不可变对象(整数)
x = 10
print(f"修改前 x 的 id: {id(x)}")  # 示例地址:140728956891216

x = x + 1
print(f"修改后 x 的 id: {id(x)}")  # 示例地址:140728956891248(已生成新对象,地址改变)

# 2. 可变对象(列表)
nums = [1, 2]
print(f"追加前 nums 的 id: {id(nums)}")  # 示例地址:2185203792512

nums.append(3)
print(f"追加后 nums 的 id: {id(nums)}")  # 示例地址:2185203792512(就地修改,地址完全不变)
二、内存机制剖析:从指针重绑到就地更新
深入理解这两种类型的关键在于观察变量名、指针引用与内存对象空间三者在操作过程中的动态流转。
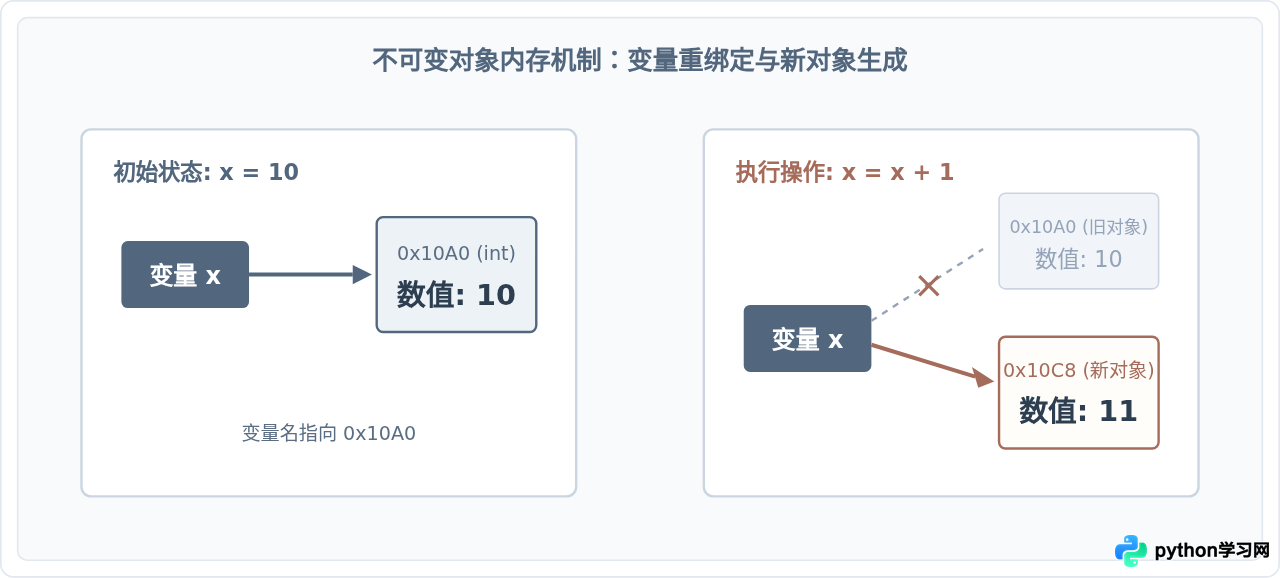
1. 不可变类型的“重新绑定”机制
对于不可变类型,任何看似“修改”的操作(例如字符串拼接 s += "!"、数值递增 i += 1),底层都不会在原有的内存块上覆盖数据。CPython 会直接分配一块新的内存区域放置运算结果,并将变量标识符重新绑定到该新地址上。旧对象若失去所有引用,将由垃圾回收器(GC)自动清理。
2. 可变类型的“原地就地更新”机制
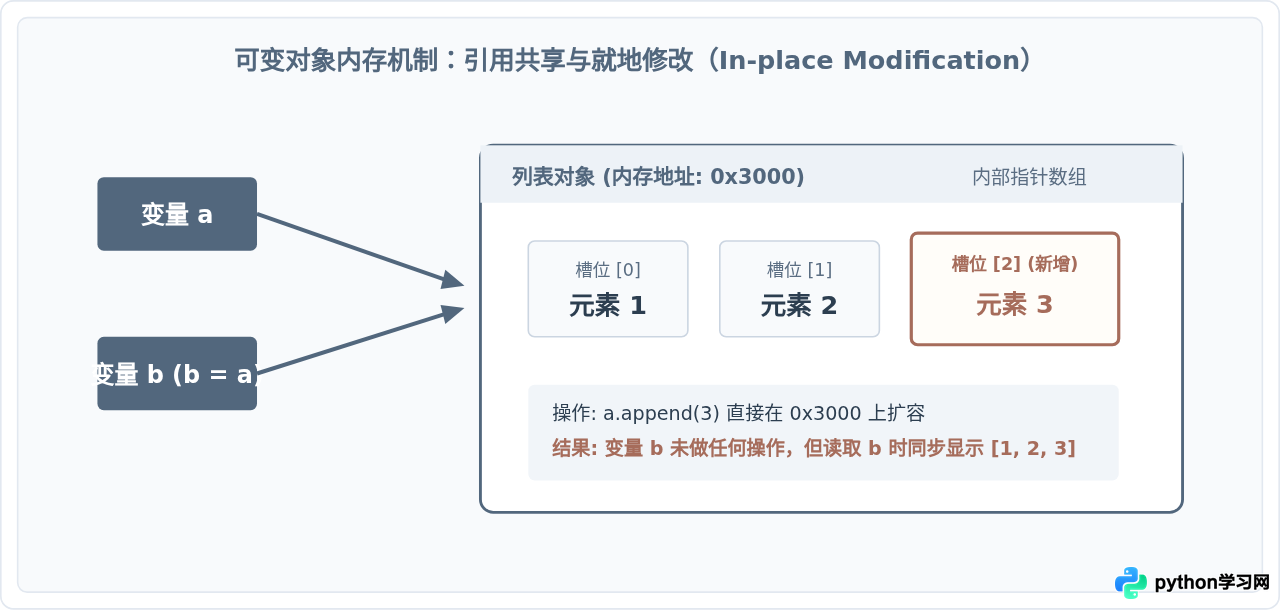
可变类型的核心在于对象本身的容器结构。列表在底层存储的是一组指向实际元素的指针数组。当调用 list.append() 或修改指定下标元素时,列表对象自身的内存地址保持不变,变化的只是其内部维护的槽位引用。
这意味着,如果有多个变量名共同指向同一个可变对象,通过任何一个变量名触发的原地修改,都会直接影响到其他所有引用该对象的变量。
三、常见使用陷阱与排查避坑
正因为可变类型具有“原地更新”与“引用共享”的特性,若编写代码时仍套用不可变类型的直觉思维,极易陷入隐蔽的逻辑缺陷。
陷阱 1:函数默认参数使用可变对象(经典的“幽灵数据”)
这是 Python 开发者最容易踩中的陷阱之一。来看以下示例:
def append_task(task_name, task_list=[]):
    task_list.append(task_name)
    return task_list

print(append_task("整理笔记"))  # 输出: ['整理笔记']
print(append_task("提交代码")) # 输出: ['整理笔记', '提交代码'] —— 意外保留了上次调用的数据!根本原因:Python 中的 def 语句属于可执行代码。当模块首次被加载解析时,函数对象被创建,其默认参数表达式仅在函数定义期被评估一次,并将该默认列表对象保存在函数的 __defaults__ 属性中。随后的多次调用如果未传参,实际都在复用这同一个列表实例。
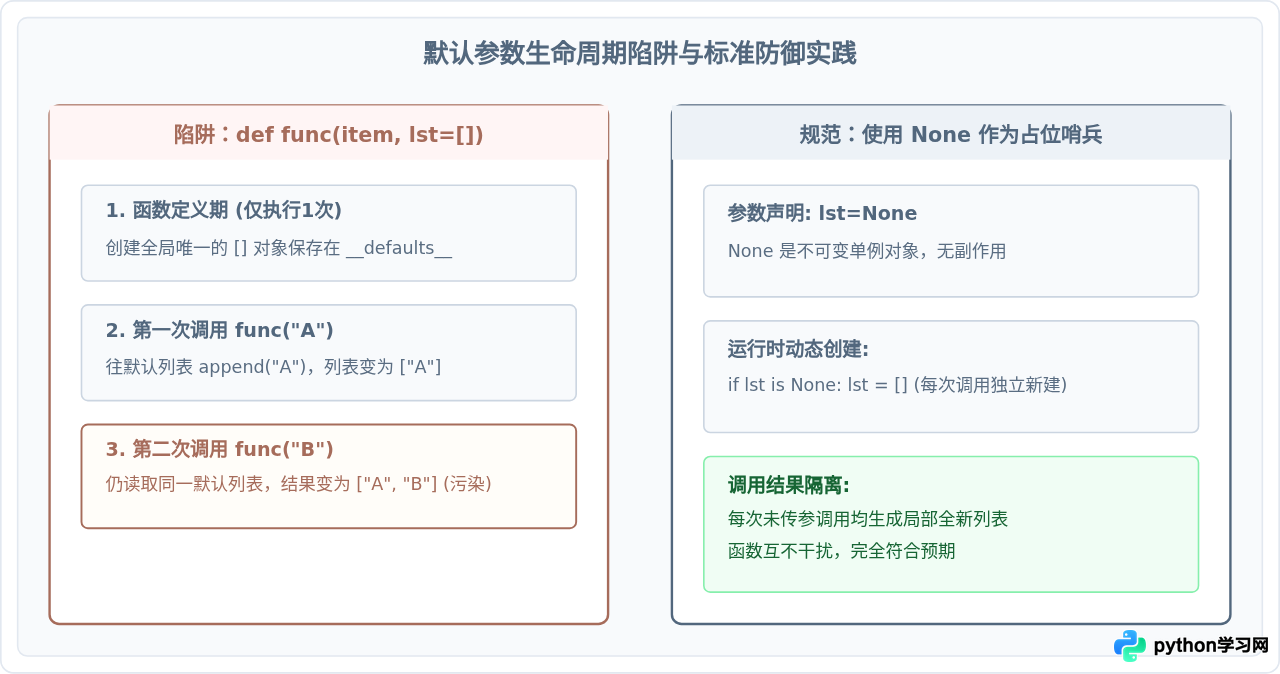
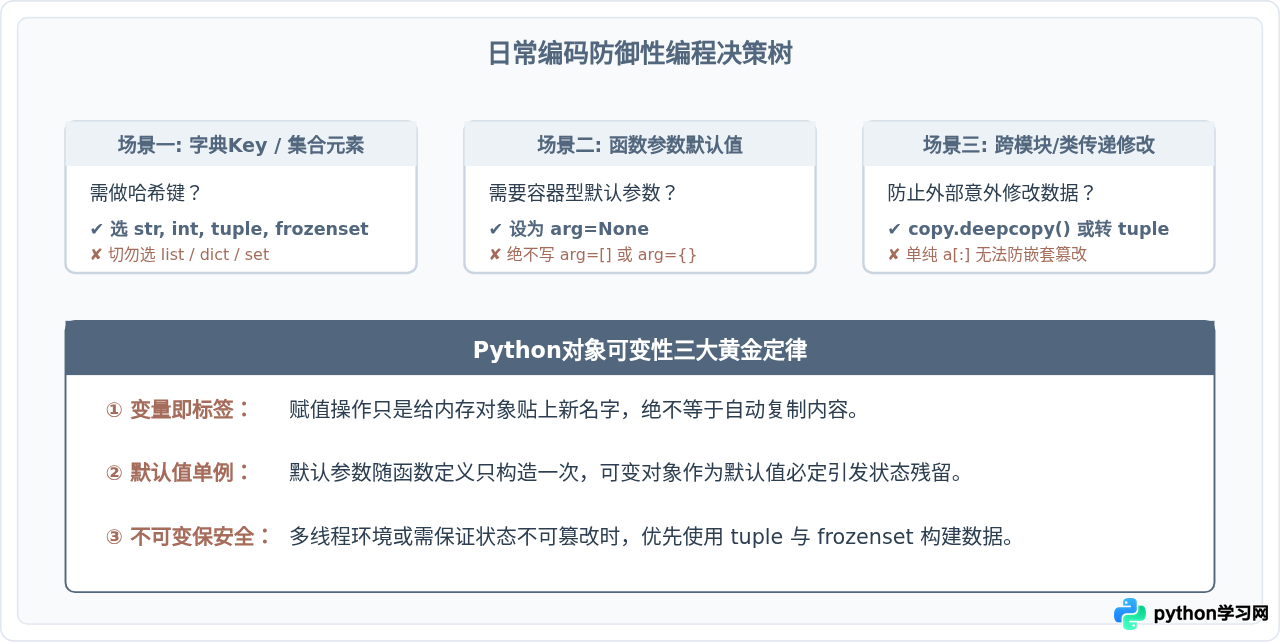
避坑指南:切勿将任何可变对象(列表、字典、集合)直接作为默认参数。标准做法是使用不可变对象 None 作为占位符:
def append_task(task_name, task_list=None):
    if task_list is None:
        task_list = []  # 每次调用时独立在运行时新建
    task_list.append(task_name)
    return task_list
陷阱 2:浅拷贝与嵌套可变对象的级联修改
很多开发者知道简单的直接赋值 b = a 是浅引用,于是使用 copy() 或切片 a[:] 进行拷贝。但注意:切片和 copy.copy() 只是浅拷贝(Shallow Copy)。
浅拷贝只会复制最外层的容器对象,若容器内部还嵌套了其他可变对象(例如二维列表 [[1, 2], [3, 4]]),内部元素仍然共享相同的内存引用:
matrix_a = [[1, 2], [3, 4]]
matrix_b = matrix_a.copy()  # 外层浅拷贝

# 修改第一层的元素替换:互相独立
matrix_b.append([5, 6])
print(len(matrix_a))  # 输出: 2(matrix_a不受影响)

# 修改内层嵌套可变对象:连带篡改!
matrix_b[0].append(99)
print(matrix_a[0]) # 输出: [1, 2, 99](matrix_a 内部也被修改了!)避坑指南:对于存在多层嵌套的可变数据结构(如 JSON 树、配置字典、二维矩阵),必须使用标准库的 copy.deepcopy() 进行深度递归复制,彻底切断所有嵌套层级的引用依赖。
陷阱 3:+= 运算在不同类型上的分裂行为与元组异常诡局
在不可变类型上,a += b 实际上等价于 a = a + b,调用的是 __add__ 魔法方法并返回新对象;而在可变列表上,a += b 会优先调用 __iadd__,其底层实现等同于 a.extend(b),是直接在原内存上原地更新。
这种差异会导致一个极其经典的 Python 考题:“包含列表的元组在执行 += 时会发生什么?”
t = (1, [2, 3])

try:
    t[1] += [4]
except TypeError as e:
    print(f"抛出异常: {e}")

print(t)  # 输出结果令人震惊: (1, [2, 3, 4])
代码抛出了 TypeError: 'tuple' object does not support item assignment,但查看元组内容时,列表却真真切切被加上了 4!
深度机理:从 Python 字节码的角度看,t[1] += [4] 包含两步操作:
- 计算阶段:获取
t[1](即列表),对它执行INPLACE_ADD(即__iadd__)。由于列表是可变的,这一步成功在原地上追加了4。 - 赋值阶段:
+=操作符要求将运算结果重新赋值回左侧容器(STORE_SUBSCR)。此时尝试对元组进行索引赋值t[1] = ...,元组是不可变的,立即抛出TypeError。
最终导致了“操作成功了,但异常依然抛出”的矛盾表象。这也是设计代码时不建议在不可变容器(元组)内部放入可变对象(列表/字典)的关键原因。
四、对比矩阵与避坑决策体系
为了在实际开发中快速判断与选择,下表梳理了核心类型的全维度对比:
| 对比维度 | 不可变类型 (Immutable) | 可变类型 (Mutable) |
|---|---|---|
| 代表类型 | int, float, str, tuple, frozenset, bytes |
list, dict, set, bytearray |
| 哈希性 (Hashable) | 可哈希(包含不可变元素时),有 __hash__ |
不可哈希,__hash__ 为 None |
| 字典键 / 集合元素 | 可以作为 dict 的 key 或 set 的成员 |
严禁使用,否则直接抛出 TypeError |
| 赋值操作 (b = a) | 传递引用;修改其中一个会重绑定,彼此安全 | 传递引用;通过任意变量原地修改将影响全局 |
| 作为函数默认参数 | 安全无害(如 None, 0, "", ()) |
绝对禁忌,会产生跨请求跨调用的累积污染 |
| 内存与性能特点 | 频繁小修改开销大(生成新对象),但支持小整数/驻留机制 | 预分配容量机制,原地增删查改效率极高 |
五、结语
掌握 Python 中可变与不可变类型的差异,是摆脱“知其然不知其所以然”的关键一步。牢记“变量是对象的引用”这一核心模型:面对不可变对象,享受其安全、可哈希带来的确定性;面对可变对象,善用其高效原地修改的优势,同时在函数传参、默认参数和复合容器设计中保持高度的防御性意识,即可从根本上杜绝绝大多数幽灵 Bug。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















