


Python可变对象与不可变对象对变量赋值的影响
全面解析Python中可变对象与不可变对象在变量赋值与操作时的底层机制差异。通过内存引用模型、代码对比、原理图解及典型开发陷阱,帮助读者彻底掌握变量赋值与传递的正确方法。
b = a 之后对 b 进行修改,有时 a 的值完全不受影响,有时 a 却随之被悄然更改。这种现象并非逻辑错误,而是由目标对象的“可变性(Mutability)”与 Python 的“名字绑定引用模型”共同决定的。理解这一机制是写出可靠代码、避免隐蔽副作用的关键。
一、核心模型:变量是“标签”,不是“盒子”
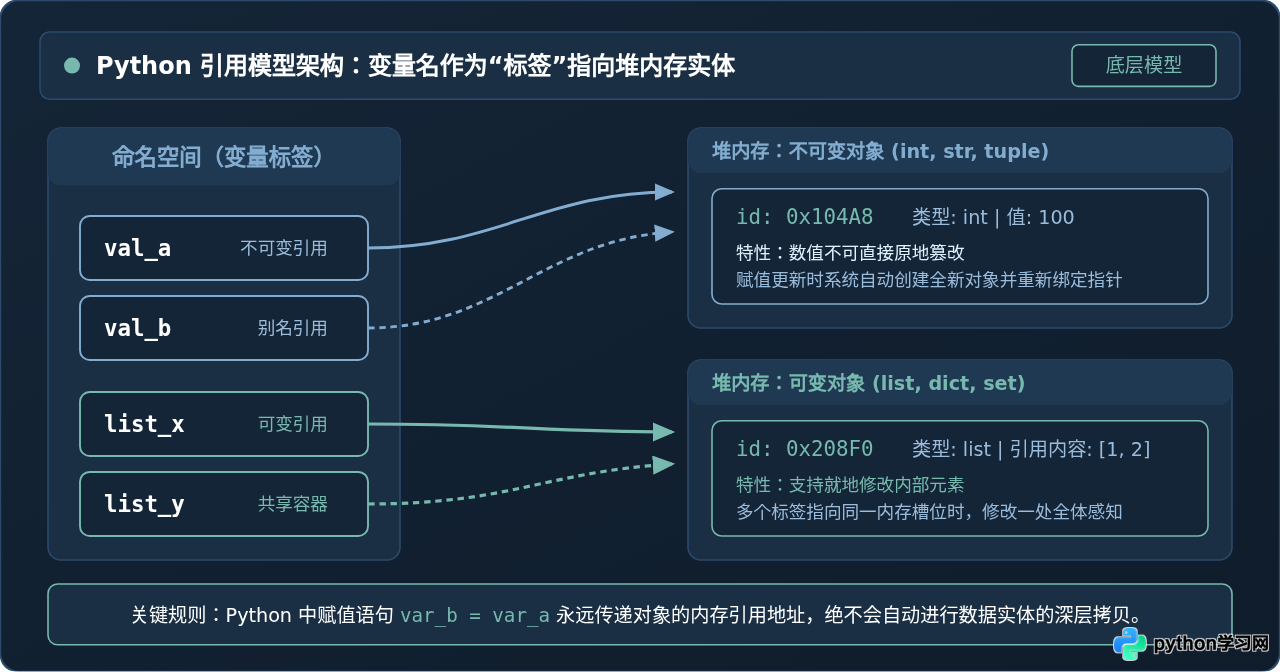
在 C 或 C++ 等静态语言中,变量通常对应一块固定的内存单元,赋值相当于把具体数值直接填入该“盒子”。而在 Python 中,变量的本质只是一个贴在内存对象上的名字标签(Name Tag)或指针引用。
所有数据(整数、字符串、列表、函数等)都在堆内存中以对象形式存在,拥有三个基础属性:
- 唯一标识(Identity):由内置函数
id()获取,反映对象在 CPython 中的内存地址。 - 数据类型(Type):由
type()查看,决定了该对象所支持的操作和内部结构。 - 具体值与可变性(Value & Mutability):决定对象创建后内部状态是否允许就地变动。
根据 Python 规范,对象被严格划分为两类:
- 不可变对象(Immutable):整数(
int)、浮点数(float)、布尔值(bool)、字符串(str)、元组(tuple)、不可变集合(frozenset)。 - 可变对象(Mutable):列表(
list)、字典(dict)、集合(set)、用户自定义类的实例(默认可变)。
执行单等号赋值 b = a 时,Python 只是为右侧对象又贴了一个新的名字标签 b,传递的是对象的物理地址,不会为数据实体创建任何副本。随后对 b 进行操作时,对象本身是否允许原地改变,直接决定了 a 是否会受到波及。
二、不可变对象的赋值与“重新绑定”机制
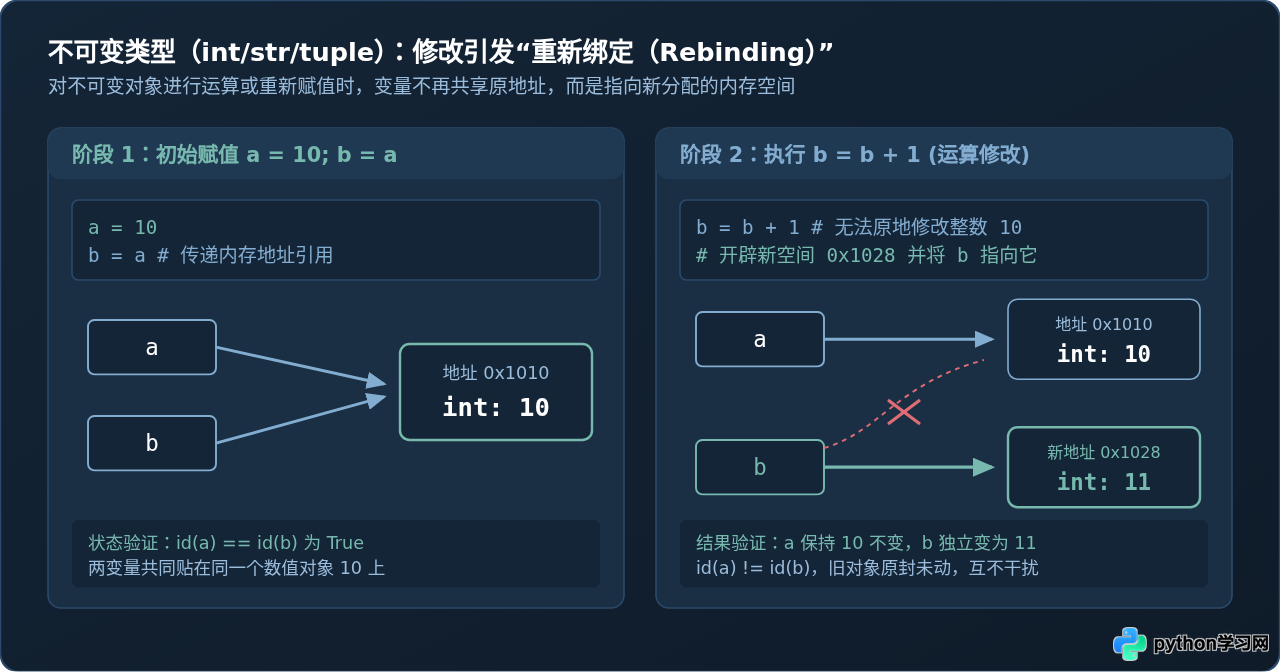
对于不可变对象,其内存中的数值一旦分配便不可篡改。当代码试图对包含该对象的变量做任何“修改”时,解释器必须在内存中开辟新区域创建全新对象,并将变量名重新指向新地址,这个过程称为重新绑定(Rebinding)。
初始状态: id(num_a)=4301594960, id(num_b)=4301594960, 相等=True
运算后 num_a: 100, id=4301594960
运算后 num_b: 101, id=4301594992
在上面的代码中,初始阶段 num_a 和 num_b 具有相同的 id,共享存储 100 的内存单元。然而,当执行 num_b += 1 时,由于整数不可修改,Python 在新内存地址创建了 101,并将标签 num_b 撕下贴到了 101 上。而 num_a 依然稳固地贴在原对象 100 上,两者脱离关联。
三、可变对象的赋值与“就地修改”共享别名
与不可变对象不同,可变对象(如列表、字典)的内部状态支持就地更新(In-place Mutation)。其内存结构是一个固定地址的容器外壳,内部存放指向各个元素的引用指针。
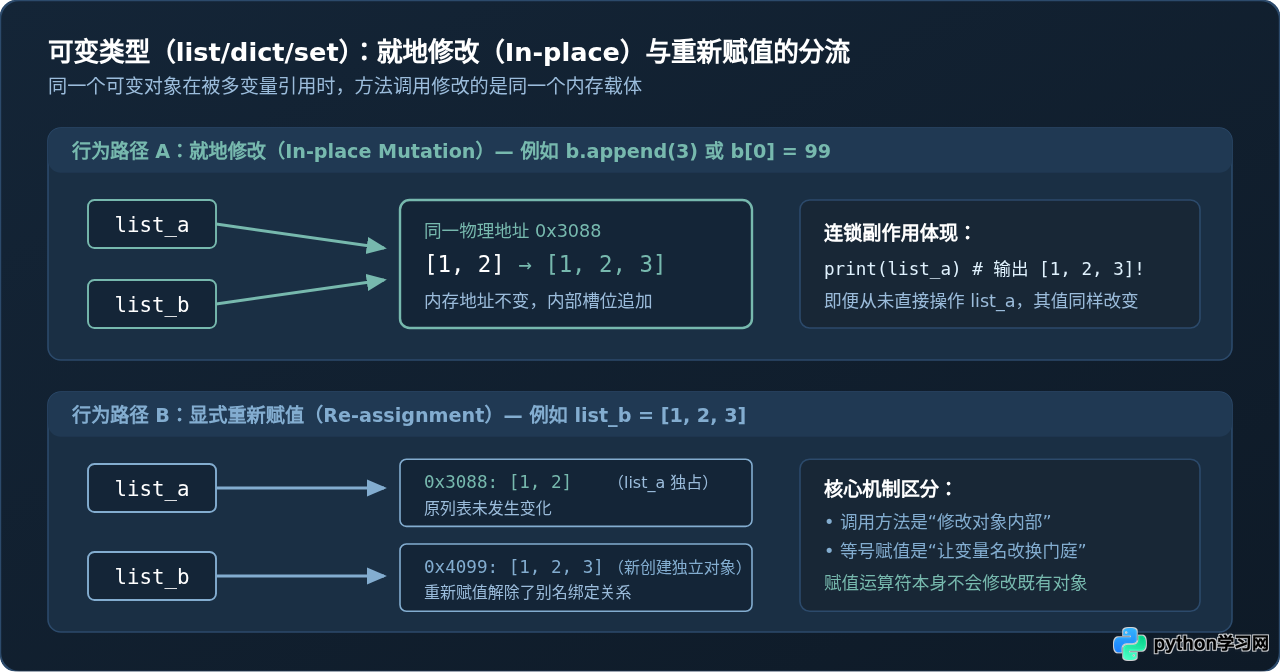
当两个变量通过赋值指向同一个可变对象时,它们互为别名(Alias)。通过任何一个变量调用如 append()、pop()、update() 或下标索引赋值时,都是在直接修改这个公共容器内部的数据。
场景 A - list_a: [10, 20, 30] (地址: 4302685824)
场景 A - list_b: [10, 20, 30] (地址: 4302685824)
场景 B - list_c: [1, 2] (地址: 4302685952)
场景 B - list_d: [1, 2, 99] (地址: 4302686016)
对比两种场景可以发现一个关键规则:
- 方法调用与下标修改(如
list_b.append(...)或list_b[0] = ...)是“内部就地篡改”,地址不变,所有别名同步受影响。 - 单等号直接重新赋值(如
list_d = [1, 2, 99])是“改换指针门庭”,生成全新对象,断开与原对象的共享关系。
int 或 str)上,x += y 等价于 x = x + y(分配新对象);但在列表上,lst += [new_val] 底层调用的是 lst.extend([new_val]),属于就地修改!这意味着 b += [3] 会直接改变共享该列表的 a。
四、典型应用场景与常见隐蔽陷阱
由可变对象共享引用引发的问题,在日常开发中最常出现在函数默认参数与多维数据结构初始化两处。
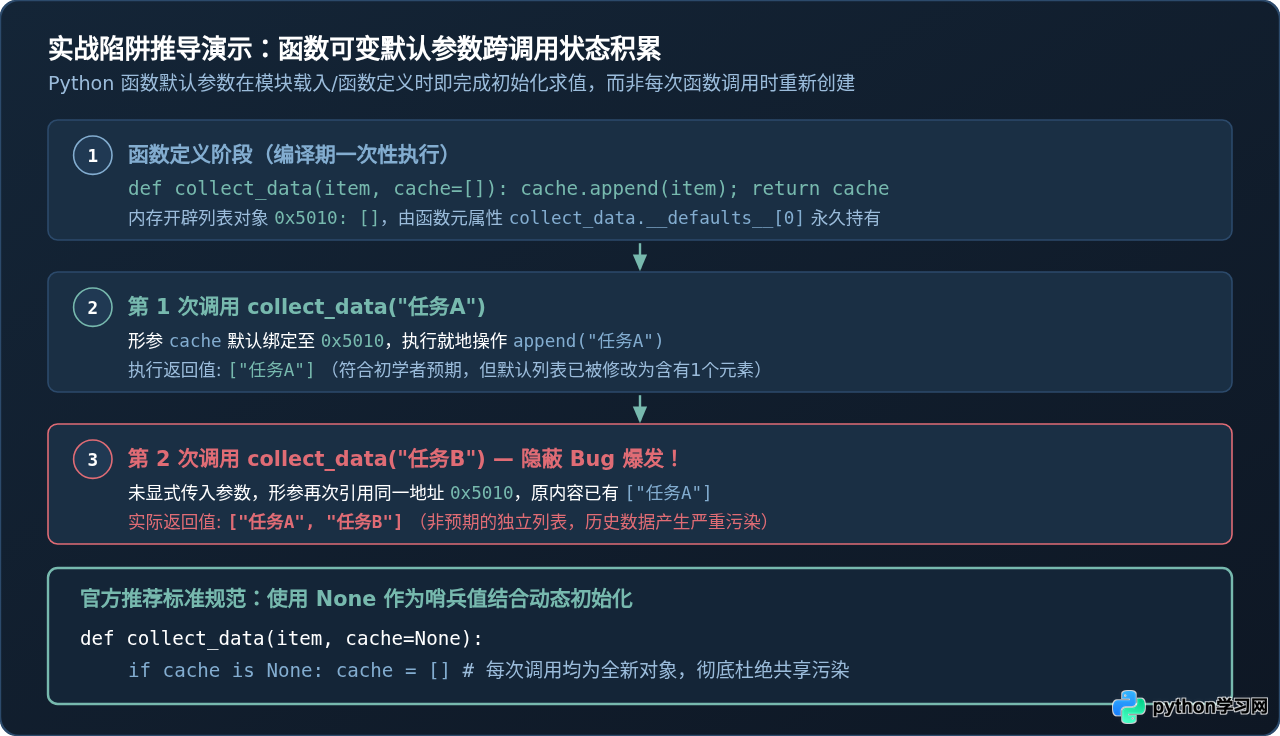
1. 函数默认形参的“跨调用状态残留”陷阱
Python 在函数定义(代码编译载入时)就会对默认形参进行一次性求值并将其保存在函数对象的元数据中。若使用可变对象作为默认值,所有未传参的函数调用将共享这同一个对象。
2. 嵌套列表相乘的“浅层重复引用”陷阱
快速创建二维网格时,初学者常写出 matrix = [[0] * 3] * 3。列表乘法运算符 * 只复制了内层列表的引用指针,外层列表中 3 个元素其实指向同一个内层列表。修改 matrix[0][0] = 1 会导致每一行的第 0 列全部变为 1。
正确做法是采用列表推导式:matrix = [[0] * 3 for _ in range(3)],每次循环都独立执行一次内层列表的分配。
五、安全传递与数据隔离:切片、浅拷贝与深拷贝
当确实需要隔离可变对象、防止业务逻辑相互干扰时,必须使用明确的复制手段替代简单赋值。复制手段分为两个层级:
| 操作方式 | 典型语法 | 复制深度 | 底层行为与适用场景 |
|---|---|---|---|
| 直接赋值(=) | b = a |
无复制 | 仅创建新标签,纯粹别名;任何就地修改完全互通。 |
| 浅拷贝(Shallow Copy) | b = a.copy()b = a[:]copy.copy(a) |
仅顶层 | 开辟新的顶层容器,但若容器内包含子列表/字典,子元素依然是共享引用。适用于单层无嵌套数据。 |
| 深拷贝(Deep Copy) | copy.deepcopy(a) |
递归完整复制 | 递归遍历对象图,为所有嵌套的子对象均开辟全新独立空间。适用于树状配置、复杂多层数据。 |
原数据: [1, [10, 20, 30]]
浅拷贝: [1, [10, 20, 30]]
深拷贝: [1, [10, 20]]
六、工程实践决策指南与总结
为了帮助开发者在实际编码中迅速选择正确的赋值与传参方式,下图总结了从需求判断到代码实现的完整决策路径:
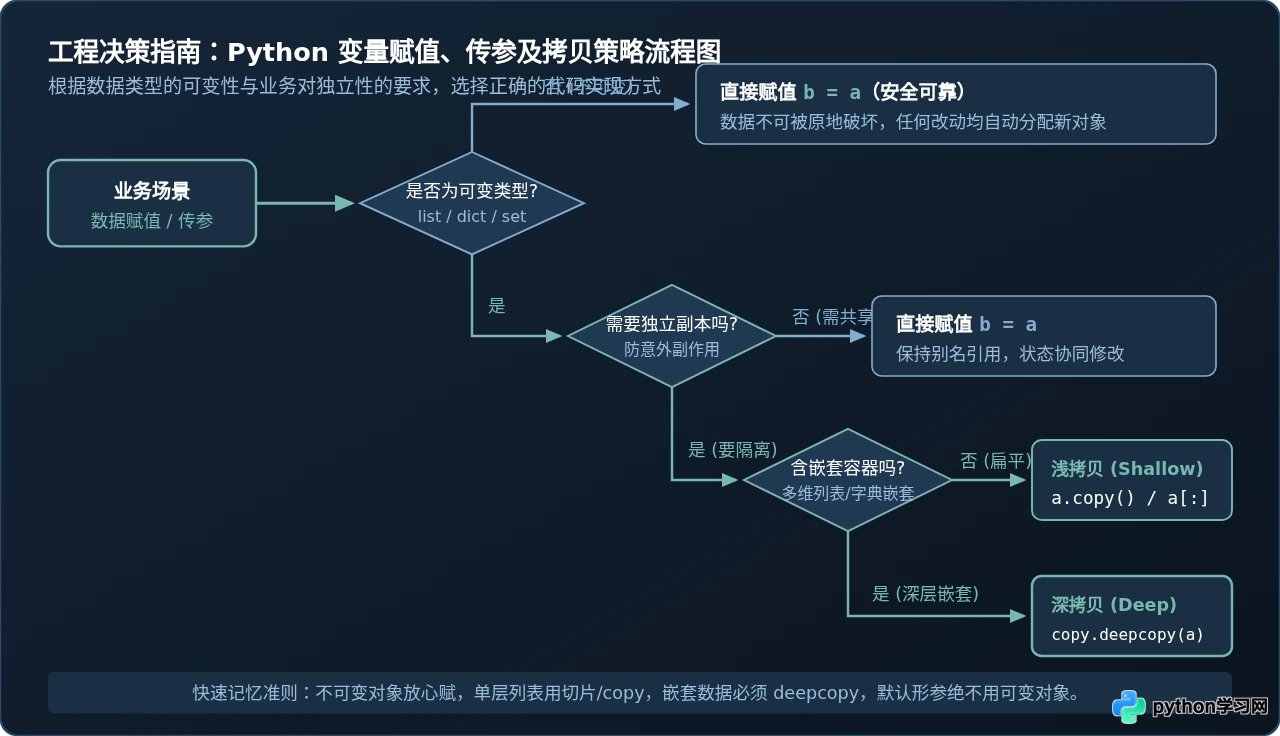
总结本文的核心结论与开发规约:
- 本质认识:Python 变量不是内存容器,而是名字指针。赋值操作永远传递引用,不触发数据深层克隆。
- 不可变对象放心赋值:数值、字符串、元组天生具备值语义安全,任何改动都会触发重新绑定,绝不会引发全局副作用。
- 可变对象警惕别名扩散:列表、字典作为函数实参传递时,若在函数内调用其变异方法(如
append、update),调用方的数据将被同步篡改。若函数只需只读或纯计算,应先制作副本。 - 默认参数坚守不可变原则:绝不在函数形参默认值中声明
[]或{},一律使用None配合内部惰性初始化。 - 嵌套数据首选 deepcopy:单层数据使用切片
[:]或.copy()性能最佳;凡涉及复杂多层字典或列表,务必使用copy.deepcopy()确保完全隔离。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















