


Python结合jieba分词制作中文词云图的完整步骤
详细讲解使用Python结合jieba中文分词与WordCloud库生成中文词云图的完整步骤,涵盖环境搭建、中文切词、停用词过滤、中文字体配置与图形遮罩实战。
在Python文本分析与可视化中,词云图(Word Cloud)能够以直观的形式呈现文本中高频词汇的权重分布。许多初学者在直接套用英文词云代码处理中文文本时,往往会遇到两个典型障碍:一是生成的词云图中只包含单字或整句长句,无法准确切分有意义的中文词语;二是渲染出来的文字全部显示为方块空白(乱码)。制作中文词云图的核心链路在于:先利用jieba分词将没有天然空格分隔的中文句子切分成离散词项,经过停用词过滤剔除无实际语义的虚词后,再利用空格串联并交由WordCloud库渲染,同时显式挂载有效的中文字体文件。本文将以清晰直观的逻辑,从环境依赖准备、分词清洗到画布渲染与图形遮罩定制,逐步拆解完整的实现流程。
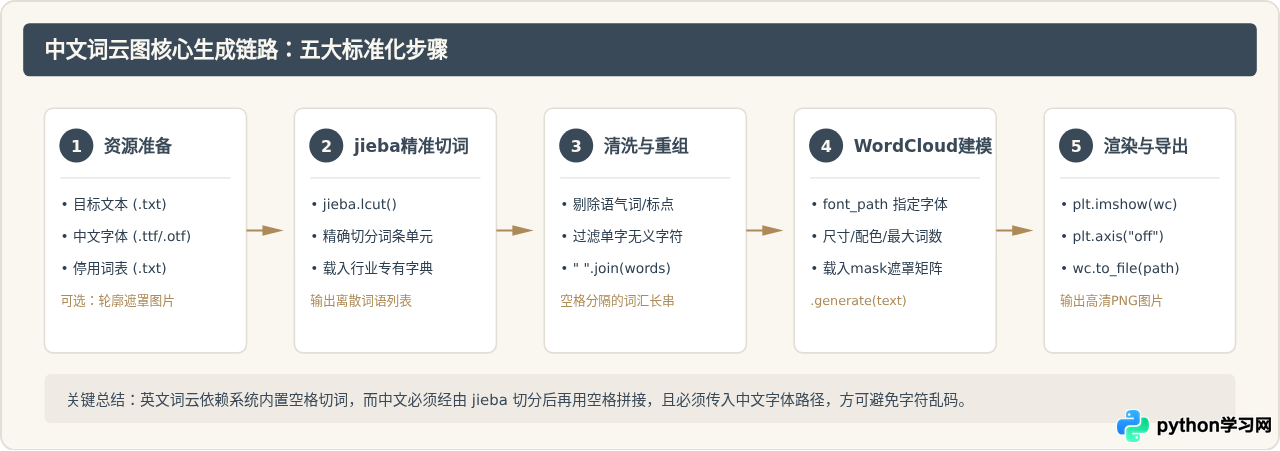
第一步:环境依赖安装与基础文件准备
在开始编写脚本之前,需要在Python运行环境中安装所需的依赖包。主要涉及分词工具 jieba、词云生成工具 wordcloud、图形展示工具 matplotlib,以及用于图像矩阵处理的 pillow 与 numpy。
打开终端或命令行界面,执行以下安装命令:
pip install jieba wordcloud matplotlib pillow numpy除了Python库,制作中文词云还需要准备好以下三项基础素材:
- 文本源文件(如 article.txt): 存储待分析的中文纯文本内容,建议保存为 UTF-8 编码,防止读取时发生编码冲突。
- 中文字体文件(如 simhei.ttf、msyh.ttc 或 pingfang.ttf):
wordcloud内部默认使用 DroidSans 英文无衬线字体,无法绘制中文字形。Windows 用户可直接取用C:\Windows\Fonts\msyh.ttc(微软雅黑)或simhei.ttf(黑体);macOS 用户可使用/System/Library/Fonts/PingFang.ttc;Linux 用户可安装fonts-wqy-microhei。 - 停用词表文件(stopwords.txt): 中文中的“的、了、在、是、和、我们”等高频功能词在文本中出现频率极高,但并不代表实际核心概念。准备一份文本文件,每行一个词,用于在统计前滤除噪音。
第二步:使用jieba对中文文本进行切分与清洗
西方语言单词之间使用天然的空格隔开,wordcloud 库的原生机制就是根据字符串中的空格提取词汇并统计频率。由于中文汉字紧密相连,若将一整段中文直接交给 WordCloud,它会将整句话当作一个长词来处理,从而失去词频可视化的意义。因此,我们需要通过 jieba 充当中文字符与词云引擎之间的桥梁。
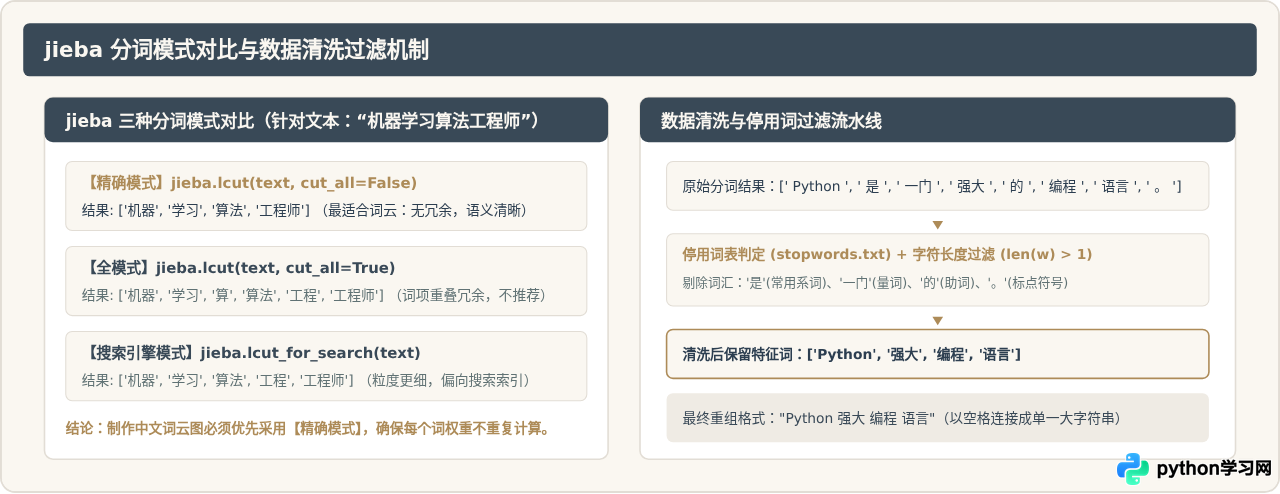
在实际代码中,推荐使用 jieba.lcut() 方法直接获取列表对象。清洗流程包含两个层次:一是过滤掉单字(中文单字往往缺乏独立语意,如“在”、“去”、“做”),二是比对停用词集合。下面是分词与清洗的封装函数:
import jieba

def clean_and_cut_text(text_path, stopword_path=None):
    # 1. 读取原始文本内容
    with open(text_path, "r", encoding="utf-8") as f:
        content = f.read()

    # 2. 读取停用词表
    stopwords = set()
    if stopword_path:
        with open(stopword_path, "r", encoding="utf-8") as f:
            for line in f:
                stopwords.add(line.strip())

    # 3. 执行精确分词
    raw_words = jieba.lcut(content)

    # 4. 过滤空字符、单字及停用词
    cleaned_words = [
        word for word in raw_words
        if len(word.strip()) > 1 and word.strip() not in stopwords
    ]

    # 5. 用空格拼接成 WordCloud 所需的长字符串
    return " ".join(cleaned_words)
jieba.load_userdict("custom_dict.txt") 载入自定义行业词典,保证专业术语的完整性。
第三步:WordCloud核心参数配置与中文字体映射
完成分词并生成带空格的字符串后,下一步是初始化 WordCloud 对象并设置各项渲染参数。了解每个参数的实际作用有助于精准调控词云的视觉品质。
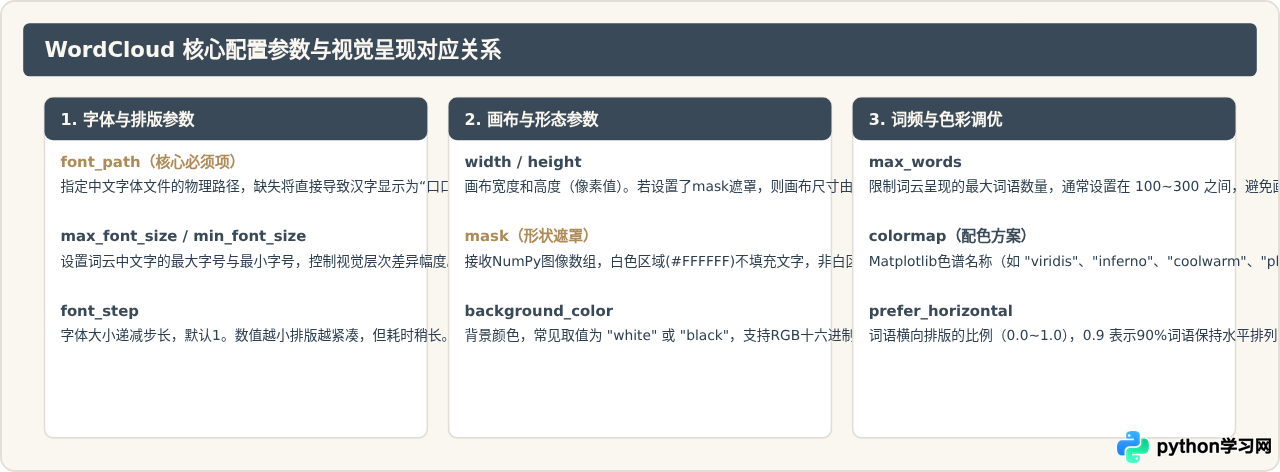
第四步:完整实战代码——基础词云与遮罩词云
下面给出两个完整且可直接执行的代码示例。第一个示例展示标准矩形词云的快速生成与保存;第二个示例引入自定义遮罩图片(Mask),让词云文字紧密贴合指定的图标轮廓展开排版。
4.1 标准基础词云图完整代码
import os
import jieba
from wordcloud import WordCloud
import matplotlib.pyplot as plt

# 1. 模拟文本内容(实际项目中可由 open('article.txt') 读取)
text_data = """
Python作为一门通用编程语言,在数据分析、机器学习、人工智能、网络爬虫和自动化运维领域
拥有极其广泛的应用。jieba分词是中文自然语言处理中轻量且高效的分词组件。利用WordCloud库,
我们可以将文本中的高频核心关键词转换为富有视觉表现力的词云图。掌握分词清洗、停用词过滤、
中文字体配置与色彩映射,是数据可视化实践中的基础能力。
"""

# 2. 精确分词与停用词过滤
stop_words = {"作为", "一门", "在", "和", "拥有", "可以", "将", "中的", "是"}
word_list = jieba.lcut(text_data)
filtered_words = [w for w in word_list if len(w.strip()) > 1 and w not in stop_words]
cut_result = " ".join(filtered_words)

# 3. 指定中文字体路径(请根据当前操作系统修改实际有效路径)
# Windows: r"C:\Windows\Fonts\msyh.ttc"
# macOS: "/System/Library/Fonts/PingFang.ttc"
# Linux: "/usr/share/fonts/truetype/wqy/wqy-microhei.ttc"
font_path = "/System/Library/Fonts/PingFang.ttc"
if not os.path.exists(font_path):
    font_path = r"C:\Windows\Fonts\msyh.ttc"

# 4. 创建 WordCloud 对象并生成词云
wc = WordCloud(
    font_path=font_path,
    width=1000,
    height=600,
    background_color="white",
    max_words=150,
    max_font_size=120,
    min_font_size=15,
    colormap="viridis",
    random_state=42
)
wc.generate(cut_result)

# 5. 导出保存并预览
wc.to_file("chinese_wordcloud.png")
print("词云图已成功导出为 chinese_wordcloud.png")

# 在交互环境中可视化显示
plt.figure(figsize=(10, 6))
plt.imshow(wc, interpolation="bilinear")
plt.axis("off")  # 关闭坐标轴刻度
plt.tight_layout(pad=0)
plt.show()
4.2 自定义图形轮廓(Mask)的高阶词云代码
在企业汇报或主题海报制作中,我们通常希望词云呈现为特定形状(例如中国地图、心形、星形或公司Logo)。实现这一效果的核心在于利用 Pillow 打开一张纯白底色的轮廓图,并将其转为 NumPy 二维矩阵传递给 mask 参数。
import numpy as np
from PIL import Image
from wordcloud import WordCloud, ImageColorGenerator
import matplotlib.pyplot as plt

# 1. 加载遮罩图片(注意:遮罩图片背景必须是纯白色 #FFFFFF / 255)
mask_image_path = "shape_mask.png"
mask_array = np.array(Image.open(mask_image_path))

# 2. 实例化词云并绑定遮罩
wc_masked = WordCloud(
    font_path=font_path,
    background_color="white",
    mask=mask_array,
    max_words=200,
    contour_width=1.5,         # 绘制遮罩边缘轮廓线宽度
    contour_color="#AD8B58",    # 轮廓线颜色
    random_state=100
)

# 3. 根据切分好的文本生成词云
wc_masked.generate(cut_result)

# 4. (可选)提取原图颜色作为文字颜色
# image_colors = ImageColorGenerator(mask_array)
# wc_masked.recolor(color_func=image_colors)

# 5. 导出高清图像
wc_masked.to_file("masked_wordcloud.png")
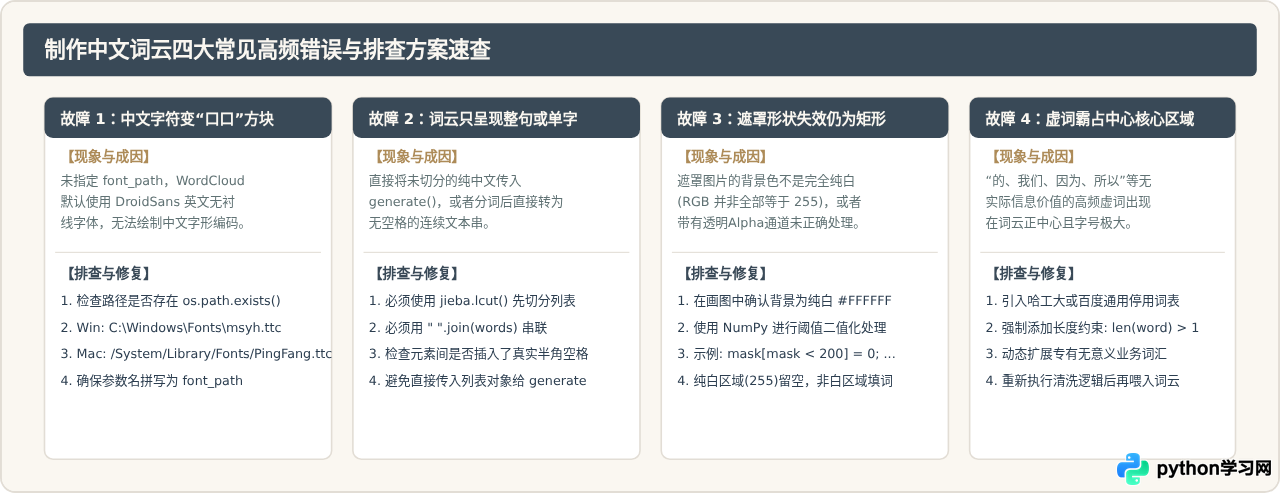
第五步:常见问题排查与避坑指南
在结合jieba与WordCloud的实际操作中,开发者最容易在字体路径、停用词清洗以及遮罩白底处理上出现偏差。以下整理了四大最高频的问题表现、深层原因及解决对策。
总结与延伸技巧
综上所述,制作中文词云图的过程并不复杂,其底层核心在于“用 jieba 解决中文分词、用空格连接契合 WordCloud 机制、用中文字体路径规避方块乱码”。掌握这三个关键节点后,即可稳定输出符合预期的高质量词云图。
在熟练基础绘制后,还可以进行如下几项进阶拓展:
- 词频字典精准输入: 如果需要根据特定算法(如 TF-IDF 或 TextRank)赋予词语不同权重,可先通过
jieba.analyse.extract_tags()计算出词频或权重字典{"词语": 权重值},然后调用WordCloud.generate_from_frequencies(freq_dict)进行精准加权渲染。 - 色彩自适应提取: 利用
ImageColorGenerator(mask_array)可以让词云中的文字颜色自动吸取背景图对应坐标的颜色,使整幅词云在保持图形轮廓的同时具备原图的渐变色彩。 - 批量化自动化处理: 将清洗与绘制封装为脚本模块,结合定时爬虫或日常分析流程,即可自动为新闻聚合、舆情监控、用户评论等文本流生成直观的周期性可视化汇报图表。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















