


Python解析URL提取域名、路径和查询参数
详细讲解如何使用 Python 标准库 urllib.parse 高效、严谨地解析 URL,完整提取网络域名、主机名、路由路径及查询参数,包含 urlsplit、parse_qs 与 parse_qsl 的核心机制、实战代码与避坑指南。
urllib.parse 提供了完整、免安装的原生解决方案,利用 urlsplit 分离基础组件,配合 parse_qs 或 parse_qsl 结构化解析键值参数,即可在保证性能的同时严谨处理各种复杂与边缘 URL。
一、URL 的标准结构与核心组件
根据 RFC 3986 规范,一个合法的统一资源定位符(URL)通常由协议(Scheme)、授权与网络位置(Netloc)、路径(Path)、查询字符串(Query)以及锚点片段(Fragment)构成。理解这些组件在规范中的边界,是正确编写提取逻辑的前提。
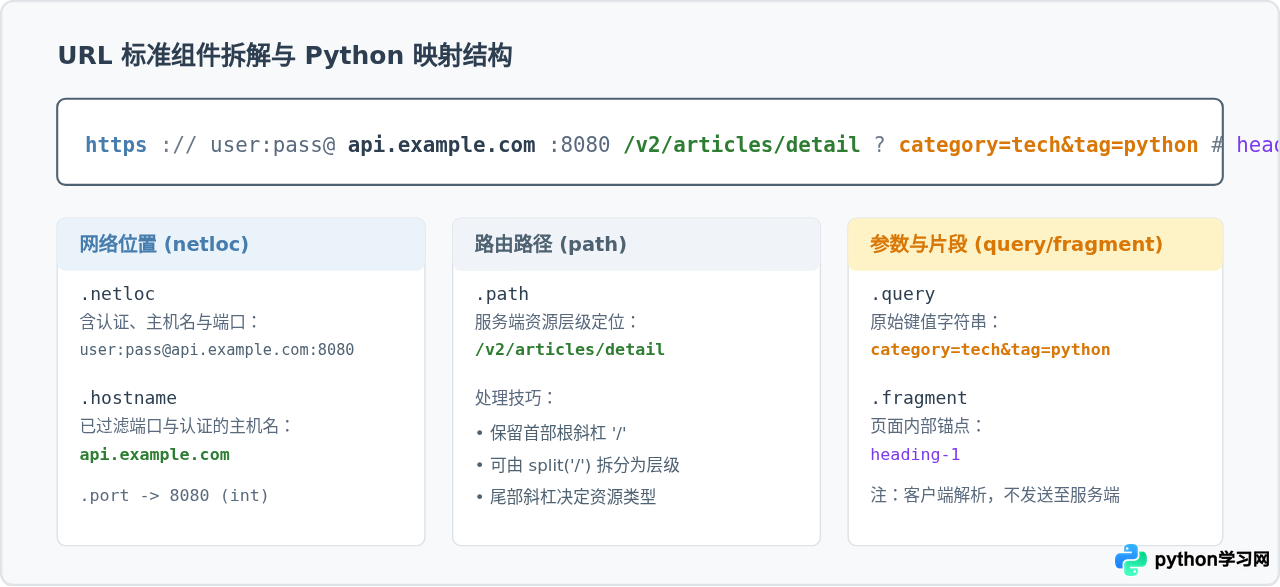
在 Python 标准库中,解析 URL 主要依靠 urllib.parse 模块。在实际开发中,应首选 urlsplit 而非历史较早的 urlparse。这是因为 urlparse 会遵循过时的 RFC 2396 规范尝试从路径末尾分离参数段(;params),这在当今 RESTful 和主流现代 Web 开发中已经不再适用,反而容易误伤正常的文件路径。urlsplit 则严格遵循 RFC 3986,将 URL 直接划分为 5 个核心部分,性能也略高。
二、提取域名与网络主机名
在获取 URL 的网络位置时,很多初学者直接取 res.netloc,但这在生产环境中容易引发故障。因为 netloc 包含了认证信息(用户名和密码)以及端口号。如果目标仅仅是获取服务器的主机名(域名或 IP 地址),应该直接使用属性 res.hostname。
from urllib.parse import urlsplit

url = "https://dev_admin:secret123@api.internal.example.com:8443/gateway/service?token=xyz"
res = urlsplit(url)

# 1. 获取完整的网络位置(包含认证与端口)
print(f"完整 netloc: {res.netloc}")
# 输出: dev_admin:secret123@api.internal.example.com:8443

# 2. 获取纯净的主机域名(自动转为小写并剔除端口与认证)
print(f"纯净域名: {res.hostname}")
# 输出: api.internal.example.com

# 3. 提取端口号与身份认证信息(若未显式指定端口,port 为 None)
print(f"端口号: {res.port}")        # 输出: 8443 (int)
print(f"用户名: {res.username}")    # 输出: dev_admin
print(f"密码: {res.password}")        # 输出: secret123
res.hostname 提取的是完整主机名(FQDN),例如 api.news.sina.com.cn。如果业务场景需要区分“二级子域名”(如 api.news)与“根域名 / 顶级主域”(如 sina.com.cn),标准库本身并不内嵌公共后缀列表(Public Suffix List),此时应使用第三方库 tldextract。对于绝大多数主机识别、同源校验及白名单过滤,标准库的 res.hostname 已经足够。
三、提取与规范化路径
路径部分决定了服务端路由匹配或文件系统资源定位。通过 res.path 可以直接获取,但需要注意绝对路径、相对路径和多余斜杠的规范化。
import posixpath
from urllib.parse import urlsplit

url = "https://example.com/assets/css/../js/./main.bundle.js"
res = urlsplit(url)

raw_path = res.path
print(f"原始路径: {raw_path}")
# 输出: https://www.ipython.cn/assets/css/../js/./main.bundle.js

# 利用 posixpath.normpath 清理相对路径 '..' 和 '.'
clean_path = posixpath.normpath(raw_path)
print(f"规范化路径: {clean_path}")
# 输出: https://www.ipython.cn/assets/js/main.bundle.js

# 路径拆解为目录层级列表
segments = [seg for seg in clean_path.split('/') if seg]
print(f"路径段: {segments}")
# 输出: ['assets', 'js', 'main.bundle.js']
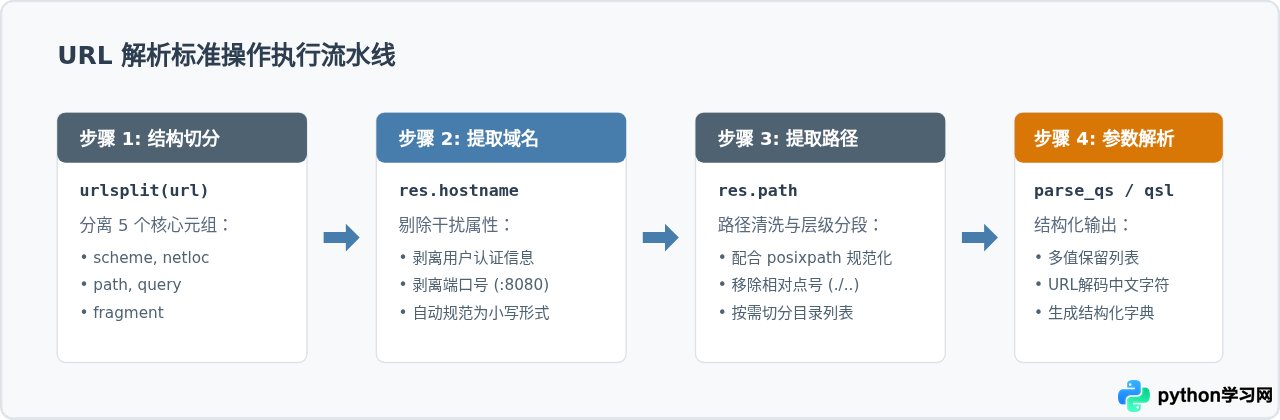
四、完整操作流与解析链路
在实际编写工具函数时,提取流程通常是从原始字符串输入开始,先进行协议拆分,再并行派发给域名提取、路径清洗和参数解析。
五、解析查询参数:parse_qs 与 parse_qsl
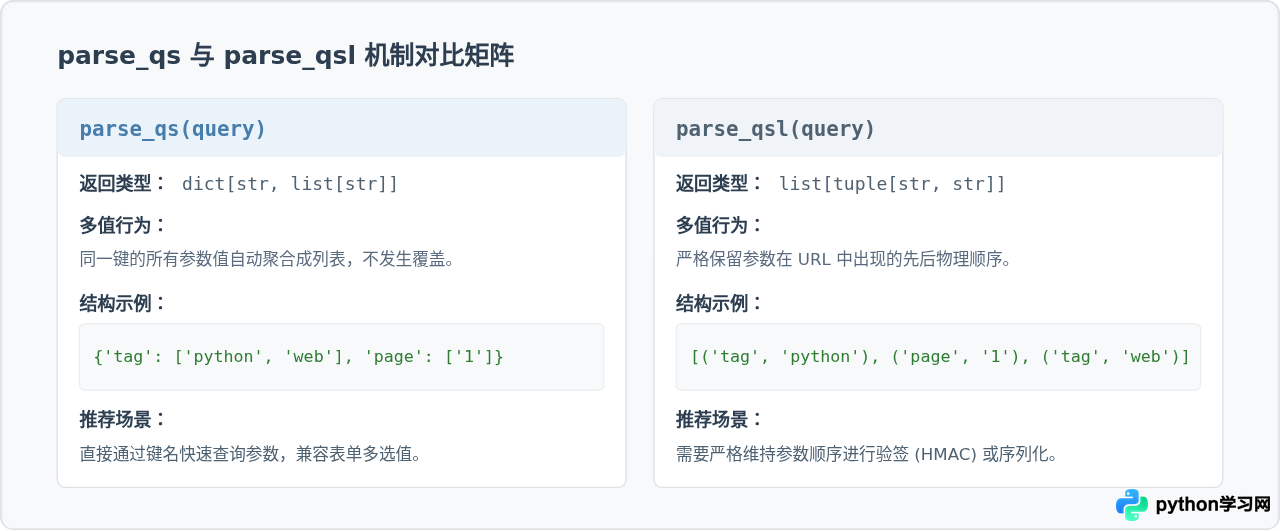
查询参数位于 URL 问号 ? 之后、锚点 # 之前。urllib.parse 提供了两个专门用于将查询字符串转换为 Python 对象的函数:parse_qs 与 parse_qsl。两者的核心差异在于返回的数据结构及对参数顺序的处理方式。
1. parse_qs 详细示例
parse_qs 会自动对键和值执行 URL 解码(URL Decode)。每个键对应的值总是一个列表,即便该键在 URL 中只出现了一次。
from urllib.parse import urlsplit, parse_qs

url = "https://example.com/search?keyword=%E7%88%AC%E8%99%AB&tag=python&tag=backend&sort=desc"
query_str = urlsplit(url).query

params = parse_qs(query_str)
print(params)
# 输出:
# {
#   'keyword': ['爬虫'],
#   'tag': ['python', 'backend'],
#   'sort': ['desc']
# }

# 安全提取单个值(避免因取第 0 项而抛出 IndexError)
keyword = params.get('keyword', [''])[0]
print(f"提取关键词: {keyword}")  # 输出: 提取关键词: 爬虫
2. parse_qsl 与扁平字典转换
在很多只需要单值参数且不关心重复键的业务逻辑中,开发者常用 dict(parse_qsl(query_str))。但必须警惕:如果有同名参数,后面的值会无声覆盖前面的值。
from urllib.parse import urlsplit, parse_qsl

url = "https://example.com/items?filter=active&filter=archived"
query_str = urlsplit(url).query

pairs = parse_qsl(query_str)
print(f"元组列表: {pairs}")
# 输出: [('filter', 'active'), ('filter', 'archived')]

flat_dict = dict(pairs)
print(f"直接 dict 转换: {flat_dict}")
# 输出: {'filter': 'archived'}  <-- 注意: 'active' 已被覆盖
六、常见边界情况与生产避坑
1. 缺少协议头的相对网络地址
在 HTML 页面中,经常会遇到协议相对 URL(如 //cdn.example.com/lib.js)或者没有协议前缀的裸域名字符串(如 www.example.com/index.html)。
- 对于
//cdn.example.com/lib.js,urlsplit能正确识别双斜杠,并将cdn.example.com归入netloc。 - 对于
www.example.com/index.html,由于没有//前缀,RFC 规范将其整体视作相对路径(Path),此时res.netloc为空,res.path为"www.example.com/index.html"。
from urllib.parse import urlsplit

def robust_url_split(url: str):
    # 如果缺少 scheme 和 '//',补齐 '//' 确保域名不被误判为路径
    if not url.startswith(('http://', 'https://', '//')):
        url = '//' + url
    return urlsplit(url)

res = robust_url_split("my-bucket.s3.amazonaws.com/files/document.pdf")
print(f"域名: {res.hostname}, 路径: {res.path}")
# 输出: 域名: my-bucket.s3.amazonaws.com, 路径: /files/document.pdf
2. 空值参数与布尔标志位
URL 中常出现类似 ?debug&version=2&empty_val= 的参数。parse_qs 默认参数 keep_blank_values=False 会直接丢弃空值参数。如果需要保留空值或者区分标志位,必须显式设置 keep_blank_values=True。
from urllib.parse import parse_qs

qs = "debug&version=2&empty_val="

# 默认情况: 丢失 empty_val 和 debug 的空值
print(parse_qs(qs))
# 输出: {'version': ['2']}

# 保留空字符串: 适合识别开关标志位与空参数
print(parse_qs(qs, keep_blank_values=True))
# 输出: {'debug': [''], 'version': ['2'], 'empty_val': ['']}
七、选型与执行决策总结
在实际工程开发中,应依据具体的业务目标(只读匹配、路由派发、API 鉴权计算)选择合适的 API 组合。
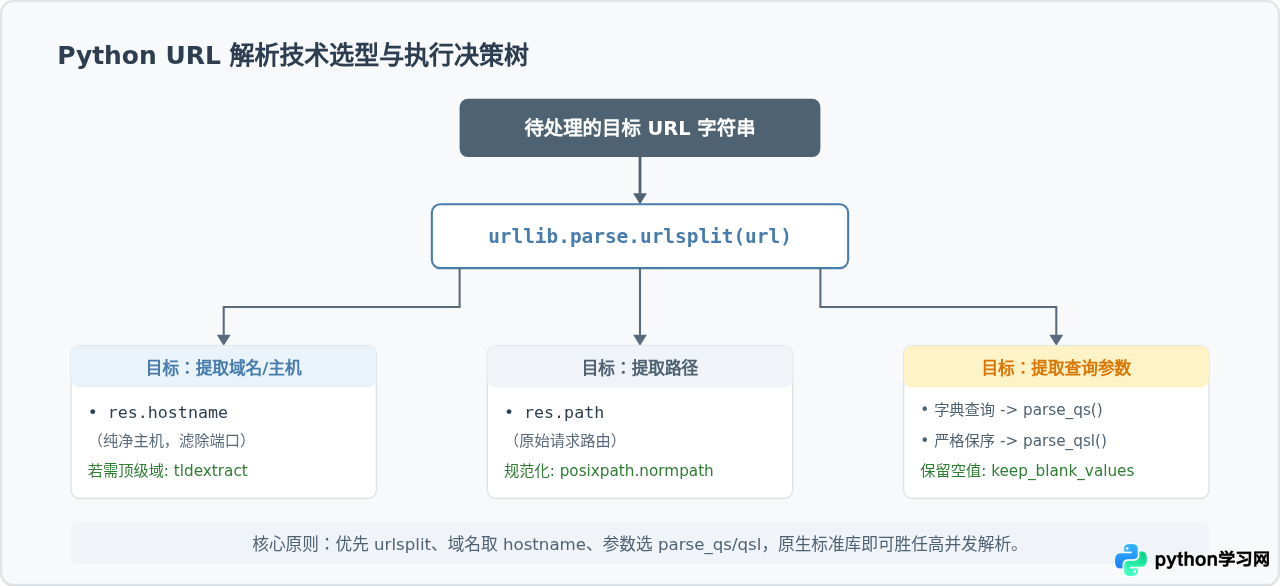
核心实践总结清单
- 使用
urlsplit替代urlparse:避免遗留标准中对;params的多余拆分,完全契合当代 Web 规范。 - 使用
.hostname提取纯净域名:自动将字母转换为小写,且不会把端口号(如:8080)或认证凭据混入域名变量中。 - 按需选用
parse_qs与parse_qsl:常规键值查询使用parse_qs(值为列表);涉及到请求重放、HMAC 验签或参数排序时,必须使用parse_qsl。 - 警惕无协议前缀 URL:面对裸域名或相对路径,先检查是否缺少
//前缀并适当规整,防止主机名被误当做相对路径解析。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















