


Python使用urllib.parse对URL进行编码和解码

在网络请求与 Web 开发中,URL(统一资源定位符)经常需要携带中文字符、空格或特殊标点符号。根据互联网标准 RFC 3986 规定,URL 只能包含特定的 ASCII 字符集;任何非 ASCII 字符(如中文汉字)或特定保留字符,都必须经过百分号编码(Percent-Encoding)转换为合法的传输格式。在 Python 3 中,标准库内置的 urllib.parse 模块提供了整套完备的 URL 解析、参数序列化与编解码工具。本文将具体阐明其工作机制、常用函数的差异、具体代码实现以及常见排查事项。
一、URL 编码机制与组件结构剖析
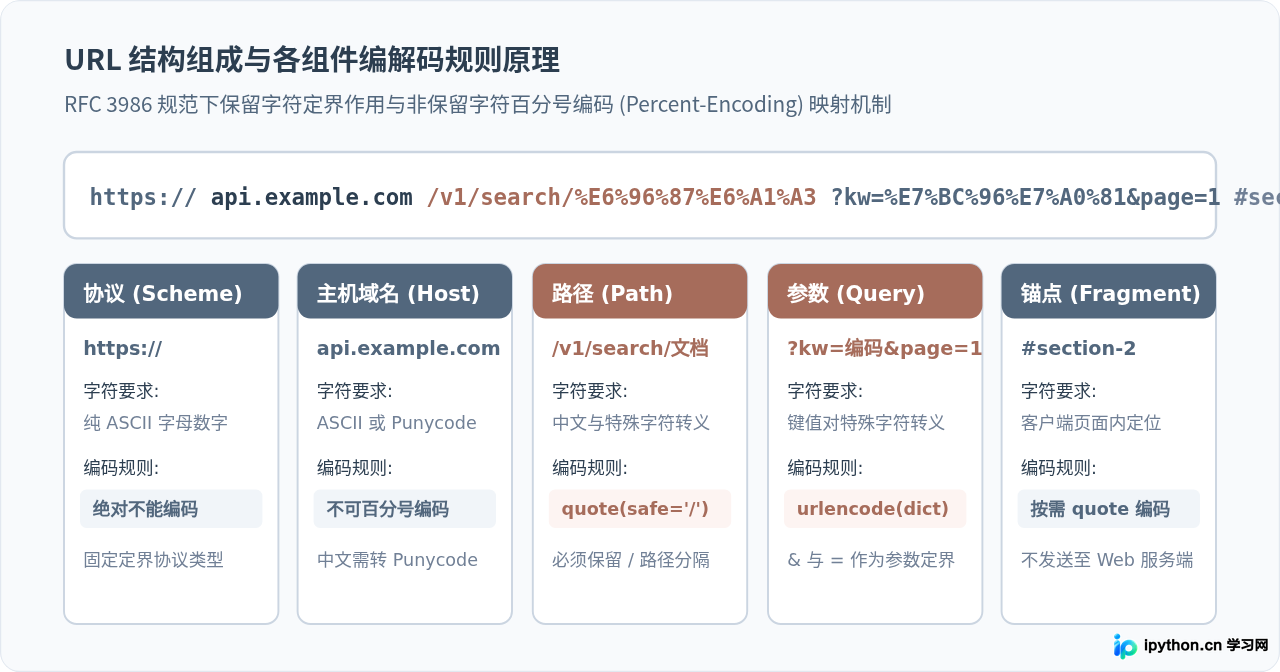
理解 URL 编解码的第一步,是明确哪些字符需要编码,以及哪些字符在特定结构中承担定界职责。URL 字符可划分为三类:
- 非保留字符(Unreserved Characters):包括大小写英文字母(
a-z,A-Z)、数字(0-9)以及连字符(-)、下划线(_)、点(.)、波浪号(~)。这些字符在任何情况下都不需要编码。 - 保留字符(Reserved Characters):包括
:、/、?、#、[、]、@、!、$、&、'、(、)、*、+、,、;、=。它们充当 URL 内部各组件(如协议、主机、路径、查询参数、锚点)的分隔符。当保留字符出现在参数数据中而非充当分隔符时,必须进行转义编码。 - 不安全字符与非 ASCII 字符:包括中文等宽字符、空格、控制字符以及双引号、尖括号等。中文字符在 UTF-8 编码下每个汉字通常占 3 个字节,每个字节用其十六进制形式前缀百分号表示(例如“编”的 UTF-8 字节为
\xe7\xbc\x96,编码为%E7%BC%96)。
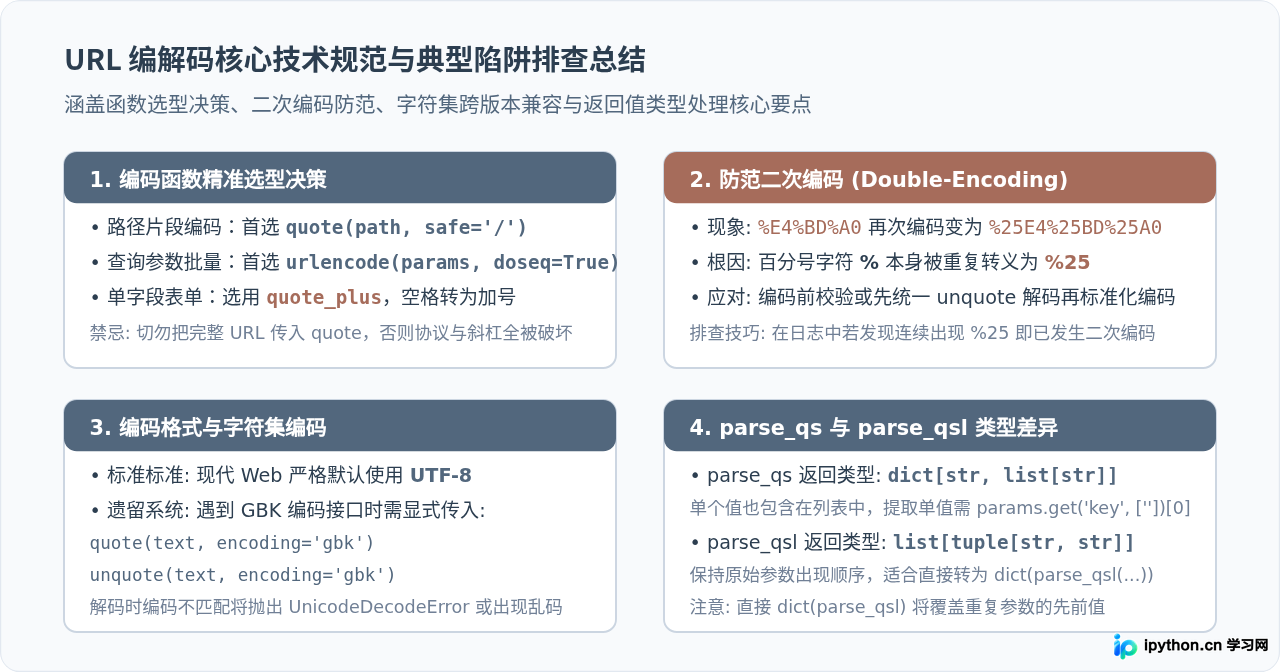
在实际开发中,开发者最常犯的错误是将整条完整的 URL(包含 https://、路径斜杠和 ?)直接送入编码函数,导致协议分隔符和路径结构全部被转义为 %3A%2F%2F,从而破坏整条链接的路由功能。因此,正确的操作始终是针对 URL 的特定组件(如路径片段或查询字典)进行差异化编码。
二、单个字符串与路径片段:quote 与 unquote
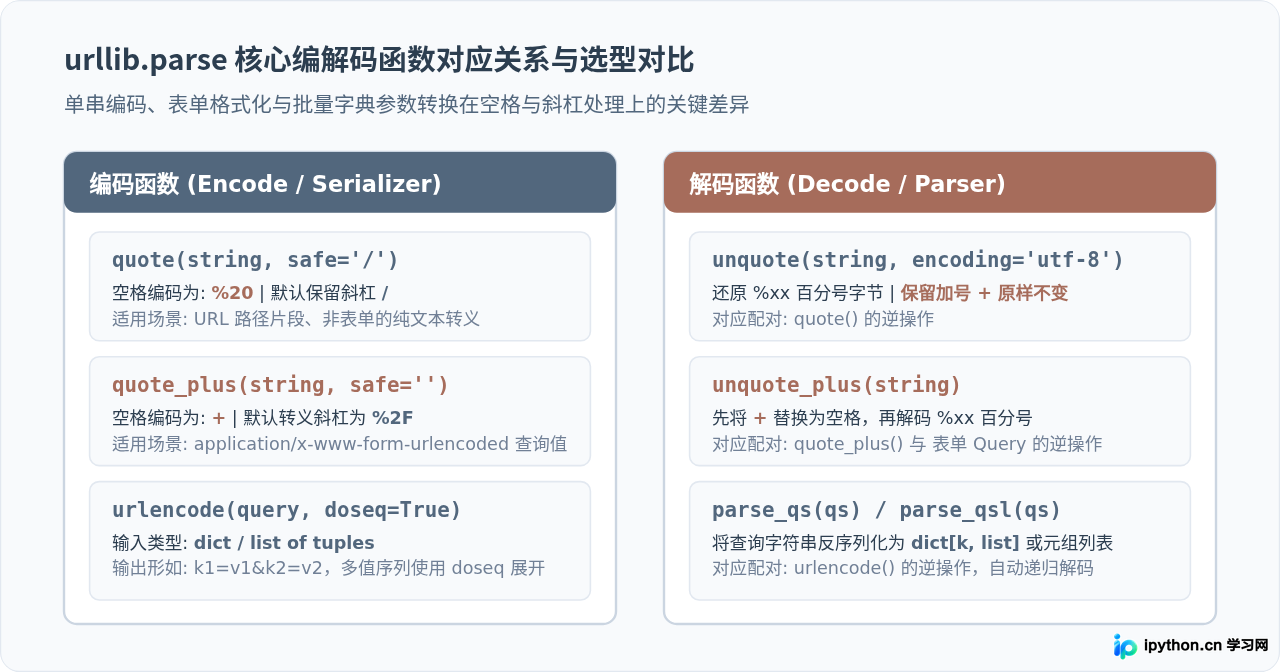
urllib.parse.quote 和 urllib.parse.unquote 是处理单个字符串百分号编码与解码的基础函数。它们通常用于处理 URL 路径片段、文件名称或非表单格式的特定参数。
1. quote 函数的基本用法与 safe 参数
quote 函数的定义为 quote(string, safe='/', encoding=None, errors=None)。其中核心参数 safe 默认为 '/',这意味着默认情况下正斜杠不会被转义,因此可以直接用于包含层级路径的字符串。
from urllib.parse import quote, unquote

# 1. 默认参数编码(保留斜杠)
path_str = "docs/深度学习/自然语言处理.pdf"
encoded_path = quote(path_str)
print("编码结果:", encoded_path)
# 示例输出: docs/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/%E8%87%AA%E7%84%B6%E8%AF%AD%E8%A8%80%E5%A4%84%E7%90%86.pdf

# 2. 修改 safe 参数,将斜杠也作为普通字符进行编码
filename = "report/2026.docx"
encoded_full = quote(filename, safe='')
print("全量编码:", encoded_full)
# 示例输出: report%2F2026.docx

# 3. 自定义保留字符(例如保留冒号和逗号)
special_str = "tag:Python,数据分析"
encoded_custom = quote(special_str, safe=':,')
print("保留冒号和逗号:", encoded_custom)
# 示例输出: tag:Python,%E6%95%B0%E6%8D%AE%E5%88%86%E6%9E%90
2. unquote 函数的解码还原
unquote(string, encoding='utf-8', errors='replace') 将形如 %xx 的百分号编码还原为原始字符。默认采用 UTF-8 编码集解码,若遇到非标准字节序列,可通过 errors 参数设置替换或忽略策略。
# 解码恢复原始字符串
raw_encoded = "docs/%E6%B7%B1%E5%BA%A6%E5%AD%A6%E4%B9%A0/%E8%87%AA%E7%84%B6%E8%AF%AD%E8%A8%80%E5%A4%84%E7%90%86.pdf"
decoded_path = unquote(raw_encoded)
print("解码结果:", decoded_path)
# 示例输出: docs/深度学习/自然语言处理.pdf
三、表单规范与空格处理:quote_plus 与 unquote_plus
在处理 HTML 表单提交(application/x-www-form-urlencoded)及搜索引擎查询字符串时,空格的处理规则与纯路径不同。在早期的 MIME 规范中,表单内的空格被转换为加号 +,而标准百分号编码则将空格转为 %20。为此,urllib.parse 提供了 quote_plus 与 unquote_plus。
from urllib.parse import quote, quote_plus, unquote, unquote_plus

query_text = "Python 教程 & 实战指南"

# 对比 quote 与 quote_plus 对空格和保留字符的编码行为
res_quote = quote(query_text)
res_quote_plus = quote_plus(query_text)

print("quote:     ", res_quote)
# 示例输出: Python%20%E6%95%99%E7%A8%8B%20%26%20%E5%AE%9E%E6%88%98%E6%8C%87%E5%8D%97
print("quote_plus:", res_quote_plus)
# 示例输出: Python+%E6%95%99%E7%A8%8B+%26+%E5%AE%9E%E6%88%98%E6%8C%87%E5%8D%97

# 对比 unquote 与 unquote_plus 对加号的解码行为
test_str = "Python+3.12%20Release"
print("unquote:     ", unquote(test_str))
# 示例输出: Python+3.12 Release (加号被保留,未变为空格)
print("unquote_plus:", unquote_plus(test_str))
# 示例输出: Python 3.12 Release (加号成功被还原为空格)如果解码来自 Web 浏览器提交的 GET 表单或 URL 查询参数(Query String),应优先使用 unquote_plus;如果处理的是 RESTful 风格的 URL 路径(Path Segment),其中的加号往往是合法的内容字符,则必须使用 unquote,避免将原本的 + 误转为空格。
四、字典键值对批量处理:urlencode 与 parse_qs / parse_qsl
在构造实际网络请求(如使用 urllib.request 或第三方库 requests)时,查询参数通常以 Python 字典或元组列表的形式存在。手动拼接字符串容易遗漏编码或导致定界符错位,urlencode 是执行参数序列化最安全高效的方法。
1. urlencode 序列化查询字典
urlencode(query, doseq=False, safe='', encoding=None, errors=None, quote_via=quote_plus) 可以将字典或键值对序列转换为标准查询字符串。当参数字典中包含列表或元组等多值字段时,务必指定 doseq=True(Do Sequence),否则列表整体会被当作字符串处理并产生错误的编码。
from urllib.parse import urlencode

# 1. 基础单值字典参数
params = {
    "keyword": "Python 数据解析",
    "page": 1,
    "sort": "desc"
}
query_string = urlencode(params)
print("基础查询串:", query_string)
# 示例输出: keyword=Python+%E6%95%B0%E6%8D%AE%E8%A7%A3%E6%9E%90&page=1&sort=desc

# 2. 包含列表的多值字段处理(对比 doseq 参数)
filter_params = {
    "category": ["programming", "database"],
    "tag": "python"
}

# 未开启 doseq 时:列表被强制转为字符串 "['programming', 'database']" 并编码
print("未开启 doseq:", urlencode(filter_params, doseq=False))
# 示例输出: category=%5B%27programming%27%2C+%27database%27%5D&tag=python

# 开启 doseq=True 时:正确展开为同一个键名对应多个值的标准形式
print("开启 doseq:  ", urlencode(filter_params, doseq=True))
# 示例输出: category=programming&category=database&tag=python
2. parse_qs 与 parse_qsl 反序列化查询字符串
当从已有 URL 中提取出查询部分时,可使用 parse_qs(解析为字典)或 parse_qsl(解析为键值列表)。这两个函数会自动处理内部的百分号解码和加号转换。
from urllib.parse import parse_qs, parse_qsl

raw_qs = "category=programming&category=database&tag=python&keyword=Python+%E6%95%B0%E6%8D%AE%E8%A7%A3%E6%9E%90"

# 1. 使用 parse_qs:返回 dict,值为 list(保留多值特性)
dict_result = parse_qs(raw_qs)
print("parse_qs 结果:")
print(dict_result)
# 示例输出:
# {'category': ['programming', 'database'], 'tag': ['python'], 'keyword': ['Python 数据解析']}

# 访问单个值时需通过索引获取列表第一项
tag_value = dict_result.get("tag", [""])[0]
print("单值提取:", tag_value)  # 示例输出: python

# 2. 使用 parse_qsl:返回 list of tuples(保持顺序且易于遍历)
list_result = parse_qsl(raw_qs)
print("parse_qsl 结果:")
print(list_result)
# 示例输出:
# [('category', 'programming'), ('category', 'database'), ('tag', 'python'), ('keyword', 'Python 数据解析')]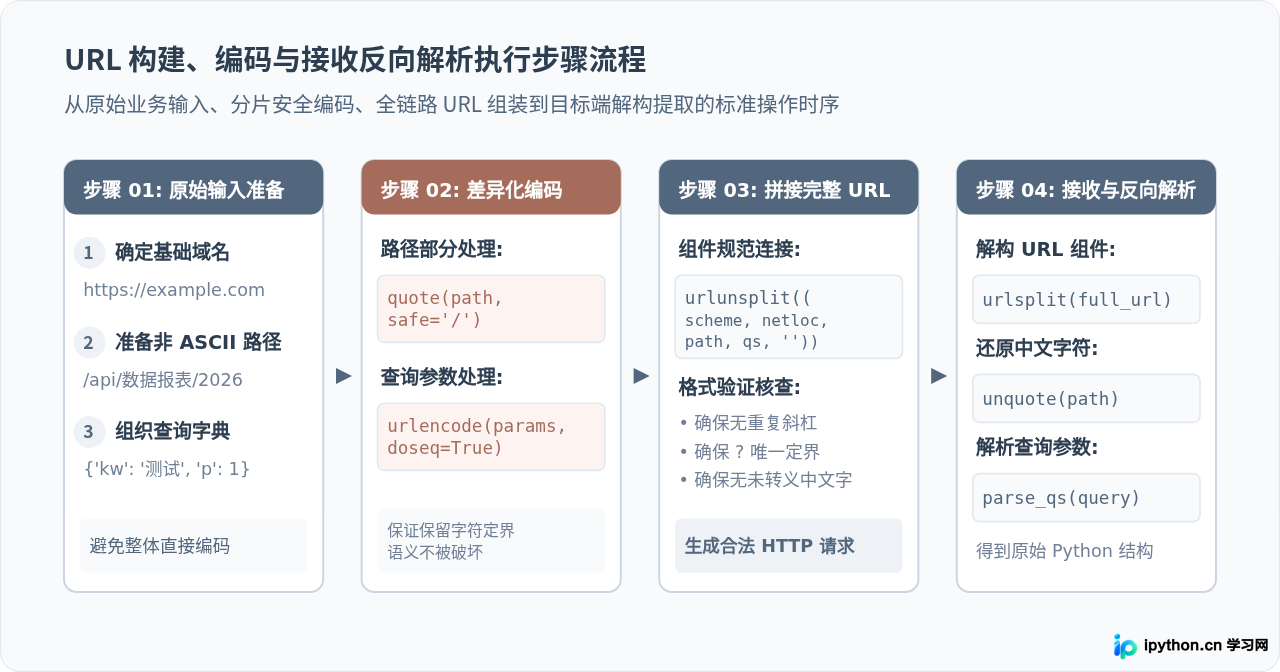
五、全链路实战:安全构建复合 URL 与反向解析
在生产级代码中,构建 URL 通常涉及协议、主机名、非 ASCII 路径和复杂查询参数的拼接。借助 urlsplit、urlunsplit 与编解码函数的协同,可以构建出完全符合 RFC 规范的请求路径,并能在接收端无缝还原。
from urllib.parse import urlsplit, urlunsplit, quote, urlencode, parse_qs, unquote

def build_secure_url(base_domain, path_segments, query_dict):
    """
    安全组装包含中文路径与参数的完整 URL
    """
    # 1. 逐级对路径进行百分号编码,保留路径分隔符 '/'
    # 对路径中的每个片段独立编码可以精确控制
    clean_path = "/" + "/".join(quote(seg, safe="") for seg in path_segments if seg)

    # 2. 对查询字典进行序列化编码
    clean_query = urlencode(query_dict, doseq=True)

    # 3. 拆解协议与主机,合并全部组件
    scheme = "https"
    netloc = base_domain.removeprefix("https://").removeprefix("http://").rstrip("/")

    # urlunsplit 接收 5 元组: (scheme, netloc, path, query, fragment)
    full_url = urlunsplit((scheme, netloc, clean_path, clean_query, ""))
    return full_url

def parse_incoming_url(target_url):
    """
    从目标 URL 中完整提取结构化数据并反向还原
    """
    split_res = urlsplit(target_url)

    # 解码路径为原始中文字符
    decoded_path = unquote(split_res.path)

    # 解析查询字符串为原始 Python 字典
    parsed_params = parse_qs(split_res.query)

    return {
        "host": split_res.netloc,
        "path": decoded_path,
        "params": parsed_params
    }

# 执行构建演示
domain = "api.example.com"
paths = ["v2", "接口服务", "数据报表"]
params = {"type": "日报", "date": "2026-10-09", "filters": ["active", "verified"]}

final_url = build_secure_url(domain, paths, params)
print("生成的规范 URL:")
print(final_url)
# 示例输出:
# https://api.example.com/v2/%E6%8E%A5%E5%8F%A3%E6%9C%8D%E5%8A%A1/%E6%95%B0%E6%8D%AE%E6%8A%A5%E8%A1%A8?type=%E6%97%A5%E6%8A%A5&date=2026-10-09&filters=active&filters=verified

# 执行解析演示
extracted = parse_incoming_url(final_url)
print("\n解析还原结果:")
print("主机:", extracted["host"])
print("路径:", extracted["path"])
print("参数:", extracted["params"])
# 示例输出:
# 主机: api.example.com
# 路径: /v2/接口服务/数据报表
# 参数: {'type': ['日报'], 'date': ['2026-10-09'], 'filters': ['active', 'verified']}
六、核心规范总结与常见避坑指南
在日常开发与网络爬虫开发中,URL 编解码问题往往表现为请求返回 400 Bad Request、404 Not Found 或后端解析出乱码。以下是开发中必须牢记的避坑要点:
1. 警惕二次编码(Double Encoding)
如果一个字符串已经被部分或全部编码过(例如包含 %E6%95%B0),直接再次对其调用 quote 会导致百分号 % 本身被转义为 %25,变成 %25E6%2595%25B0。服务端收到后解码一次只会还原为 %E6%95%B0,从而无法获得原始文本。防范方法是在接收不确定来源的字符串时,先通过 unquote 解码一次确认无百分号残留,再统一执行标准化编码。
2. 注意指定字符编码集(Encoding)
虽然现代 Web 规范默认采用 UTF-8 编码,但部分国内传统政企或高校系统仍在使用 GBK / GB2312 编码。如果目标接口要求 GBK 编码参数,直接使用默认 quote 会导致服务端解析失败。此时应显式传入 encoding='gbk':
from urllib.parse import quote, unquote

chinese_word = "测试"

# UTF-8 编码(每个中文字符占用 3 组百分号)
utf8_encoded = quote(chinese_word, encoding='utf-8')
print("UTF-8 编码: ", utf8_encoded)  # 示例输出: %E6%B5%8B%E8%AF%95

# GBK 编码(每个中文字符占用 2 组百分号)
gbk_encoded = quote(chinese_word, encoding='gbk')
print("GBK 编码:   ", gbk_encoded)   # 示例输出: %B2%E2%CA%D4

# 解码时也必须匹配对应的编码集
print("GBK 解码:   ", unquote(gbk_encoded, encoding='gbk'))  # 示例输出: 测试
3. parse_qs 返回值永远是列表
使用 parse_qs 解析单值参数时,直接使用 params['key'] 会得到列表而不是字符串标量。如果代码后续逻辑期望字符串类型(如 if params['status'] == 'active'),将永远判定为 False。应当使用 params.get('status', [''])[0] 安全提取,或在明确参数均为单值时结合 parse_qsl 转换为普通字典 dict(parse_qsl(qs))。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















