


Java适合后端开发,Python擅长AI:两者应用领域有何不同?
深入对比Java与Python在后端开发与人工智能领域的底层设计、执行效率、生态壁垒与工程实践差异,提供详尽的技术选型指南。
一、核心定位与底层设计的根本分歧
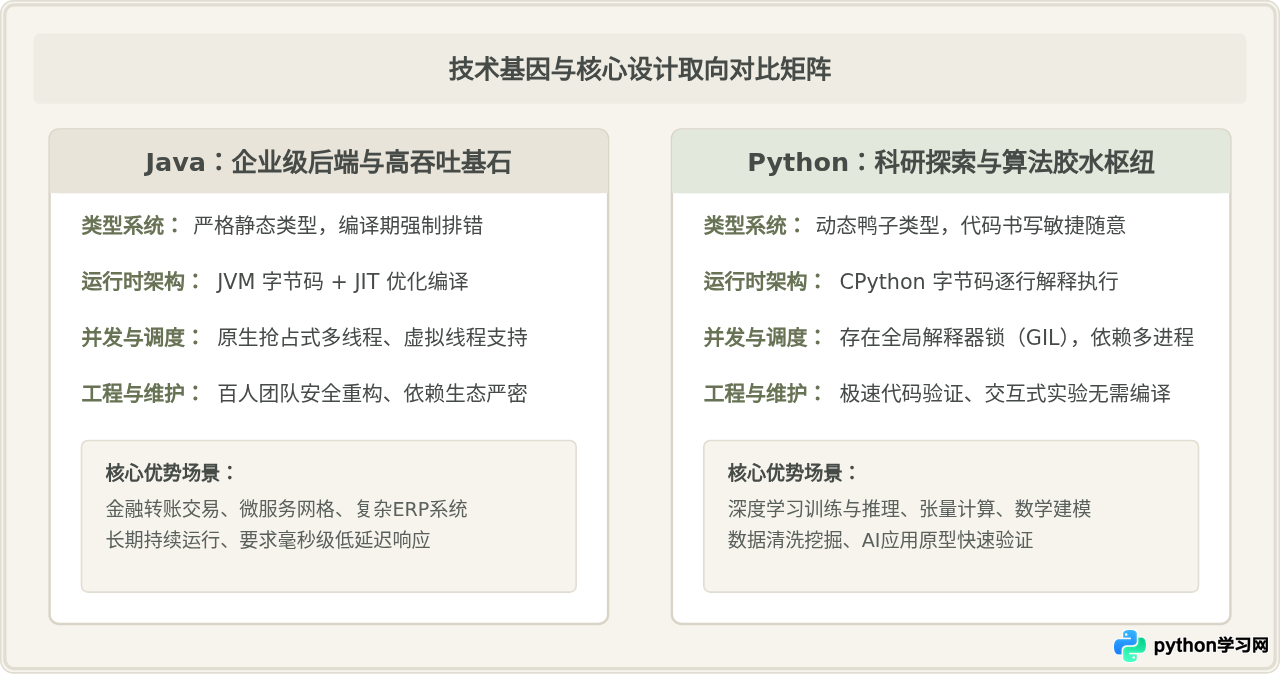
很多开发者在初学阶段容易产生疑问:既然两者都是图灵完备的通用编程语言,为什么很少见到用Java来写前沿深度学习模型,也很少见到超大规模金融或电商核心交易系统完全由Python支撑?这一现象的根源不在于语法糖的多少,而在于两门语言诞生之初就确立的执行模型与架构哲学。
Java在设计之初就将“编写一次,到处运行”以及大规模工程协同作为首要目标。Java采用强类型静态检查机制,代码在编译期就能捕捉绝大多数接口类型不匹配、空指针风险或结构调用错误。依托Java虚拟机(JVM),程序在运行时拥有精细的垃圾回收器(如G1、ZGC)、即时编译器(JIT)以及操作系统级的多线程支持。经过JIT热点编译优化后,Java后端服务的吞吐量与执行速度极高,并且具备极度稳定的长时间运行表现。
与此相对,Python自诞生起就强调开发者的表达效率与极简语法。Python采用动态类型与解释执行模式,自带交互式REPL环境。对于科研人员、算法工程师而言,他们不需要在编写代码前定义繁杂的类结构和类型声明,几行代码就能完成数据加载、矩阵切片和参数试验。更关键的是,Python在底层设计了完备的C语言扩展接口,能够极其廉价地调用由C、C++或Fortran编写的原生高性能库。这种特性使得Python最终演化为顶层的统一控制面板。
二、深入辨析:为什么“慢语言”Python能统治AI?
行业中常有一种看似矛盾的说法:“Python的执行速度比C/C++慢数十倍乃至上百倍,为什么对计算资源要求最极端的深度学习与大模型训练,反而全部基于Python?”
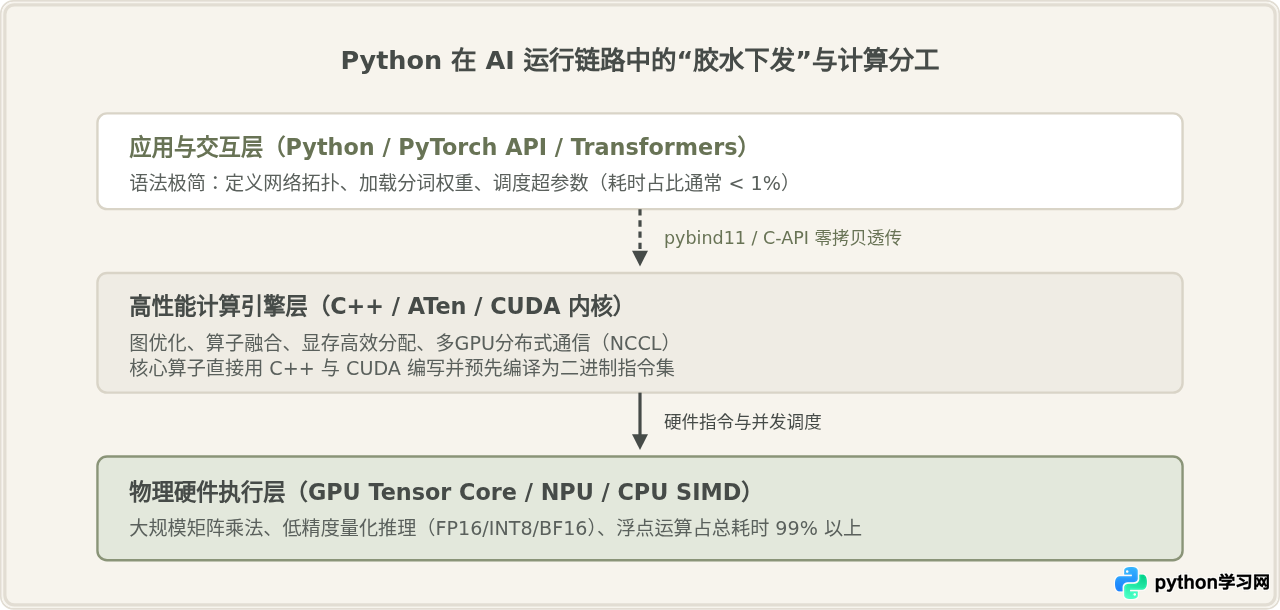
要理解这个现象,首先需要看清AI计算任务的真正瓶颈。在现代深度学习中,99%以上的计算开销都集中在大规模矩阵乘法(GEMM)、卷积运算以及激活函数的高密集张量操作上。这些计算本质上由底层的硬件算力芯片(NVIDIA GPU、Google TPU等)处理,或者通过底层的C++与汇编优化库(如cuBLAS、cuDNN、Intel oneDNN)执行。
在实际代码中,Python并不亲自遍历多维数组进行加乘计算,而是作为“指挥调度系统”。开发者在Python中调用一行简洁的张量乘法,Python虚拟机在毫秒级内解析该指令,随即便通过底层C/C++扩展将指针和计算图下发至GPU显存中。此时,GPU内部数千个CUDA核心并行执行高负荷运算,Python解释器本身只是在等待硬件完成通知。
为什么Java在此类探索中难以占据主导?
Java在语法与交互机制上与AI研究的天然属性存在壁垒:
- 交互式实验环境的门槛:AI模型研发包含大量的特征探索、权重调试与结构试验。数据科学家需要依赖Jupyter Notebook这类支持单步执行、即时输出图表与张量形状的工具。Java语言严格的编译机制与样板代码使其在探索性实验中步调较重。
- 原生交互的历史历史包袱:Java以往通过JNI(Java Native Interface)调用C/C++动态链接库,不仅编写冗长,而且JVM与操作系统原生内存之间的数据交换存在不可忽视的边界开销(即使最新版本引入Foreign Function & Memory API,现有AI生态的迁移成本依然极其巨大)。
- 社区与框架马太效应:PyTorch、TensorFlow、HuggingFace、vLLM、LangChain等现代AI生态无一例外优先以Python作为第一API。算法论文一旦发布,附带的代码仓库99%以上基于Python,这形成了牢不可破的生态护城河。
三、后端架构对比:为什么企业级系统青睐Java?
如果说Python凭借敏捷胶水特性赢得了AI算法实验室,那么在复杂的商业系统与企业级后端开发中,衡量标准则完全转移到了工程鲁棒性、系统吞吐量与故障容错能力上。
1. 静态类型带来的重构安全保障
在涉及数百个数据表、数十个微服务与数百人研发团队的企业系统中,代码库随时面临迭代与重构。Java的强类型系统让现代IDE能够在毫秒级内完成全局字段改名、引用排查与接口签名校验。任何调用错误在编译期就会触发失败,无法打包部署。
相反,Python的动态特性虽然在小型脚本或单人开发时非常敏捷,但在大型团队协同中,若没有严格的mypy类型注解和全覆盖单元测试,极其容易在运行时发生意料之外的AttributeError或TypeError。这种不确定性在金融支付、资产记账等严肃业务中是不可容忍的。
2. JVM成熟的内存管理与多线程并发模型
Python官方解释器(CPython)受制于全局解释器锁(GIL),一个Python进程内的多个原生线程无法在多核CPU上实现真正的并行字节码计算(虽然Python 3.13正在实验性推进自由线程free-threaded模式,但现有生态仍高度依赖多进程模式)。而在后端服务处理高并发网络请求时,多进程模式会带来昂贵的内存复制和跨进程通信开销。
Java则原生支持操作系统级抢占式多线程,并且Java 21引入的虚拟线程(Virtual Threads)更是将并发连接处理能力提升到了百万级别。结合成熟的分代垃圾回收调优体系,JVM能够轻松管理数十GB乃至数百GB的堆内存,长期平稳运行数月无需重启。
// 典型的 Spring Boot 响应式 / 并发事务后端接口示例(Java)
@RestController
@RequestMapping("/api/orders")
public class OrderController {
    private final OrderService orderService;

    public OrderController(OrderService orderService) {
        this.orderService = orderService;
    }

    @PostMapping("/checkout")
    @Transactional(isolation = Isolation.READ_COMMITTED)
    public ResponseEntity<OrderResult> checkout(@Valid @RequestBody OrderRequest request) {
        // 严格类型校验与事务隔离,确保高并发资金扣减的一致性
        OrderResult result = orderService.processOrder(request);
        return ResponseEntity.ok(result);
    }
}四、技术选型决策:不同业务场景下的取舍步骤
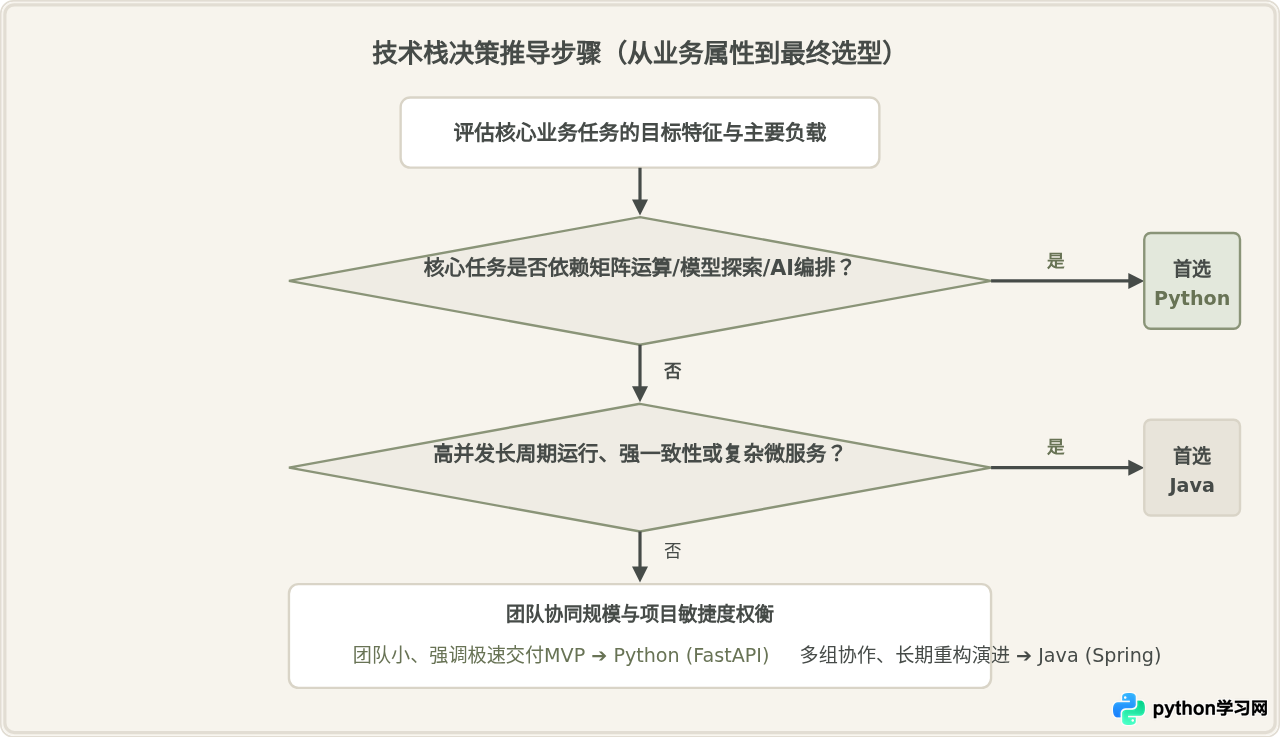
为了帮助工程师与技术管理者在立项时准确评估技术栈,以下推导流程从任务属性、吞吐需求与团队维护成本三个维度给出了明确的选择依据:
选型维度的具体对照
| 考量维度 | Java 应用场景表现 | Python 应用场景表现 |
|---|---|---|
| 计算性能与吞吐 | JIT持续优化,高吞吐,CPU密集运算(非矩阵)极快 | 解释执行较慢;但底层张量运算由C++/CUDA代劳,速度极快 |
| 并发模型 | 多线程共享内存并发,支持百万级虚拟线程(Loom) | 受GIL限制,多依靠异步协程(Asyncio)或多进程负载均衡 |
| 生态成熟度 | Spring体系、Netty、Kafka客户端、企业级中间件极其强大 | PyTorch、TensorFlow、Scikit-learn、Hugging Face垄断AI生态 |
| 开发与重构成本 | 前期需要定义模板和接口,但大型重构时类型推断极其稳健 | 前期起步极快,原型迭代快,但代码规模膨胀后维护成本增加 |
五、现代架构中的双剑合璧:工程协同的最佳实践
在成熟的现代互联网与智能化产品架构中,Java与Python早已不是“二选一”的非此即彼关系,而是各司其职的协同配合模式。
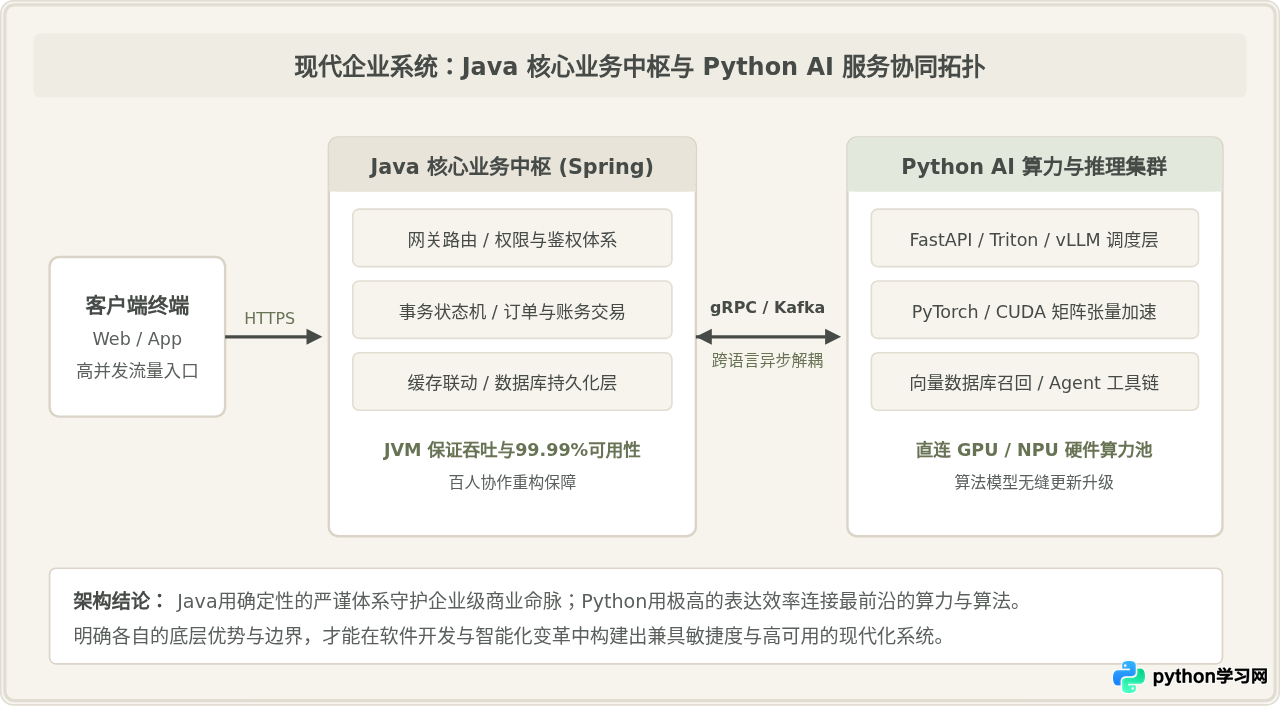
典型的工业级AI落地架构通常由两套子系统组成:
- 业务核心与流转中心(Java负责):负责用户权限认证、账户流水结算、订单状态机流转、数据库事务一致性、高并发限流熔断以及外部API网关通信。这部分业务代码庞大、规则复杂,需要极强的可维护性与稳定性。
- 智能计算与模型服务(Python负责):使用PyTorch或TensorFlow进行模型微调训练;在线推理时使用FastAPI包装Triton Inference Server、vLLM或Ray集群,负责向量召回、大模型文本生成或图像分析。
- 跨语言通信枢纽:Java服务与Python AI服务之间通过高性能通信协议连接。常见方案包括基于Protobuf的gRPC远程过程调用、高吞吐消息队列(Apache Kafka)进行异步解耦,或者通过共享Redis显式缓存中间状态。
总结
回顾“Java适合后端开发,Python擅长AI”这一行业共识,其本质不是语言优劣的争论,而是计算机工程中“确定性”与“灵活性”的权衡体现:
- Java 将工程可靠性置于第一位,以静态类型、虚拟机即时编译优化和成熟的并发模型,构筑了现代工业级后端系统的坚实地基。
- Python 将开发者效率与生态连接能力置于第一位,以敏捷语法作为外壳,底层深度融合C/C++与GPU算力驱动,成为了人工智能探索与创新的首选语言。
理清两者的应用领域与技术边界,无论是技术选型还是个人技能成长,都能建立起更加清晰、理性的技术判断力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















