


pandas读取CSV文件:pd.read_csv基础用法与核心参数
本文介绍如何使用 pandas 的 read_csv 函数读取 CSV 文件,涵盖分隔符、编码、列选择、数据类型指定及大文件分块读取等核心参数的配置方法,帮助初学者快速掌握数据导入技巧。
在 pandas 数据分析流程中,读取 CSV 文件往往是第一步。熟悉 read_csv 的基本调用方式后,你可以先快速预览数据内容,随后根据文件的实际分隔符、字符编码及列类型需求调整相应参数;面对超大文件时,还可以利用分块读取功能高效处理。
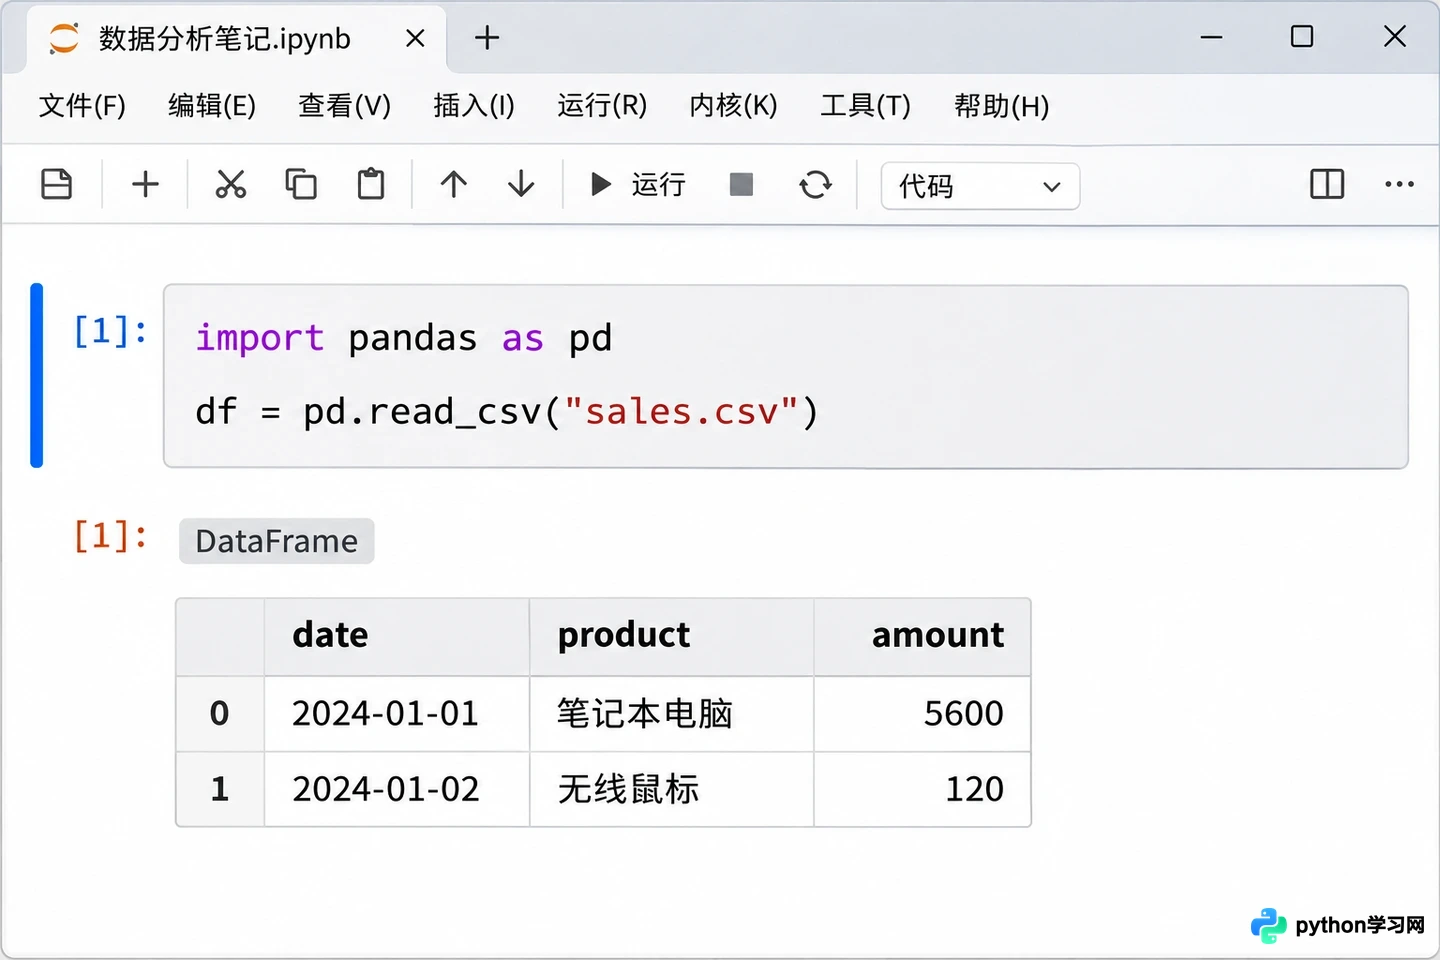
用 read_csv 读取文件并查看表格结果
1. 用 read_csv 读取 CSV 文件
首先导入 pandas 库,然后将目标文件的路径传递给 pd.read_csv():
import pandas as pd

df = pd.read_csv("sales.csv")
print(df.head())
代码中的 sales.csv 仅为示例文件名,实际使用时需替换为真实的文件路径。若使用相对路径,则以当前 Python 工作目录为基准;也可以直接使用绝对路径,例如 Windows 系统下的 r"D:\data\sales.csv"。该函数默认以逗号作为分隔符,并将文件首行识别为列名,最终返回一个 DataFrame 对象。执行 df.head() 可以预览前几行数据,从而确认列名解析和数据加载是否符合预期。
如果原始文件不包含表头行,可以通过显式设置 header=None 来告知程序,并利用 names 参数手动指定列名:
df = pd.read_csv("sales.csv", header=None, names=["date", "product", "amount"])
采用上述设置后,文件的第一行也会被当作普通数据读取。若错误地对包含表头的文件设置了 header=None,原本的列名会被误读为第一行数据,因此建议在读取前先查看文件结构,再决定参数配置。
2. 按分隔符和编码调整读取方式
CSV 文件的分隔符并不局限于逗号。例如,某些地区设置或导出工具可能生成分号分隔的文件,此时可以通过指定 sep 参数来解决:
df = pd.read_csv("sales.csv", sep=";")
sep 支持其他单字符分隔符;delimiter 是其别名参数,通常只需选用其中一个即可。如果读取后发现所有数据都拥挤在同一列中,应优先检查文件的实际分隔符,而非急于修改数据本身。
当遇到中文乱码问题时,需确保 encoding 参数的值与文件的实际编码一致。常见的尝试方案包括:对于 UTF-8 文件使用 encoding="utf-8",对于带 BOM 头的 UTF-8 文件使用 encoding="utf-8-sig",而对于部分旧版 Windows 导出的文件,则可能需要使用 encoding="gbk":
df = pd.read_csv("sales.csv", encoding="utf-8-sig")
不能仅凭文件扩展名来判断编码格式。若出现解码错误,建议先确认文件来源或使用文本编辑器查看其真实编码,再选择对应的参数值。切勿为了强行运行代码而随意忽略解码错误,这可能导致字符被替换或数据损坏。
3. 只读取需要的列并指定类型
当文件包含大量列时,可以利用 usecols 参数仅读取分析所需的列,从而减少无关数据的内存占用;对于编号、金额等特定字段,还可以通过 dtype 直接指定数据类型:
df = pd.read_csv(
    "sales.csv",
    usecols=["date", "amount"],
    dtype={"amount": "float64"}
)
usecols 中指定的列名必须与 CSV 文件中的表头完全匹配。上述示例仅保留了 date 和 amount 两列,并将 amount 解析为浮点数。如果金额列中混杂了空值或非数字文本,直接指定数值类型可能会引发错误;此时应先检查源数据,或暂时将该列读作字符串,待清洗后再进行类型转换。
日期列可以在数据读入后进行转换,这样能更灵活地处理各种日期格式:
df["date"] = pd.to_datetime(df["date"], errors="coerce")
使用 errors="coerce" 参数可以将无法解析的值转换为缺失值,便于后续筛查异常日期。转换完成后,可通过 df.dtypes 查看列的数据类型,并使用 df.isna().sum() 统计各列的缺失值数量。
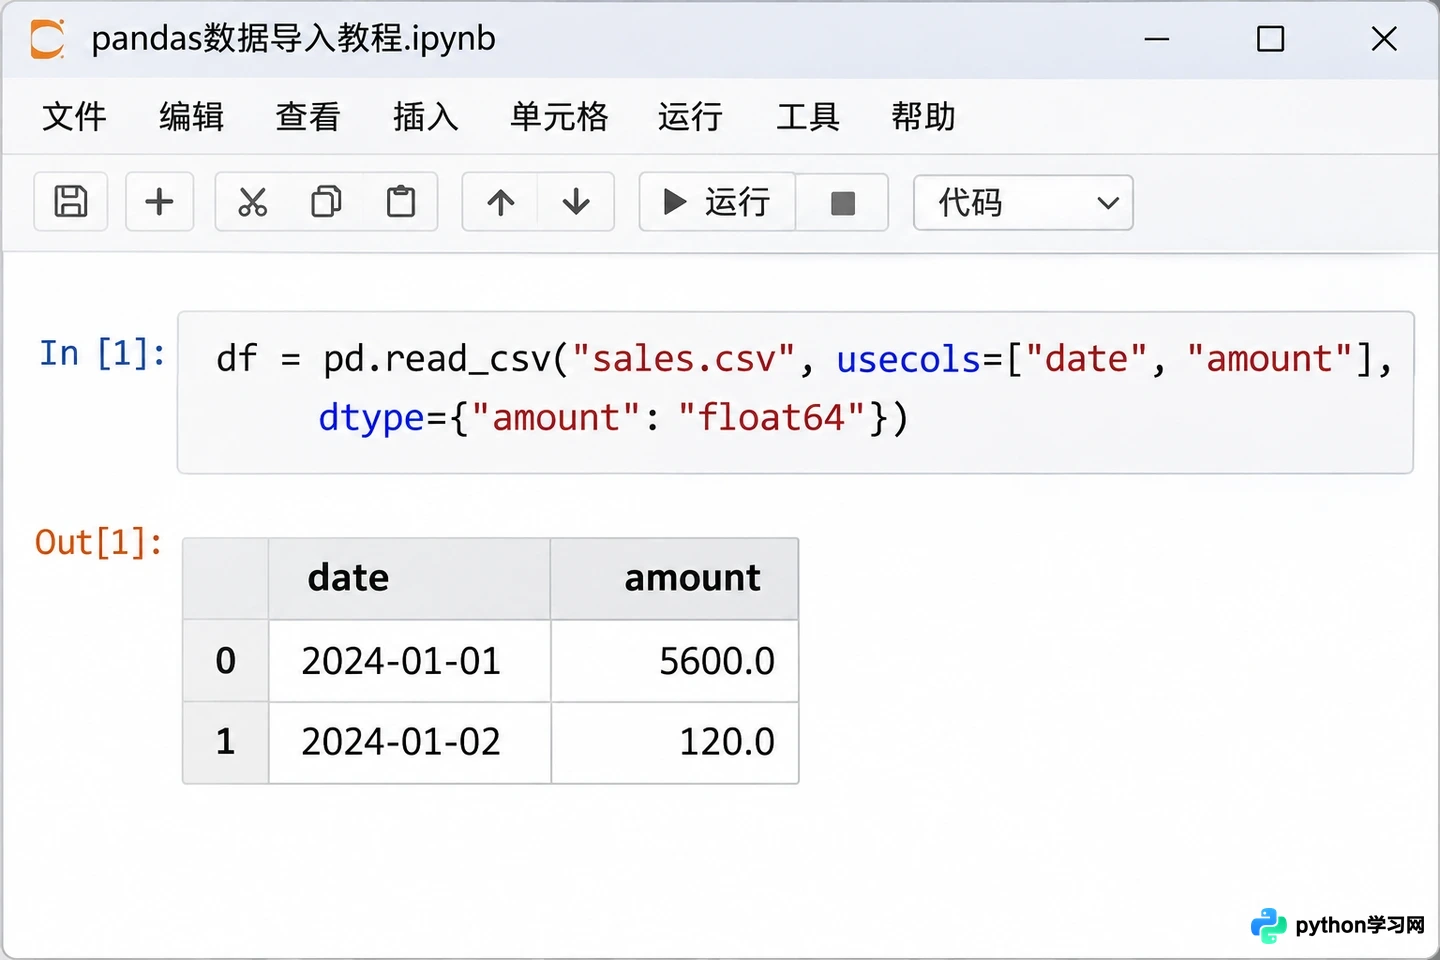
选择需要的列并指定数据类型
4. 文件较大时使用 chunksize 分块读取
常规情况下,pd.read_csv() 会将整个文件读取为一个 DataFrame。当数据量巨大且内存紧张时,可以传入 chunksize 参数,使函数返回一个可逐块遍历的读取器对象:
reader = pd.read_csv("sales.csv", chunksize=1000)

for chunk in reader:
    print(chunk.shape)
在此模式下,每次迭代获取的数据块最多包含 1000 行,你可以在循环中对每块数据进行统计或写入操作,从而避免一次性将完整文件载入内存。需注意,chunksize 定义的是每块的行数而非总行数,最后一块的实际行数可能少于设定值。若仅需获取第一块数据,可使用 first_chunk = next(reader),但需注意读取器在遍历后会继续向后移动,不会自动重置到起始位置。
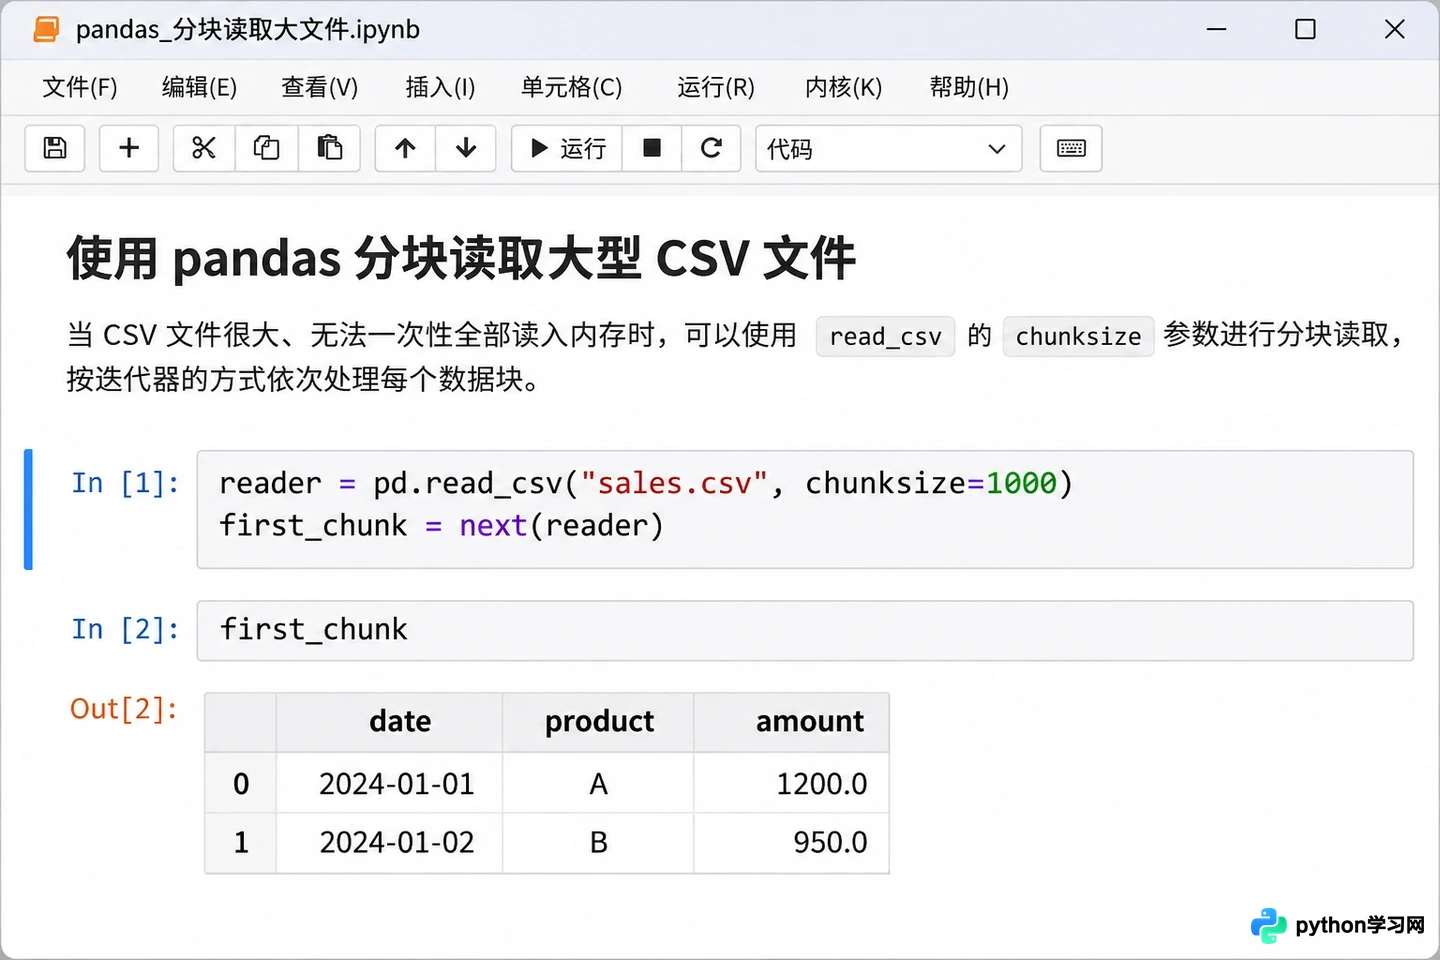
使用 chunksize 逐块读取较大的 CSV 文件
5. 检查结果并定位常见问题
数据读取完成后,建议立即检查列名、前几行样本以及数据类型:
print(df.columns.tolist())
print(df.head())
print(df.dtypes)
若发现列数不符,请核对 sep 设置及表头处理逻辑;若出现中文乱码,请检查 encoding 配置;若数字列被误识别为文本,需检查其中是否混入了单位、千位分隔符或其他特殊字符,进而决定是否调整 dtype 或进行数据清洗。此外,read_csv 还提供了 nrows、skiprows、na_values 等参数,分别用于限制读取行数、跳过指定行以及自定义缺失值标记。根据文件实际情况逐项配置参数,通常比一次性填入大量参数更易于排查问题。
最后,保留一份最小可复现的读取代码,并确认输出的列结构、行数及数据类型均满足后续分析的需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















