


Python爬虫相比Java和Go有什么优缺点?技术选型对比
全面对比Python、Go与Java在网络爬虫开发中的优劣势,从开发效率、并发性能、反爬对抗生态与维护成本等核心维度提供清晰的技术选型依据与架构建议。
一、核心维度对比:语言特性的爬虫视角
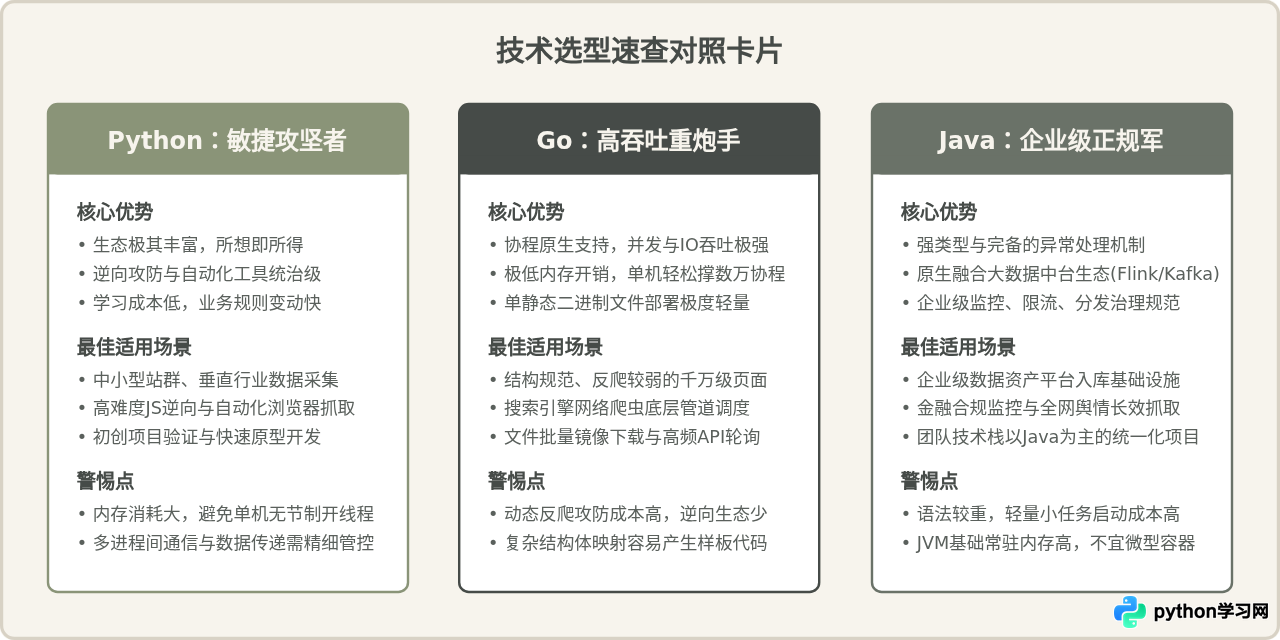
评估一门语言是否适合编写网络爬虫,通常需要从四个维度展开考察:网络与并发模型、数据提取与DOM解析生态、反爬对抗与浏览器自动化工具链,以及工程化维护成本。
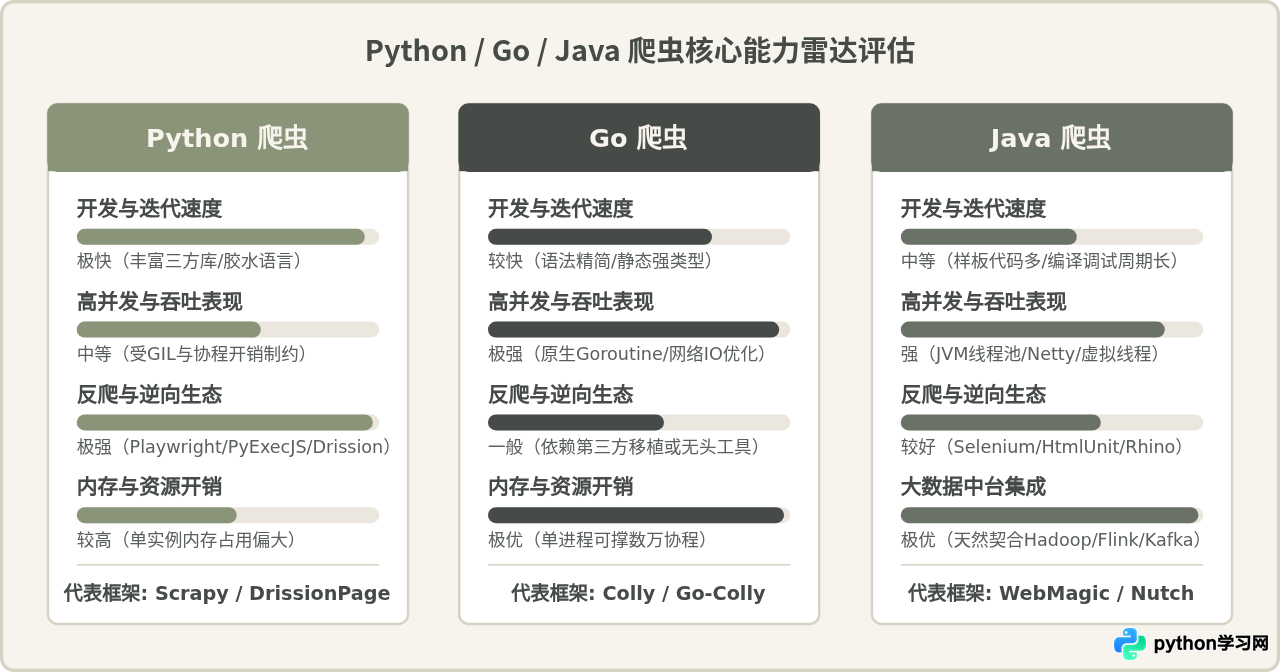
二、Python 爬虫的优势与现实局限
1. Python 的核心优势
在绝大多数数据采集任务中,Python 仍是第一选型,主要原因体现在三个方面:
- 极为低廉的原型与提取成本:利用
Requests、Httpx发送网络请求,搭配Parsel、BeautifulSoup或XPath提取内容,几行代码就能完成数据抓取验证。在目标网站频繁改版或提取规则多变时,无需经历编译打包,调整即刻生效。 - Scrapy 构建的工业级体系:Scrapy 提供了业界最成熟的异步爬虫架构,内置了调度器、去重指纹过滤器、中间件(Downloader & Spider Middleware)以及管道流水线(Item Pipeline)。开发者只需编写提取规则,即可获得完善的断点重试与限速机制。
- 反爬与逆向领域的统治级工具链:针对 JS 混淆加密,Python 拥有直接调用 Node.js 运行环境的
PyExecJS;针对浏览器环境指纹检测,拥有Playwright、DrissionPage以及undetected-chromedriver等开箱即用的高阶对抗库。
2. Python 面对高负荷时的局限
Python 爬虫的短板主要集中在多核计算密集与巨量并发场景:
- 全局解释器锁(GIL)与多进程开销:当爬虫不仅需要下载网页,还需要对大批量 HTML 文本做密集正则表达式匹配、自然语言分词或解压缩时,单个 Python 进程无法利用多核 CPU。虽然可以通过
multiprocessing解决,但多进程间的数据共享、序列化传输与上下文切换带来了明显的内存占用激增。 - 单机大并发时的内存膨胀:Python 对象较为“重量级”。当同时保持数万个连接和挂起任务时,基于 Twisted 或 asyncio 的调度开销会随着爬取队列的扩张占用数倍于底层语言的内存空间。
三、Go 爬虫的突破与生态短板
1. Go 的核心优势
Go 语言自诞生起就为高并发网络服务而设计,在纯粹的网络 IO 爬取任务中表现亮眼:
- 轻量级并发(Goroutine):Go 协程的初始栈大小仅为数 KB,单个 Go 进程可以轻松调度数十万个并发协程而不会耗尽系统内存。配合高效的
net/http客户端,能够以极低的硬件消耗打满带宽。 - 单二进制无依赖部署:Go 编译后输出单一静态二进制文件,跨平台编译和容器化打包极为简便。在云端分布式集群扩展采集节点时,几秒钟即可完成启动与部署。
- Colly 框架的高性能采集:Go 社区最知名的
Colly框架设计简洁,原生支持并发线程控制、限速延迟、Cookie 存储与分布式收集器扩展,对 API 接口和静态页面采集的吞吐量显著高于同等硬件下的 Python 方案。
2. Go 在复杂爬虫任务中的短板
- 动态页面逆向工具链相对薄弱:虽然 Go 也有
chromedp库用于驱动无头浏览器,但在应对高度混淆的前端 JS 代码、动态加载以及指纹绕过时,调试工具和第三方成熟包的丰富程度远落后于 Python 社区。 - 数据提取灵活性较弱:Go 是一门强类型静态语言。爬虫抓取的数据往往结构松散、字段缺失频繁。在 Go 中处理未经规范化的嵌套 JSON 或杂乱 HTML 时,需要编写繁琐的结构体映射或反复进行类型断言,代码冗余度高,维护改版成本高于动态语言。
四、Java 爬虫的企业级定位与包袱
1. Java 的核心优势
- 企业级分布式架构与监控治理:Java 拥有极度强健的线程池管理、JMX 性能监控及微服务体系。在面对需要与企业的服务注册中心(Consul/Nacos)、日志中心(ELK)和权限安全策略统一管制的场景时,Java 爬虫具备天然的工程化规范。
- 与大数据中台无缝接轨:Java 是现代大数据计算框架(Hadoop、Spark、Flink、Kafka)的原生第一语言。基于
WebMagic或Apache Nutch编写的爬虫,可以直接通过内存对象将数据注入 Kafka 队列或直接作为 Flink 流计算的输入源,省去了跨语言 RPC 或序列化转换的性能损耗。
2. Java 的核心短板
- 开发繁琐与启动冷启动成本:Java 语法严谨、类型强制,编写一个简单的单页面抓取脚本往往需要配置 Maven/Gradle 依赖、定义实体类、处理受检异常。对于小批量、时效要求短的抓取任务,开发周期偏长。
- JVM 基础内存占用较高:即便是一个极简的抓取程序,JVM 虚拟机启动后的常驻内存通常也在数百 MB 以上,不适合频繁创建、销毁的微型轻量爬取容器。
五、常见认知误区与深度辨析
辨析:该说法看似合理,但在绝大多数爬虫场景下并不完全成立。网络爬虫的核心瓶颈在网络等待延迟(RTT)与目标网站的反爬频控阈值,而非编程语言的执行时间。Python 结合 asyncio 或 Scrapy 的非阻塞 IO,单机完全可以撑起每秒数千个 HTTP 连接。只有当每个页面的 CPU 解析时间远超网络请求时间时,语言本身的执行速度才会成为瓶颈。此外,工业级的大规模采集无一例外依赖分布式架构,单节点通过消息队列横向扩容,Python 借助成熟的 Scrapy-Redis 同样可以胜任千万级数据抓取。
辨析:只有在目标网站反爬较弱、数据结构规范、网络吞吐要求极高的条件下才成立(例如公开文件下载、未受反爬保护的公开 API 镜像同步)。如果目标站点包含复杂的逆向签名算法(如高维混淆的 _signature)、强指纹检测或频繁变化的 DOM 结构,选用 Go 会导致大量的开发时间消耗在移植逆向算法和重构类型结构体上。此时整个项目的瓶颈是“工程师逆向破解与维护时间”,而非“机器并发能力”。
辨析:在面向散碎站点的日常爬虫开发中,Java 的出场率确实在下降;但在金融风控、政府合规监控及大型电商舆情中台等企业场景中,爬虫系统被视为核心数据流基础设施的一部分。在此类系统内部,需要严格的代码规范、静态类型检查、成熟的熔断限流(Sentinel)及无缝的数据湖写入,Java 依然是工程治理确定性最高的语言。
六、爬虫技术选型决策流程
进行爬虫项目技术选型时,可以通过以下四个步骤进行判断:
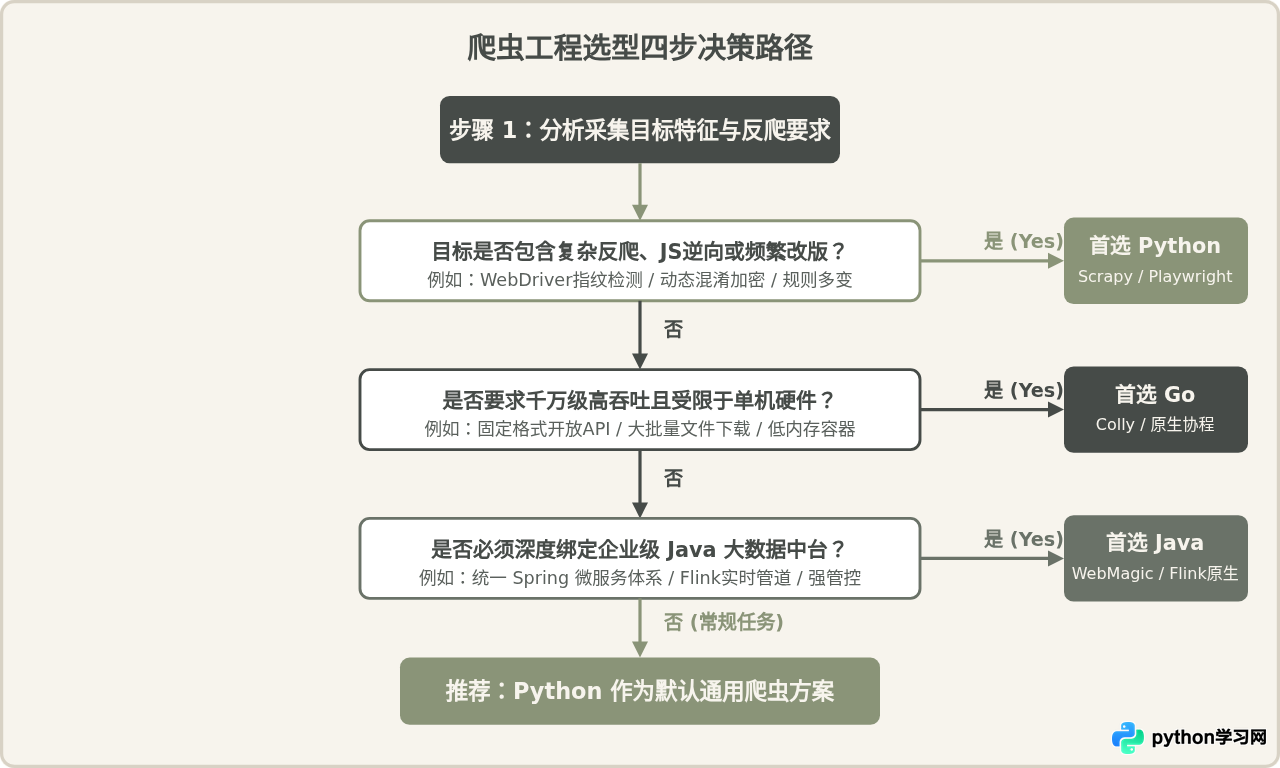
按步骤落实选型决策时,建议遵循以下具体标准:
- 评估反爬烈度与页面特性:如果目标站点部署了 Cloudflare、Akamai 等商业防爬网关,或者前端包含复杂的 JS 逆向解密逻辑,应直接选用 Python。此时选择 Python 能节省数天乃至数周的反编译与底层模拟时间。
- 评估并发指标与硬件基线:如果目标数据源是结构清晰的公开接口,数据量达到千万级或亿级,且需要在配置有限的服务器或容器中运行,选用 Go 能够显著压低服务器资源开销并获得极佳的抓取吞吐。
- 评估团队协作与下游基础设施:如果团队已有完整的 Java 微服务治理架构,数据落地直接接入 HDFS 或 Kafka,且有严格的接口校验与类型规范,采用 Java 编写或通过封装统一客户端接入能够最大化降低跨系统联调摩擦。
- 考虑多语言协同的混合架构:当系统规模达到大型商业级别时,往往不再局限于单一语言,而是采用混合架构取长补短。
七、工业级实践:多语言协同的混合架构
在成熟的数据工程体系中,技术选型不必“非此即彼”。常见的优秀架构是将 Go 的高并发吞吐能力与 Python 的高灵活性逆向能力结合,形成分工协作的数据流水线。
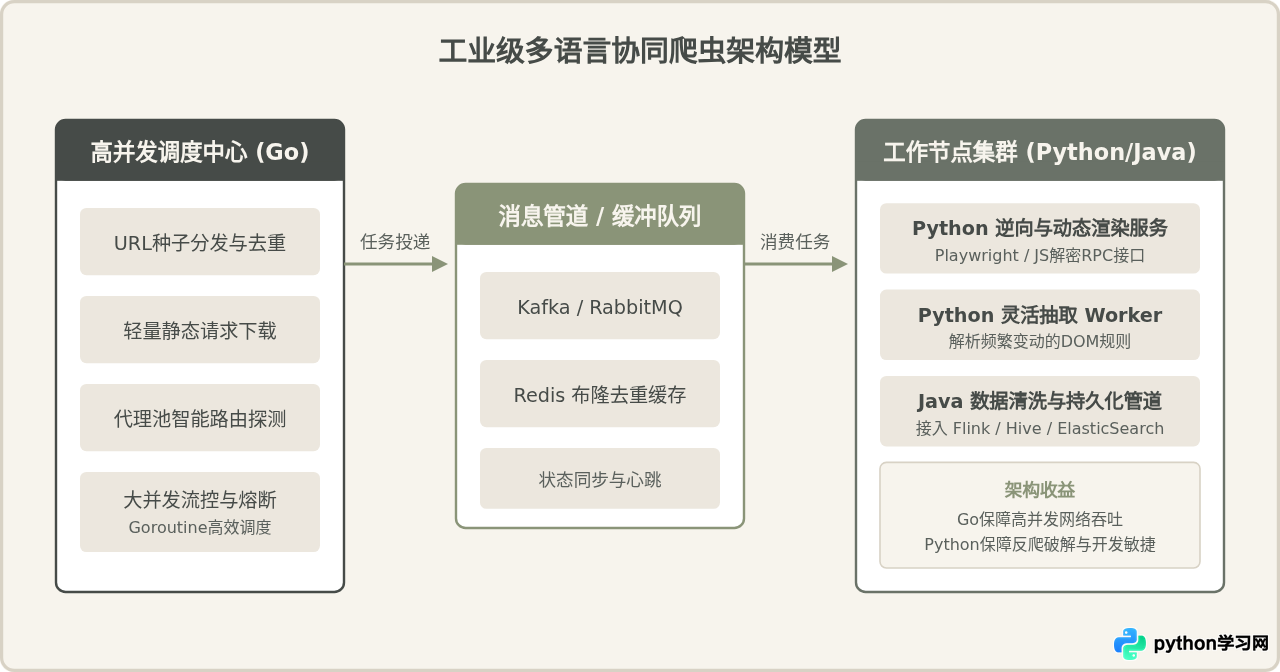
架构分工落地说明:
- Go 负责网关与调度中心:编写种子调度器、代理 IP 质量检测器和请求分发队列。Go 占用内存极低,一台 2 核 4G 的机器即可稳定维持对数千个目标域名的并发节流调度。
- Python 独立微服务化处理复杂逆向:将最难处理的签名生成算法、无头浏览器动态页面渲染封装为独立的 HTTP 或 gRPC 微服务,供核心抓取流程按需调用。由于业务爬取规则变动最快,将 Python 代码与主调度解耦,改动规则无需重启主调度引擎。
- Java 负责入库与大数据流转:解析后的清洗数据交由 Java 消费者写入大数据湖或实时分析索引,充分复用企业现有的大数据校验规则与资产治理工具。
八、典型代码范式对比
通过实现一个最简单的“并发抓取 100 个 URL 并提取标题”的任务,可以直观观察三种语言的代码风格与工程心智负担:
1. Python 范式(asyncio + aiohttp + lxml)
import asyncio
import aiohttp
from lxml import etree

async def fetch_title(session, url):
    try:
        async with session.get(url, timeout=10) as resp:
            text = await resp.text()
            html = etree.HTML(text)
            title = html.xpath('//title/text()')
            return title[0].strip() if title else ""
    except Exception as e:
        return f"Error: {e}"

async def main(urls):
    connector = aiohttp.TCPConnector(limit=50) # 并发控制
    async with aiohttp.ClientSession(connector=connector) as session:
        tasks = [fetch_title(session, url) for url in urls]
        results = await asyncio.gather(*tasks)
        return results

# 运行位置:本地环境 python3
# 特点:无需类型声明,代码短小,解析便利
2. Go 范式(原生 Goroutine + goquery)
package main

import (
	"fmt"
	"net/http"
	"sync"
	"time"
	"github.com/PuerkitoBio/goquery"
)

func fetchTitle(client *http.Client, url string) (string, error) {
	resp, err := client.Get(url)
	if err != nil {
		return "", err
	}
	defer resp.Body.Close()

	doc, err := goquery.NewDocumentFromReader(resp.Body)
	if err != nil {
		return "", err
	}
	return doc.Find("title").Text(), nil
}

func main() {
	urls := []string{"https://example.com"} // 目标列表
	client := &http.Client{Timeout: 10 * time.Second}
	var wg sync.WaitGroup
	sem := make(chan struct{}, 50) // 并发度控制

	for _, u := range urls {
		wg.Add(1)
		sem <- struct{}{}
		go func(targetUrl string) {
			defer wg.Done()
			defer func() { <-sem }()
			title, _ := fetchTitle(client, targetUrl)
			fmt.Println(title)
		}(u)
	}
	wg.Wait()
}
3. Java 范式(CompletableFuture + Jsoup)
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import java.util.List;
import java.util.concurrent.*;
import java.util.stream.Collectors;

public class FastCrawler {
    private static final ExecutorService EXECUTOR = Executors.newFixedThreadPool(50);

    public static String fetchTitle(String url) {
        try {
            Document doc = Jsoup.connect(url).timeout(10000).get();
            return doc.title();
        } catch (Exception e) {
            return "Error: " + e.getMessage();
        }
    }

    public static List<String> batchCrawl(List<String> urls) {
        List<CompletableFuture<String>> futures = urls.stream()
            .map(url -> CompletableFuture.supplyAsync(() -> fetchTitle(url), EXECUTOR))
            .collect(Collectors.toList());

        return futures.stream()
            .map(CompletableFuture::join)
            .collect(Collectors.toList());
    }
}
九、技术选型决策总结对照
| 对比维度 | Python 爬虫 | Go 爬虫 | Java 爬虫 |
|---|---|---|---|
| 编写门槛与调试速度 | 极低,支持交互式调试与快速热修改 | 较低,编译迅速但需处理强类型 | 中等,面向对象样板代码偏多 |
| 并发机制与吞吐上限 | asyncio / 多进程,单机上限受限 | 轻量级 Goroutine,单机网络吞吐极高 | 线程池 / 虚拟线程,吞吐高且调度成熟 |
| 内存与硬件利用率 | 较高,进程常驻对象较重 | 极优,数千协程仅消耗几十兆内存 | 中等偏高,JVM 基础内存占用较大 |
| 反爬逆向与无头生态 | 极其强大,成熟对抗工具首发首选 | 一般,依赖第三方移植库或调用底层 | 健全,但高强度逆向破解库支持较慢 |
| 与大数据平台整合 | 通常通过消息队列中间件解耦传递 | 通过标准协议写入中间件分发 | 原生无缝接入 Hadoop、Flink、Spark 管道 |
| 推荐首要选择 | 常规爬虫首选、重度反爬任务 | 高并发下载、接口同步管道 | 企业级数据中台与内嵌采集 |
总体而言,在面对具体的爬虫任务时,不要脱离业务目标去追求单方面的极致性能。如果数据源经常变动、反爬严苛,优先选用 Python 保证数据能够在最短时间内稳定产出;如果是协议固定、高吞吐、对服务器资源敏感的基础设施型管道,优先选用 Go;如果是与内部数据中台强绑定的合规性长期任务,选用 Java 最为稳妥。而对于超大型数据系统,利用 Go 调度、Python 破防解析、Java 入库计算的混合架构,则是工程效率与系统性能兼备的最优解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















